
In this Article
Ein Web-Unblocker für AI ist ein verwalteter Dienst, der öffentliche Webseiten bei Bedarf abruft und sauberes HTML oder gerenderte Inhalte zurückgibt. So können Sprachmodelle, Retrieval-Pipelines und autonome Agenten das aktuelle Web lesen, ohne blockiert zu werden. Dieser Artikel erklärt, was ein Web-Unblocker tatsächlich leistet, warum AI-Teams zuverlässigen Webzugang benötigen und wie sich die Entscheidung zwischen Eigenentwicklung und Kauf in der Praxis auswirkt.
Er zieht außerdem eine klare Grenze, die Anbieter häufig verwischen. Ein Web-Unblocker ist ein vollständiger Abruf-Stack; ein Proxy-Anbieter wie DataImpulse ist die darin enthaltene Netzwerkschicht. Zu wissen, welchen Teil Sie kaufen, verändert sowohl die Kosten als auch Ihre Kontrolle.
DataImpulse ist ein ethischer Proxy-Anbieter mit mehr als 90 Millionen Residential-, Mobile- und Datacenter-IP-Adressen in 195 Ländern. Das Pay-as-you-go-Modell beginnt bei 1 Dollar pro GB und umfasst Traffic ohne Ablaufdatum. Es wird für Web Scraping, Werbeverifizierung, Preisüberwachung, Marktforschung und Multi-Account-Management genutzt.
Wichtige Fakten
- Web-Unblocker für AI: Ein Web-Unblocker ist eine verwaltete Scraping-API, die JavaScript-Rendering, CAPTCHA-Verarbeitung und Proxy-Rotation bündelt, um öffentliche Webseiten für AI-Training, RAG und Agenten-Pipelines abzurufen; die darunterliegende Proxy-Schicht ist eine separate, austauschbare Komponente.
- Bester Proxy-Typ: rotierende Residential-Proxys, die echte IPs von Endnutzern verwenden und Erkennungen passieren.
- Preis: ab 1 Dollar pro GB, Pay-as-you-go, mit Traffic ohne Ablaufdatum und ohne Abonnement.
- Abdeckung: mehr als 90 Mio. ethisch beschaffte IPs in 195 Ländern.
- Zuverlässigkeit: 99,51 % Erfolgsquote, mit 4,8 von 5 Punkten auf G2 bewertet.
- Protokolle und Targeting: HTTP, HTTPS und SOCKS5, einschließlich Länder-Targeting.
Was ist ein Web-Unblocker für AI?
Ein Web-Unblocker ist eine verwaltete Scraping-API, die eine Ziel-URL entgegennimmt, die nötige Arbeit zum Laden der Seite und Überwinden ihrer Schutzmechanismen erledigt und die Seiteninhalte bereit zur Verarbeitung zurückgibt. Für AI vermarktet, ist er das Tor zur Datenbeschaffung, das Trainings-Crawler, Jobs für Retrieval-Augmented Generation (RAG) und Browser-Agenten mit aktuellen öffentlichen Webdaten versorgt.
Hinter einem einzigen Endpoint bündelt ein typischer Web-Unblocker mehrere Dinge, die früher separate Tools waren:
- Proxy-Rotation: Anfragen werden über einen großen Pool von IP-Adressen verteilt, damit keine einzelne Adresse Ratenlimits oder Sperren auslöst.
- JavaScript-Rendering: Es führt einen echten oder Headless-Browser aus, sodass durch clientseitige Skripte eingefügte Inhalte im zurückgegebenen HTML enthalten sind.
- CAPTCHA- und Challenge-Verarbeitung: Es erkennt und verarbeitet Zwischenseiten, Bot-Prüfungen und Anti-Automatisierungs-Challenges.
- Fingerprint- und Header-Verwaltung: Es setzt realistische Browser-Fingerprints, TLS-Profile und Header, damit Anfragen wie gewöhnlicher Traffic aussehen.
Der entscheidende Unterschied liegt im Umfang. Ein Web-Unblocker ist die gesamte Abruf-Pipeline als Dienst. Ein Proxy-Anbieter liefert nur das IP-Netzwerk, auf dem die Rotation läuft. DataImpulse ist eine Proxy-Schicht und kein verwalteter Web-Unblocker, also eine Komponente dieses Stacks statt der Stack selbst.
Warum benötigen AI-Teams zuverlässigen Webzugang?
AI-Teams benötigen zuverlässigen Webzugang, weil die meisten ihrer Daten aus dem aktuellen öffentlichen Web stammen und jede Lücke beim Abruf zu einer Lücke im Wissen des Modells oder in der Handlungsfähigkeit eines Agenten wird. Drei Workloads treiben diese Nachfrage.
Trainingsdaten. Große Textkorpora entstehen durch das Crawlen öffentlicher Seiten im großen Maßstab. Wird ein Crawler bei einer Klasse von Websites blockiert, fehlen diese Quellen unbemerkt im Datensatz, was die Abdeckung verzerrt.
Retrieval-Augmented Generation. RAG-Systeme rufen zum Zeitpunkt der Anfrage aktuelle Seiten ab, um Antworten auf frischen Fakten zu stützen. Ein blockierter Abruf bedeutet hier nicht nur Datenverlust, sondern verschlechtert die Antwort, die der Nutzer gerade sieht.
Browser-Agenten. Autonome Agenten laden Seiten, um Preise zu lesen, Verfügbarkeit zu prüfen oder Aufgaben zu erledigen. Sie benötigen beständigen Zugang zu vielen Domains, oft aus bestimmten Ländern, und ein fehlgeschlagener Ladevorgang kann einen gesamten mehrstufigen Workflow aufhalten.
In allen drei Fällen ist der Fehlerfall derselbe: Eine Anfrage, die ein normaler Browser abschließen würde, wird geprüft oder abgelehnt, weil sie automatisiert aussieht oder aus einem markierten Netzwerk stammt. Zur Abrufseite dynamischer Websites behandelt unser Leitfaden zu dynamische Webseiten scrapen das Rendering-Problem ausführlicher.
Wie funktioniert ein Web-Unblocker?
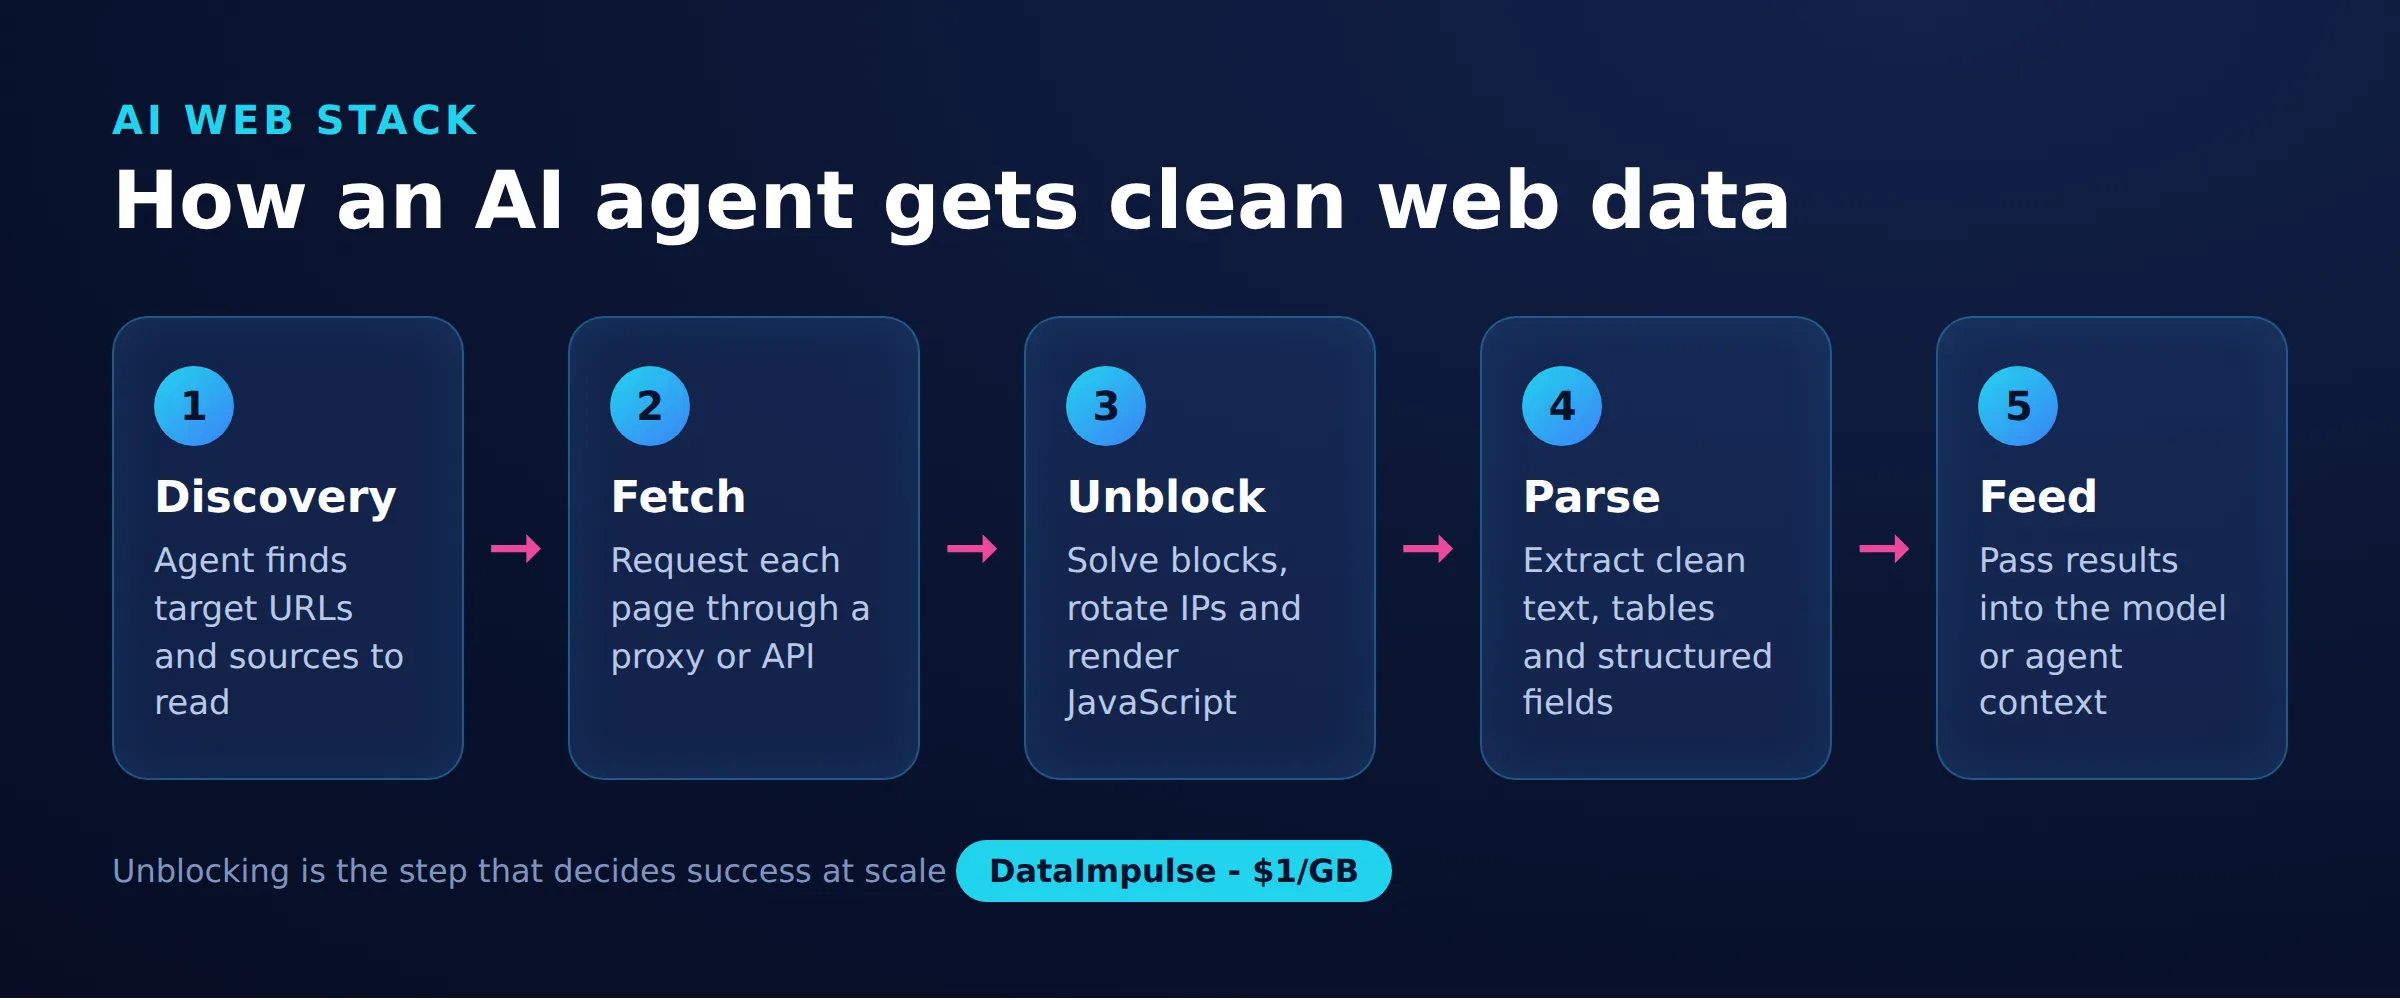
Ein Web-Unblocker verkettet eine feste Abfolge von Schritten zwischen Ihrem AI-System und der Zielseite. Wir nennen diese Abfolge das 5-Stufen-Modell für AI-Webzugang. Es ist eine hilfreiche Orientierung, unabhängig davon, ob Sie den Stack kaufen oder selbst zusammenstellen.
- Ermittlung: Entscheiden Sie, welche URLs abgerufen werden sollen: aus einer Seed-Liste, einer Sitemap, einer Crawl-Frontier oder der aktuellen Entscheidung eines Agenten.
- Abruf: Senden Sie die Anfrage über einen Proxy, sodass die Zielseite die Exit-IP statt Ihres Servers sieht.
- Freischaltung: Rendern Sie JavaScript, setzen Sie einen realistischen Fingerprint und lösen Sie jede Challenge, damit die Seite vollständig lädt.
- Verarbeitung: Extrahieren Sie die nützlichen Inhalte und entfernen Sie Navigation, Werbung und Standardbestandteile zu sauberem Text oder strukturierten Feldern.
- Übergabe: Übergeben Sie die bereinigten Inhalte an den Empfänger: einen Trainingssatz, einen Vector Store für RAG oder das Kontextfenster eines Agenten.
Ein verwalteter Web-Unblocker fasst Abruf und Freischaltung in einem API-Aufruf zusammen. Bei einer Eigenentwicklung steckt in diesen beiden Stufen der größte Entwicklungsaufwand, und das Proxy-Netzwerk ist das Fundament der Abrufstufe. Davor (Ermittlung) und danach (Verarbeitung, Übergabe) ist der Ablauf weitgehend gleich.
Sollten Sie einen verwalteten Unblocker kaufen oder selbst entwickeln?
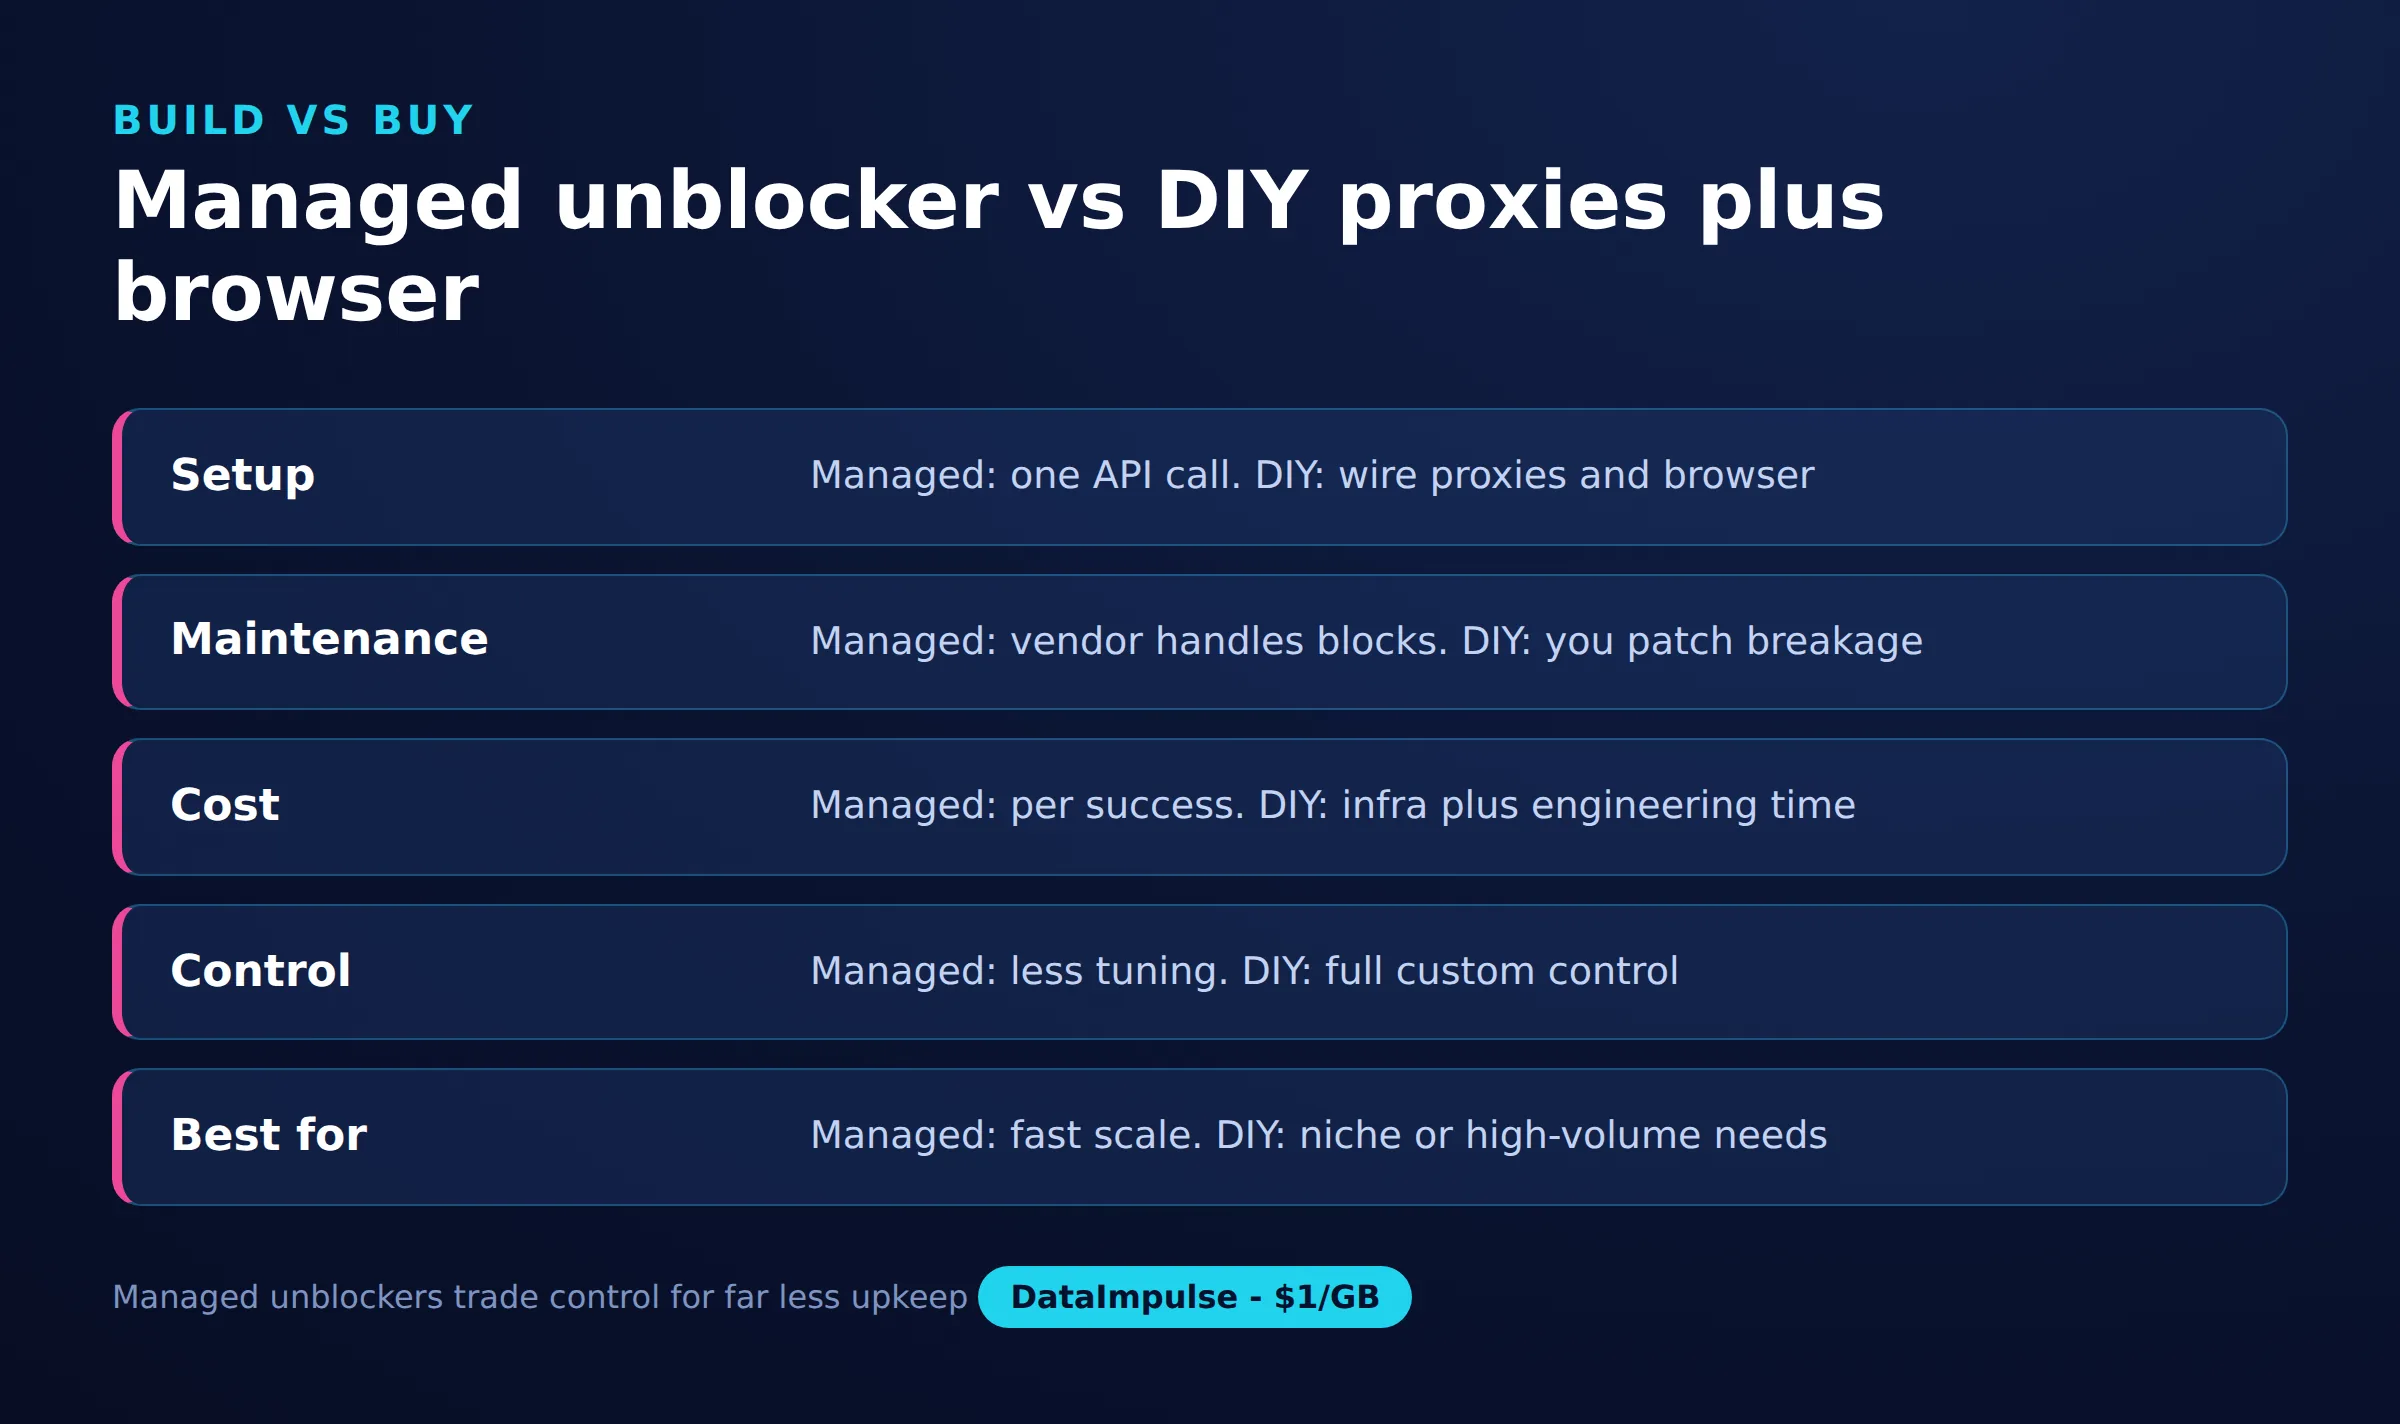
Kaufen Sie einen verwalteten Unblocker, wenn Geschwindigkeit und geringer Wartungsaufwand wichtiger sind als Kosten und Kontrolle. Stellen Sie Proxys plus Headless-Browser selbst zusammen, wenn Sie Transparenz, bessere Stückkosten im großen Maßstab oder individuelle Abruflogik benötigen. Die beiden Ansätze unterscheiden sich vor allem darin, wer die Freischaltungsstufe verantwortet.
| Faktor | Verwaltete Unblocker-API | Eigene Proxys plus Headless-Browser |
|---|---|---|
| Kontrolle | Gering; der Anbieter entscheidet über Rendering und Challenge-Logik | Hoch; Sie stimmen jede Anfrage und jeden Header ab |
| Kostenmodell | Preis pro erfolgreicher Anfrage, höhere Stückkosten | Preis pro GB Proxy-Traffic zuzüglich Ihrer Rechenleistung |
| Wartung | Anbieter übernimmt Änderungen bei Anti-Bot-Maßnahmen | Sie aktualisieren Fingerprints und Rendering selbst |
| Transparenz | Intransparent; schwer zu prüfen, wie eine Seite abgerufen wurde | Vollständige Sicht auf den gesamten Anfrageweg |
| Zeit bis zum ersten Abruf | Schnell; ein API-Aufruf | Langsamer; Sie verbinden zuerst Browser und Proxy |
Die Entscheidungsmatrix in Kürze:
- Nutzen Sie einen verwalteten Unblocker, wenn Ihrem Team Scraping-Infrastruktur fehlt, Ziele stark geschützt sind, die Volumina moderat sind und Entwicklungszeit knapp ist.
- Stellen Sie Proxys plus Browser selbst zusammen, wenn Sie hohe Volumina verarbeiten, die Kosten pro Datensatz kontrollieren müssen, genau prüfen möchten, wie jede Seite abgerufen wurde, oder besondere Rendering-Anforderungen haben.
- Vermeiden Sie einen verwalteten Unblocker, wenn die Preise pro Anfrage in Ihrem Maßstab die Kosten eigener Proxys und Rechenleistung übersteigen oder Intransparenz eine Compliance-Prüfung verhindert.
Viele Teams nutzen einen hybriden Ansatz: einen eigenen Web-Scraping-Proxy plus Headless-Browser für den Großteil der einfachen Ziele und einen verwalteten Unblocker nur für die schwierigsten Websites.
Welche Rolle spielen Proxys, und warum sind Residential IPs wichtig?
Proxys sind die Netzwerkschicht der Abrufstufe: Sie geben jeder Anfrage eine andere Exit-IP, sodass das Ziel normalen Traffic statt einer Flut von einem Server sieht. Ob Sie einen Unblocker kaufen oder selbst bauen, die darunterliegende Rotation übernimmt ein Proxy-Pool. Diese Schicht stellt DataImpulse bereit.
Residential IPs sind für AI-Webzugang wichtig, weil Internetdienstanbieter sie echten Haushalten zuweisen und sie sich daher dort unauffällig einfügen, wo Datacenter-Bereiche oft vorab markiert sind. Für Crawler, die verbraucherorientierte Websites aufrufen, entscheidet dieser Unterschied häufig darüber, ob eine Seite lädt oder blockiert wird. DataImpulse bietet für diesen Fall Residential-Proxys sowie Datacenter-Proxys für günstigere Ziele und Mobile-Proxys für die schwierigsten Fälle.
Hier ist die eigene Abrufstufe in ihrer einfachsten Form: eine HTTP-Anfrage über einen rotierenden Residential-Proxy, bereit für die Übergabe an eine AI-Pipeline. DataImpulse unterstützt HTTP, HTTPS und SOCKS5; Länder-Targeting ist im Grundpreis enthalten.
import requests

proxy = "http://USERNAME:[email protected]:823"
resp = requests.get(
    "https://example.com/product/123",
    proxies={"http": proxy, "https": proxy},
    timeout=30,
)
html = resp.text  # hand this to your parser, then your RAG store
Bei Seiten, die ihren Inhalt erst im Browser zusammensetzen, ergänzen Sie einen Headless-Browser, damit JavaScript ausgeführt wird, bevor Sie das DOM lesen. Derselbe rotierende Proxy wird direkt an den Browser-Kontext übergeben.
from playwright.sync_api import sync_playwright

proxy = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}
with sync_playwright() as p:
    browser = p.chromium.launch(proxy=proxy, headless=True)
    page = browser.new_page()
    page.goto("https://example.com/product/123", wait_until="networkidle")
    content = page.content()  # rendered HTML for the AI pipeline
    browser.close()
Rotierende Sitzungen geben jeder Anfrage eine frische IP, was sich für breit angelegtes Crawling eignet. Sticky Sessions halten dagegen eine IP über einen mehrstufigen Ablauf wie eine angemeldete Agentenaufgabe hinweg. DataImpulse unterstützt beides.
Welche ethischen und rechtlichen Grenzen hat Web-Unblocking für AI?
Web-Unblocking für AI sollte auf öffentliche Daten beschränkt sein, die in angemessenem Tempo und über mit Einwilligung beschaffte IPs gesammelt werden. Das Umgehen einer technischen Sperre ist keine Lizenz, die Regeln für die Daten selbst zu ignorieren. AI-Teams tragen diese Verantwortung auch dann, wenn ein Anbieter den Abruf übernimmt.
Unabhängig vom Tool gelten einige dauerhafte Grundsätze:
- Nur öffentliche Daten: Rufen Sie Seiten ab, die ohne Anmeldung und ohne Überwindung von Zugriffskontrollen offen erreichbar sind; scrapen Sie keine privaten oder kostenpflichtigen Inhalte, für die Sie keine Berechtigung haben.
- robots.txt und Bedingungen beachten: Lesen Sie die robots.txt und Nutzungsbedingungen jeder Website und verstehen Sie sie als Hinweis darauf, was der Betreiber erlaubt.
- Eigene Raten begrenzen: Verteilen Sie Anfragen zeitlich, damit Sie den Dienst des Ziels nicht beeinträchtigen, auch wenn die Rotation ein höheres Tempo zuließe.
- IPs ethisch beschaffen: Das von Ihnen genutzte Proxy-Netzwerk sollte aus Nutzern bestehen, die zustimmen und vergütet werden, nicht aus übernommenen Geräten.
In der IP-Schicht entscheidet sich in der Praxis die ethische Qualität einer Pipeline. DataImpulse bezieht seine IPs von Nutzern, die zustimmen und vergütet werden, orientiert sich an der GDPR und bietet eine Vereinbarung zur Datenverarbeitung. Unser Überblick über ethische Proxys erläutert dieses Beschaffungsmodell. Ethische Beschaffung macht einen konkreten Scrape für sich genommen nicht rechtmäßig. Behandeln Sie die rechtliche Prüfung daher als separaten Schritt.
Welche Einschränkungen hat ein Web-Unblocker für AI?
Ein Web-Unblocker beseitigt Reibung beim Abruf, nicht jedoch die schwierigeren Probleme von Datenqualität, Kostenkontrolle und Compliance. Auch ist keine Proxy-Schicht allein ein vollständiger Unblocker. Die Grenzen zu kennen, schafft realistische Erwartungen.
- Er beurteilt keine Datenqualität: Eine Seite kann perfekt laden und dennoch Spam, veraltet oder falsch sein; Verarbeitung und Validierung bleiben Ihre Aufgabe.
- Er erteilt keine rechtliche Erlaubnis: Das Überwinden einer Bot-Prüfung sagt nichts darüber aus, ob Sie diese Inhalte sammeln oder wiederverwenden dürfen.
- Verwaltete APIs sind intransparent und werden pro Anfrage berechnet: Sie tauschen Sichtbarkeit und Stückkosten gegen Komfort, was bei hohem Volumen nachteilig sein kann.
- Schwierige Ziele scheitern bisweilen dennoch: Kein Unblocker erreicht eine Erfolgsquote von 100 Prozent, und stark geschützte oder durch Anmeldung abgeschirmte Websites können unerreichbar bleiben.
- Ein Proxy ist nicht der gesamte Stack: Die Rotation übernimmt die Netzwerkschicht, aber Sie benötigen weiterhin Rendering, Verarbeitung und Orchestrierung darum herum.
Zum letzten Punkt: Seien Sie präzise darin, was DataImpulse ist. Es stellt die Proxy-Schicht bereit: mehr als 90 Millionen Residential-, Mobile- und Datacenter-IPs in 195 Ländern mit einer Erfolgsquote von 99,51 Prozent, ab 1 Dollar pro GB. Es verkauft keine statischen ISP-Proxys, ist keine verwaltete Scraping-API und kein Web-Unblocker und auch kein kostenloser Web-Proxy-Dienst. Den umfassenderen Leitfaden gegen Blockierungen finden Sie in unserem Beitrag über Scraping ohne blockiert zu werden.
Häufig gestellte Fragen
Ist ein Web-Unblocker dasselbe wie ein Proxy?
Nein. Ein Web-Unblocker ist eine verwaltete API, die Proxy-Rotation mit JavaScript-Rendering und CAPTCHA-Verarbeitung bündelt und eine fertige Seite zurückgibt. Ein Proxy-Anbieter liefert nur das rotierende IP-Netzwerk, auf dem die Abrufstufe läuft. Es ist eine Komponente innerhalb eines Unblockers.
Benötige ich Residential-Proxys für AI-Webzugang?
Bei verbraucherorientierten Websites oft ja, denn Residential IPs werden echten Haushalten zugewiesen und fügen sich dort unauffällig ein, wo Datacenter-Bereiche häufig vorab markiert sind. Für leicht geschützte oder interne Ziele können günstigere Datacenter-Proxys genügen.
Kann DataImpulse als Web-Unblocker für meine AI-Pipeline dienen?
DataImpulse stellt die Proxy-Schicht bereit, keinen verwalteten Unblocker. Es liefert rotierende und Sticky Residential-, Mobile- und Datacenter-IPs, die Sie mit Ihrem eigenen Headless-Browser und Parser kombinieren oder als Netzwerkkomponente in einen verwalteten Unblocker einspeisen.
Ist das Scrapen öffentlicher Webdaten für AI legal?
Das hängt von der Rechtsordnung, den Bedingungen der Website und der Nutzung der Daten ab. Behandeln Sie die rechtliche Prüfung daher als eigenen Schritt. Die Beschränkung auf öffentliche Daten, die Beachtung von robots.txt und Ratenlimits sowie ethisch beschaffte IPs senken das Risiko, ersetzen aber keine Rechtsberatung.
Wann sollte ich meinen eigenen Abruf-Stack entwickeln, statt einen Unblocker zu kaufen?
Entwickeln Sie selbst, wenn das Volumen so hoch ist, dass die Preise pro Anfrage schmerzen, wenn Sie genau prüfen müssen, wie jede Seite abgerufen wurde, oder wenn Sie individuelle Rendering-Anforderungen haben. Rotierende Proxys plus Headless-Browser geben Ihnen diese Kontrolle zu Kosten für Proxy-Traffic.
Wann ist DataImpulse nicht die richtige Wahl?
Wenn Sie statische ISP-Proxys, eine vollständig verwaltete Scraping-API oder Zugang zu Banking- und Regierungswebsites benötigen, ist DataImpulse nicht das richtige Tool. Es konzentriert sich auf rotierende Residential-, Mobile- und Datacenter-Proxys für das Sammeln öffentlicher Daten und den Zugriff auf Inhalte.
Weiterführende Leitfäden
Holen Sie sich die Proxy-Schicht für Ihre AI-Pipeline
Wenn Sie die Abrufstufe selbst entwickeln, muss die darunterliegende Netzwerkschicht stimmen. Sie können ein DataImpulse-Konto erstellen und Ihren Crawler oder Agenten über rotierende Residential-, Mobile- oder Datacenter-IPs leiten, im Pay-as-you-go-Modell ab 1 Dollar pro GB einschließlich Länder-Targeting.