
In this Article
web unblocker สำหรับ AI คือบริการแบบจัดการให้ที่ดึงหน้าเว็บสาธารณะตามต้องการและส่งคืน HTML ที่สะอาดหรือเนื้อหาที่เรนเดอร์แล้ว เพื่อให้โมเดลภาษา ไปป์ไลน์การดึงข้อมูล และเอเจนต์อัตโนมัติอ่านเว็บแบบเรียลไทม์ได้โดยไม่ถูกบล็อก บทความนี้อธิบายว่า web unblocker ทำอะไรจริง เหตุใดทีม AI จึงต้องการการเข้าถึงเว็บที่เชื่อถือได้ และเมื่อดูรายละเอียดแล้วการเลือกระหว่างสร้างเองกับซื้อมีผลอย่างไร
บทความนี้ยังแบ่งเส้นให้ชัดเจนในจุดที่ผู้ขายมักทำให้คลุมเครือ web unblocker คือสแต็กการดึงข้อมูลครบชุด ส่วนผู้ให้บริการ proxy อย่าง DataImpulse คือชั้นเครือข่ายที่อยู่ภายในสแต็กนั้น การรู้ว่ากำลังซื้อส่วนใดส่งผลต่อทั้งต้นทุนและการควบคุม
DataImpulse คือผู้ให้บริการ proxy ที่มีจริยธรรม ให้บริการ IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการ ครอบคลุม 195 ประเทศ ใช้โมเดลจ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมทราฟฟิกไม่หมดอายุ และใช้สำหรับ web scraping, ad verification, การติดตามราคา, การวิจัยตลาด และการจัดการหลายบัญชี
ข้อมูลสำคัญ
- Web unblocker สำหรับ AI: web unblocker คือ API สำหรับ scraping แบบจัดการให้ที่รวมการเรนเดอร์ JavaScript การจัดการ CAPTCHA และการหมุนเวียน proxy เพื่อดึงหน้าเว็บสาธารณะสำหรับการฝึก AI, RAG และไปป์ไลน์เอเจนต์ โดยชั้น proxy ที่อยู่ข้างใต้เป็นองค์ประกอบแยกต่างหากที่สลับเปลี่ยนได้
- ประเภท proxy ที่เหมาะที่สุด: rotating residential proxies ซึ่งใช้ IP ของผู้บริโภคจริงที่หลบเลี่ยงการตรวจจับได้
- ราคา: เริ่มต้นที่ 1 ดอลลาร์ต่อ GB จ่ายตามการใช้งาน ทราฟฟิกไม่หมดอายุ และไม่มีค่าบริการสมาชิก
- ความครอบคลุม: IP ที่จัดหาตามหลักจริยธรรมมากกว่า 90M+ ครอบคลุม 195 ประเทศ
- ความน่าเชื่อถือ: อัตราความสำเร็จ 99.51% ได้คะแนน 4.8 จาก 5 บน G2
- โปรโตคอลและการกำหนดเป้าหมาย: HTTP, HTTPS และ SOCKS5 พร้อมการกำหนดเป้าหมายตามประเทศ
web unblocker สำหรับ AI คืออะไร?
web unblocker คือ API สำหรับ scraping แบบจัดการให้ที่รับ URL เป้าหมาย ดำเนินการตามที่จำเป็นเพื่อโหลดหน้าเว็บและผ่านการป้องกันของเว็บไซต์ แล้วส่งคืนเนื้อหาหน้าพร้อมสำหรับการแยกวิเคราะห์ เมื่อทำตลาดสำหรับ AI มันคือประตูหน้าสำหรับการเก็บข้อมูลที่คอยป้อนข้อมูลเว็บสาธารณะใหม่ให้ crawler สำหรับการฝึก งาน retrieval-augmented generation (RAG) และเอเจนต์ท่องเว็บ
ภายใต้ endpoint เดียว web unblocker ทั่วไปจะรวมสิ่งต่างๆ ที่เคยเป็นเครื่องมือแยกกันไว้:
- การหมุนเวียน proxy: มันสลับคำขอผ่านกลุ่ม IP จำนวนมาก เพื่อไม่ให้ที่อยู่ใดที่อยู่หนึ่งถูกจำกัดอัตราหรือถูกแบน
- การเรนเดอร์ JavaScript: มันเรียกใช้เบราว์เซอร์จริงหรือ headless browser เพื่อให้เนื้อหาที่สคริปต์ฝั่งไคลเอนต์แทรกไว้ปรากฏใน HTML ที่ส่งคืน
- การจัดการ CAPTCHA และความท้าทาย: มันตรวจจับและจัดการหน้าคั่น การตรวจสอบบอต และความท้าทายต่อต้านระบบอัตโนมัติ
- การจัดการ fingerprint และ header: มันตั้งค่า fingerprint ของเบราว์เซอร์ โปรไฟล์ TLS และ header ให้สมจริง เพื่อให้คำขอดูเหมือนทราฟฟิกปกติ
ความแตกต่างสำคัญคือขอบเขต web unblocker คือไปป์ไลน์การดึงข้อมูลทั้งชุดที่ขายเป็นบริการ ผู้ให้บริการ proxy ให้เฉพาะเครือข่าย IP ที่ใช้หมุนเวียน DataImpulse คือชั้น proxy ไม่ใช่ web unblocker แบบจัดการให้ จึงเป็นข้อมูลนำเข้าอย่างหนึ่งของสแต็กนั้น ไม่ใช่ตัวสแต็กเอง
เหตุใดทีม AI จึงต้องการการเข้าถึงเว็บที่เชื่อถือได้?
ทีม AI ต้องการการเข้าถึงเว็บที่เชื่อถือได้ เพราะข้อมูลส่วนใหญ่มาจากเว็บสาธารณะแบบเรียลไทม์ และช่องว่างในการดึงข้อมูลจะกลายเป็นช่องว่างในความรู้ของโมเดลหรือความสามารถของเอเจนต์ในการทำงาน มีภาระงาน 3 ประเภทที่ผลักดันความต้องการนี้
ข้อมูลฝึกสอน. คลังข้อความขนาดใหญ่สร้างขึ้นโดยการ crawl หน้าเว็บสาธารณะในวงกว้าง หาก crawler ถูกบล็อกจากเว็บไซต์กลุ่มหนึ่ง แหล่งข้อมูลเหล่านั้นจะหายไปจากชุดข้อมูลโดยไม่รู้ตัว ทำให้ความครอบคลุมบิดเบือน
Retrieval-augmented generation. ระบบ RAG ดึงหน้าปัจจุบันขณะมีคำค้น เพื่อยึดคำตอบกับข้อเท็จจริงใหม่ การดึงข้อมูลที่ถูกบล็อกตรงนี้ไม่ได้เพียงทำให้ข้อมูลหาย แต่ยังลดคุณภาพคำตอบที่ผู้ใช้เห็นในขณะนั้น
เอเจนต์ท่องเว็บ. เอเจนต์อัตโนมัติโหลดหน้าเว็บเพื่ออ่านราคา ตรวจสอบความพร้อมใช้งาน หรือทำงานให้เสร็จ พวกเขาต้องเข้าถึงหลายโดเมนได้อย่างสม่ำเสมอ ซึ่งมักมาจากประเทศที่ระบุ และการโหลดล้มเหลวอาจทำให้เวิร์กโฟลว์หลายขั้นตอนทั้งหมดหยุดชะงัก
ทั้ง 3 กรณีมีรูปแบบความล้มเหลวเหมือนกัน คือคำขอที่เบราว์เซอร์ปกติทำสำเร็จกลับถูกท้าทายหรือปฏิเสธ เพราะดูเป็นระบบอัตโนมัติหรือมาจากเครือข่ายที่ถูกทำเครื่องหมายไว้ สำหรับด้านการดึงข้อมูลของเว็บไซต์แบบไดนามิก คู่มือของเราเรื่อง การ scrape หน้าเว็บแบบไดนามิก อธิบายปัญหาการเรนเดอร์อย่างละเอียดขึ้น
web unblocker ทำงานอย่างไร?
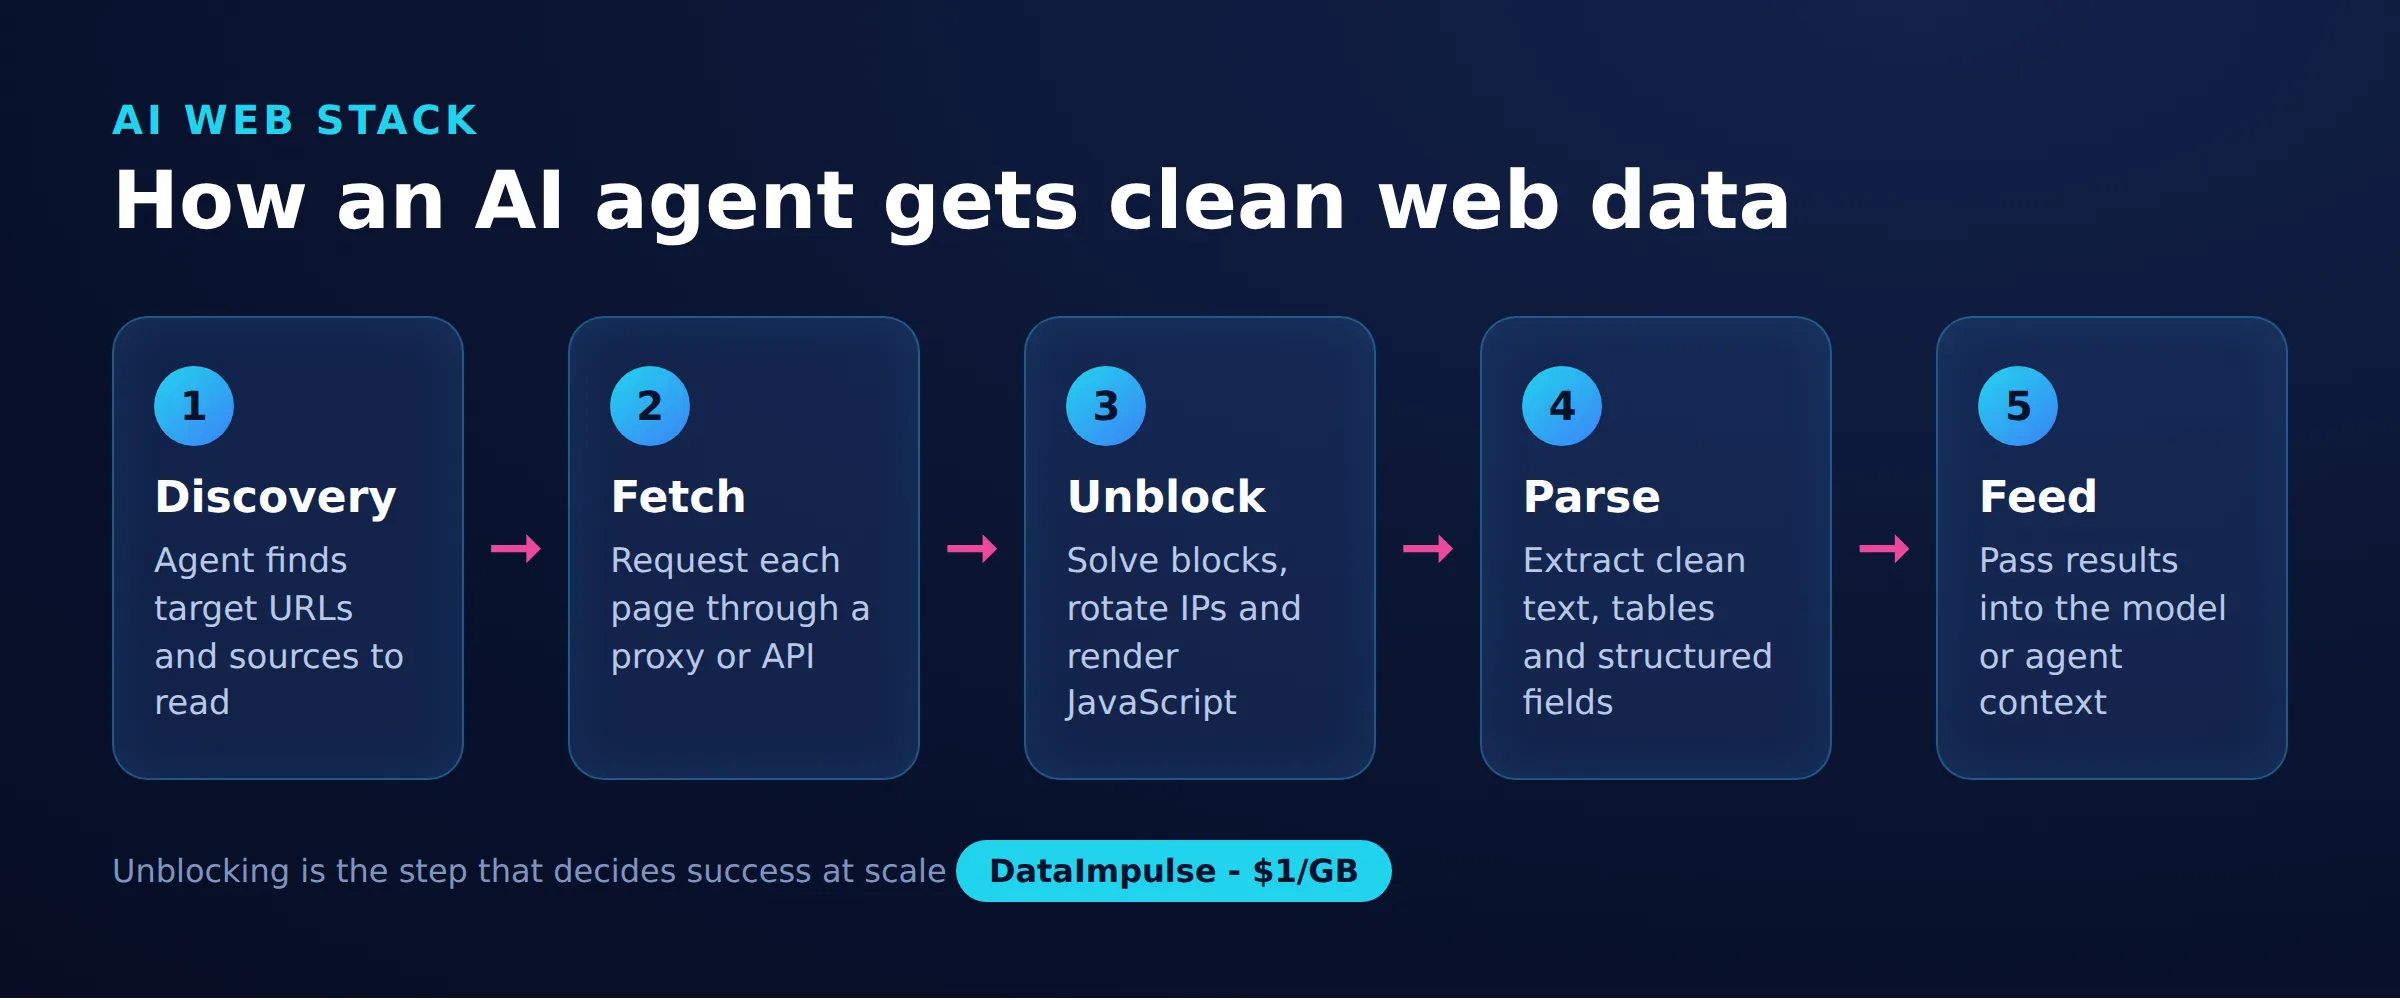
web unblocker ทำงานโดยเชื่อมลำดับขั้นตอนคงที่ระหว่างระบบ AI ของคุณกับเว็บไซต์เป้าหมาย เราเรียกลำดับนี้ว่าโมเดลการเข้าถึงเว็บสำหรับ AI 5 ขั้นตอน ซึ่งเป็นแผนที่ที่มีประโยชน์ไม่ว่าคุณจะซื้อสแต็กหรือประกอบเอง
- การค้นหา: ตัดสินใจว่าจะดึง URL ใด จากรายการตั้งต้น sitemap ขอบเขตการ crawl หรือการตัดสินใจแบบเรียลไทม์ของเอเจนต์
- การดึงข้อมูล: ส่งคำขอผ่าน proxy เพื่อให้เว็บไซต์เป้าหมายเห็น IP ขาออก ไม่ใช่เซิร์ฟเวอร์ของคุณ
- การปลดบล็อก: เรนเดอร์ JavaScript ตั้งค่า fingerprint ที่สมจริง และแก้ความท้าทายต่างๆ เพื่อให้หน้าเว็บโหลดครบถ้วน
- การแยกวิเคราะห์: แยกเนื้อหาที่มีประโยชน์และตัดการนำทาง โฆษณา และข้อความแม่แบบออกเป็นข้อความสะอาดหรือฟิลด์ที่มีโครงสร้าง
- การป้อนข้อมูล: ส่งเนื้อหาที่ทำความสะอาดแล้วให้ผู้ใช้ ชุดฝึกสอน vector store สำหรับ RAG หรือหน้าต่างบริบทของเอเจนต์
web unblocker แบบจัดการให้รวมขั้นตอนดึงข้อมูลและปลดบล็อกไว้ใน API call เดียว เมื่อสร้างเอง ทั้ง 2 ขั้นตอนนี้คือจุดที่ใช้ความพยายามด้านวิศวกรรมส่วนใหญ่ และเครือข่าย proxy คือรากฐานของขั้นตอนดึงข้อมูล ไม่ว่าจะเลือกทางใด สิ่งที่อยู่ต้นทาง (การค้นหา) และปลายทาง (การแยกวิเคราะห์ การป้อนข้อมูล) โดยรวมเหมือนกัน
ควรซื้อ unblocker แบบจัดการให้หรือสร้างเอง?
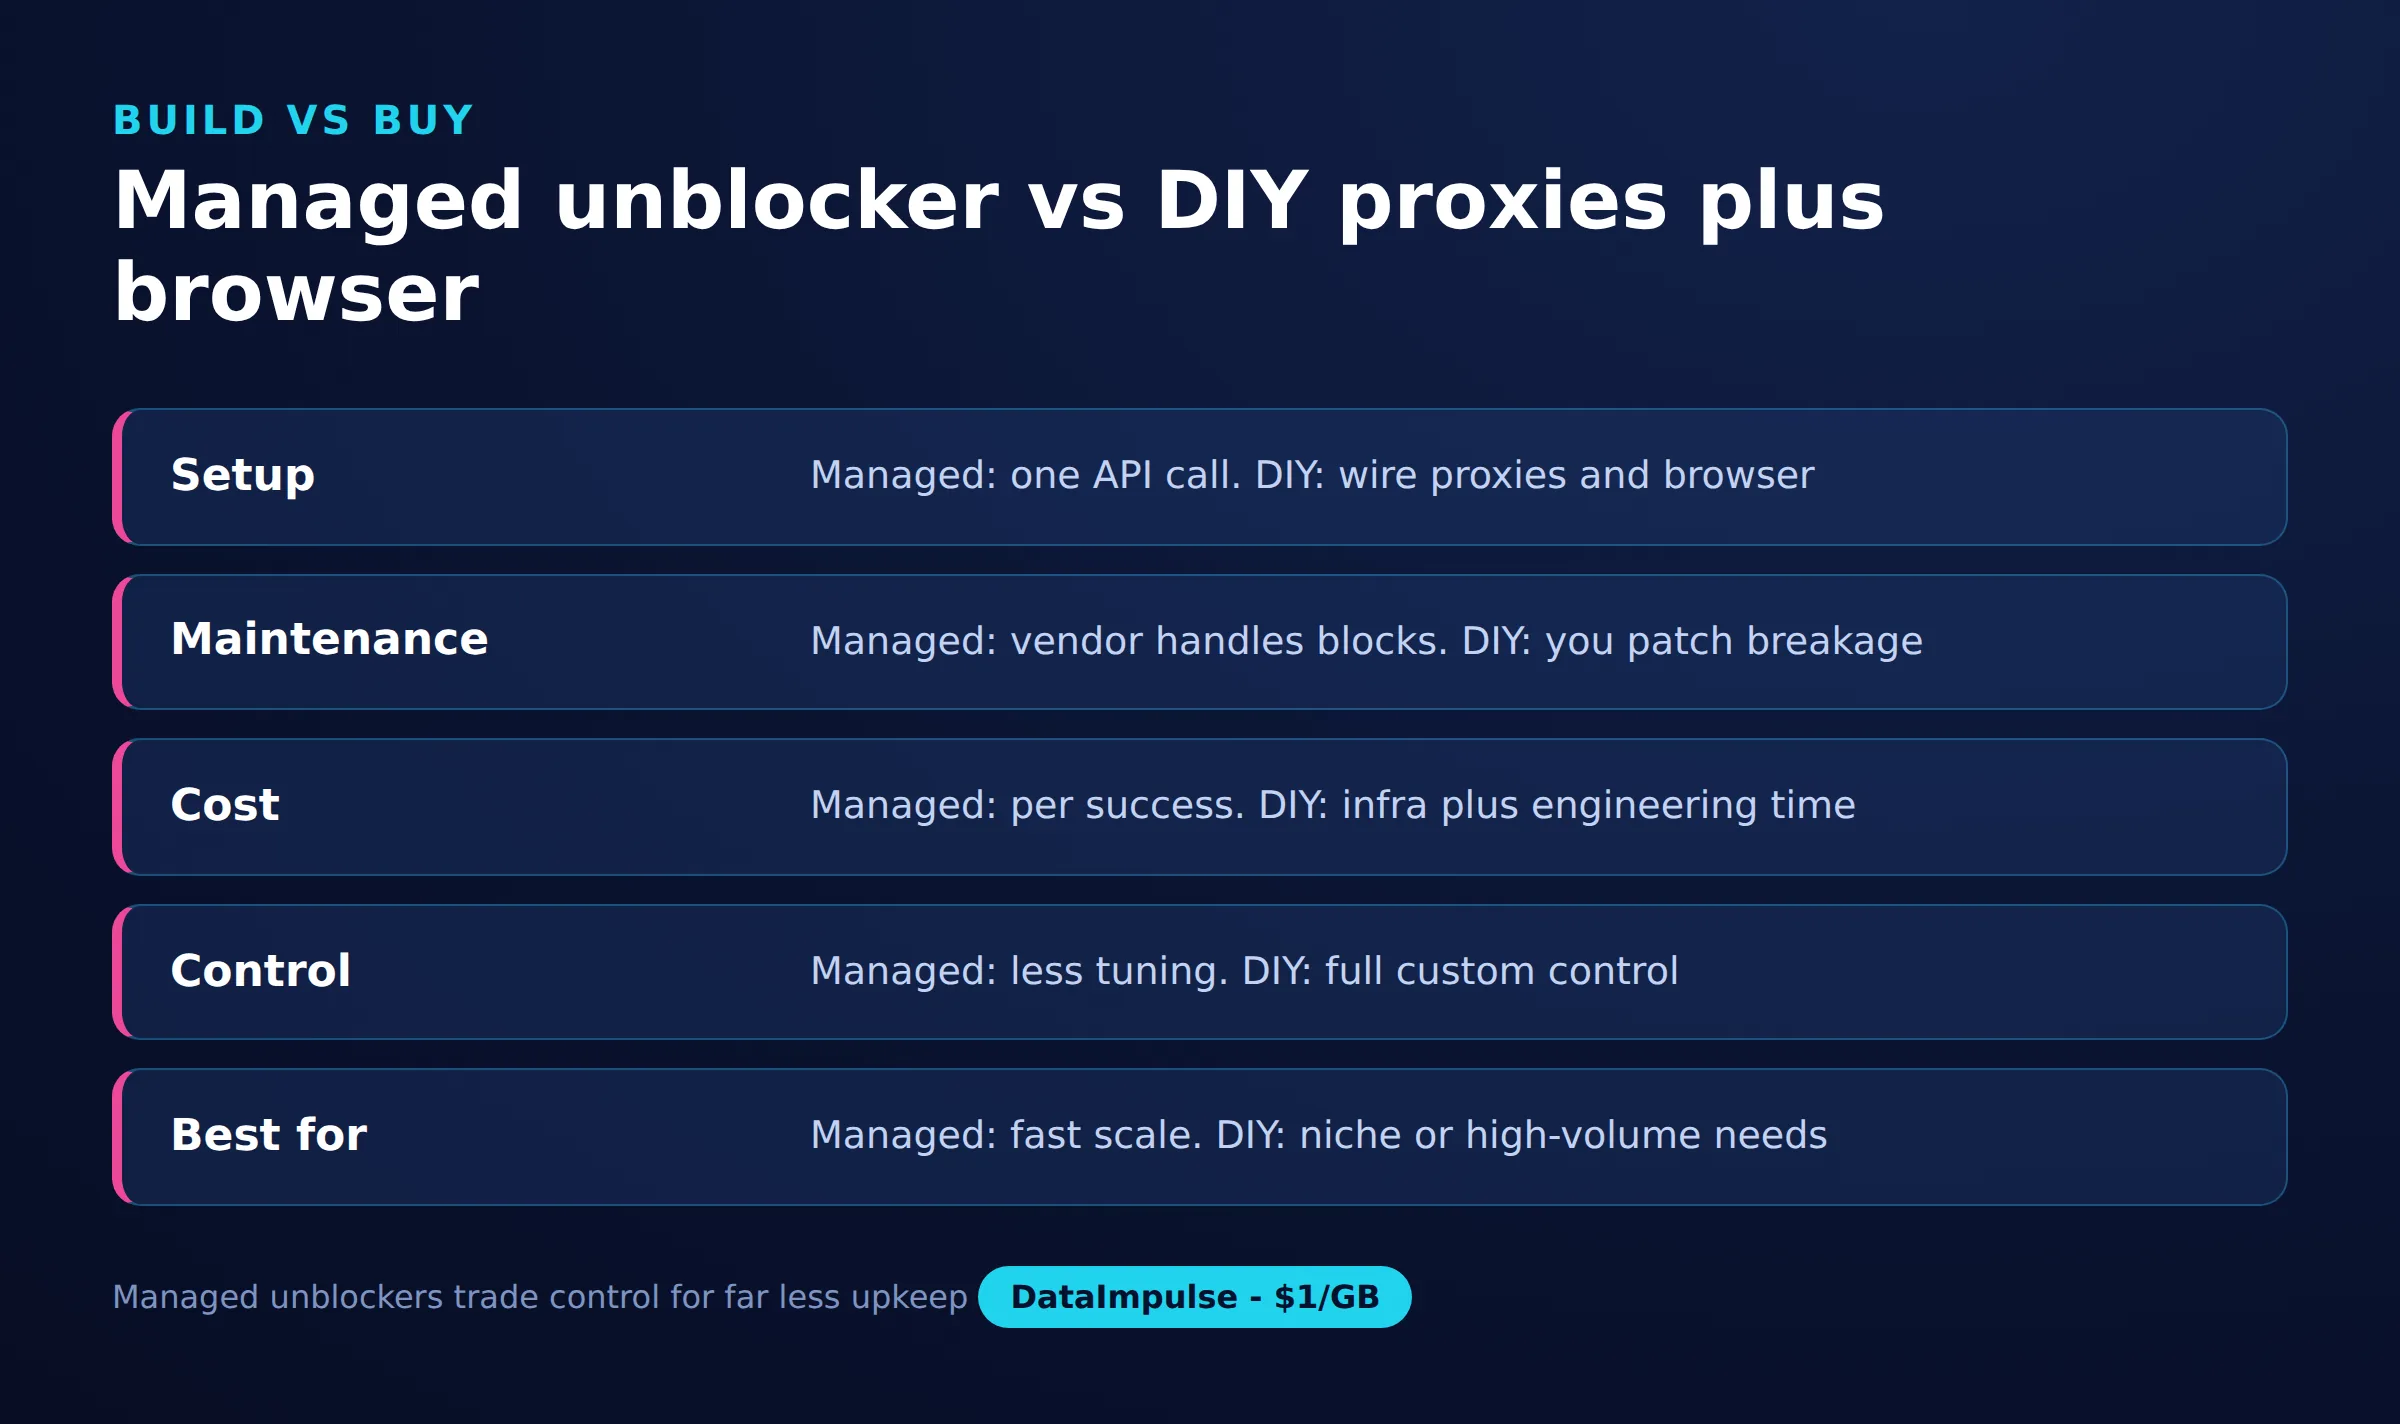
ซื้อ unblocker แบบจัดการให้เมื่อความเร็วและการดูแลรักษาน้อยสำคัญกว่าต้นทุนและการควบคุม ประกอบ proxy กับ headless browser เองเมื่อคุณต้องการความโปร่งใส ต้นทุนต่อหน่วยที่เหมาะสมกว่าเมื่อขยายขนาด หรือตรรกะการดึงข้อมูลแบบกำหนดเอง ทั้ง 2 แนวทางต่างกันหลักๆ ที่ผู้รับผิดชอบขั้นตอนปลดบล็อก
| ปัจจัย | API ของ unblocker แบบจัดการให้ | proxy แบบทำเองร่วมกับ headless browser |
|---|---|---|
| การควบคุม | ต่ำ ผู้ขายเป็นผู้ตัดสินใจเรื่องการเรนเดอร์และตรรกะความท้าทาย | สูง คุณปรับแต่งทุกคำขอและ header |
| โมเดลต้นทุน | คิดราคาต่อคำขอที่สำเร็จ ต้นทุนต่อหน่วยสูงกว่า | คิดราคาต่อ GB ของทราฟฟิก proxy บวกค่า compute ของคุณ |
| การดูแลรักษา | ผู้ขายรับมือการเปลี่ยนแปลงต่อต้านบอต | คุณ patch fingerprint และการเรนเดอร์ด้วยตนเอง |
| ความโปร่งใส | ไม่โปร่งใส ตรวจสอบได้ยากว่าหน้าเว็บถูกดึงมาอย่างไร | มองเห็นเส้นทางคำขอทั้งหมดอย่างครบถ้วน |
| เวลาจนถึงการดึงครั้งแรก | รวดเร็ว ใช้ API call เดียว | ช้ากว่า คุณต้องเชื่อมเบราว์เซอร์กับ proxy ก่อน |
สรุปตารางตัดสินใจ:
- ใช้ unblocker แบบจัดการให้เมื่อ ทีมของคุณไม่มีโครงสร้างพื้นฐานสำหรับ scraping เป้าหมายมีการป้องกันแน่นหนา ปริมาณงานปานกลาง และเวลาเชิงวิศวกรรมเป็นทรัพยากรที่ขาดแคลน
- ประกอบ proxy กับเบราว์เซอร์เองเมื่อ คุณมีปริมาณงานสูง ต้องควบคุมต้นทุนต่อระเบียน ต้องการตรวจสอบว่าหน้าเว็บแต่ละหน้าถูกดึงมาอย่างไร หรือมีความต้องการการเรนเดอร์ที่ไม่ปกติ
- หลีกเลี่ยง unblocker แบบจัดการให้เมื่อ การคิดราคาต่อคำขอในขนาดงานของคุณสูงกว่าต้นทุนการใช้งาน proxy และ compute ของตนเอง หรือเมื่อความไม่โปร่งใสขัดขวางการตรวจสอบการปฏิบัติตามข้อกำหนด
หลายทีมใช้แนวทางผสม คือมี web scraping proxy ของตนเองร่วมกับ headless browser สำหรับเป้าหมายที่ง่ายเป็นส่วนใหญ่ และใช้ unblocker แบบจัดการให้เฉพาะเว็บไซต์ที่ยากที่สุด
proxy อยู่ตรงไหน และเหตุใด residential IP จึงสำคัญ?
proxy คือชั้นเครือข่ายของขั้นตอนดึงข้อมูล โดยให้ IP ขาออกที่ต่างกันแก่แต่ละคำขอ เพื่อให้เป้าหมายเห็นทราฟฟิกปกติแทนการพุ่งขึ้นจากเซิร์ฟเวอร์เดียว ไม่ว่าคุณจะซื้อ unblocker หรือสร้างเอง กลุ่ม proxy จะทำการหมุนเวียนอยู่ด้านล่าง นี่คือชั้นที่ DataImpulse ให้บริการ
residential IP สำคัญต่อการเข้าถึงเว็บสำหรับ AI เพราะเป็นที่อยู่ที่ผู้ให้บริการอินเทอร์เน็ตกำหนดให้บ้านจริง จึงกลมกลืนได้ในจุดที่ช่วง IP ของ datacenter มักถูกทำเครื่องหมายไว้ล่วงหน้า สำหรับ crawler ที่เข้าถึงเว็บไซต์สำหรับผู้บริโภค ความต่างนี้มักเป็นสิ่งที่แยกระหว่างหน้าเว็บที่โหลดสำเร็จกับการถูกบล็อก DataImpulse มี residential proxies สำหรับกรณีนี้ พร้อม datacenter proxies สำหรับเป้าหมายที่ป้องกันน้อยกว่า และ mobile proxies สำหรับเป้าหมายที่ยากที่สุด
นี่คือขั้นตอนดึงข้อมูลแบบ DIY ในรูปแบบที่ง่ายที่สุด คือคำขอ HTTP หนึ่งครั้งผ่าน rotating residential proxy พร้อมป้อนให้ไปป์ไลน์ AI DataImpulse รองรับ HTTP, HTTPS และ SOCKS5 โดยรวมการกำหนดเป้าหมายตามประเทศไว้ในอัตราพื้นฐาน
import requests

proxy = "http://USERNAME:[email protected]:823"
resp = requests.get(
    "https://example.com/product/123",
    proxies={"http": proxy, "https": proxy},
    timeout=30,
)
html = resp.text  # hand this to your parser, then your RAG store
สำหรับหน้าเว็บที่ประกอบเนื้อหาในเบราว์เซอร์เท่านั้น ให้เพิ่ม headless browser เพื่อให้ JavaScript ทำงานก่อนอ่าน DOM โดยส่ง rotating proxy เดียวกันไปยัง browser context โดยตรง
from playwright.sync_api import sync_playwright

proxy = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}
with sync_playwright() as p:
    browser = p.chromium.launch(proxy=proxy, headless=True)
    page = browser.new_page()
    page.goto("https://example.com/product/123", wait_until="networkidle")
    content = page.content()  # rendered HTML for the AI pipeline
    browser.close()
เซสชันแบบหมุนเวียนให้ IP ใหม่แก่แต่ละคำขอ ซึ่งเหมาะกับการ crawl ในวงกว้าง ขณะที่ sticky session จะคง IP เดียวตลอดโฟลว์หลายขั้นตอน เช่น งานของเอเจนต์ที่เข้าสู่ระบบแล้ว DataImpulse รองรับทั้งสองแบบ
ขอบเขตด้านจริยธรรมและกฎหมายของการปลดบล็อกเว็บสำหรับ AI คืออะไร?
การปลดบล็อกเว็บสำหรับ AI ควรจำกัดอยู่ที่ข้อมูลสาธารณะ เก็บรวบรวมในอัตราที่ให้ความเคารพ และจาก IP ที่จัดหามาโดยได้รับความยินยอม การข้ามบล็อกทางเทคนิคไม่ใช่ใบอนุญาตให้เพิกเฉยต่อกฎเกี่ยวกับข้อมูลนั้น และทีม AI ยังคงรับผิดชอบแม้ผู้ขายจะเป็นผู้ดึงข้อมูล
มีหลักการสำคัญบางประการที่ใช้ได้ไม่ว่าเครื่องมือใด:
- เฉพาะข้อมูลสาธารณะ: ดึงหน้าเว็บที่เข้าถึงได้อย่างเปิดเผยโดยไม่ต้องเข้าสู่ระบบหรือเอาชนะการควบคุมการเข้าถึง อย่า scrape เนื้อหาส่วนตัวหรือเนื้อหาหลัง paywall ที่คุณไม่ได้รับอนุญาตให้ดู
- เคารพ robots และข้อกำหนด: อ่าน robots.txt และข้อกำหนดการให้บริการของแต่ละเว็บไซต์ และถือว่าสิ่งเหล่านี้เป็นสัญญาณว่าผู้ดำเนินการอนุญาตอะไร
- จำกัดอัตราด้วยตนเอง: เว้นช่วงคำขอเพื่อไม่ให้บริการของเป้าหมายด้อยลง แม้การหมุนเวียนจะทำให้คุณทำได้เร็วขึ้น
- จัดหา IP อย่างมีจริยธรรม: เครือข่าย proxy ที่คุณพึ่งพาควรสร้างจากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน ไม่ใช่อุปกรณ์ที่ถูกยึดครอง
ชั้น IP คือจุดที่จริยธรรมของไปป์ไลน์ถูกตัดสินในทางปฏิบัติ DataImpulse จัดหา IP จากผู้ใช้ที่เลือกเข้าร่วมและได้รับค่าตอบแทน สอดคล้องกับ GDPR และมีข้อตกลงการประมวลผลข้อมูล ภาพรวมของเราเรื่อง proxy ที่มีจริยธรรม อธิบายโมเดลการจัดหานั้น การจัดหาอย่างมีจริยธรรมเพียงอย่างเดียวไม่ได้ทำให้การ scrape ใดๆ ถูกกฎหมาย ดังนั้นให้ถือว่าการตรวจสอบทางกฎหมายเป็นขั้นตอนแยกต่างหาก
ข้อจำกัดของ web unblocker สำหรับ AI คืออะไร?
web unblocker ลดความฝืดในการดึงข้อมูล แต่ไม่ได้ขจัดปัญหาที่ยากกว่าด้านคุณภาพข้อมูล การควบคุมต้นทุน และการปฏิบัติตามข้อกำหนด และชั้น proxy เพียงอย่างเดียวไม่ใช่ unblocker ที่ครบถ้วน การรู้ขอบเขตช่วยให้ความคาดหวังสมจริง
- มันไม่ประเมินคุณภาพข้อมูล: หน้าเว็บอาจโหลดสมบูรณ์แต่ยังเป็นสแปม ล้าสมัย หรือผิดพลาดได้ การแยกวิเคราะห์และตรวจสอบความถูกต้องยังเป็นงานของคุณ
- มันไม่ได้ให้สิทธิ์ทางกฎหมาย: การเอาชนะการตรวจสอบบอตไม่ได้บอกว่าคุณอาจเก็บรวบรวมหรือนำเนื้อหานั้นกลับมาใช้ได้หรือไม่
- API แบบจัดการให้ไม่โปร่งใสและคิดราคาต่อคำขอ: คุณแลกการมองเห็นและต้นทุนต่อหน่วยกับความสะดวก ซึ่งอาจส่งผลเสียเมื่อมีปริมาณงานสูง
- เป้าหมายที่ยากยังล้มเหลวได้เป็นบางครั้ง: ไม่มี unblocker ใดมีอัตราความสำเร็จ 100 เปอร์เซ็นต์ และเว็บไซต์ที่ป้องกันแน่นหนาหรือมีกำแพงการเข้าสู่ระบบอาจยังเข้าถึงไม่ได้
- proxy ไม่ใช่ทั้งสแต็ก: การหมุนเวียนจัดการชั้นเครือข่าย แต่คุณยังต้องมีการเรนเดอร์ การแยกวิเคราะห์ และการประสานงานรอบๆ มัน
ในประเด็นสุดท้ายนี้ ควรระบุให้ชัดว่าบริการนี้คืออะไร โดยให้บริการชั้น proxy พร้อม IP แบบ residential, mobile และ datacenter มากกว่า 90 ล้านรายการ ครอบคลุม 195 ประเทศ ด้วยอัตราความสำเร็จ 99.51 เปอร์เซ็นต์ เริ่มต้นที่ 1 ดอลลาร์ต่อ GB DataImpulse ไม่ได้ขาย static ISP proxies ไม่ใช่ API สำหรับ scraping แบบจัดการให้หรือ web unblocker และไม่ใช่บริการ web-proxy ฟรี สำหรับแนวทางป้องกันการถูกบล็อกที่ครอบคลุมขึ้น โปรดดูคู่มือของเราเรื่อง การ scrape โดยไม่ถูกบล็อก.
คำถามที่พบบ่อย
web unblocker เหมือนกับ proxy หรือไม่?
ไม่ web unblocker คือ API แบบจัดการให้ที่รวมการหมุนเวียน proxy กับการเรนเดอร์ JavaScript และการจัดการ CAPTCHA เพื่อส่งคืนหน้าเว็บที่เสร็จสมบูรณ์ ผู้ให้บริการ proxy ให้เฉพาะเครือข่าย IP แบบหมุนเวียนที่ขั้นตอนดึงข้อมูลใช้ ซึ่งเป็นองค์ประกอบหนึ่งภายใน unblocker
ฉันต้องใช้ residential proxies เพื่อเข้าถึงเว็บสำหรับ AI หรือไม่?
มักจำเป็นสำหรับเว็บไซต์สำหรับผู้บริโภค เพราะ residential IP ถูกกำหนดให้บ้านจริงและกลมกลืนได้ในจุดที่ช่วง datacenter มักถูกทำเครื่องหมายไว้ล่วงหน้า สำหรับเป้าหมายที่ป้องกันไม่มากหรือภายในองค์กร datacenter proxies ที่ถูกกว่าอาจเพียงพอ
DataImpulse ใช้เป็น web unblocker สำหรับไปป์ไลน์ AI ของฉันได้หรือไม่?
DataImpulse ให้บริการชั้น proxy ไม่ใช่ unblocker แบบจัดการให้ โดยให้ IP แบบ residential, mobile และ datacenter ทั้งแบบหมุนเวียนและ sticky ซึ่งคุณนำไปจับคู่กับ headless browser และ parser ของตนเอง หรือป้อนให้ unblocker แบบจัดการให้เป็นองค์ประกอบด้านเครือข่าย
การ scrape ข้อมูลเว็บสาธารณะสำหรับ AI ถูกกฎหมายหรือไม่?
ขึ้นอยู่กับเขตอำนาจศาล ข้อกำหนดของเว็บไซต์ และวิธีใช้ข้อมูล ดังนั้นให้ถือว่าการตรวจสอบทางกฎหมายเป็นขั้นตอนของมันเอง การจำกัดการเก็บรวบรวมไว้ที่ข้อมูลสาธารณะ การเคารพ robots.txt และขีดจำกัดอัตรา รวมถึงการใช้ IP ที่จัดหาอย่างมีจริยธรรม ช่วยลดความเสี่ยงแต่ไม่ทดแทนคำปรึกษาทางกฎหมาย
ควรสร้างสแต็กการดึงข้อมูลเองแทนการซื้อ unblocker เมื่อใด?
สร้างเองเมื่อปริมาณงานสูงจนการคิดราคาต่อคำขอส่งผลเสีย เมื่อคุณต้องตรวจสอบให้แน่ชัดว่าหน้าเว็บแต่ละหน้าถูกดึงมาอย่างไร หรือเมื่อมีความต้องการการเรนเดอร์แบบกำหนดเอง การประกอบ rotating proxies กับ headless browser ให้การควบคุมนั้นแก่คุณที่ต้นทุนทราฟฟิก proxy
เมื่อใดที่ DataImpulse ไม่เหมาะสม?
หากคุณต้องการ static ISP proxies, API สำหรับ scraping แบบจัดการให้ครบวงจร หรือการเข้าถึงเว็บไซต์ธนาคารและภาครัฐ DataImpulse ไม่ใช่เครื่องมือที่เหมาะสม โดยมุ่งเน้น proxy แบบ residential, mobile และ datacenter ที่หมุนเวียน สำหรับเก็บข้อมูลสาธารณะและเข้าถึงเนื้อหา
คู่มือที่เกี่ยวข้อง
รับชั้น proxy สำหรับไปป์ไลน์ AI ของคุณ
หากคุณกำลังสร้างขั้นตอนดึงข้อมูลเอง เครือข่ายที่อยู่ข้างใต้คือส่วนที่ต้องทำให้ถูกต้อง คุณสามารถ สร้างบัญชี DataImpulse และกำหนดเส้นทาง crawler หรือเอเจนต์ผ่าน IP แบบ residential, mobile หรือ datacenter ที่หมุนเวียน จ่ายตามการใช้งานเริ่มต้นที่ 1 ดอลลาร์ต่อ GB พร้อมการกำหนดเป้าหมายตามประเทศ