
In this Article
Web unblocker dla AI to zarządzana usługa, która na żądanie pobiera publiczne strony internetowe i zwraca czysty HTML lub wyrenderowaną treść, dzięki czemu modele językowe, potoki wyszukiwania i autonomiczni agenci mogą odczytywać aktualną sieć bez blokad. Ten artykuł wyjaśnia, czym rzeczywiście jest web unblocker, dlaczego zespoły AI potrzebują niezawodnego dostępu do sieci oraz jak wygląda wybór między własnym rozwiązaniem a zakupem gotowego, gdy przyjrzeć się szczegółom.
Wyznacza też uczciwą granicę, którą dostawcy często zacierają. Web unblocker to kompletny stos pobierania, natomiast dostawca proxy taki jak DataImpulse jest warstwą sieciową działającą w jego wnętrzu. Wiedza o tym, którą część kupujesz, zmienia zarówno koszt, jak i poziom kontroli.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 mln residential, mobile i datacenter adresów IP w 195 krajach. Stosuje model pay-as-you-go od 1 dolara za GB z transferem bez daty wygaśnięcia i jest używany do web scraping, ad verification, monitorowania cen, badań rynku i zarządzania wieloma kontami.
Najważniejsze informacje
- Web unblocker dla AI: web unblocker to zarządzane API do scrapingu, które łączy renderowanie JavaScript, obsługę CAPTCHA i rotację proxy, aby pobierać publiczne strony internetowe dla potoków szkolenia AI, RAG i agentów; znajdująca się pod spodem warstwa proxy to osobny komponent, który można wymienić.
- Najlepszy typ proxy: rotacyjne residential proxy, które wykorzystują rzeczywiste konsumenckie adresy IP przechodzące wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z transferem bez daty wygaśnięcia i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych adresów IP w 195 krajach.
- Niezawodność: współczynnik powodzenia 99,51%, ocena 4,8/5 na G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem krajów w cenie.
Czym jest web unblocker dla AI?
Web unblocker to zarządzane API do scrapingu, które przyjmuje docelowy URL, wykonuje pracę konieczną do załadowania strony i przejścia jej zabezpieczeń, a następnie zwraca treść strony gotową do parsowania. W zastosowaniach AI jest bramą pozyskiwania danych, która zapewnia crawlerom szkoleniowym, zadaniom generowania wspomaganego wyszukiwaniem (RAG) i agentom przeglądającym stały dopływ aktualnych publicznych danych z sieci.
Pod jednym endpointem typowy web unblocker łączy kilka elementów, które wcześniej były osobnymi narzędziami:
- Rotacja proxy: rozdziela żądania między dużą pulę adresów IP, aby żaden pojedynczy adres nie przyciągał limitów szybkości ani banów.
- Renderowanie JavaScript: uruchamia rzeczywistą lub headless przeglądarkę, dzięki czemu treść wstrzykiwana przez skrypty po stronie klienta jest obecna w zwróconym HTML.
- Obsługa CAPTCHA i wyzwań: wykrywa i obsługuje strony pośrednie, kontrole botów oraz wyzwania antyautomatyzacyjne.
- Zarządzanie fingerprintem i headers: ustawia realistyczne fingerprinty przeglądarki, profile TLS i headers, aby żądania wyglądały jak zwykły ruch.
Istotna różnica dotyczy zakresu. Web unblocker to cały potok pobierania sprzedawany jako usługa. Dostawca proxy dostarcza wyłącznie sieć IP, na której działa rotacja. DataImpulse jest warstwą proxy, a nie zarządzanym web unblockerem, więc stanowi jeden z elementów tego stosu, a nie cały stos.
Dlaczego zespoły AI potrzebują niezawodnego dostępu do sieci?
Zespoły AI potrzebują niezawodnego dostępu do sieci, ponieważ większość ich danych pochodzi z aktualnej publicznej sieci, a każda luka w pobieraniu staje się luką w wiedzy modelu lub zdolności agenta do działania. Popyt napędzają trzy rodzaje zadań.
Dane szkoleniowe. Duże korpusy tekstowe powstają przez indeksowanie publicznych stron na dużą skalę. Jeśli robot indeksujący zostanie zablokowany dla klasy stron, źródła te po cichu nie trafiają do zbioru danych, co zniekształca pokrycie.
Generowanie wspomagane wyszukiwaniem. Systemy RAG pobierają aktualne strony w czasie zapytania, aby oprzeć odpowiedzi na świeżych faktach. Zablokowane pobranie nie tylko powoduje utratę danych, ale też pogarsza odpowiedź, którą użytkownik widzi w tej chwili.
Agenci przeglądający. Autonomiczni agenci ładują strony, aby odczytać ceny, sprawdzić dostępność lub wykonać zadania. Potrzebują spójnego dostępu w wielu domenach, często z konkretnych krajów, a nieudane ładowanie może zatrzymać cały wieloetapowy proces.
We wszystkich trzech przypadkach mechanizm awarii jest taki sam: żądanie, które zwykła przeglądarka wykonałaby bez problemu, zostaje zakwestionowane lub odrzucone, ponieważ wygląda na zautomatyzowane albo pochodzi z oznaczonej sieci. Jeśli chodzi o pobieranie dynamicznych stron, nasz przewodnik scrapowanie dynamicznych stron internetowych szerzej omawia problem renderowania.
Jak działa web unblocker?
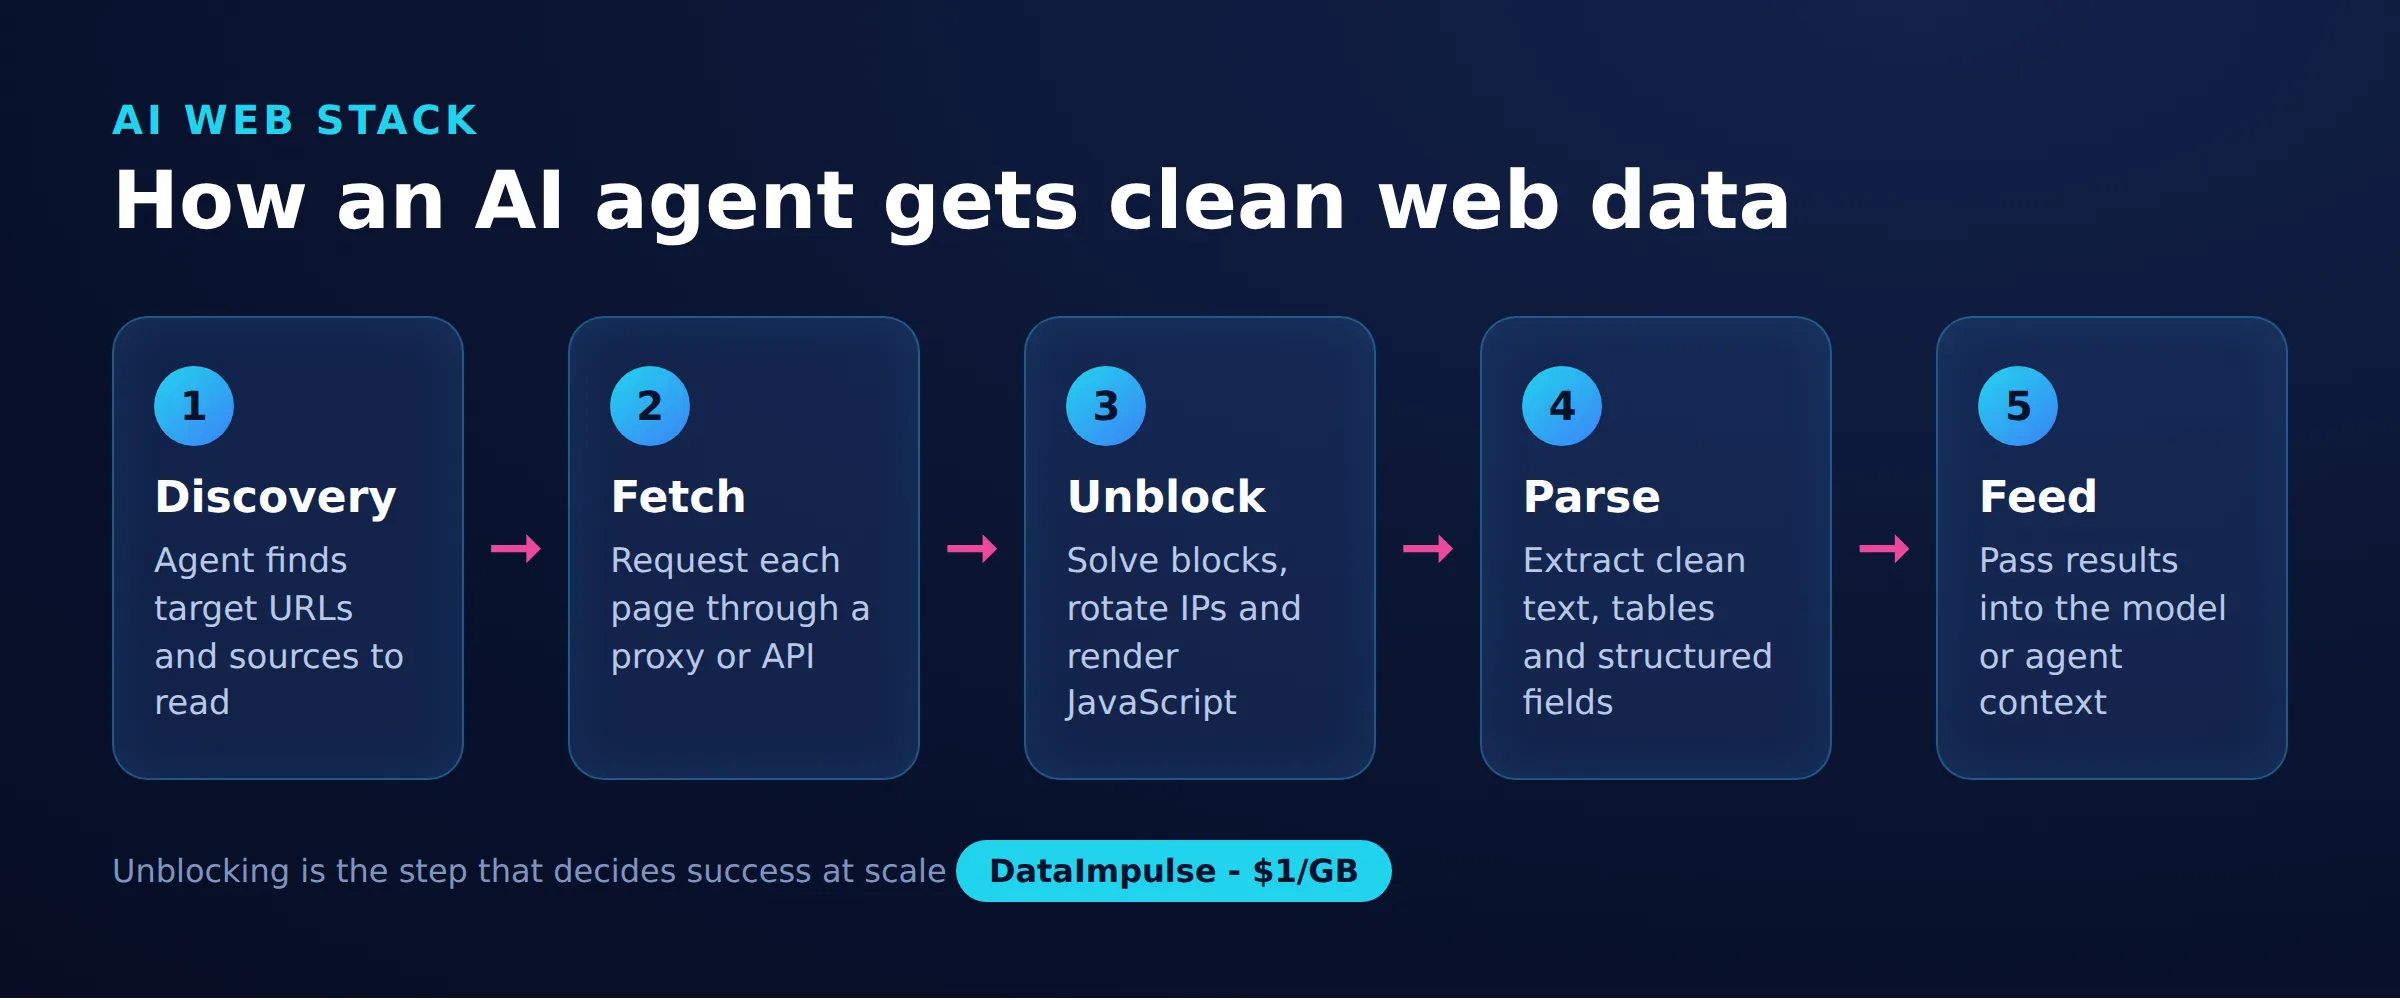
Web unblocker działa, łącząc stałą sekwencję etapów między Twoim systemem AI a docelową stroną. Nazywamy tę sekwencję 5-etapowym modelem dostępu AI do sieci. To przydatna mapa niezależnie od tego, czy kupujesz stos, czy składasz go samodzielnie.
- Odkrywanie: określ, które URL-e pobrać, korzystając z listy początkowej, mapy witryny, granicy crawla lub bieżącej decyzji agenta.
- Pobranie: wyślij żądanie przez proxy, aby docelowa strona widziała wyjściowy IP, a nie Twój serwer.
- Odblokowanie: wyrenderuj JavaScript, ustaw realistyczny fingerprint i rozwiąż każde wyzwanie, aby strona załadowała się w pełni.
- Parsowanie: wyodrębnij użyteczną treść i usuń nawigację, reklamy oraz powtarzalne elementy, uzyskując czysty tekst lub pola strukturalne.
- Przekazanie: przekaż oczyszczoną treść odbiorcy, zbiorowi szkoleniowemu, magazynowi wektorowemu dla RAG lub oknu kontekstu agenta.
Zarządzany web unblocker łączy etapy pobrania i odblokowania w jedno wywołanie API. Gdy budujesz własne rozwiązanie, właśnie te dwa etapy wymagają najwięcej pracy inżynierskiej, a sieć proxy jest fundamentem etapu pobrania. Wszystko przed nimi (odkrywanie) i po nich (parsowanie, przekazanie) jest zasadniczo takie samo w obu przypadkach.
Czy kupić zarządzany unblocker, czy zbudować własny?
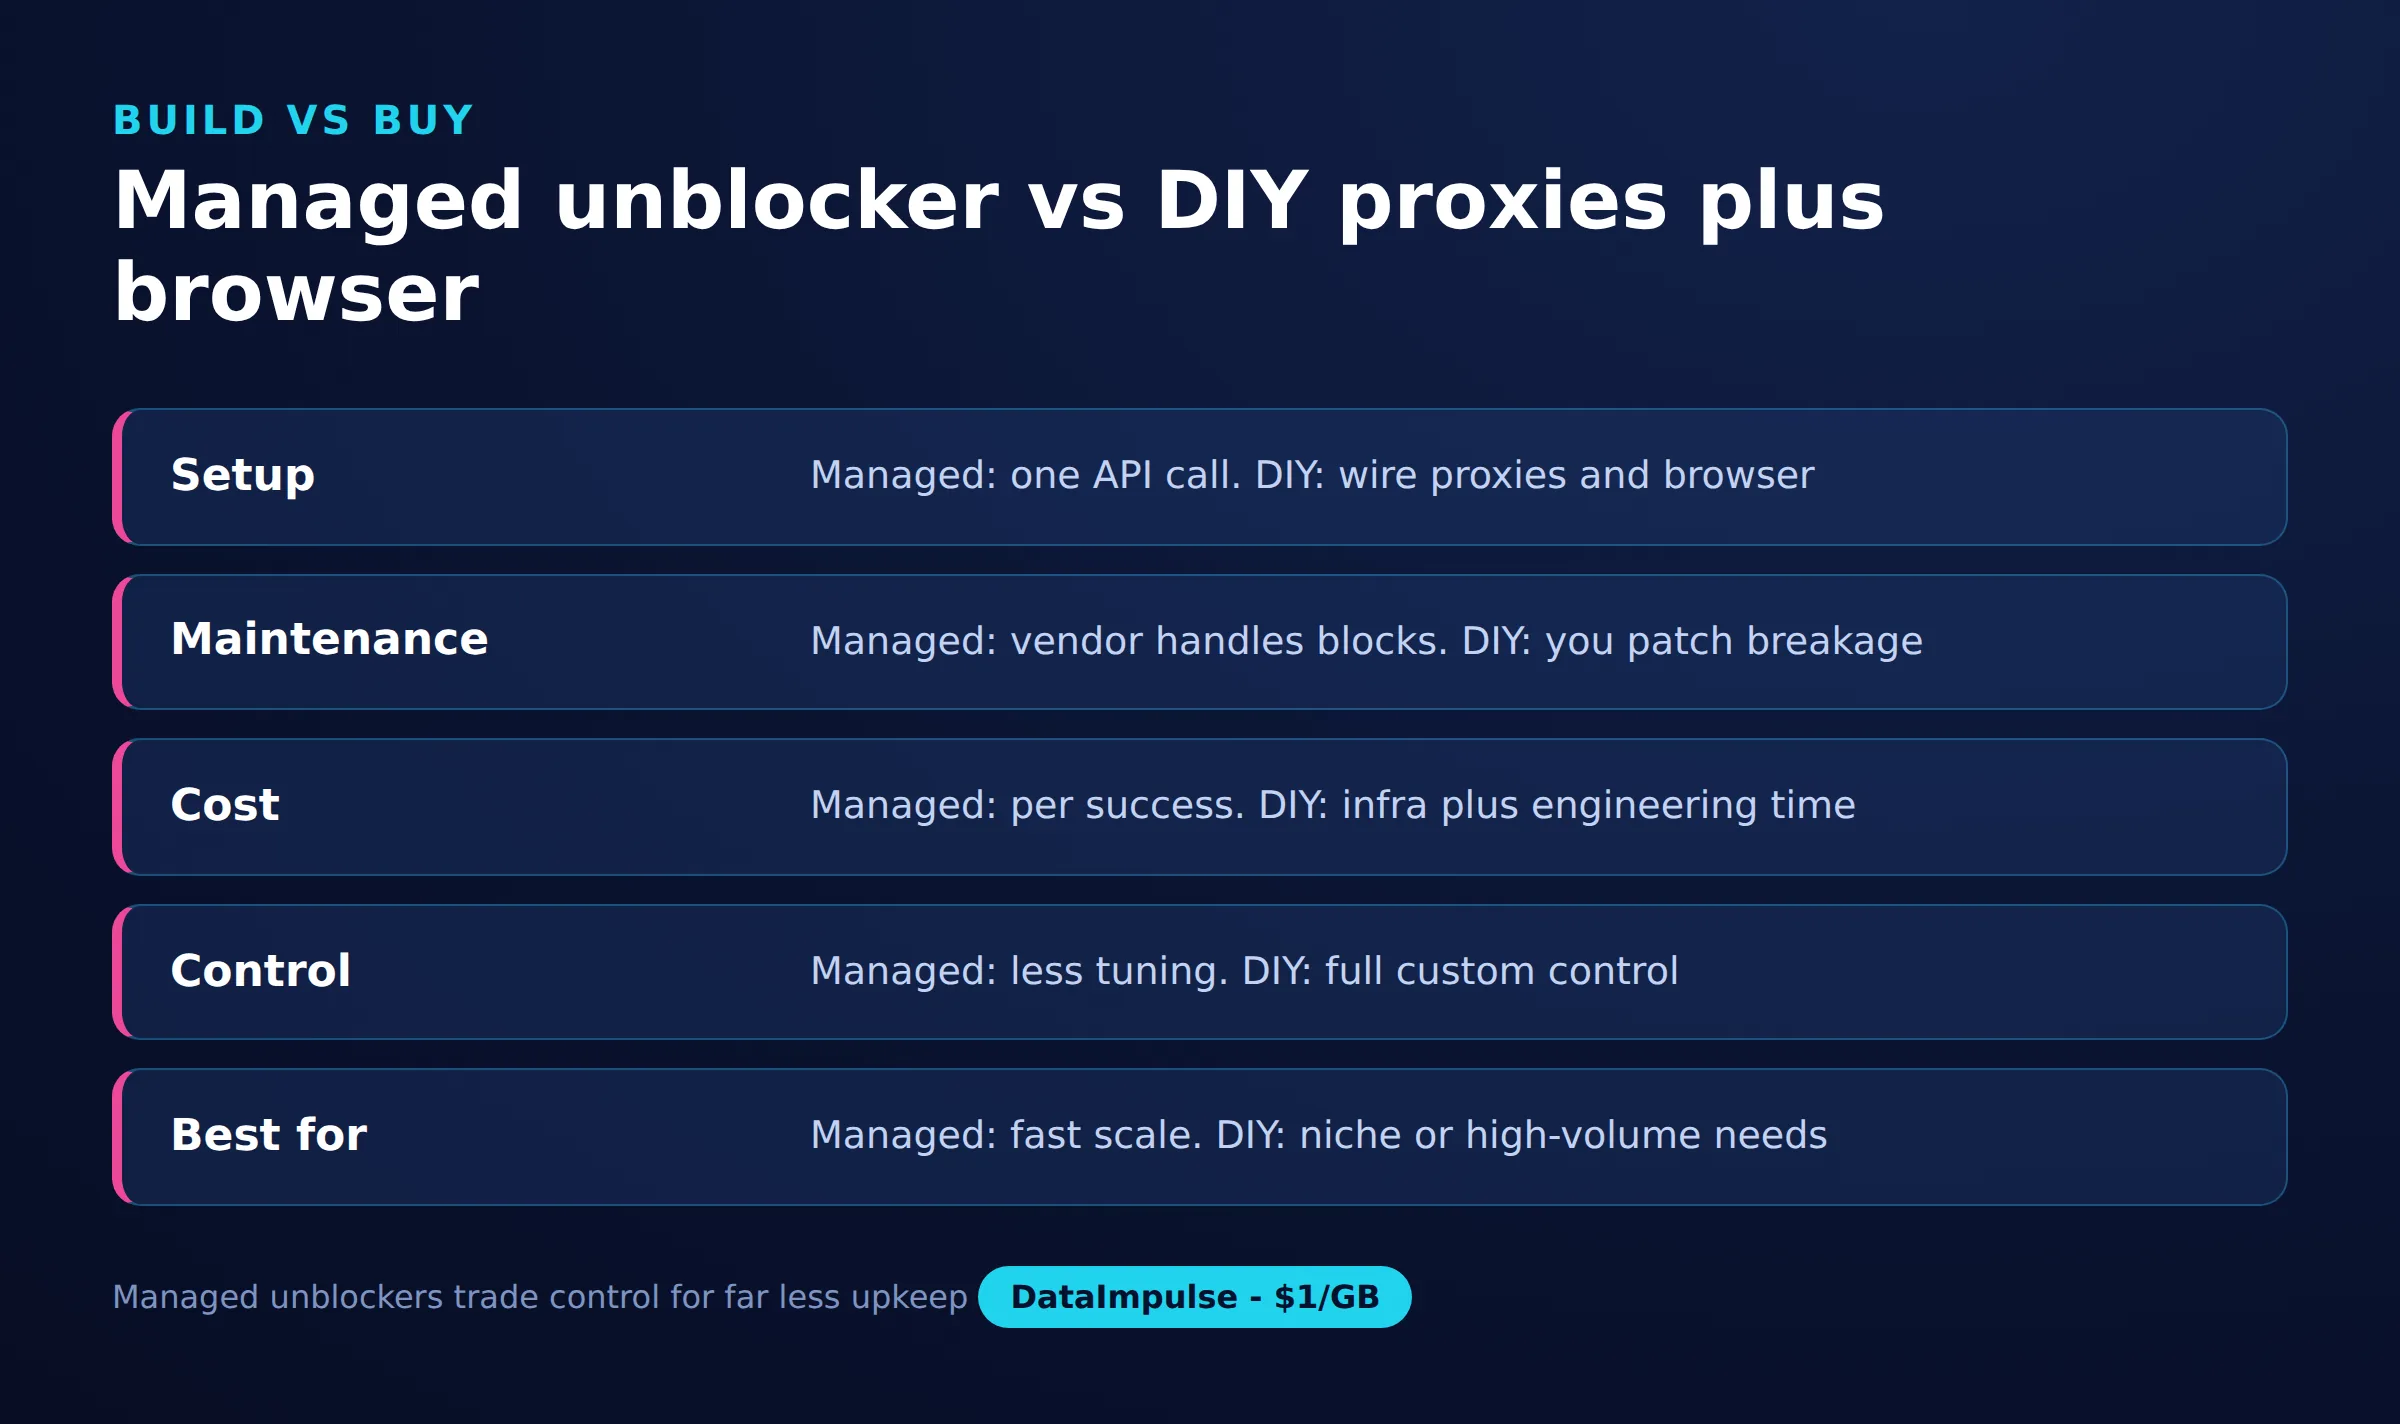
Kup zarządzany unblocker, gdy szybkość i niskie wymagania utrzymaniowe są ważniejsze niż koszt i kontrola; samodzielnie połącz proxy z headless przeglądarką, gdy potrzebujesz przejrzystości, lepszej ekonomiki jednostkowej przy dużej skali lub własnej logiki pobierania. Podejścia różnią się głównie tym, kto odpowiada za etap odblokowania.
| Czynnik | API zarządzanego unblockera | Własne proxy i headless przeglądarka |
|---|---|---|
| Kontrola | Niska; dostawca decyduje o logice renderowania i wyzwań | Wysoka; dostrajasz każde żądanie i headers |
| Model kosztowy | Cena za udane żądanie, wyższa za jednostkę | Cena za GB ruchu proxy plus Twoje zasoby obliczeniowe |
| Utrzymanie | Dostawca przejmuje zmiany mechanizmów antybotowych | Samodzielnie stosujesz poprawki do fingerprintów i renderowania |
| Przejrzystość | Nieprzejrzysta; trudno skontrolować, jak pobrano stronę | Pełny wgląd w całą ścieżkę żądania |
| Czas do pierwszego pobrania | Szybki; jedno wywołanie API | Wolniejszy; najpierw konfigurujesz przeglądarkę i proxy |
Macierz decyzji w skrócie:
- Użyj zarządzanego unblockera, gdy Twój zespół nie ma infrastruktury do scrapingu, cele są silnie chronione, wolumeny są umiarkowane, a czas inżynierów jest ograniczonym zasobem.
- Samodzielnie połącz proxy z przeglądarką, gdy działasz przy dużym wolumenie, musisz kontrolować koszt rekordu, chcesz audytować dokładnie sposób pobrania każdej strony lub masz nietypowe potrzeby renderowania.
- Unikaj zarządzanego unblockera, gdy cena za żądanie przy Twojej skali przekracza koszt własnych proxy i zasobów obliczeniowych albo gdy brak przejrzystości uniemożliwia przegląd zgodności.
Wiele zespołów stosuje model hybrydowy: własne web scraping proxy oraz headless przeglądarkę dla większości łatwych celów, a zarządzany unblocker tylko dla najtrudniejszych stron.
Gdzie pasują proxy i dlaczego residential IP mają znaczenie?
Proxy to warstwa sieciowa etapu pobierania: zapewniają każdemu żądaniu inny wyjściowy IP, dzięki czemu cel widzi zwykły ruch zamiast serii żądań z jednego serwera. Niezależnie od tego, czy kupujesz unblocker, czy budujesz własny, pulą proxy wykonującą rotację zarządza warstwa poniżej. To warstwa, którą zapewnia DataImpulse.
Residential IP są ważne dla dostępu AI do sieci, ponieważ są to adresy przydzielane przez dostawców usług internetowych prawdziwym domom, więc wtapiają się w ruch tam, gdzie zakresy datacenter często są wstępnie oznaczone. W przypadku crawlerów odwiedzających strony dla konsumentów różnica ta często decyduje o tym, czy strona się załaduje, czy zostanie zablokowana. DataImpulse oferuje w tym zastosowaniu residential proxies, a także datacenter proxies dla słabiej chronionych celów i mobile proxies dla najtrudniejszych.
Oto najprostsza postać własnego etapu pobierania: jedno żądanie HTTP przez rotacyjny residential proxy, gotowe do przekazania do potoku AI. DataImpulse obsługuje HTTP, HTTPS i SOCKS5, z targetowaniem krajów wliczonym w stawkę podstawową.
import requests

proxy = "http://USERNAME:[email protected]:823"
resp = requests.get(
    "https://example.com/product/123",
    proxies={"http": proxy, "https": proxy},
    timeout=30,
)
html = resp.text  # hand this to your parser, then your RAG store
W przypadku stron, które tworzą treść dopiero w przeglądarce, dodaj headless przeglądarkę, aby JavaScript uruchomił się przed odczytaniem DOM. Ten sam rotacyjny proxy przekazuje się bezpośrednio do kontekstu przeglądarki.
from playwright.sync_api import sync_playwright

proxy = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}
with sync_playwright() as p:
    browser = p.chromium.launch(proxy=proxy, headless=True)
    page = browser.new_page()
    page.goto("https://example.com/product/123", wait_until="networkidle")
    content = page.content()  # rendered HTML for the AI pipeline
    browser.close()
Sesje rotacyjne zapewniają każdemu żądaniu świeży IP, co sprawdza się przy szerokim crawlowaniu, natomiast sticky session utrzymują jeden IP w całym wieloetapowym przepływie, takim jak zadanie zalogowanego agenta. DataImpulse obsługuje oba rodzaje.
Jakie są etyczne i prawne granice odblokowywania sieci dla AI?
Odblokowywanie sieci dla AI powinno ograniczać się do danych publicznych, zbieranych z rozsądną częstotliwością, z adresów IP pozyskanych za zgodą. Ominięcie blokady technicznej nie jest licencją na ignorowanie zasad dotyczących samych danych, a zespoły AI ponoszą tę odpowiedzialność nawet wtedy, gdy pobieranie wykonuje dostawca.
Niezależnie od narzędzia obowiązuje kilka trwałych zasad:
- Tylko dane publiczne: pobieraj strony dostępne otwarcie bez logowania i obchodzenia kontroli dostępu; nie wykonuj scrapingu prywatnej lub płatnej treści, do której nie masz upoważnienia.
- Przestrzegaj robots i warunków: zapoznaj się z robots.txt i warunkami korzystania z każdej strony oraz traktuj je jako sygnały dotyczące tego, na co zezwala operator.
- Samodzielnie ograniczaj tempo: rozłóż żądania w czasie, aby nie pogarszać działania usługi celu, nawet jeśli rotacja pozwalałaby działać szybciej.
- Pozyskuj IP etycznie: sieć proxy, na której polegasz, powinna być zbudowana z adresów użytkowników, którzy wyrazili zgodę i otrzymują wynagrodzenie, a nie z przejętych urządzeń.
Warstwa IP to miejsce, w którym w praktyce rozstrzyga się etyka potoku. DataImpulse pozyskuje IP od użytkowników, którzy wyrażają zgodę i otrzymują wynagrodzenie, jest zgodne z RODO oraz oferuje umowę o przetwarzaniu danych. Nasz przegląd etyczne proxy wyjaśnia ten model pozyskiwania. Etyczne pozyskiwanie samo w sobie nie sprawia, że dany scraping jest zgodny z prawem, dlatego traktuj przegląd prawny jako osobny etap.
Jakie są ograniczenia web unblockera dla AI?
Web unblocker usuwa trudności z pobieraniem, ale nie rozwiązuje trudniejszych problemów jakości danych, kontroli kosztów i zgodności, a sama warstwa proxy nie jest pełnym unblockerem. Znajomość granic pozwala zachować realistyczne oczekiwania.
- Nie ocenia jakości danych: strona może załadować się idealnie, a mimo to być spamem, nieaktualna lub błędna; parsowanie i walidacja nadal należą do Ciebie.
- Nie daje zezwolenia prawnego: pokonanie kontroli bota nie mówi nic o tym, czy możesz zbierać lub ponownie wykorzystywać tę treść.
- Zarządzane API są nieprzejrzyste i rozliczane za żądanie: wymieniasz widoczność i koszt jednostkowy na wygodę, co może być niekorzystne przy dużym wolumenie.
- Trudne cele czasem nadal zawodzą: żaden unblocker nie osiąga 100% współczynnika powodzenia, a silnie chronione strony lub strony za ścianą logowania mogą pozostać niedostępne.
- Proxy nie jest całym stosem: rotacja obsługuje warstwę sieciową, ale nadal potrzebujesz wokół niej renderowania, parsowania i orkiestracji.
W tej ostatniej kwestii precyzyjnie określ, czym jest DataImpulse. Zapewnia warstwę proxy, ponad 90 mln residential, mobile i datacenter IP w 195 krajach, ze współczynnikiem powodzenia 99,51%, od 1 dolara za GB. Nie sprzedaje statycznych ISP proxy, nie jest zarządzanym API do scrapingu ani web unblockerem i nie jest bezpłatną usługą web-proxy. Szersze podejście do unikania blokad znajdziesz w naszym przewodniku scraping without getting blocked.
Często zadawane pytania
Czy web unblocker to to samo co proxy?
Nie. Web unblocker to zarządzane API, które łączy rotację proxy z renderowaniem JavaScript i obsługą CAPTCHA, aby zwrócić gotową stronę. Dostawca proxy dostarcza wyłącznie rotacyjną sieć IP, na której działa etap pobierania, czyli jeden z komponentów unblockera.
Czy potrzebuję residential proxies do dostępu AI do sieci?
Często tak w przypadku stron dla konsumentów, ponieważ residential IP są przydzielane prawdziwym domom i wtapiają się w ruch tam, gdzie zakresy datacenter często są wstępnie oznaczone. W przypadku lekko chronionych lub wewnętrznych celów wystarczające mogą być tańsze datacenter proxies.
Czy DataImpulse może działać jako web unblocker dla mojego potoku AI?
DataImpulse zapewnia warstwę proxy, a nie zarządzany unblocker. Dostarcza rotacyjne i sticky residential, mobile oraz datacenter IP, które łączysz z własną headless przeglądarką i parserem albo przekazujesz do zarządzanego unblockera jako jego komponent sieciowy.
Czy scraping publicznych danych z sieci dla AI jest legalny?
Zależy to od jurysdykcji, warunków strony i sposobu wykorzystania danych, dlatego traktuj przegląd prawny jako osobny etap. Ograniczenie zbierania do danych publicznych, przestrzeganie robots.txt i limitów szybkości oraz używanie etycznie pozyskanych IP zmniejsza ryzyko, ale nie zastępuje porady prawnej.
Kiedy powinienem zbudować własny stos pobierania zamiast kupować unblocker?
Zbuduj własny stos, gdy wolumen jest na tyle wysoki, że rozliczenie za żądanie staje się niekorzystne, gdy musisz audytować dokładnie sposób pobrania każdej strony lub gdy masz własne potrzeby renderowania. Połączenie rotacyjnych proxy z headless przeglądarką zapewnia taką kontrolę przy koszcie ruchu proxy.
Kiedy DataImpulse nie jest odpowiednim rozwiązaniem?
Jeśli potrzebujesz statycznych ISP proxy, w pełni zarządzanego API do scrapingu lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotacyjnych residential, mobile i datacenter proxies do zbierania danych publicznych oraz dostępu do treści.
Powiązane przewodniki
Zdobądź warstwę proxy dla swojego potoku AI
Jeśli samodzielnie budujesz etap pobierania, najważniejsza jest poprawnie dobrana warstwa sieciowa. Możesz utworzyć konto DataImpulse i kierować crawlera lub agenta przez rotacyjne residential, mobile albo datacenter IP, w modelu pay-as-you-go od 1 dolara za GB z targetowaniem krajów w cenie.