
In this Article
Los datos web para el entrenamiento de LLM son el texto y el contenido recopilados de la web abierta de los que aprenden los modelos de lenguaje grandes. Los LLM modernos se entrenan con corpus enormes, y una gran parte de ellos proviene del rastreo de la web pública: artículos, foros, documentación, código y más. La forma en que esos datos se recopilan, filtran y obtienen determina lo que el modelo sabe y qué tan defendible es. Esta guía define los datos web de entrenamiento, de dónde provienen, cómo se recopilan a escala y dónde encajan los proxies.
Soy Andrii Byzov, un CMO fraccional AI-Native que crea pipelines de datos web para equipos de ML. A continuación: una definición sencilla, las fuentes, el flujo de trabajo de recopilación, la capa de proxy y las cuestiones de calidad y legales. Forma parte de la infraestructura de datos web para IA más amplia.
Datos clave
- Datos web para el entrenamiento de LLM = texto/contenido recopilado de la web utilizado para preentrenar o ajustar modelos de lenguaje.
- Combinación de fuentes: rastreo de la web abierta, conjuntos de datos públicos curados, corpus con licencia y, cada vez más, datos sintéticos.
- La recopilación es un proceso: rastrear → filtrar → deduplicar → limpiar → validar, antes de que algo llegue al entrenamiento.
- La diversidad importa. Un corpus obtenido de una sola región o de unos pocos sitios hereda esa estrechez; la recopilación geodistribuida la amplía.
- Los proxies respaldan el acceso del rastreo. Los sitios limitan la frecuencia y bloquean a escala, por lo que los proxies residenciales ayudan a mantener accesible una recopilación grande y geodiversa (el scraper realiza el rastreo; el proxy lo enruta).
¿Qué son los datos web para el entrenamiento de LLM?
Es la parte obtenida de la web del corpus de entrenamiento de un LLM: el texto y el contenido estructurado que un modelo ingiere para aprender lenguaje, hechos y patrones. Aunque algunos datos de entrenamiento son licenciados o sintéticos, una gran parte se recopila de la web pública a escala masiva. La frase abarca tanto las páginas sin procesar recopiladas como el conjunto de datos limpiado y filtrado que realmente se utiliza en el entrenamiento. Es distinto de la mecánica de proxies para recopilarlos (eso es LLM scraping); aquí nos referimos a los datos en sí: qué son, de dónde provienen y qué los hace buenos o riesgosos.
De dónde provienen los datos de entrenamiento
- Rastreo de la web abierta — rastreo a gran escala de páginas públicas (una fuente importante en muchas mezclas de entrenamiento de propósito general divulgadas, por ejemplo, datos estilo Common Crawl).
- Conjuntos de datos públicos curados — corpus filtrados y listos para usar creados a partir de rastreos web.
- Datos licenciados — contenido obtenido mediante acuerdos con editores o plataformas.
- Datos sintéticos — datos generados por modelos, cada vez más utilizados para cubrir brechas (y que es mejor mantener anclados en datos web reales).
Cómo se recopilan los datos de entrenamiento web
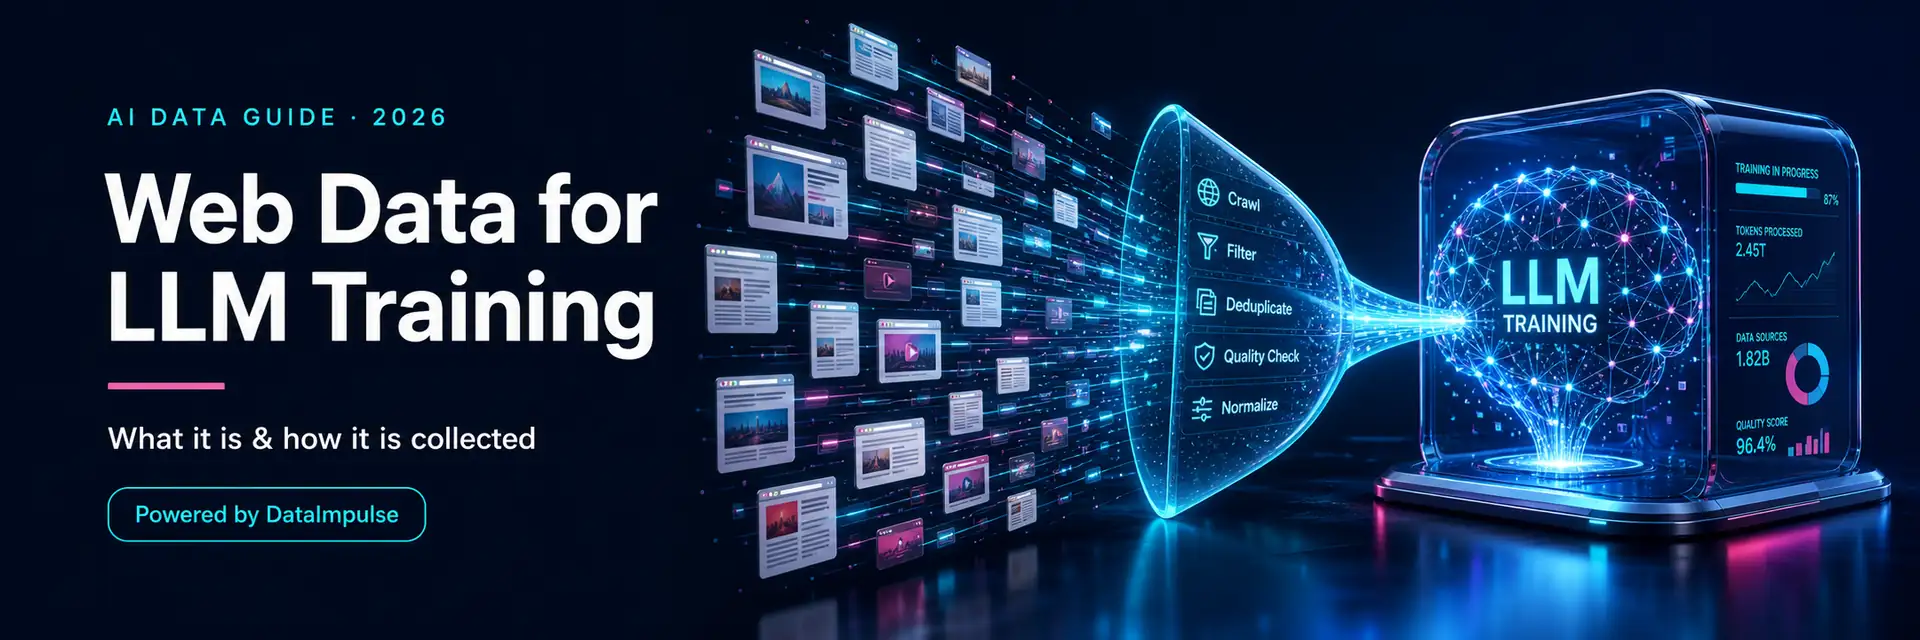
Las páginas web sin procesar no son datos de entrenamiento: se convierten en ellos mediante un proceso. Rastrea las páginas objetivo, filtra el contenido repetitivo, spam y contenido de baja calidad o no seguro, deduplica (los duplicados desperdician cómputo y sesgan el modelo), limpia y normaliza el texto, y valida la calidad antes de que se integre al conjunto. El paso de rastreo es una recopilación web común a una escala extraordinaria, que es exactamente donde el acceso se vuelve la parte difícil.
import requests
# Collecting a web sample for a training corpus: route the crawl through
# residential proxies so it reaches geo-diverse pages without being blocked.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def collect(url):
r = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0"}, timeout=30)
r.raise_for_status()
return r.text # -> filter, dedupe, clean, then add to the training set
# Vary the exit country to gather a more diverse, multi-market corpus
for url in seed_urls:
raw = collect(url)
Por qué los proxies importan para la recopilación de datos de entrenamiento
Recopilar a escala de entrenamiento implica acceder a muchos sitios, muchas veces, desde muchos lugares, y los sitios objetivo limitan la tasa por IP, personalizan según la geografía y marcan rápidamente los rangos de centros de datos. De ahí surgen dos necesidades: escala (rastreo sostenido y de alto volumen sin ser limitado) y diversidad geográfica (un corpus que refleje más de un mercado). Los proxies residenciales enrutan el rastreo a través de IPs reales de consumidores en distintos mercados: los residenciales de DataImpulse desde $1/GB (móviles desde $2/GB) en más de 195 ubicaciones, con rotación y alta concurrencia, para que la recopilación grande y diversa siga siendo accesible donde sea legal y apropiado (junto con otras fuentes como Common Crawl, APIs y feeds con licencia). Los proxies respaldan el acceso; tu pipeline se encarga del filtrado y la calidad.
Calidad y legalidad
Dos cosas separan un corpus utilizable de una responsabilidad. Calidad: el filtrado agresivo y la deduplicación importan más que el volumen bruto: un conjunto más pequeño, más limpio y bien deduplicado a menudo supera a uno más grande y ruidoso. Procedencia y ley: los datos de entrenamiento se han vuelto objeto de numerosos litigios, y la disponibilidad pública no resuelve cuestiones de derechos de autor, contratos o privacidad; la legalidad depende de la jurisdicción, la fuente, el tipo de datos y el uso. Mantén la recopilación defendible: prioriza datos públicos y no personales, respeta los términos de los sitios y trata robots.txt como una señal de política, evita eludir inicios de sesión o controles de acceso, regula el ritmo de las solicitudes y registra de dónde provino cada parte del corpus. Usar proxies para una recopilación legítima generalmente es legal; lo que se examina es el uso de los datos. Consulta si el web scraping es legal. Esta es información general, no asesoría legal.
Preguntas frecuentes
¿Qué son los datos web para el entrenamiento de LLM?
Son el texto y el contenido recopilados de la web pública con los que aprenden los modelos de lenguaje grandes: una gran parte de los corpus de entrenamiento de la mayoría de los modelos generales. El término abarca tanto las páginas rastreadas sin procesar como el conjunto de datos limpiado y filtrado que realmente se usa en el entrenamiento, junto con datos licenciados y sintéticos.
¿De dónde provienen los datos de entrenamiento de LLM?
De cuatro fuentes principales: rastreo web abierto a gran escala (por lo general, la más grande), conjuntos de datos públicos seleccionados creados a partir de rastreos, contenido licenciado de editores o plataformas, y datos sintéticos generados por modelos. La mayoría de los modelos de propósito general dependen en gran medida del rastreo web, que luego filtran y deduplican exhaustivamente.
¿Cómo se recopilan los datos web de entrenamiento?
A través de un flujo de trabajo: rastrear páginas objetivo, filtrar contenido repetitivo y de baja calidad o inseguro, deduplicar, limpiar y normalizar, y luego validar la calidad antes de que se incorpore al conjunto de entrenamiento. El paso de rastreo es la recopilación web a gran escala, donde los límites de tasa y los bloqueos por IP hacen que el acceso sea la parte difícil.
¿Por qué se usan proxies para recopilar datos de entrenamiento?
La recopilación a escala de entrenamiento accede repetidamente a muchos sitios desde muchas ubicaciones, y los sitios limitan la tasa y bloquean el tráfico automatizado. Los proxies residenciales enrutan el rastreo a través de IPs reales de consumidores en distintos mercados, de modo que la recopilación de alto volumen y geodiversa se mantenga accesible, lo que también hace que el corpus sea más diverso que recopilar desde una sola ubicación.
¿Es legal recopilar datos web para el entrenamiento de LLM?
Es un tema muy litigado y no es incondicional. La disponibilidad pública no resuelve cuestiones de derechos de autor, contratos o privacidad, y la legalidad depende de la jurisdicción, la fuente, el tipo de datos y el uso. Prioriza datos públicos y no personales, respeta los términos del sitio y robots.txt, no evadas controles de acceso, dosifica las solicitudes y registra la procedencia. Usar proxies para una recopilación legítima suele ser legal. No constituye asesoría legal.
Conclusión
Los datos web son una entrada fundamental para la mayoría de los LLM, y su calidad depende de cómo se recopilan, filtran y obtienen. La diversidad y una deduplicación limpia superan al volumen bruto; la procedencia y el cuidado legal separan un activo de una responsabilidad. El paso de recopilación es el acceso web a escala, que a menudo depende de una capa de acceso mediante proxies (proxies residenciales, junto con Common Crawl, API o IPs de centro de datos) para mantener accesibles los rastreos grandes y geográficamente diversos. Construye tu canal de filtrado y calidad; alquila el acceso. Ve el panorama general en infraestructura de datos web para IA, la mecánica de recopilación en proxies para scraping de LLM y mejores proxies para entrenamiento de ML.
Última actualización: 27 de junio de 2026.