
In this Article
I dati web per l’addestramento degli LLM sono i testi e i contenuti raccolti dal web aperto, da cui apprendono i grandi modelli linguistici. Gli LLM moderni vengono addestrati su corpora enormi e una parte consistente proviene dalla scansione del web pubblico: articoli, forum, documentazione, codice e altro ancora. Il modo in cui questi dati vengono raccolti, filtrati e reperiti determina ciò che il modello conosce e quanto il loro uso sia difendibile. Questa guida definisce i dati web per l’addestramento, da dove provengono, come vengono raccolti su larga scala e quale ruolo hanno i proxy.
Sono Andrii Byzov, Fractional CMO AI-Native e realizzo pipeline di dati web per team ML. Qui trovi una definizione semplice, le fonti, il flusso di raccolta, il livello proxy e le questioni di qualità e legali. Fa parte della più ampia infrastruttura di dati web per l’AI.
Fatti chiave
- Dati web per l’addestramento degli LLM = testi/contenuti raccolti dal web usati per pre-addestrare o sottoporre a fine-tuning i modelli linguistici.
- Mix di fonti: scansione del web aperto, dataset pubblici curati, corpora con licenza e, sempre più spesso, dati sintetici.
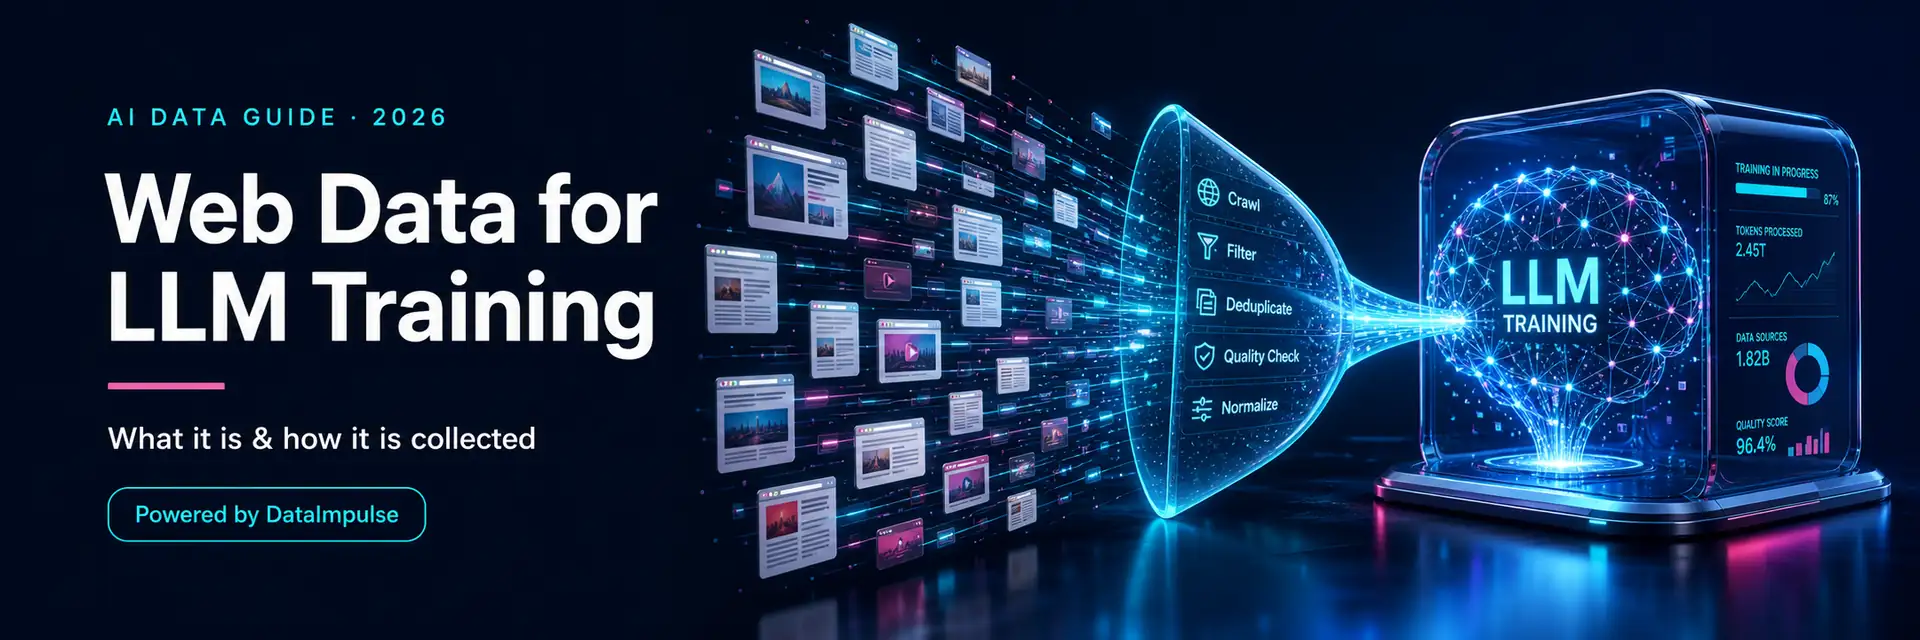
- La raccolta è una pipeline: scansione → filtraggio → deduplicazione → pulizia → convalida, prima che qualunque dato arrivi all’addestramento.
- La diversità conta. Un corpus estratto da una regione o da pochi siti ne eredita la ristrettezza; una raccolta geograficamente distribuita la amplia.
- I proxy supportano l’accesso della scansione. I siti applicano limiti di frequenza e bloccano su larga scala, quindi i residential proxy aiutano a mantenere raggiungibile una raccolta ampia e geograficamente diversificata (lo scraper esegue la scansione; il proxy la instrada).
Cosa sono i dati web per l’addestramento degli LLM?
È la parte del corpus di addestramento di un LLM proveniente dal web: i testi e i contenuti strutturati che un modello acquisisce per apprendere lingua, fatti e modelli. Sebbene alcuni dati di addestramento siano concessi in licenza o sintetici, una parte consistente viene raccolta dal web pubblico su scala enorme. L’espressione comprende sia le pagine grezze raccolte sia il dataset pulito e filtrato che entra effettivamente nell’addestramento. È distinto dalla meccanica proxy usata per raccoglierli (ossia LLM scraping): qui intendiamo i dati stessi, cosa sono, da dove provengono e cosa li rende validi o rischiosi.
Da dove provengono i dati di addestramento
- Scansione del web aperto: scansione su larga scala di pagine pubbliche (una fonte importante in molte composizioni di addestramento per uso generale rese pubbliche, ad esempio dati in stile Common Crawl).
- Dataset pubblici curati: corpora filtrati e pronti all’uso, costruiti a partire da scansioni web.
- Dati con licenza: contenuti ottenuti tramite accordi con editori o piattaforme.
- Dati sintetici: dati generati dal modello, sempre più usati per colmare le lacune (ed è preferibile mantenerli ancorati a dati web reali).
Come vengono raccolti i dati web per l’addestramento
Le pagine web grezze non sono dati di addestramento: lo diventano attraverso una pipeline. Scansiona le pagine di destinazione, filtra boilerplate, spam e contenuti di bassa qualità o non sicuri, deduplica (i duplicati sprecano capacità di calcolo e distorcono il modello), pulisci e normalizza il testo, quindi convalida la qualità prima che entri nel set. La fase di scansione è una normale raccolta web su scala straordinaria, ed è proprio qui che l’accesso diventa difficile.
import requests
# Collecting a web sample for a training corpus: route the crawl through
# residential proxies so it reaches geo-diverse pages without being blocked.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def collect(url):
r = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0"}, timeout=30)
r.raise_for_status()
return r.text # -> filter, dedupe, clean, then add to the training set
# Vary the exit country to gather a more diverse, multi-market corpus
for url in seed_urls:
raw = collect(url)
Perché i proxy sono importanti per la raccolta dei dati di addestramento
Raccogliere alla scala dell’addestramento significa raggiungere molti siti, molte volte, da molti luoghi, e i siti di destinazione applicano limiti di frequenza per IP, personalizzano in base alla geografia e segnalano rapidamente gli intervalli datacenter. Ne derivano due esigenze: scala (scansione continuativa ad alto volume senza rallentamenti) e diversità geografica (un corpus che rifletta più di un mercato). I residential proxy instradano la scansione tramite IP reali di utenti in diversi mercati: DataImpulse residential da $1/GB (mobile da $2/GB) in oltre 195 località, con rotazione e alta concorrenza, affinché una raccolta ampia e diversificata resti raggiungibile dove sia legittimo e appropriato (insieme ad altre fonti come Common Crawl, API e feed con licenza). I proxy supportano l’accesso; la tua pipeline gestisce filtraggio e qualità.
Qualità e legalità
Due aspetti separano un corpus utilizzabile da una passività. Qualità: filtraggio e deduplicazione aggressivi contano più del volume grezzo: un set più piccolo, più pulito e ben deduplicato spesso supera uno più grande e rumoroso. Provenienza e diritto: i dati di addestramento sono diventati oggetto di numerose controversie e la disponibilità pubblica non risolve le questioni di copyright, contratto o privacy: la legalità dipende da giurisdizione, fonte, tipo di dati e utilizzo. Mantieni la raccolta difendibile: privilegia dati pubblici e non personali, rispetta i termini del sito e considera robots.txt un segnale di policy, evita di aggirare login o controlli di accesso, regola il ritmo delle richieste e traccia la provenienza di ogni parte del corpus. Usare proxy per una raccolta appropriata è generalmente lecito; ciò che viene esaminato è l’uso dei dati. Scopri se il web scraping è legale. Queste sono informazioni generali, non consulenza legale.
Domande frequenti
Cosa sono i dati web per l’addestramento degli LLM?
Sono i testi e i contenuti raccolti dal web pubblico, da cui apprendono i grandi modelli linguistici: una parte consistente dei corpora di addestramento della maggior parte dei modelli generali. Il termine comprende sia le pagine grezze sottoposte a scansione sia il dataset pulito e filtrato che entra effettivamente nell’addestramento, insieme a dati con licenza e sintetici.
Da dove provengono i dati di addestramento degli LLM?
Quattro fonti principali: scansione su larga scala del web aperto (di solito la più grande), dataset pubblici curati basati su scansioni, contenuti con licenza di editori o piattaforme e dati sintetici generati dal modello. La maggior parte dei modelli per uso generale si basa in larga misura sulla scansione web, che poi filtra e deduplica intensamente.
Come vengono raccolti i dati web per l’addestramento?
Attraverso una pipeline: scansione delle pagine di destinazione, filtraggio di boilerplate e contenuti di bassa qualità o non sicuri, deduplicazione, pulizia e normalizzazione, quindi convalida della qualità prima dell’ingresso nel set di addestramento. La fase di scansione è raccolta web su scala enorme, dove limiti di frequenza e blocchi per IP rendono difficile l’accesso.
Perché si usano i proxy per la raccolta dei dati di addestramento?
La raccolta alla scala dell’addestramento raggiunge ripetutamente molti siti da molte località e i siti applicano limiti di frequenza e bloccano il traffico automatizzato. I residential proxy instradano la scansione tramite IP reali di utenti in diversi mercati, affinché una raccolta ad alto volume e geograficamente diversificata resti raggiungibile, rendendo anche il corpus più diversificato rispetto a una raccolta da un’unica località.
La raccolta di dati web per l’addestramento degli LLM è legale?
È oggetto di numerose controversie e non è incondizionata. La disponibilità pubblica non risolve le questioni di copyright, contratto o privacy e la legalità dipende da giurisdizione, fonte, tipo di dati e utilizzo. Privilegia dati pubblici e non personali, rispetta i termini del sito e robots.txt, non aggirare i controlli di accesso, regola il ritmo delle richieste e traccia la provenienza. Usare proxy per una raccolta appropriata è generalmente lecito. Non è consulenza legale.
Conclusione
I dati web sono un input fondamentale per la maggior parte degli LLM e valgono quanto il modo in cui vengono raccolti, filtrati e reperiti. La diversità e una deduplicazione accurata superano il volume grezzo; provenienza e attenzione legale separano una risorsa da una passività. La fase di raccolta è accesso al web su larga scala, che spesso si basa su un livello di accesso proxy (residential proxy, insieme a Common Crawl, API o IP datacenter) per mantenere raggiungibili scansioni ampie e geograficamente diversificate. Crea la tua pipeline di filtraggio e qualità; noleggia l’accesso. Scopri il quadro generale nell’infrastruttura di dati web per l’AI, la meccanica di raccolta nei proxy per LLM scraping e i migliori proxy per l’addestramento ML.
Ultimo aggiornamento: 27 giugno 2026.