
In this Article
LLM 학습용 웹 데이터는 대규모 언어 모델이 학습하는 공개 웹에서 수집한 텍스트와 콘텐츠입니다. 최신 LLM은 방대한 말뭉치로 학습하며, 그중 큰 비중은 공개 웹의 기사, 포럼, 문서, 코드 등을 크롤링하여 얻습니다. 데이터를 어떻게 수집하고, 필터링하고, 확보하는지가 모델이 아는 내용과 그 근거의 타당성을 좌우합니다. 이 가이드에서는 웹 학습 데이터의 정의, 출처, 대규모 수집 방식, 그리고 프록시의 역할을 설명합니다.
저는 ML 팀을 위한 웹 데이터 파이프라인을 구축하는 AI 네이티브 프랙셔널 CMO, Andrii Byzov입니다. 아래에서 쉬운 정의, 출처, 수집 작업 흐름, 프록시 계층, 품질 및 법적 쟁점을 다룹니다. 이는 더 폭넓은 AI를 위한 웹 데이터 인프라의 일부입니다.
핵심 정보
- LLM 학습용 웹 데이터 = 웹에서 수집한 텍스트/콘텐츠로, 언어 모델의 사전 학습 또는 미세 조정에 사용됩니다.
- 출처의 조합: 공개 웹 크롤링, 선별된 공개 데이터세트, 라이선스 말뭉치, 그리고 점차 늘어나는 합성 데이터입니다.
- 수집은 파이프라인입니다: 크롤링 → 필터링 → 중복 제거 → 정제 → 검증을 거쳐야 학습에 사용됩니다.
- 다양성이 중요합니다. 한 지역이나 소수의 사이트에서 가져온 말뭉치는 그 편협성을 물려받으며, 지리적으로 분산된 수집은 이를 넓힙니다.
- 프록시는 크롤링의 접근을 지원합니다. 사이트는 대규모 접근을 속도 제한하거나 차단하므로, 레지덴셜 프록시는 대규모의 지리적으로 다양한 수집이 접근 가능한 상태를 유지하도록 돕습니다(스크래퍼가 크롤링하고 프록시가 경로를 지정합니다).
LLM 학습용 웹 데이터란 무엇인가요?
이는 LLM 학습 말뭉치 중 웹에서 확보한 부분으로, 모델이 언어, 사실, 패턴을 학습하기 위해 수집하는 텍스트와 구조화된 콘텐츠를 뜻합니다. 일부 학습 데이터는 라이선스를 받았거나 합성 데이터이지만, 큰 비중은 공개 웹에서 대규모로 수집됩니다. 이 표현은 원시 수집 페이지와 실제 학습에 투입되는 정제 및 필터링된 데이터세트 모두를 포괄합니다. 이는 수집을 위한 프록시 작동 방식(LLM 스크래핑)과는 다릅니다. 여기서는 데이터 자체, 즉 무엇이며 어디에서 오고 무엇이 품질 또는 위험을 결정하는지를 말합니다.
학습 데이터의 출처
- 공개 웹 크롤링: 공개 페이지를 대규모로 크롤링하는 방식입니다(예: Common Crawl 스타일 데이터는 공개된 다수의 범용 학습 조합에서 주요 출처입니다).
- 선별된 공개 데이터세트: 웹 크롤링을 기반으로 구축한 필터링된 완성형 말뭉치입니다.
- 라이선스 데이터: 게시자 또는 플랫폼과의 계약을 통해 얻은 콘텐츠입니다.
- 합성 데이터: 모델이 생성한 데이터로, 빈틈을 메우는 데 점점 더 많이 사용됩니다(실제 웹 데이터에 근거를 두는 것이 바람직합니다).
웹 학습 데이터를 수집하는 방법
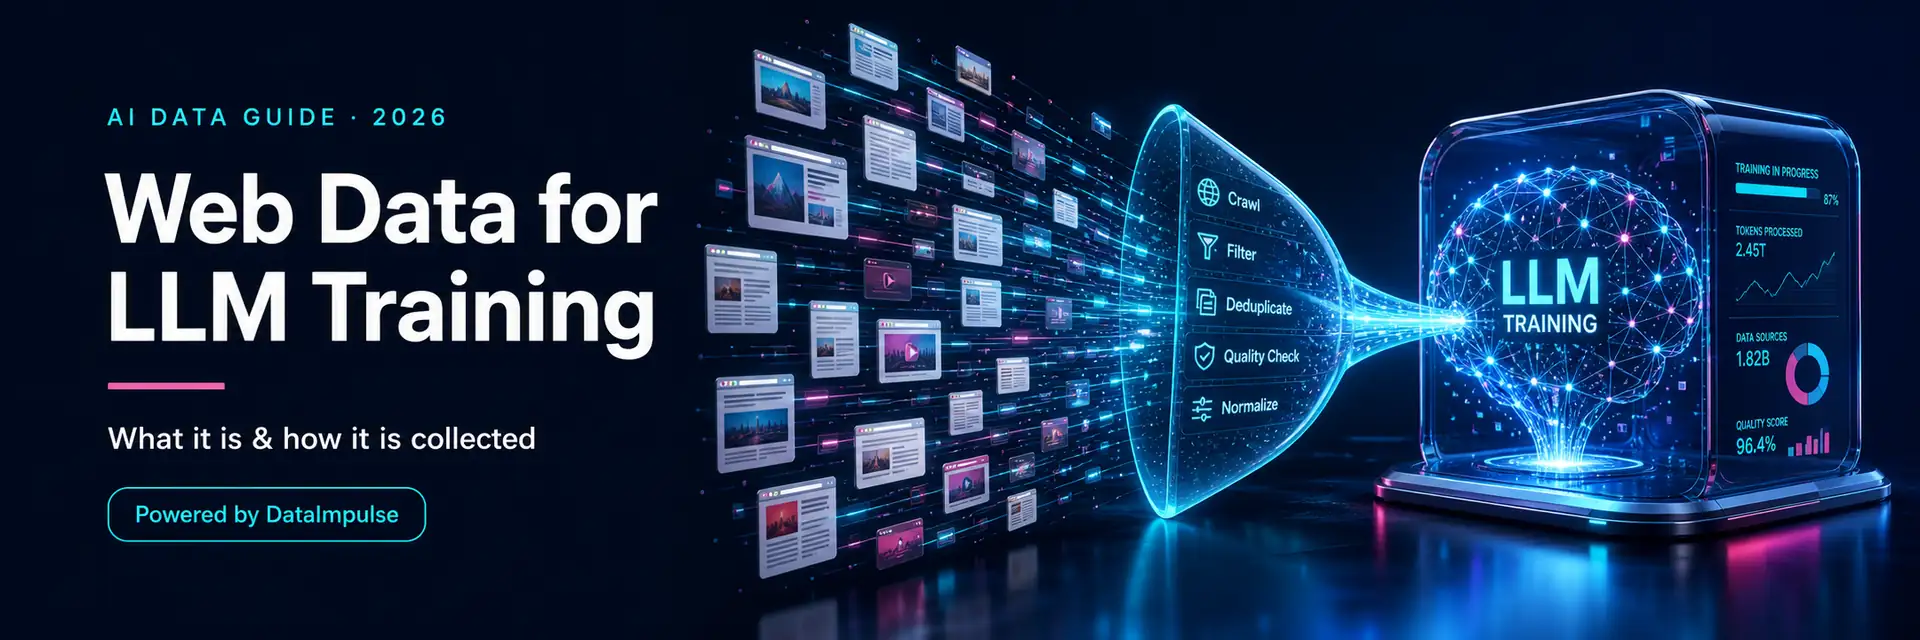
원시 웹 페이지는 그 자체로 학습 데이터가 아니며, 파이프라인을 거쳐 학습 데이터가 됩니다. 대상 페이지를 크롤링하고, 보일러플레이트, 스팸, 저품질 또는 안전하지 않은 콘텐츠를 필터링하며, 중복을 제거하고(중복은 컴퓨팅 자원을 낭비하고 모델을 편향시킵니다), 텍스트를 정제하고 정규화한 다음, 세트에 포함하기 전에 품질을 검증합니다. 크롤링 단계는 이례적으로 큰 규모의 일반적인 웹 수집이며, სწორედ 이 단계에서 접근이 어려운 문제가 됩니다.
import requests
# Collecting a web sample for a training corpus: route the crawl through
# residential proxies so it reaches geo-diverse pages without being blocked.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def collect(url):
r = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0"}, timeout=30)
r.raise_for_status()
return r.text # -> filter, dedupe, clean, then add to the training set
# Vary the exit country to gather a more diverse, multi-market corpus
for url in seed_urls:
raw = collect(url)
학습 데이터 수집에 프록시가 중요한 이유
학습 규모로 수집한다는 것은 여러 장소에서 여러 사이트에 반복적으로 접근한다는 뜻입니다. 대상 사이트는 IP별로 속도를 제한하고, 지역별로 개인화하며, 데이터센터 범위를 빠르게 플래그 지정합니다. 따라서 두 가지가 필요합니다. 규모(제한 없이 지속되는 대용량 크롤링)와 지리적 다양성(하나 이상의 시장을 반영하는 말뭉치)입니다. 레지덴셜 프록시는 여러 시장의 실제 소비자 IP를 통해 크롤링 경로를 지정합니다. DataImpulse 레지덴셜은 195개 이상의 위치에서 $1/GB부터, 모바일은 $2/GB부터 제공되며 로테이팅과 높은 동시성을 지원합니다. 따라서 합법적이고 적절한 경우 Common Crawl, API, 라이선스 피드 등의 다른 출처와 함께 대규모의 다양한 수집이 계속 접근 가능하도록 합니다. 프록시는 접근을 지원하고, 필터링과 품질 관리는 사용자의 파이프라인이 처리합니다.
품질 및 적법성
사용 가능한 말뭉치와 책임 부담을 가르는 요소는 두 가지입니다. 품질: 원시 물량보다 적극적인 필터링과 중복 제거가 더 중요합니다. 더 작고, 더 깨끗하며, 중복이 잘 제거된 세트가 더 크고 잡음이 많은 세트를 능가하는 경우가 많습니다. 출처 및 법: 학습 데이터는 소송이 활발한 분야가 되었으며, 공개되어 있다고 해서 저작권, 계약 또는 개인정보 문제를 해결하는 것은 아닙니다. 적법성은 관할권, 출처, 데이터 유형, 사용 방식에 따라 달라집니다. 수집의 정당성을 유지하려면 공개된 비개인 데이터를 우선하고, 사이트 약관을 존중하며 robots.txt를 정책 신호로 취급하고, 로그인이나 접근 통제를 우회하지 않으며, 요청 속도를 조절하고, 말뭉치의 모든 부분이 어디에서 왔는지 추적해야 합니다. 정당한 수집을 위해 프록시를 사용하는 것은 일반적으로 합법적이지만, 검토 대상은 데이터의 사용입니다. 웹 스크래핑의 적법성을 참조하세요. 이는 일반 정보이며 법률 자문이 아닙니다.
자주 묻는 질문
LLM 학습용 웹 데이터란 무엇인가요?
대규모 언어 모델이 학습하는 공개 웹에서 수집한 텍스트와 콘텐츠입니다. 이는 대부분의 범용 모델 학습 말뭉치에서 큰 비중을 차지합니다. 이 용어는 라이선스 및 합성 데이터와 더불어 원시 크롤링 페이지와 실제 학습에 투입되는 정제 및 필터링된 데이터세트 모두를 포괄합니다.
LLM 학습 데이터는 어디에서 오나요?
네 가지 주요 출처가 있습니다. 대규모 공개 웹 크롤링(대개 가장 큰 비중), 크롤링 기반의 선별된 공개 데이터세트, 게시자 또는 플랫폼의 라이선스 콘텐츠, 그리고 모델이 생성한 합성 데이터입니다. 대부분의 범용 모델은 웹 크롤링에 크게 의존한 뒤 이를 광범위하게 필터링하고 중복 제거합니다.
웹 학습 데이터는 어떻게 수집하나요?
파이프라인을 통해 수집합니다. 대상 페이지를 크롤링하고, 보일러플레이트와 저품질 또는 안전하지 않은 콘텐츠를 필터링하며, 중복을 제거하고, 정제 및 정규화한 다음, 학습 세트에 포함하기 전에 품질을 검증합니다. 크롤링 단계는 엄청난 규모의 웹 수집으로, IP 속도 제한과 차단 때문에 접근이 어려운 부분입니다.
학습 데이터 수집에 프록시를 사용하는 이유는 무엇인가요?
학습 규모의 수집은 여러 위치에서 많은 사이트에 반복적으로 접근하며, 사이트는 자동화 트래픽을 속도 제한하고 차단합니다. 레지덴셜 프록시는 여러 시장의 실제 소비자 IP를 통해 크롤링 경로를 지정하므로, 대용량의 지리적으로 다양한 수집이 계속 접근 가능하며 한 위치에서만 수집할 때보다 말뭉치를 더 다양하게 만들 수 있습니다.
LLM 학습용 웹 데이터를 수집하는 것은 합법적인가요?
관련 소송이 활발하며 무조건 허용되는 것은 아닙니다. 공개되어 있다고 해서 저작권, 계약 또는 개인정보 문제가 해결되는 것은 아니고, 적법성은 관할권, 출처, 데이터 유형, 사용 방식에 따라 달라집니다. 공개된 비개인 데이터를 우선하고, 사이트 약관과 robots.txt를 존중하며, 접근 통제를 우회하지 않고, 요청 속도를 조절하며, 출처를 추적하세요. 정당한 수집을 위해 프록시를 사용하는 것은 일반적으로 합법적입니다. 법률 자문이 아닙니다.
결론
웹 데이터는 대부분의 LLM에 주요 입력 요소이며, 수집, 필터링, 확보 방식만큼만 품질이 좋습니다. 다양성과 깔끔한 중복 제거는 원시 물량을 능가하며, 출처 관리와 법적 주의는 자산과 책임 부담을 구분합니다. 수집 단계는 대규모 웹 접근으로, 대규모의 지리적으로 다양한 크롤링을 계속 접근 가능하게 하려면 흔히 프록시 접근 계층(레지덴셜 프록시, Common Crawl, API 또는 데이터센터 IP와 함께)에 의존합니다. 필터링 및 품질 파이프라인을 구축하고 접근 서비스는 이용하세요. 더 큰 그림은 AI를 위한 웹 데이터 인프라에서, 수집 방식은 LLM 스크래핑용 프록시에서, ML 학습을 위한 최적의 프록시에서 확인하세요.
최종 업데이트: 2026년 6월 27일.