
In this Article
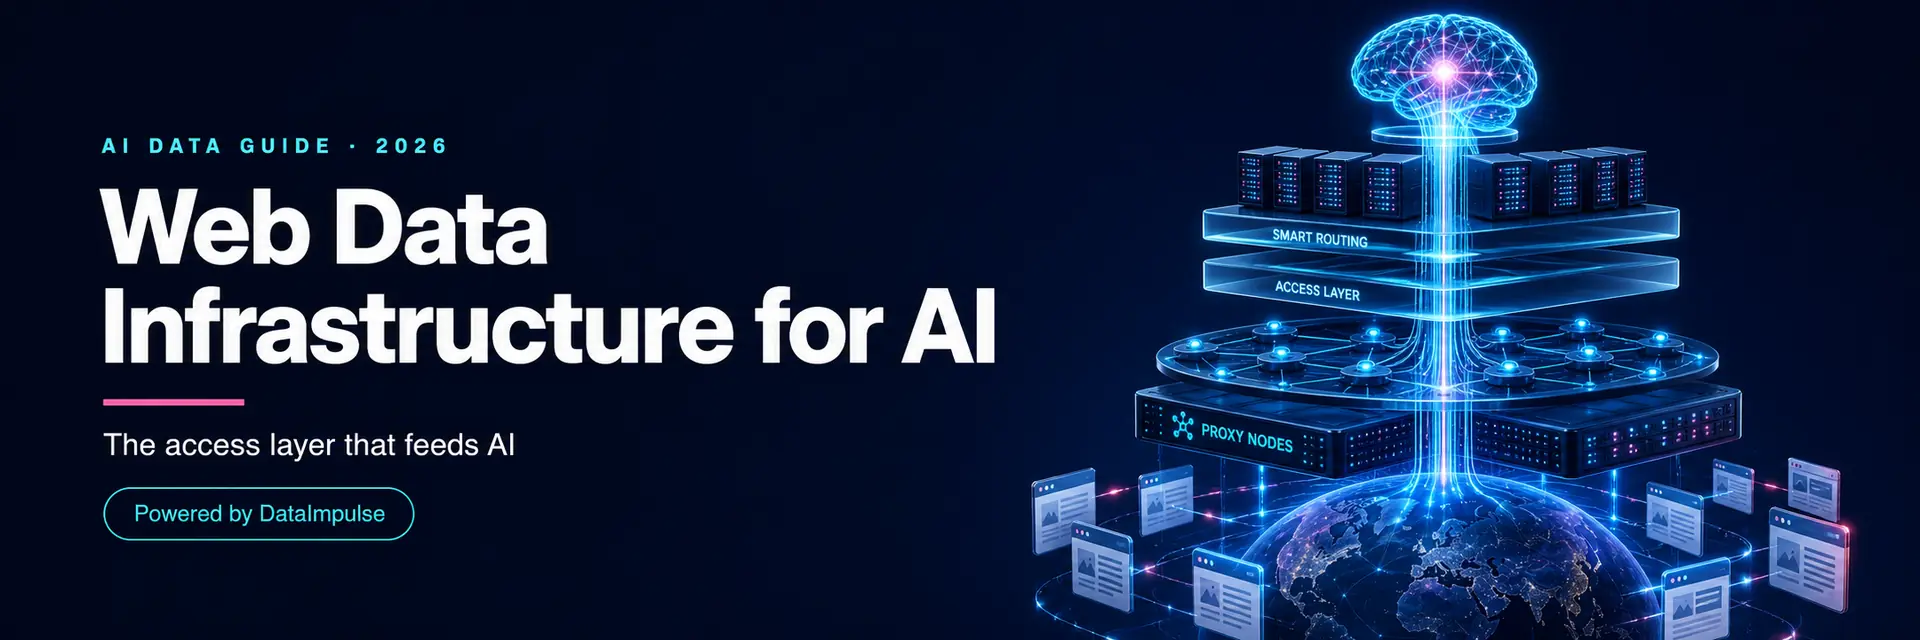
面向 AI 的网页数据基础设施,是让 AI 系统从开放网络收集、访问和使用实时数据的技术栈,是模型训练、RAG 和自主代理的底层支撑。模型不会凭空学习或回答问题: 它们需要真实世界的数据,其中很大一部分来自网络。能够大规模、跨市场且不受封锁地获取这些数据的基础设施,正和计算、存储一样成为 AI 的基础能力。本指南将定义这一类别,拆解其各个层级,并说明代理如何作为访问基础发挥作用。
我是 Andrii Byzov,一名专注于 AI 的兼职 CMO,负责为 AI 团队构建网页数据管道。下文将介绍: 清晰的定义、AI 为何依赖网页数据、这一技术栈的四个层级、住宅代理的定位,以及如何权衡自建与采购。这篇文章也是我们其他 AI 数据指南的核心支柱。
关键事实
- 面向 AI 的网页数据基础设施 = 访问层 + 采集层,用于向训练、RAG/grounding 和智能体提供网页数据。
- 四个层级:访问(代理)、采集(抓取/爬取)、处理(提取/清洗)和交付(交付给模型或数据管道)。
- 访问往往是瓶颈。网站会根据地理位置提供个性化内容、实施速率限制并拦截自动化流量,因此能否获取到数据本身就可能是难点,尤其是在特定地理位置或大规模采集场景中。
- 住宅代理是访问基础,目标市场中的真实用户 IP 可提高网页访问成功率、增强地理位置准确性,并大幅降低大规模使用时被拦截的概率。
- 如今它已成为采购标准。AI 团队越来越像评估 GPU 一样评估网页数据基础设施(并发能力、地理覆盖范围、每 GB 成本)。
什么是面向 AI 的网页数据基础设施?
面向 AI 的网页数据基础设施,是连接开放网络与 AI 可用数据的一整套能力。它是一条管道,能够访问页面、稳定地获取页面内容、将其转化为结构化信号,并交付给模型、RAG 管道或AI 代理。计算用于训练模型,存储用于保存模型,但二者都无法让模型获得真实世界的最新信息,网页数据层可以。随着 AI 从静态训练集转向实时、可溯源、具备代理能力的系统,这一层也从锦上添花变成了核心基础设施。
为什么 AI 依赖网页数据
- 训练:模型从大规模、多样化的语料库中学习,其中很大一部分抓取自公共网络(LLM 训练数据)。
- 检索增强与 RAG:为了用最新事实作答,系统会在查询时检索新鲜的网页数据,而不仅仅依赖已有的内部知识。
- 代理:自主代理会浏览和比较页面,并根据实时页面信息采取行动,因此它们需要实时网页访问能力。
- 评估与监控:团队使用网页数据跟踪价格、竞争对手以及自身在 AI 搜索中的可见度。
技术栈的四个层级
1. 访问层。 确保能够成功访问页面,即从正确的地理位置访问,同时避免被限速或封禁。代理就在这一层发挥作用,而且这通常是最难的部分。
2. 采集层。 爬取和抓取可访问的页面,包括获取 HTML、跟踪链接,以及处理分页和动态内容。
3. 处理层。 将杂乱的 HTML 转换为结构化信号,包括提取(越来越多地通过基于 LLM 的提取)、清洗、去重和验证。
4. 交付层。 将结果交付至目标位置: 训练集、用于检索的向量存储,或代理的上下文窗口。
代理的位置:访问基础
只有第 1 层正常工作,第 2-4 层才能发挥作用,而第 1 层正是许多管道出问题的地方。目标网站会根据地理位置提供个性化内容、按 IP 限速,并识别数据中心 IP 段,因此任何需要真正大规模获取数据的 AI 系统都会很快遇到阻碍。Residential proxies 通过目标市场中的真实用户 IP 路由请求,提高网页访问成功率和地理位置准确性,并大幅降低被封禁的概率。对于代理集群或大规模爬取任务,按会话进行轮换的 IP 池可让每个请求看起来都来自不同的真实用户。这就是其他所有层级赖以建立的基础。
import requests
# The access layer in practice: an AI system fetches a live web page through a
# residential proxy so the request looks like a real user in the right market.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def fetch_for_ai(url):
r = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0", "Accept-Language": "en-US,en;q=0.9"},
timeout=30)
r.raise_for_status()
return r.text # hand the HTML to your extractor / model / RAG pipeline
html = fetch_for_ai("https://example.com/data")
DataImpulse 提供这一访问层: 住宅代理价格低至 $1/GB(移动代理低至 $2/GB),覆盖 195+ 个地区,支持轮换、地理位置定向和高并发,适合并行采集。模型、数据管道和代理程序都由你掌控,代理则让它们真正能够访问网络。
自建还是采购
大多数团队会自建采集、处理和交付层(这些层与你的数据和模型密切相关),并购买访问层(代理),因为维护覆盖全球、干净且未被封锁的 IP 池,本身就是一项需要全职投入的基础设施问题。实际的分工是: 自建爬虫和提取逻辑,租用 IP。评估访问服务商时,应像评估任何基础设施一样关注:地理覆盖范围、并发能力、成功率以及每 GB 成本。
为 AI 采集网页数据合法吗?
为 AI 采集公开的非个人网页数据是一种广泛实践,但并非无条件合法:公开可访问并不意味着可以忽略版权、合同、隐私或数据库权利问题,合法性取决于司法管辖区、来源、数据类型和用途。要让采集行为更具合法性依据:优先选择公开、非个人数据,遵守网站条款并将 robots.txt 视为政策信号,不要绕过登录或访问控制,控制请求频率,并为任何用于模型的数据记录来源。将代理用于合法采集通常是合法的;规避封禁或访问控制才是风险出现的地方。请参阅网络爬取是否合法。本文为一般信息,不构成法律建议。
常见问题
什么是面向 AI 的网页数据基础设施?
它是让 AI 系统能够从开放网络收集、访问和使用实时数据的技术栈,也就是连接网页与模型、RAG 管道或代理可用数据的层。它涵盖访问(代理)、采集(抓取)、处理(提取)和交付,并与计算和存储一起构成核心 AI 基础设施。
为什么 AI 系统需要网页数据?
模型基于大规模网页语料库进行训练,RAG 系统检索最新的网页数据以用当前事实作答,代理则通过浏览实时页面来执行操作。计算和存储无法为模型提供真实世界的最新信息,网页数据层可以。随着 AI 从静态数据集转向实时、代理式系统,这一层会变得至关重要。
代理在网页数据基础设施中处于什么位置?
代理是访问层,也就是基础。网站会进行地理位置个性化、速率限制并拦截自动化流量,因此大规模访问网页是难点。住宅代理通过目标市场中的真实消费者 IP 路由请求,提高网页访问成功率和地理定位准确性,并大幅降低被拦截的可能性,从而使采集、处理和交付层能够正常工作。
我应该自建还是购买网页数据基础设施?
大多数团队会自建采集、处理和交付层(因为它们与自身数据和模型相关),并购买访问层,也就是代理,因为维护一个全球范围内干净且未被封锁的 IP 池本身就是一项需要全职投入的基础设施工作。自建抓取器和提取流程,租用 IP,并根据地理覆盖、并发能力、成功率和每 GB 成本进行评估。
为 AI 收集网页数据合法吗?
采集公开的非个人网页数据很常见,但并非毫无条件。公开可访问并不意味着可以忽视版权、合同或隐私问题,合法性取决于司法管辖区、来源和用途。优先使用公开的非个人数据,遵守网站条款,并将 robots.txt 视为政策信号,不绕过登录,控制请求频率,并记录来源。将代理用于合法收集通常是合法的。非法律建议。