
Dans cet article
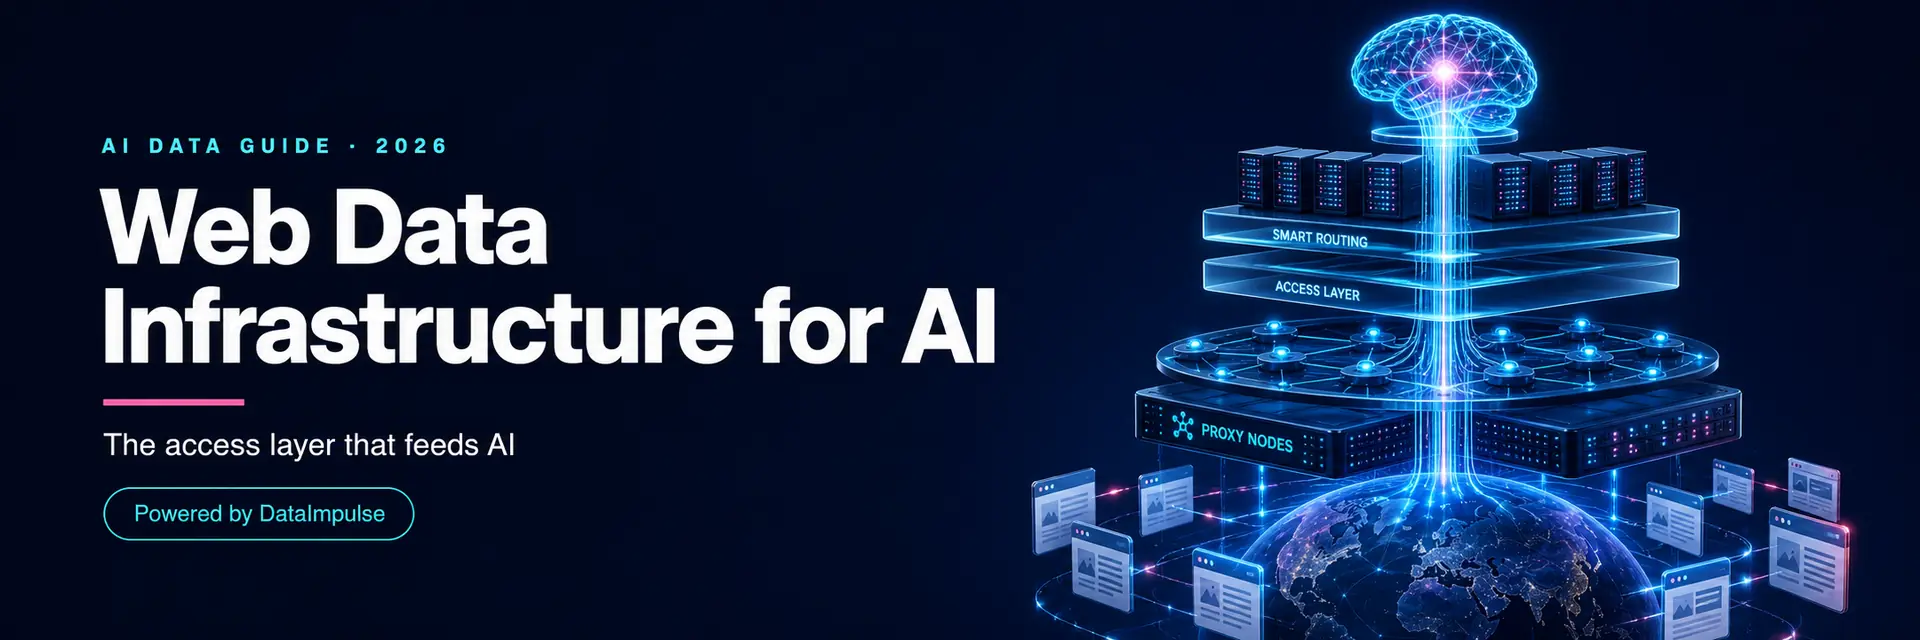
L’infrastructure de données web pour l’IA est l’ensemble qui permet aux systèmes d’IA de collecter, d’accéder à et d’utiliser des données en temps réel issues du web ouvert, la couche sous-jacente à l’entraînement des modèles, au RAG et aux agents autonomes. Les modèles n’apprennent pas et ne répondent pas dans le vide : ils ont besoin de données du monde réel, dont une grande partie provient du web. L’infrastructure qui permet de les collecter à grande échelle, sur différents marchés et sans être bloqué devient aussi fondamentale pour l’IA que le calcul et le stockage. Ce guide définit cette catégorie, détaille ses différentes couches et explique le rôle fondamental des proxies dans l’accès.
Je suis Andrii Byzov, CMO fractionnel spécialisé dans l’IA, et je construis des pipelines de données web pour les équipes IA. Vous trouverez ci-dessous une définition simple, les raisons pour lesquelles l’IA dépend des données web, les quatre couches de cette infrastructure, le rôle des proxies résidentiels et les critères à retenir pour choisir entre construire ou acheter. Ce guide sert de point de départ à nos autres contenus sur les données pour l’IA.
Faits clés
- L’infrastructure de données web pour l’IA = la couche d’accès et de collecte qui alimente l’entraînement, le RAG, l’ancrage et les agents avec des données web.
- Quatre couches : accès (proxies), collecte (scraping/crawling), traitement (extraction/nettoyage) et livraison (au modèle ou au pipeline).
- L’accès est souvent le goulot d’étranglement. Les sites adaptent leur contenu à la zone géographique, limitent le débit et bloquent le trafic automatisé. Obtenir les données peut donc être l’étape la plus difficile, surtout pour une collecte géociblée ou à fort volume.
- Les proxies résidentiels sont la base de l’accès : de véritables IP de consommateurs dans la zone géographique ciblée rendent le web plus accessible, plus précis géographiquement et beaucoup moins susceptible d’être bloqué à grande échelle.
- C’est désormais un critère d’achat. Les équipes IA évaluent de plus en plus l’infrastructure de données web (simultanéité, couverture géographique, coût par GB) comme elles évaluent les GPU.
Qu’est-ce que l’infrastructure de données web pour l’IA ?
L’infrastructure de données web pour l’IA désigne tout ce qui se situe entre le web ouvert et les données que votre IA peut utiliser. C’est le pipeline qui accède à une page, la récupère de manière fiable, la transforme en données structurées et les transmet à un modèle, à un pipeline RAG ou à un agent IA. Le calcul entraîne le modèle et le stockage conserve les données, mais aucun des deux ne fournit au modèle des informations réelles et actuelles : c’est le rôle de la couche de données web. À mesure que l’IA passe de jeux de données d’entraînement statiques à des systèmes vivants, ancrés et agentiques, cette couche devient une infrastructure essentielle, plutôt qu’un simple avantage.
Pourquoi l’IA dépend des données web
- Entraînement : les modèles apprennent à partir de corpus vastes et diversifiés, dont une grande partie est extraite du web public (données d’entraînement LLM).
- Ancrage & RAG : pour fournir des réponses fondées sur des faits récents, les systèmes récupèrent des données web à jour au moment de la requête, plutôt que de s’appuyer uniquement sur ce qu’ils ont mémorisé.
- Agents : les agents autonomes parcourent, comparent et exploitent des pages en temps réel ; ils ont donc besoin d’un accès au web en temps réel.
- Évaluation & surveillance : les équipes suivent les prix, les concurrents et leur propre visibilité dans la recherche IA à l’aide de données web.
Les quatre couches de l’infrastructure
1. Couche d’accès. Accéder à la page depuis la bonne zone géographique, sans subir de limitation de débit ni de blocage. C’est là que les proxies interviennent, et c’est souvent la partie la plus difficile.
2. Couche de collecte. Explorer et scraper les pages accessibles : récupérer le HTML, suivre les liens, gérer la pagination et le contenu dynamique.
3. Couche de traitement. Transformer un HTML désordonné en données structurées : extraction (de plus en plus au moyen d’une extraction basée sur les LLM), nettoyage, déduplication et validation.
4. Couche de livraison. Transmettre le résultat à sa destination : un jeu de données d’entraînement, une base vectorielle pour la récupération ou la fenêtre de contexte d’un agent.
Où s’intègrent les proxies : la base de l’accès
Les couches 2 à 4 ne fonctionnent que si la couche 1 est opérationnelle, or c’est à ce stade que de nombreux pipelines échouent. Les sites ciblés adaptent leur contenu selon la zone géographique, limitent le débit par IP et repèrent les plages d’IP de datacenters ; un système d’IA qui collecte des données à grande échelle se heurte donc rapidement à des obstacles. Les proxies résidentiels acheminent les requêtes via de véritables IP de consommateurs dans la zone géographique dont vous avez besoin, ce qui rend le web bien plus accessible, plus précis géographiquement et beaucoup moins susceptible d’être bloqué. Pour une flotte d’agents ou un crawl de grande ampleur, un pool rotatif avec une identité par session permet à chaque requête de ressembler à un utilisateur réel distinct. C’est la base sur laquelle repose tout le reste.
import requests
# The access layer in practice: an AI system fetches a live web page through a
# residential proxy so the request looks like a real user in the right market.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def fetch_for_ai(url):
r = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0", "Accept-Language": "en-US,en;q=0.9"},
timeout=30)
r.raise_for_status()
return r.text # hand the HTML to your extractor / model / RAG pipeline
html = fetch_for_ai("https://example.com/data")
DataImpulse fournit cette couche d’accès : des proxies résidentiels à partir de $1/GB et mobiles à partir de $2/GB, dans plus de 195 emplacements, avec rotation, géociblage et forte simultanéité pour la collecte parallèle. Le modèle, le pipeline et l’agent vous appartiennent ; les proxies leur donnent réellement accès au web.
Construire ou acheter
La plupart des équipes construisent les couches de collecte, de traitement et de livraison, qui sont propres à leurs données et à leurs modèles, et achètent la couche d’accès (proxies), car maintenir un pool mondial d’IP fiables et non bloquées est un travail d’infrastructure à plein temps. En pratique, gardez la maîtrise de vos scrapers et de votre logique d’extraction, et louez les IP. Évaluez les fournisseurs d’accès comme vous évalueriez n’importe quelle infrastructure : couverture géographique, simultanéité, taux de réussite et coût par GB.
La collecte de données web pour l’IA est-elle légale ?
La collecte de données web publiques et non personnelles pour l’IA est largement pratiquée, mais elle n’est pas inconditionnelle : la disponibilité publique n’efface pas les questions de droit d’auteur, de contrat, de confidentialité ou de droits sur les bases de données, et la légalité dépend de la juridiction, de la source, du type de données et de l’utilisation. Adoptez une approche défendable : privilégiez les données publiques et non personnelles, respectez les conditions des sites et tenez compte de robots.txt comme indication de leurs règles, ne contournez ni les connexions ni les contrôles d’accès, espacez les requêtes et suivez la provenance de tout ce qui alimente un modèle. L’utilisation de proxies pour une collecte légitime est généralement légale ; le risque survient lorsque l’on cherche à contourner des interdictions ou des contrôles d’accès. Consultez si le web scraping est légal. Il s’agit d’informations générales, et non de conseils juridiques.
Questions fréquemment posées
Qu’est-ce que l’infrastructure de données web pour l’IA ?
C’est l’infrastructure qui permet aux systèmes d’IA de collecter, d’accéder à et d’utiliser des données en temps réel provenant du web ouvert. Elle fait le lien entre le web et les données que votre modèle, votre pipeline RAG ou votre agent peut utiliser. Elle couvre l’accès (proxies), la collecte (scraping), le traitement (extraction) et la livraison, et elle s’inscrit aux côtés du calcul et du stockage comme infrastructure IA essentielle.
Pourquoi les systèmes d’IA ont-ils besoin de données web ?
Les modèles s’entraînent sur de grands corpus web, les systèmes RAG récupèrent des données web fraîches pour répondre avec des faits actuels, et les agents parcourent des pages en direct pour agir. Le calcul et le stockage ne fournissent pas à un modèle des informations réelles et à jour ; la couche de données web, si. À mesure que l’IA passe de jeux de données statiques à des systèmes en direct et agentiques, cette couche devient fondamentale.
Où les proxies s’intègrent-ils dans l’infrastructure de données web ?
Les proxies constituent la couche d’accès : la fondation. Les sites adaptent leur contenu à la zone géographique, limitent les débits et bloquent le trafic automatisé, ce qui complique l’accès aux pages à grande échelle. Les proxies résidentiels acheminent les requêtes via de véritables IP de consommateurs dans la zone géographique ciblée, ce qui rend le web plus accessible, plus précis géographiquement et beaucoup moins susceptible d’être bloqué, afin que les couches de collecte, de traitement et de livraison puissent fonctionner.
Dois-je créer ou acheter une infrastructure de données web ?
La plupart des équipes créent les couches de collecte, de traitement et de livraison (spécifiques à leurs données et à leurs modèles) et achètent la couche d’accès, les proxies, car maintenir un pool mondial d’IP fiables et non bloquées est un travail d’infrastructure à plein temps. Gardez la maîtrise de vos scrapers et de votre extraction ; louez les IP, en les évaluant selon la couverture géographique, la simultanéité, le taux de réussite et le coût par GB.
La collecte de données web pour l’IA est-elle légale ?
La collecte de données web publiques et non personnelles est largement pratiquée, mais elle n’est pas sans conditions : la disponibilité publique n’efface pas les questions de droit d’auteur, de contrat ou de confidentialité, et sa légalité dépend de la juridiction, de la source et de l’usage. Privilégiez les données publiques et non personnelles, respectez les conditions des sites et tenez compte de robots.txt, ne contournez pas les connexions, espacez les requêtes et suivez la provenance. L’utilisation de proxies pour une collecte légitime est généralement légale. Ceci ne constitue pas un avis juridique.
Conclusion
À mesure que l’IA passe d’un entraînement statique à des systèmes vivants, contextualisés et agentiques, l’infrastructure de données web devient aussi fondamentale que le calcul et le stockage. Sa couche la plus complexe est l’accès. Accéder au web à grande échelle, depuis les zones géographiques pertinentes et sans être bloqué, rend possible tout ce qui en dépend : c’est précisément le rôle de la couche proxy. Construisez vos scrapers, vos systèmes d’extraction et vos pipelines ; utilisez une couche d’accès reposant sur des proxies résidentiels qui maintient le web accessible. Explorez les différents éléments : proxies pour agents IA, données d’entraînement LLM, pipelines RAG et web scraping IA.
Dernière mise à jour : 27 juin 2026.