
ในบทความนี้
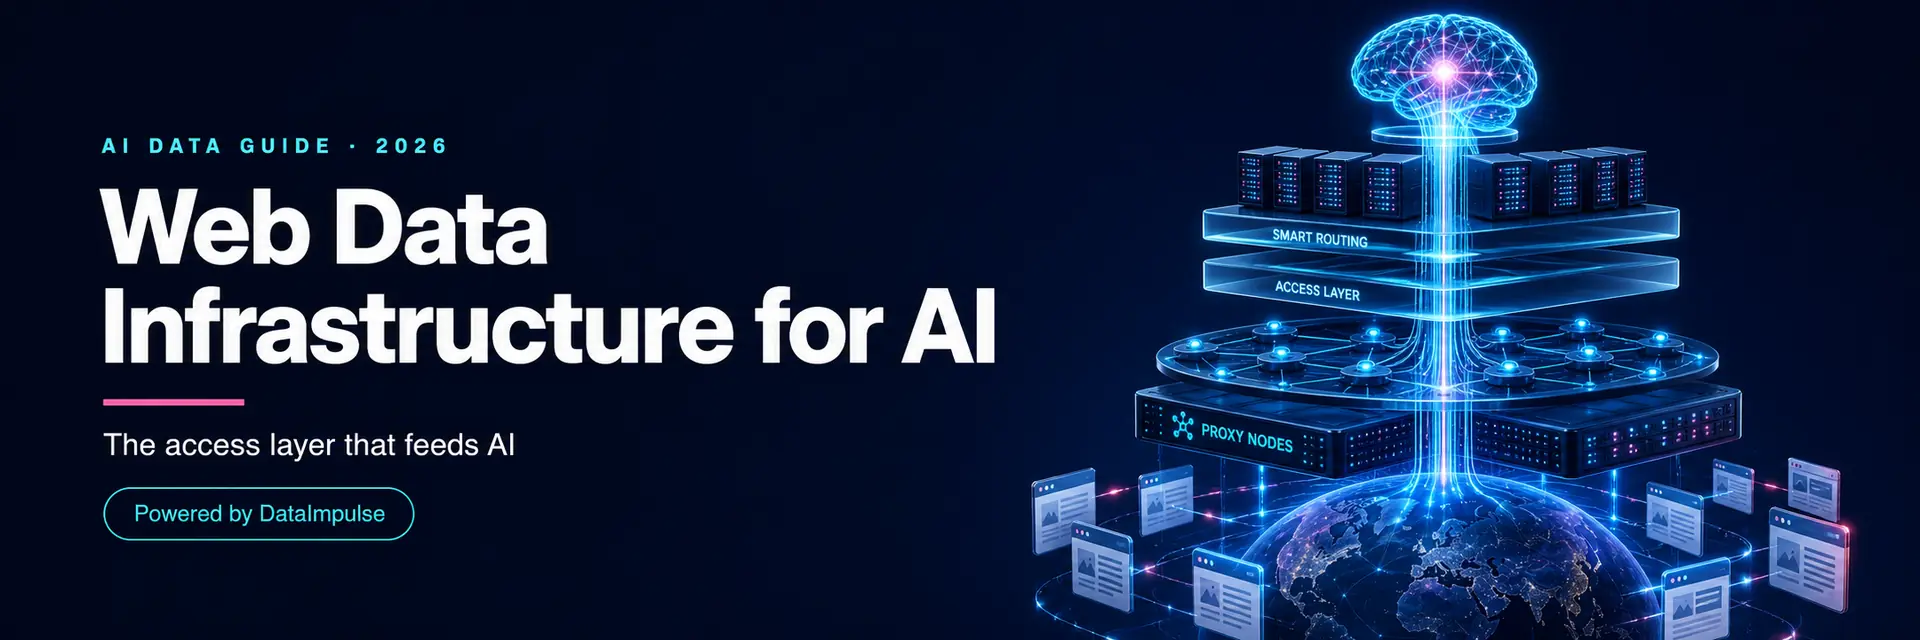
โครงสร้างพื้นฐานข้อมูลเว็บสำหรับ AI คือชุดระบบที่ช่วยให้ระบบ AI รวบรวม เข้าถึง และใช้ข้อมูลแบบสดจากเว็บสาธารณะ ซึ่งเป็นชั้นที่อยู่ใต้การฝึกโมเดล RAG และเอเจนต์อัตโนมัติ โมเดลไม่ได้เรียนรู้หรือตอบคำถามในสุญญากาศ แต่ต้องการข้อมูลจากโลกจริง และข้อมูลจำนวนมากมาจากเว็บ โครงสร้างพื้นฐานที่รวบรวมข้อมูลนี้ในระดับขนาดใหญ่ ข้ามตลาด และโดยไม่ถูกบล็อก กำลังกลายเป็นรากฐานสำคัญของ AI เช่นเดียวกับการประมวลผลและพื้นที่จัดเก็บ คู่มือนี้นิยามหมวดหมู่นี้ แยกอธิบายแต่ละชั้น และบอกตำแหน่งของ proxy ในฐานะรากฐานด้านการเข้าถึง
ผมคือ Andrii Byzov, AI-Native Fractional CMO ผู้สร้างไปป์ไลน์ข้อมูลเว็บให้ทีม AI ด้านล่างนี้คือคำนิยามแบบเข้าใจง่าย เหตุผลที่ AI พึ่งพาข้อมูลเว็บ สี่ชั้นของชุดระบบ ตำแหน่งของ residential proxy และวิธีคิดเรื่องการสร้างเองเทียบกับการซื้อ นี่คือแกนหลักที่คู่มือข้อมูล AI อื่น ๆ ของเราเชื่อมโยงเข้ามา
ประเด็นสำคัญ
- โครงสร้างพื้นฐานข้อมูลเว็บสำหรับ AI = ชั้นการเข้าถึง + การรวบรวม ซึ่งป้อนข้อมูลเว็บสู่การฝึก RAG/การยึดโยงกับข้อเท็จจริง และเอเจนต์
- สี่ชั้น: การเข้าถึง (proxy) การรวบรวม (scraping/crawling) การประมวลผล (การดึงข้อมูล/การทำความสะอาด) และการส่งต่อ (ไปยังโมเดลหรือไปป์ไลน์)
- การเข้าถึงมักเป็นคอขวด เว็บไซต์ปรับเนื้อหาตามภูมิศาสตร์ จำกัดอัตราการใช้งาน และบล็อกทราฟฟิกอัตโนมัติ ดังนั้นแค่การได้ข้อมูลมาก็อาจเป็นส่วนที่ยาก โดยเฉพาะการรวบรวมที่ระบุพื้นที่หรือมีปริมาณสูง
- Residential proxy คือรากฐานด้านการเข้าถึง โดย IP ของผู้บริโภคจริงในตลาดที่ถูกต้องทำให้เข้าถึงเว็บได้มากขึ้น แม่นยำตามภูมิศาสตร์ และมีโอกาสถูกบล็อกน้อยลงมากเมื่อทำงานในระดับขนาดใหญ่
- ปัจจุบันนี่เป็นเกณฑ์ในการเลือกซื้อ ทีม AI ประเมินโครงสร้างพื้นฐานข้อมูลเว็บมากขึ้นเรื่อย ๆ ทั้ง concurrency ความครอบคลุมตามภูมิศาสตร์ และต้นทุนต่อ GB เช่นเดียวกับที่ประเมิน GPU
โครงสร้างพื้นฐานข้อมูลเว็บสำหรับ AI คืออะไร?
โครงสร้างพื้นฐานข้อมูลเว็บสำหรับ AI คือทุกสิ่งที่อยู่ระหว่าง “เว็บสาธารณะ” และ “ข้อมูลที่ AI ของคุณใช้ได้” เป็นไปป์ไลน์ที่เข้าถึงหน้าเว็บ ดึงข้อมูลได้อย่างเชื่อถือได้ แปลงเป็นสัญญาณที่มีโครงสร้าง แล้วส่งต่อไปยังโมเดล ไปป์ไลน์ RAG หรือ เอเจนต์ AI การประมวลผลฝึกโมเดลและพื้นที่จัดเก็บเก็บโมเดลไว้ แต่ทั้งสองอย่างไม่ได้มอบข้อมูลปัจจุบันจากโลกจริงให้โมเดล ชั้นข้อมูลเว็บต่างหากที่ทำเช่นนั้น เมื่อ AI เปลี่ยนจากชุดข้อมูลฝึกแบบคงที่สู่ระบบแบบสดที่ยึดโยงกับข้อเท็จจริงและทำงานแบบเอเจนต์ ชั้นนี้จึงเปลี่ยนจากสิ่งที่มีก็ดีเป็นโครงสร้างพื้นฐานหลัก
เหตุใด AI จึงพึ่งพาข้อมูลเว็บ
- การฝึก โมเดลเรียนรู้จากคลังข้อมูลขนาดใหญ่และหลากหลาย ซึ่งส่วนมาก scraping มาจากเว็บสาธารณะ (ข้อมูลฝึก LLM)
- การยึดโยงกับข้อเท็จจริง & RAG เพื่อให้ตอบด้วยข้อเท็จจริงปัจจุบัน ระบบจะดึงข้อมูลเว็บใหม่ในเวลาที่มีคำค้นหา ไม่ได้อาศัยเพียงสิ่งที่จดจำไว้
- เอเจนต์ เอเจนต์อัตโนมัติท่องเว็บ เปรียบเทียบ และดำเนินการบนหน้าเว็บแบบสด จึงต้องเข้าถึงเว็บแบบเรียลไทม์
- การประเมินผล & การติดตาม ทีมต่าง ๆ ติดตามราคา คู่แข่ง และการมองเห็นของตนเองในการค้นหา AI ด้วยข้อมูลเว็บ
สี่ชั้นของชุดระบบ
1. ชั้นการเข้าถึง การเข้าถึงหน้าเว็บจากตำแหน่งที่ถูกต้องโดยไม่ถูกจำกัดอัตราการใช้งานหรือบล็อก นี่คือตำแหน่งของ proxy และมักเป็นส่วนที่ยากที่สุด
2. ชั้นการรวบรวม การ crawling และ scraping หน้าเว็บที่เข้าถึงได้ การดึง HTML การตามลิงก์ และการจัดการ pagination กับเนื้อหาแบบไดนามิก
3. ชั้นการประมวลผล การแปลง HTML ที่ยุ่งเหยิงเป็นสัญญาณที่มีโครงสร้าง ได้แก่ การดึงข้อมูล (เพิ่มขึ้นเรื่อย ๆ ผ่าน การดึงข้อมูลด้วย LLM) การทำความสะอาด การลบข้อมูลซ้ำ และการตรวจสอบความถูกต้อง
4. ชั้นการส่งต่อ ป้อนผลลัพธ์ไปยังปลายทาง ได้แก่ ชุดข้อมูลฝึก vector store สำหรับการดึงข้อมูล หรือ context window ของเอเจนต์
ตำแหน่งของ proxy: รากฐานด้านการเข้าถึง
ชั้น 2-4 จะทำงานได้ก็ต่อเมื่อชั้น 1 ทำงาน และชั้น 1 คือจุดที่ไปป์ไลน์จำนวนมากสะดุด เว็บไซต์เป้าหมายปรับเนื้อหาตามภูมิศาสตร์ จำกัดอัตราตาม IP และระบุช่วง datacenter ทำให้ระบบ AI ที่ดึงข้อมูลในขนาดจริงเจออุปสรรคอย่างรวดเร็ว Residential proxy ส่งคำขอผ่าน IP ของผู้บริโภคจริงในตลาดที่คุณต้องการ จึงเข้าถึงเว็บได้มากขึ้น แม่นยำตามภูมิศาสตร์ และมีโอกาสถูกบล็อกน้อยลงมาก สำหรับกลุ่มเอเจนต์หรือการ crawl ขนาดใหญ่ กลุ่ม IP ที่หมุนเวียนพร้อมอัตลักษณ์รายเซสชันทำให้แต่ละคำขอดูเหมือนผู้ใช้จริงที่แตกต่างกัน นี่คือรากฐานที่ทุกสิ่งอื่นตั้งอยู่
import requests
# The access layer in practice: an AI system fetches a live web page through a
# residential proxy so the request looks like a real user in the right market.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def fetch_for_ai(url):
r = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0", "Accept-Language": "en-US,en;q=0.9"},
timeout=30)
r.raise_for_status()
return r.text # hand the HTML to your extractor / model / RAG pipeline
html = fetch_for_ai("https://example.com/data")
DataImpulse ให้บริการชั้นการเข้าถึงดังกล่าว residential เริ่มที่ $1/GB (mobile เริ่มที่ $2/GB) ครอบคลุม 195+ พื้นที่ พร้อมการหมุนเวียน การกำหนดเป้าหมายตามภูมิศาสตร์ และ concurrency สูงสำหรับการรวบรวมแบบขนาน โมเดล ไปป์ไลน์ และเอเจนต์เป็นของคุณ ส่วน proxy ทำให้ทั้งหมดเข้าถึงเว็บได้จริง
สร้างเองเทียบกับซื้อ
ทีมส่วนใหญ่สร้างชั้นการรวบรวม การประมวลผล และการส่งต่อเอง (เพราะเฉพาะกับข้อมูลและโมเดลของคุณ) และ ซื้อชั้นการเข้าถึง (proxy) เนื่องจากการดูแลกลุ่ม IP ที่สะอาดและไม่ถูกบล็อกทั่วโลกเป็นปัญหาโครงสร้างพื้นฐานเต็มเวลาในตัวเอง แนวแบ่งงานที่ใช้ได้จริงคือ เป็นเจ้าของ scraper และตรรกะการดึงข้อมูลของคุณ แล้วเช่า IP ประเมินผู้ให้บริการการเข้าถึงเช่นเดียวกับโครงสร้างพื้นฐานอื่น โดยดูความครอบคลุมตามภูมิศาสตร์ concurrency อัตราความสำเร็จ และต้นทุนต่อ GB
การรวบรวมข้อมูลเว็บสำหรับ AI ถูกกฎหมายหรือไม่?
การรวบรวมข้อมูลเว็บสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลสำหรับ AI เป็นแนวปฏิบัติที่แพร่หลาย แต่ไม่มีเงื่อนไขตายตัว การเปิดเผยต่อสาธารณะไม่ได้ลบข้อกังวลเรื่องลิขสิทธิ์ สัญญา ความเป็นส่วนตัว หรือสิทธิในฐานข้อมูล และความชอบด้วยกฎหมายขึ้นอยู่กับเขตอำนาจ แหล่งที่มา ประเภทข้อมูล และการใช้งาน ควรรวบรวมข้อมูลอย่างมีเหตุผล โดยเลือกข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคล ปฏิบัติตามข้อกำหนดของเว็บไซต์และถือ robots.txt เป็นสัญญาณเชิงนโยบาย อย่าข้ามการเข้าสู่ระบบหรือการควบคุมการเข้าถึง ควบคุมจังหวะคำขอ และติดตามที่มาสำหรับทุกสิ่งที่ป้อนเข้าสู่โมเดล การใช้ proxy เพื่อการรวบรวมที่เหมาะสมโดยทั่วไปชอบด้วยกฎหมาย การหลีกเลี่ยงการแบนหรือการควบคุมการเข้าถึงคือจุดที่ความเสี่ยงเกิดขึ้น ดู ว่า web scraping ถูกกฎหมายหรือไม่ นี่เป็นข้อมูลทั่วไป ไม่ใช่คำแนะนำทางกฎหมาย
คำถามที่พบบ่อย
โครงสร้างพื้นฐานข้อมูลเว็บสำหรับ AI คืออะไร?
เป็นชุดระบบที่ช่วยให้ระบบ AI รวบรวม เข้าถึง และใช้ข้อมูลแบบสดจากเว็บสาธารณะ เป็นชั้นระหว่างเว็บกับข้อมูลที่โมเดล ไปป์ไลน์ RAG หรือเอเจนต์ของคุณใช้ได้ ครอบคลุมการเข้าถึง (proxy) การรวบรวม (scraping) การประมวลผล (การดึงข้อมูล) และการส่งต่อ และอยู่เคียงคู่กับการประมวลผลและพื้นที่จัดเก็บในฐานะโครงสร้างพื้นฐาน AI หลัก
เหตุใดระบบ AI จึงต้องการข้อมูลเว็บ?
โมเดลฝึกจากคลังข้อมูลเว็บขนาดใหญ่ ระบบ RAG ดึงข้อมูลเว็บใหม่เพื่อตอบด้วยข้อเท็จจริงปัจจุบัน และเอเจนต์ท่องหน้าเว็บแบบสดเพื่อดำเนินการ การประมวลผลและพื้นที่จัดเก็บไม่ได้มอบข้อมูลจากโลกจริงที่เป็นปัจจุบันให้โมเดล ชั้นข้อมูลเว็บต่างหากที่ทำเช่นนั้น เมื่อ AI เปลี่ยนจากชุดข้อมูลคงที่สู่ระบบแบบสดและแบบเอเจนต์ ชั้นนี้จึงกลายเป็นรากฐานสำคัญ
proxy อยู่ตรงไหนในโครงสร้างพื้นฐานข้อมูลเว็บ?
Proxy คือชั้นการเข้าถึง ซึ่งเป็นรากฐาน เว็บไซต์ปรับเนื้อหาตามภูมิศาสตร์ จำกัดอัตราการใช้งาน และบล็อกทราฟฟิกอัตโนมัติ ดังนั้นการเข้าถึงหน้าเว็บในระดับขนาดใหญ่จึงเป็นส่วนที่ยาก residential proxy ส่งคำขอผ่าน IP ของผู้บริโภคจริงในตลาดที่ถูกต้อง ทำให้เข้าถึงเว็บได้มากขึ้น แม่นยำตามภูมิศาสตร์ และมีโอกาสถูกบล็อกน้อยลงมาก เพื่อให้ชั้นการรวบรวม การประมวลผล และการส่งต่อทำงานได้
ควรสร้างหรือซื้อโครงสร้างพื้นฐานข้อมูลเว็บ?
ทีมส่วนใหญ่สร้างชั้นการรวบรวม การประมวลผล และการส่งต่อเอง ซึ่งเฉพาะกับข้อมูลและโมเดลของตน และซื้อชั้นการเข้าถึง คือ proxy เพราะการดูแลกลุ่ม IP ที่สะอาดและไม่ถูกบล็อกทั่วโลกเป็นปัญหาโครงสร้างพื้นฐานเต็มเวลาในตัวเอง เป็นเจ้าของ scraper และการดึงข้อมูลของคุณ แล้วเช่า IP โดยประเมินจากความครอบคลุมตามภูมิศาสตร์ concurrency อัตราความสำเร็จ และต้นทุนต่อ GB
การรวบรวมข้อมูลเว็บสำหรับ AI ถูกกฎหมายหรือไม่?
การรวบรวมข้อมูลเว็บสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคลเป็นแนวปฏิบัติที่แพร่หลาย แต่ไม่มีเงื่อนไขตายตัว การเปิดเผยต่อสาธารณะไม่ได้ลบข้อกังวลด้านลิขสิทธิ์ สัญญา หรือความเป็นส่วนตัว และความชอบด้วยกฎหมายขึ้นอยู่กับเขตอำนาจ แหล่งที่มา และการใช้งาน เลือกข้อมูลสาธารณะที่ไม่ใช่ข้อมูลส่วนบุคคล เคารพข้อกำหนดของเว็บไซต์และ robots.txt อย่าข้ามการเข้าสู่ระบบ ควบคุมจังหวะคำขอ และติดตามที่มา การใช้ proxy เพื่อการรวบรวมที่เหมาะสมโดยทั่วไปชอบด้วยกฎหมาย ไม่ใช่คำแนะนำทางกฎหมาย
บทสรุป
เมื่อ AI เปลี่ยนจากการฝึกแบบคงที่สู่ระบบแบบสดที่ยึดโยงกับข้อเท็จจริงและทำงานแบบเอเจนต์ โครงสร้างพื้นฐานข้อมูลเว็บจะกลายเป็นรากฐานสำคัญเทียบเท่าการประมวลผลและพื้นที่จัดเก็บ และชั้นที่ยากที่สุดคือการเข้าถึง การเข้าถึงเว็บในระดับขนาดใหญ่จากตลาดที่ถูกต้องโดยไม่ถูกบล็อกคือสิ่งที่ทำให้ทุกอย่างด้านบนเป็นไปได้ และนั่นคือชั้น proxy สร้าง scraper การดึงข้อมูล และไปป์ไลน์ของคุณ แล้วเช่าชั้นการเข้าถึง residential proxy ที่ทำให้เข้าถึงเว็บได้ สำรวจองค์ประกอบต่าง ๆ: proxy สำหรับเอเจนต์ AI, ข้อมูลฝึก LLM, ไปป์ไลน์ RAG และ web scraping ด้วย AI.
อัปเดตล่าสุด: 27 มิถุนายน 2026.