
In this Article
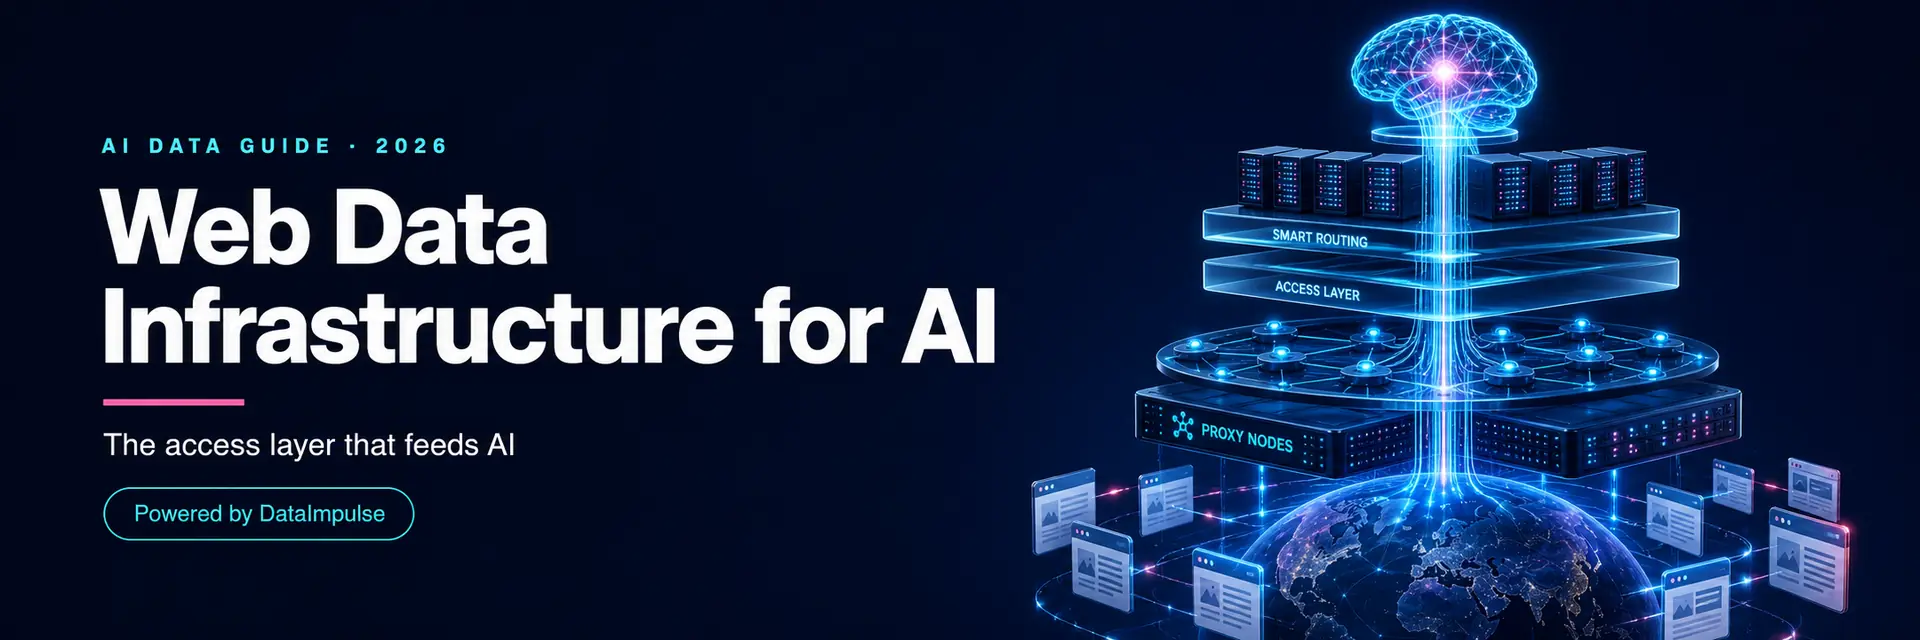
AI를 위한 웹 데이터 인프라는 AI 시스템이 공개 웹의 실시간 데이터를 수집하고, 접근하고, 활용할 수 있게 하는 스택입니다. 이는 모델 학습, RAG, 자율 에이전트 아래에 있는 계층입니다. 모델은 진공 상태에서 학습하거나 답하지 않습니다. 현실 세계의 데이터가 필요하며, 그중 상당수는 웹에서 나옵니다. 시장 전반에서, 차단되지 않고, 대규모로 이를 수집하는 인프라는 컴퓨팅 및 스토리지 못지않게 AI의 기반이 되고 있습니다. 이 가이드에서는 이 범주를 정의하고 계층을 나누어 살펴보며, 접근 기반으로서 프록시가 어디에 위치하는지 설명합니다.
저는 AI 팀을 위한 웹 데이터 파이프라인을 구축하는 AI 네이티브 파트타임 CMO, Andrii Byzov입니다. 아래에서는 간단한 정의, AI가 웹 데이터에 의존하는 이유, 스택의 네 가지 계층, 레지덴셜 프록시가 위치하는 곳, 그리고 구축과 구매를 어떻게 판단할지를 다룹니다. 이는 나머지 AI 데이터 가이드가 연결되는 핵심 글입니다.
핵심 정보
- AI를 위한 웹 데이터 인프라 = 접근 + 수집 계층으로, 웹 데이터를 학습, RAG/그라운딩 및 에이전트에 제공합니다.
- 네 가지 계층: 접근(프록시), 수집(스크래핑/크롤링), 처리(추출/정제), 전달(모델 또는 파이프라인으로)입니다.
- 접근은 흔히 병목 지점입니다. 사이트는 지역별로 개인화하고, 속도를 제한하며, 자동화 트래픽을 차단하므로, 데이터를 아예 확보하는 것 자체가 어려울 수 있습니다. 특히 지역별 또는 대규모 수집에서 그렇습니다.
- 레지덴셜 프록시(residential proxy)는 접근의 기반입니다. 필요한 시장의 실제 소비자 IP는 웹에 더 쉽게 접근하게 하고, 지역 정확도를 높이며, 대규모에서 차단될 가능성을 크게 낮춥니다.
- 이제는 구매 기준입니다. AI 팀은 GPU를 평가하듯 웹 데이터 인프라(동시성, 지역 커버리지, GB당 비용)를 점점 더 평가하고 있습니다.
AI를 위한 웹 데이터 인프라란 무엇입니까?
AI를 위한 웹 데이터 인프라는 “공개 웹”과 “AI가 사용할 수 있는 데이터” 사이에 있는 모든 것입니다. 페이지에 도달하고, 안정적으로 가져오며, 이를 구조화된 신호로 전환해 모델, RAG 파이프라인 또는 AI 에이전트에 전달하는 파이프라인입니다. 컴퓨팅은 모델을 학습시키고 스토리지는 모델을 저장하지만, 어느 쪽도 모델에 현실 세계의 최신 정보를 제공하지는 못합니다. 웹 데이터 계층이 이를 제공합니다. AI가 정적인 학습 세트에서 실시간 그라운디드 에이전틱 시스템으로 전환됨에 따라, 이 계층은 있으면 좋은 요소에서 핵심 인프라로 바뀌고 있습니다.
AI가 웹 데이터에 의존하는 이유
- 학습: 모델은 대규모의 다양한 코퍼스에서 학습하며, 그중 상당수는 공개 웹에서 스크래핑한 것입니다(LLM 학습 데이터).
- 그라운딩 및 RAG: 시스템은 최신 사실을 바탕으로 답하기 위해, 기억한 내용만 사용하는 대신 쿼리 시점에 새로운 웹 데이터를 가져옵니다.
- 에이전트: 자율 에이전트는 실시간 페이지를 탐색하고 비교하며 그에 따라 행동하므로, 실시간 웹 접근이 필요합니다.
- 평가 및 모니터링: 팀은 웹 데이터를 사용하여 가격, 경쟁사 및 자체 AI 검색 가시성을 추적합니다.
스택의 네 가지 계층
1. 접근 계층. 올바른 위치에서, 속도 제한이나 차단 없이 페이지 자체에 도달하는 계층입니다. 프록시가 여기에 있으며, 흔히 가장 어려운 부분입니다.
2. 수집 계층. 접근 가능한 페이지를 크롤링하고 스크래핑하는 계층입니다. HTML을 가져오고, 링크를 따라가며, 페이지네이션과 동적 콘텐츠를 처리합니다.
3. 처리 계층. 정돈되지 않은 HTML을 구조화된 신호로 바꾸는 계층입니다. 추출(점차 LLM 기반 추출 사용), 정제, 중복 제거, 검증을 포함합니다.
4. 전달 계층. 결과를 대상에 제공하는 계층입니다. 학습 세트, 검색용 벡터 스토어 또는 에이전트의 컨텍스트 창이 대상이 될 수 있습니다.
프록시의 위치: 접근의 기반
계층 2-4는 계층 1이 작동할 때만 작동하며, 계층 1은 많은 파이프라인이 실패하는 곳입니다. 대상 사이트는 지역에 따라 개인화하고, IP별로 속도를 제한하며, 데이터센터 범위를 플래그로 지정하므로, 실제 규모로 데이터를 가져오는 AI 시스템은 빠르게 벽에 부딪힙니다. 레지덴셜 프록시는 필요한 시장의 실제 소비자 IP를 통해 요청을 라우팅하므로, 웹에 훨씬 더 쉽게 접근할 수 있고 지역 정확도가 높으며 차단될 가능성이 훨씬 낮습니다. 에이전트 집단 또는 대규모 크롤링의 경우, 세션별 ID를 갖춘 로테이팅 풀이 각 요청을 서로 다른 실제 사용자처럼 보이게 유지합니다. 이것이 다른 모든 것이 놓이는 기반입니다.
import requests
# The access layer in practice: an AI system fetches a live web page through a
# residential proxy so the request looks like a real user in the right market.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def fetch_for_ai(url):
r = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0", "Accept-Language": "en-US,en;q=0.9"},
timeout=30)
r.raise_for_status()
return r.text # hand the HTML to your extractor / model / RAG pipeline
html = fetch_for_ai("https://example.com/data")
DataImpulse는 195개 이상의 지역에서 $1/GB부터의 레지덴셜 서비스($2/GB부터의 모바일 서비스)를 통해 이러한 접근 계층을 제공합니다. 로테이팅 및 지역 타기팅을 지원하고 병렬 수집을 위한 높은 동시성을 갖추고 있습니다. 모델, 파이프라인, 에이전트는 여러분의 것이며, 프록시는 이들이 실제로 웹에 접근할 수 있게 합니다.
구축과 구매
대부분의 팀은 수집, 처리, 전달 계층은 구축하고(데이터와 모델에 특화되어 있기 때문입니다), 접근 계층(프록시)은 구매합니다. 깨끗하고 차단되지 않은 IP의 글로벌 풀을 유지하는 일은 그 자체로 전업 인프라 문제이기 때문입니다. 실용적인 분담은 다음과 같습니다. 스크레이퍼와 추출 로직은 직접 소유하고, IP는 임대합니다. 다른 인프라를 평가하듯 접근 제공업체도 지역 커버리지, 동시성, 성공률, GB당 비용을 기준으로 평가해야 합니다.
AI를 위해 웹 데이터를 수집하는 것은 합법적입니까?
공개된 비개인 웹 데이터를 AI용으로 수집하는 것은 널리 행해지지만, 무조건적인 것은 아닙니다. 공개되어 있다고 해서 저작권, 계약, 개인정보 보호 또는 데이터베이스 권리에 관한 문제가 사라지는 것은 아니며, 적법성은 관할권, 출처, 데이터 유형, 이용 방식에 따라 달라집니다. 수집을 정당화할 수 있는 상태로 유지해야 합니다. 공개된 비개인 데이터를 우선하고, 사이트 약관을 따르며 robots.txt를 정책 신호로 취급하고, 로그인이나 접근 제어를 우회하지 말고, 요청 속도를 조절하며, 모델에 제공되는 모든 데이터의 출처 이력을 추적해야 합니다. 정당한 수집을 위해 프록시를 사용하는 것은 일반적으로 적법하지만, 차단이나 접근 제어를 회피하는 경우에 위험이 발생합니다. 웹 스크래핑이 합법적인지를 참조하십시오. 이는 일반 정보이며 법률 자문이 아닙니다.
자주 묻는 질문
AI를 위한 웹 데이터 인프라란 무엇입니까?
AI 시스템이 공개 웹의 실시간 데이터를 수집하고, 접근하고, 활용하게 하는 스택입니다. 웹과 모델, RAG 파이프라인 또는 에이전트가 사용할 수 있는 데이터 사이의 계층입니다. 접근(프록시), 수집(스크래핑), 처리(추출), 전달을 아우르며, 컴퓨팅과 스토리지에 더해 핵심 AI 인프라를 이룹니다.
AI 시스템에 웹 데이터가 필요한 이유는 무엇입니까?
모델은 대규모 웹 코퍼스에서 학습하고, RAG 시스템은 최신 사실로 답하기 위해 새로운 웹 데이터를 가져오며, 에이전트는 행동하기 위해 실시간 페이지를 탐색합니다. 컴퓨팅과 스토리지는 모델에 현실 세계의 최신 정보를 주지 못합니다. 웹 데이터 계층이 이를 제공합니다. AI가 정적 데이터 세트에서 실시간 에이전틱 시스템으로 이동하면서 이 계층은 기반이 됩니다.
프록시는 웹 데이터 인프라에서 어디에 위치합니까?
프록시는 기반인 접근 계층입니다. 사이트는 지역별로 개인화하고, 속도를 제한하며, 자동화 트래픽을 차단하므로 대규모로 페이지에 도달하는 일이 어렵습니다. 레지덴셜 프록시는 올바른 시장의 실제 소비자 IP를 통해 요청을 라우팅하여 웹 접근성을 높이고 지역 정확도를 높이며 차단될 가능성을 크게 낮추므로, 수집, 처리, 전달 계층이 작동할 수 있습니다.
웹 데이터 인프라는 구축해야 합니까, 구매해야 합니까?
대부분의 팀은 데이터와 모델에 특화된 수집, 처리, 전달 계층은 구축하고, 깨끗하고 차단되지 않은 IP의 글로벌 풀을 유지하는 것은 그 자체로 전업 인프라 문제이므로 접근 계층인 프록시는 구매합니다. 스크레이퍼와 추출 기능은 직접 소유하고, IP는 임대하십시오. 지역 커버리지, 동시성, 성공률, GB당 비용으로 평가해야 합니다.
AI를 위해 웹 데이터를 수집하는 것은 합법적입니까?
공개된 비개인 데이터 수집은 널리 행해지지만 무조건적인 것은 아닙니다. 공개되어 있다고 해서 저작권, 계약 또는 개인정보 보호에 관한 문제가 사라지는 것은 아니며, 적법성은 관할권, 출처, 이용 방식에 따라 달라집니다. 공개된 비개인 데이터를 우선하고, 사이트 약관과 robots.txt를 존중하며, 로그인을 우회하지 말고, 요청 속도를 조절하고, 출처 이력을 추적해야 합니다. 정당한 수집을 위해 프록시를 사용하는 것은 일반적으로 적법합니다. 법률 자문이 아닙니다.
결론
AI가 정적 학습에서 실시간 그라운디드 에이전틱 시스템으로 전환됨에 따라, 웹 데이터 인프라는 컴퓨팅과 스토리지 못지않은 기반이 되며, 그중 가장 어려운 계층은 접근입니다. 올바른 시장에서 차단되지 않고 대규모로 웹에 도달하는 것이 그 위의 모든 것을 가능하게 하며, 그것이 프록시 계층입니다. 스크레이퍼, 추출 기능, 파이프라인은 구축하고, 웹에 계속 접근할 수 있게 하는 레지덴셜 프록시 접근 계층은 임대하십시오. 구성 요소를 살펴보십시오. AI 에이전트용 프록시, LLM 학습 데이터, RAG 파이프라인, AI 웹 스크래핑.
최종 업데이트: 2026년 6월 27일.