
In this Article
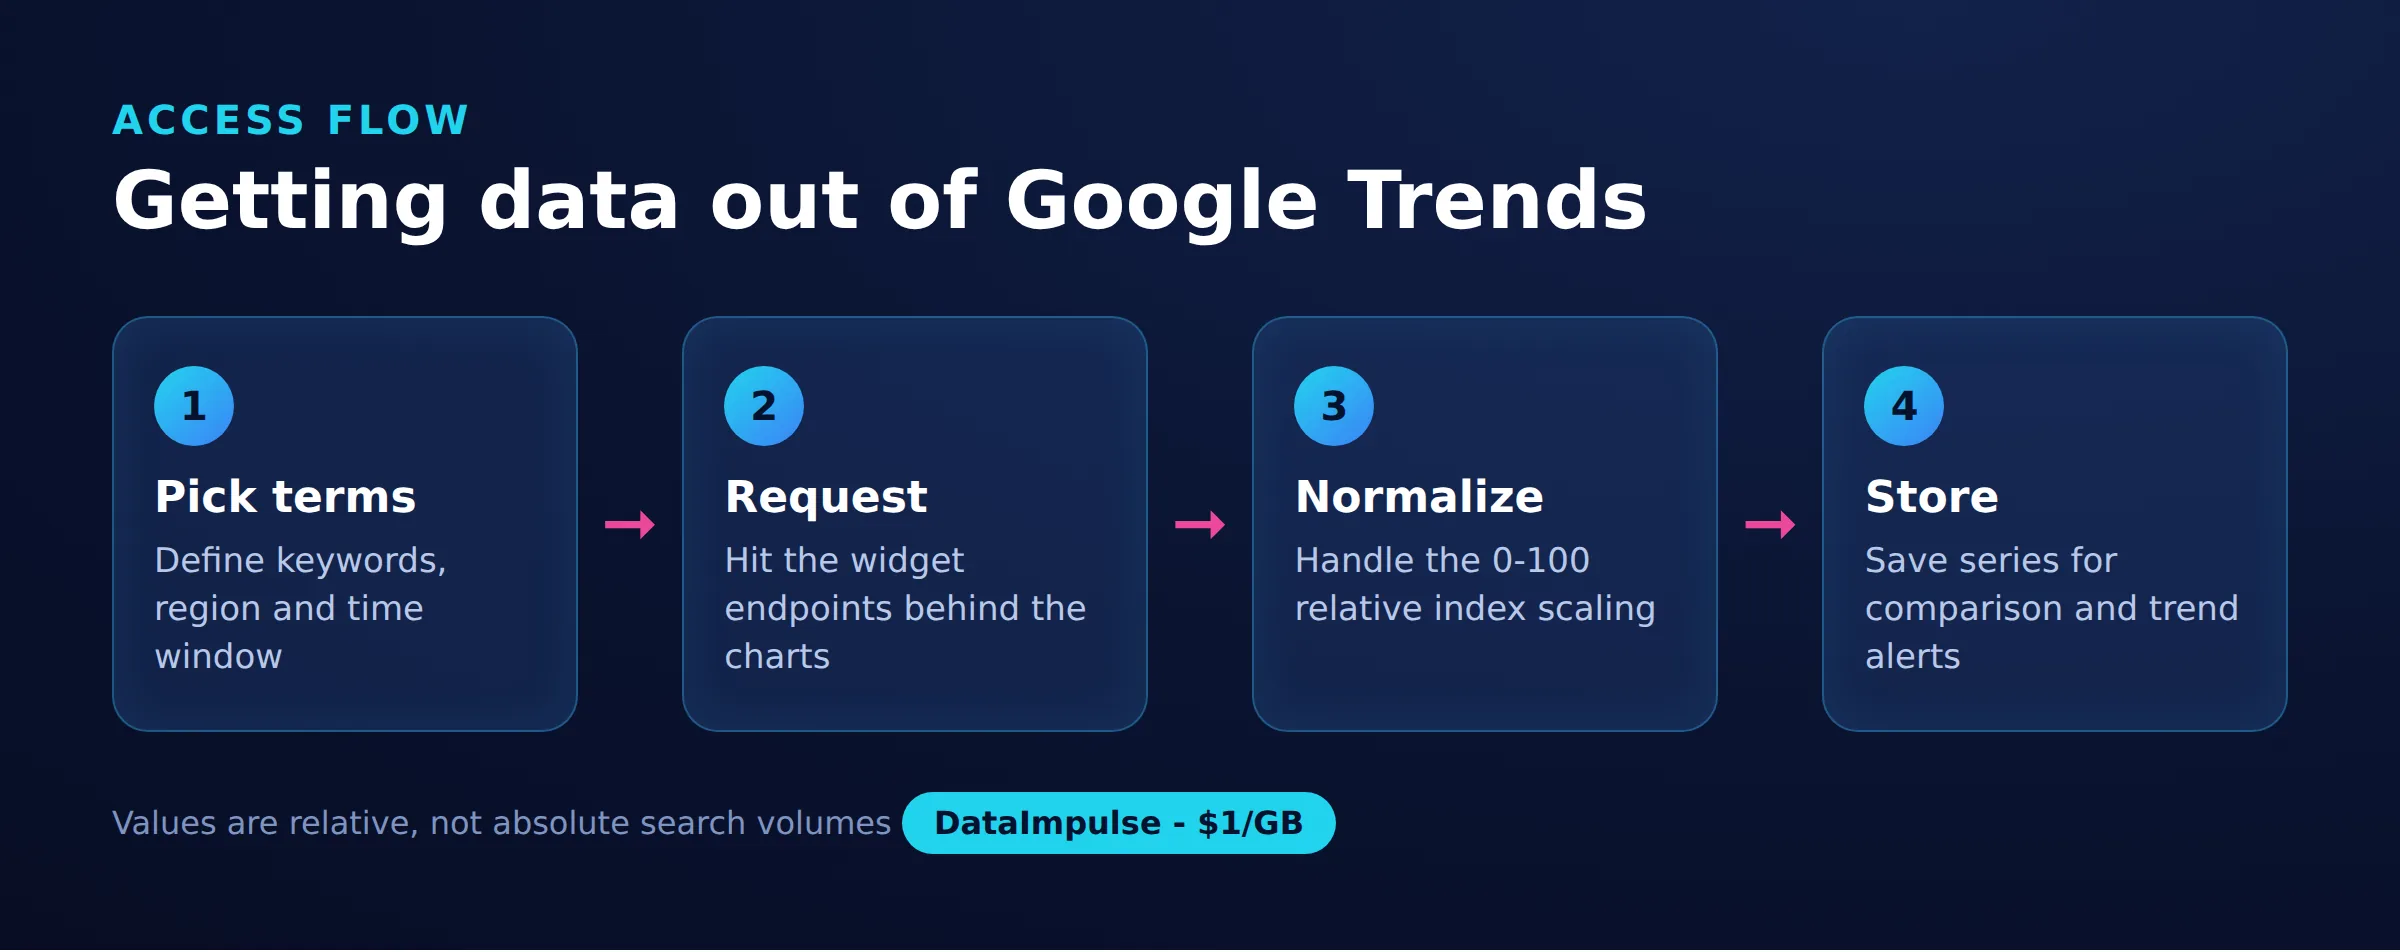
Si vous voulez savoir comment scraper Google Trends, la première chose à comprendre est ce que vous collectez réellement. Google Trends ne publie pas un volume de recherche absolu. Il renvoie un indice d’intérêt normalisé de 0 à 100, mis à l’échelle par rapport au pic correspondant à la requête, à la région et à la plage de dates que vous indiquez.
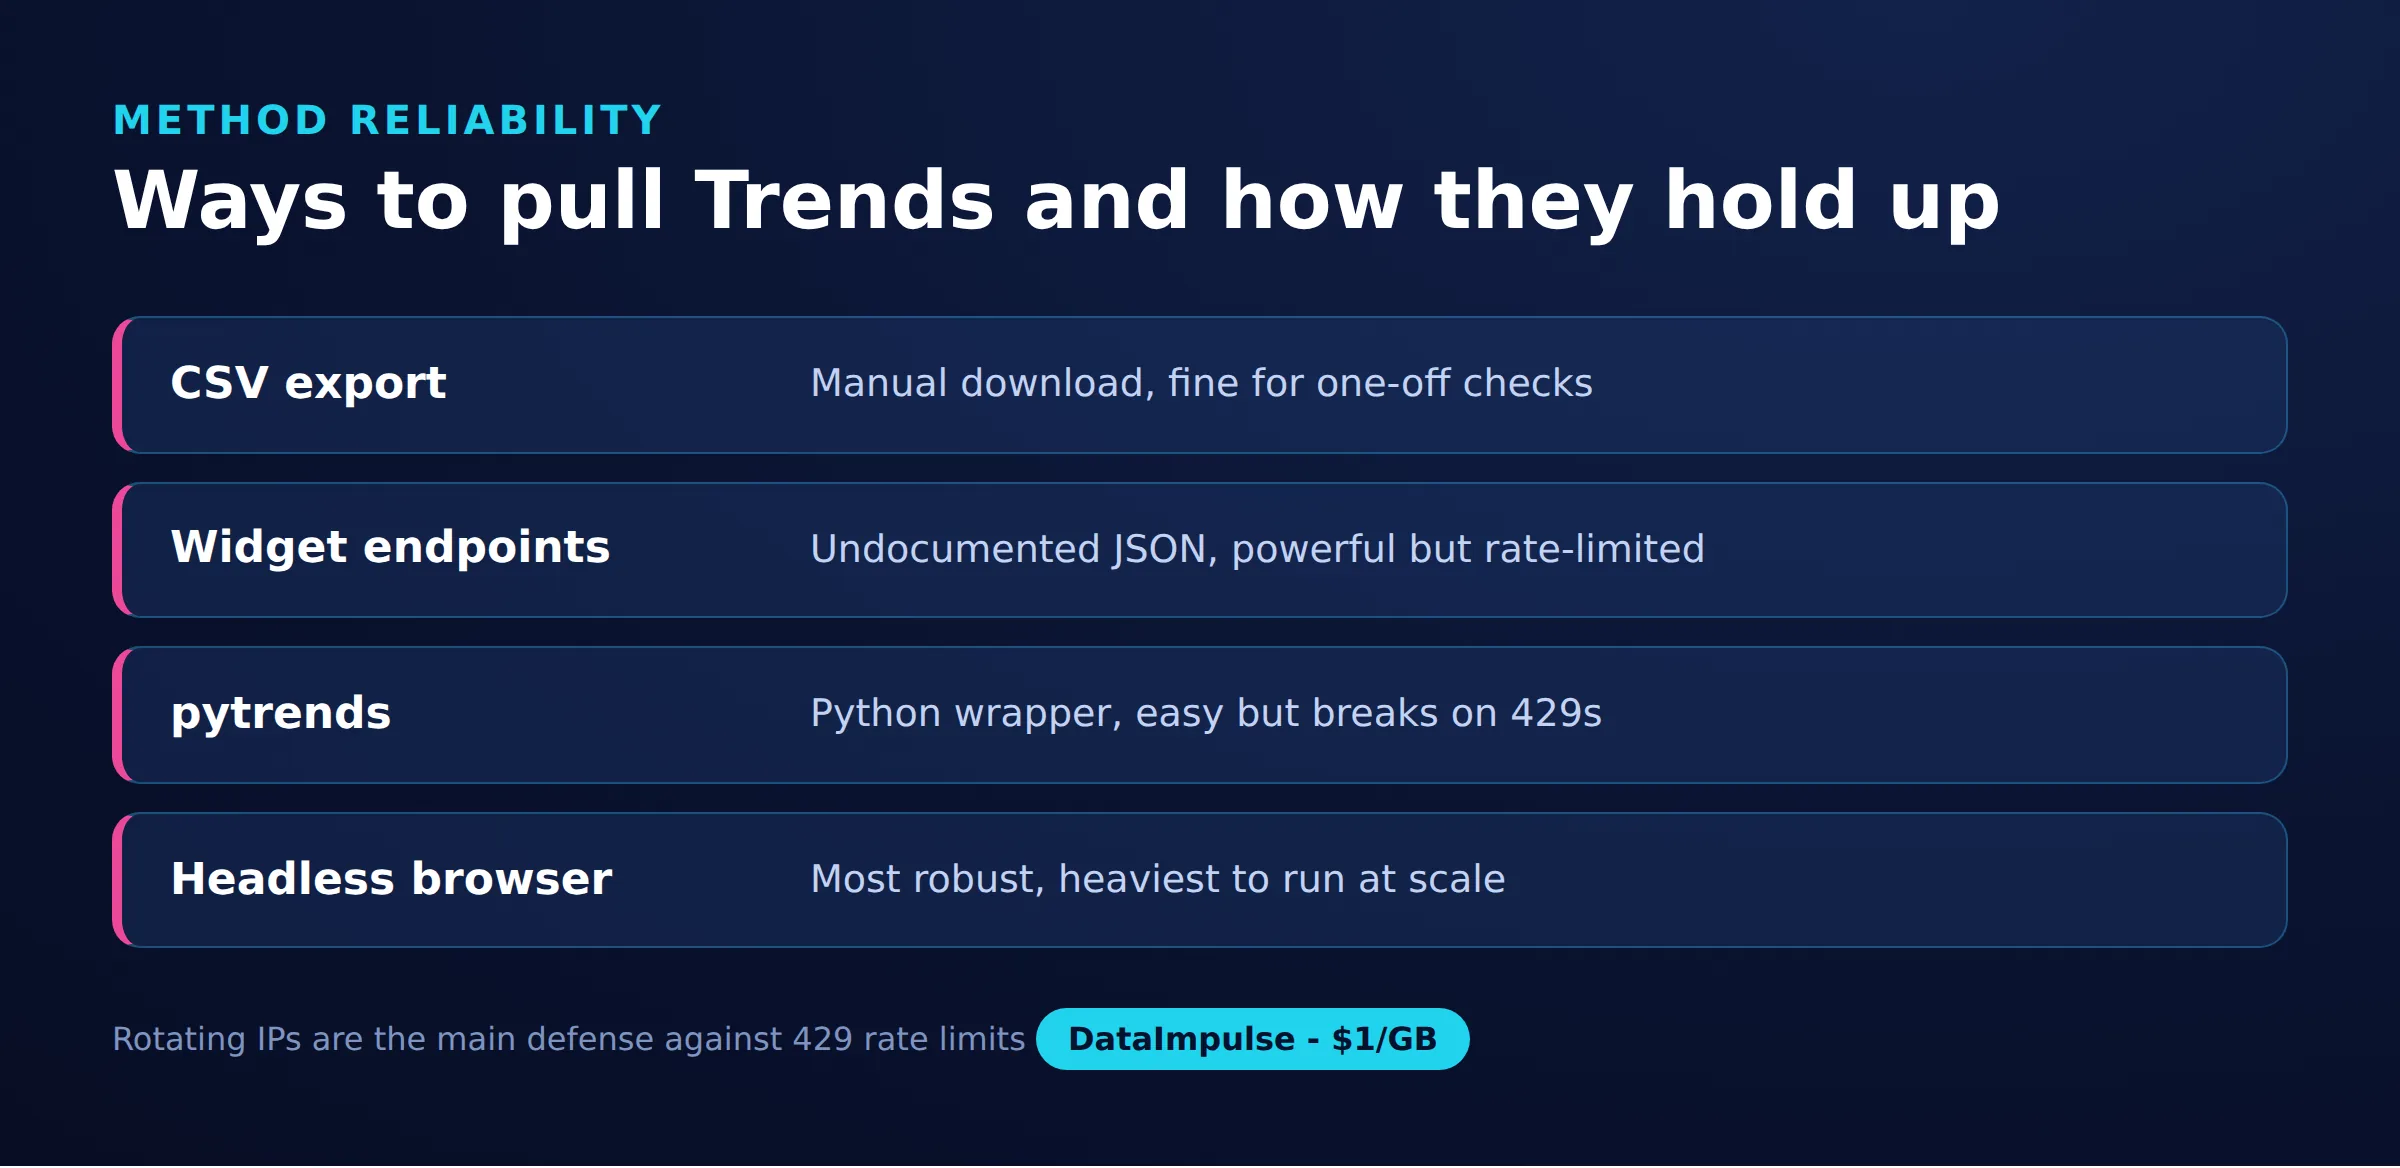
Cet article couvre les principales façons d’extraire ces données : l’export CSV intégré, les endpoints JSON non documentés des widgets, la bibliothèque Python pytrends et une solution de repli avec un navigateur headless. Il explique aussi pourquoi les proxies résidentiels rotatifs aident lorsque Google commence à renvoyer des erreurs 429, et où se situent les limites réalistes.
DataImpulse est un fournisseur éthique de proxies proposant plus de 90 millions d’adresses IP résidentielles, mobiles et datacenter dans 195 pays. Il utilise un modèle de paiement à l’usage à partir de 1 dollar par Go avec un trafic qui n’expire pas, et il est utilisé pour le web scraping, la vérification de publicités, la surveillance des prix, les études de marché et la gestion multi-comptes.
Faits clés
- Google Trends renvoie un indice relatif, pas des comptes bruts : chaque valeur est mise à l’échelle de 0 à 100 par rapport au pic de la requête, de la région et de la plage temporelle que vous choisissez. Les chiffres extraits servent donc à comparer, plutôt qu’à mesurer des volumes de recherche absolus.
- Meilleur type de proxy : des proxies résidentiels rotatifs, qui utilisent de vraies IP de particuliers et passent mieux les mécanismes de détection.
- Prix : à partir de 1 dollar par Go, paiement à l’usage, avec un trafic qui n’expire pas et sans abonnement.
- Couverture : plus de 90M d’IP d’origine éthique dans 195 pays.
- Fiabilité : 99,51 % de taux de réussite, noté 4,8 sur 5 sur G2.
- Protocoles et ciblage : HTTP, HTTPS et SOCKS5, avec le ciblage par pays inclus.
Quelles données Google Trends vous donne-t-il réellement ?
Google Trends fournit un indice d’intérêt relatif de 0 à 100, et non le nombre de recherches. Chaque point est normalisé pour que la valeur de pic de votre requête et de votre fenêtre temporelle soit égale à 100, et tous les autres points sont mis à l’échelle par rapport à elle.
Cela compte pour tout projet de scraping car vous ne pouvez pas comparer directement deux exports distincts comme s’ils étaient des comptes absolus. Un terme qui obtient 100 dans un pays et un autre qui obtient 100 dans un autre sont chacun à leur propre pic, pas au même volume réel. Pour comparer les termes équitablement, demandez-les ensemble dans la même requête afin que Google les normalise sur une seule échelle partagée. Les principales vues de données que vous pouvez extraire sont l’intérêt au fil du temps, l’intérêt par région, les requêtes associées et les sujets associés.
Comment exporter les données de Google Trends au format CSV ?
La méthode la plus simple est l’export CSV officiel intégré à l’interface de Google Trends. Sur n’importe quelle page de résultats de Trends, chaque widget dispose d’une icône de téléchargement qui enregistre cette vue sous forme de fichier CSV.
C’est l’option la plus fiable et la plus stable car elle utilise une fonctionnalité prise en charge, et elle suffit pour une recherche occasionnelle ou un petit ensemble de mots-clés. Les compromis sont qu’elle est manuelle, un widget et une requête à la fois, et qu’elle ne passe pas à l’échelle pour des centaines de termes. Si vous n’avez besoin que de quelques comparaisons pour la planification de contenu ou une vérification rapide du marché, l’export CSV évite totalement les problèmes de fiabilité liés au scraping automatisé.
Comment fonctionnent les endpoints JSON des widgets de Google Trends ?
Le site de Trends est alimenté par des endpoints JSON internes que le front-end appelle pour afficher chaque widget. Les utiliser directement pour le scraping est la solution programmatique la plus rapide, mais ils ne sont pas documentés et peuvent changer sans préavis.
Le flux comporte deux étapes. Vous appelez d’abord un endpoint explore avec votre mot-clé, votre région et votre plage temporelle, ce qui renvoie un ensemble de tokens de widget. Ensuite, vous passez chaque token à l’endpoint de données correspondant, comme celui de l’intérêt au fil du temps, pour recevoir la série réelle en JSON. Deux particularités pratiques sont souvent surprenantes :
- Les réponses sont préfixées par des caractères anti-JSON que vous devez retirer avant le parsing.
- Les tokens ont une durée de vie courte, vous ne pouvez donc pas les mettre en cache longtemps ni les réutiliser d’une session à l’autre.
Comme ces endpoints ne sont pas officiels, considérez que tout scraper reposant sur eux nécessitera une maintenance lorsque Google ajustera le format de réponse.
Devriez-vous utiliser pytrends pour scraper Google Trends ?
pytrends est une bibliothèque Python non officielle populaire qui encapsule les endpoints de widgets décrits ci-dessus, et c’est le moyen le plus rapide de démarrer. Elle est vraiment utile, mais vous devriez l’utiliser avec des attentes claires.
Soyons honnêtes à propos de pytrends : ce n’est pas un produit officiel de Google, elle peut cesser de fonctionner lorsque Google modifie les endpoints et son débit est fortement limité : elle renvoie des erreurs 429 dès que vous envoyez un nombre un peu trop élevé de requêtes sur une courte période. Elle convient mieux aux travaux de recherche qu’à une collecte continue à grand volume. Une extraction basique de l’intérêt au fil du temps, avec une liste de proxies fournie pour répartir les requêtes entre les IP, ressemble à ceci :
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
La rotation entre plusieurs proxies évite qu’une seule IP ne déclenche les limites imposées par Google à chaque adresse, et les réglages de retry et de backoff atténuent les échecs transitoires.
Pourquoi les proxies résidentiels rotatifs aident-ils avec les erreurs 429 ?
Les proxies résidentiels rotatifs sont utiles parce que Google limite les requêtes Trends par adresse IP. Une fois une adresse signalée, elle continuera à recevoir des réponses 429 Too Many Requests. Répartir les requêtes entre de nombreuses IP résidentielles, combiné à un backoff exponentiel, maintient chaque adresse sous le seuil.
Les IP résidentielles proviennent d’appareils réels appartenant à des particuliers. Elles se fondent donc bien mieux dans le trafic ordinaire que les plages datacenter, que Google reconnaît et limite plus agressivement. La rotation signifie que chaque requête ou petit lot part d’une adresse différente, ce qui évite qu’une IP n’accumule un volume suffisant pour être bloquée. Les proxies résidentiels sont le choix pratique ici pour cette raison, même si les proxies datacenter peuvent encore convenir aux travaux légers et peu fréquents lorsque le coût importe davantage que la discrétion. DataImpulse fournit des sessions rotatives et fixes sur plus de 90M d’IP dans 195 pays, avec le ciblage par pays inclus, ce qui vous permet aussi de collecter des données Trends spécifiques à une région depuis une IP située dans cette région.
La rotation seule ne suffit pas ; vous devez aussi ralentir délibérément. La méthode consiste à détecter un 429, à attendre un délai qui double à chaque tentative, puis à abandonner après un nombre fixe d’essais pour éviter qu’une cible défaillante ne boucle indéfiniment :
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
Combinez ce backoff avec la rotation des proxies et une pause aléatoire entre les appels réussis. Les mêmes principes anti-blocage s’appliquent à tout gros travail de collecte, comme expliqué dans ce guide sur le scraping sans se faire bloquer.
Quand devriez-vous utiliser un navigateur headless plutôt ?
Utilisez un navigateur headless lorsque les endpoints JSON cessent de fonctionner ou renvoient des défis qu’un simple client HTTP ne peut pas résoudre. Des outils comme Playwright ou Selenium chargent la vraie page Trends, exécutent son JavaScript et vous permettent de lire les données de widget affichées ou d’intercepter les appels réseau que la page effectue.
Cette approche est plus lourde et plus lente car elle exécute un navigateur complet par session, mais elle résiste mieux aux changements du front end et peut passer certaines vérifications interactives qui cassent les scrapers simples basés sur des requêtes. Faites passer le navigateur par un proxy, idéalement des proxies mobiles ou des IP résidentielles, pour que la session automatisée ressemble toujours à un visiteur normal. Gardez à l’esprit qu’un navigateur headless ne supprime pas les limites de débit sous-jacentes ; vous devez toujours cadencer les requêtes et alterner les IP, simplement avec plus de surcharge par requête que la méthode d’endpoint direct.
À quelles fins pouvez-vous utiliser les données extraites de Google Trends ?
Les données extraites de Google Trends sont surtout utiles pour repérer des tendances relatives et la saisonnalité, plutôt que des volumes exacts. Comme les chiffres sont un indice normalisé, considérez-les comme des signaux indiquant une hausse ou une baisse de l’intérêt, et non comme des prévisions de trafic.
Les cas d’usage courants incluent :
- SEO et planification de contenu : comparez des termes associés sur une même échelle pour décider quel sujet prioriser et quand l’intérêt atteint son pic dans l’année.
- Demande produit : suivez si l’intérêt pour une catégorie ou une fonctionnalité augmente ou décline avant d’engager des ressources.
- Calendrier de mise sur le marché : utilisez les tendances saisonnières et les différences régionales pour planifier les campagnes ou les lancements lorsque l’attention est à son maximum.
La principale limite est que Trends seul ne permet pas de connaître la demande absolue ni la valeur de conversion ; associez-le à des outils de volume de recherche, des données de ventes ou des chiffres de plateformes publicitaires pour transformer le signal relatif en décision.
Comparaison des méthodes d’accès
| Méthode | Fiabilité | Effort requis et limites |
|---|---|---|
| Export CSV | Élevée | Manuel, requête unique |
| Endpoints de widgets | Moyenne | Non documentés, peuvent changer |
| pytrends | Moyenne | Facile, débit limité |
| Navigateur headless | Élevée | Plus lourd, nécessite des proxies |
Foire aux questions
Le scraping de Google Trends est-il légal ?
Le scraping de données visibles publiquement est généralement autorisé dans de nombreuses juridictions, mais l’accès automatisé peut entrer en conflit avec les conditions d’utilisation de Google. Vérifiez les conditions et la législation locale applicable, et privilégiez l’export CSV officiel ou un jeu de données pris en charge lorsque c’est possible.
Google Trends montre-t-il le volume de recherche réel ?
Non. Il montre un indice d’intérêt relatif de 0 à 100, normalisé par rapport au pic de la requête, de la région et de la plage temporelle que vous choisissez. Pour estimer le volume absolu, vous avez besoin d’un outil de mots-clés distinct.
Pourquoi pytrends continue-t-il de renvoyer des erreurs 429 ?
429 signifie que Google limite le débit de votre IP parce que vous effectuez trop de requêtes trop rapidement. Ajoutez des délais avec un backoff exponentiel, réduisez la fréquence des requêtes et alternez entre plusieurs proxies pour qu’aucune IP ne dépasse la limite.
Ai-je besoin de proxies pour scraper Google Trends ?
Pour quelques requêtes manuelles, non. Pour des travaux automatisés ou plus importants, les proxies résidentiels rotatifs vous aident à éviter les limites de débit par IP et à collecter des données spécifiques à une région depuis une IP située dans le pays cible.
pytrends est-il une bibliothèque officielle de Google ?
Non. pytrends est une bibliothèque communautaire non officielle qui encapsule les endpoints internes de Google. Elle fonctionne bien pour la recherche, mais elle peut cesser de fonctionner lorsque Google modifie ces endpoints, elle nécessite donc une maintenance occasionnelle.
Quand DataImpulse n’est-il pas le bon choix ?
Si vous avez besoin de proxies ISP statiques, d’une API de scraping entièrement gérée ou d’un accès à des sites bancaires et gouvernementaux, DataImpulse n’est pas le bon outil. Il se concentre sur les proxies résidentiels, mobiles et datacenter rotatifs pour collecter des données publiques et accéder à du contenu.
Collectez les données de Google Trends à grande échelle
Pour un scraping de Trends à grande échelle, les IP résidentielles rotatives maintiennent chaque requête sous les limites imposées par Google à chaque adresse. DataImpulse propose des proxies résidentiels, mobiles et datacenter en paiement à l’usage à partir de 1 dollar par Go avec le ciblage par pays inclus. Créez un compte DataImpulse pour commencer.