
In questo articolo
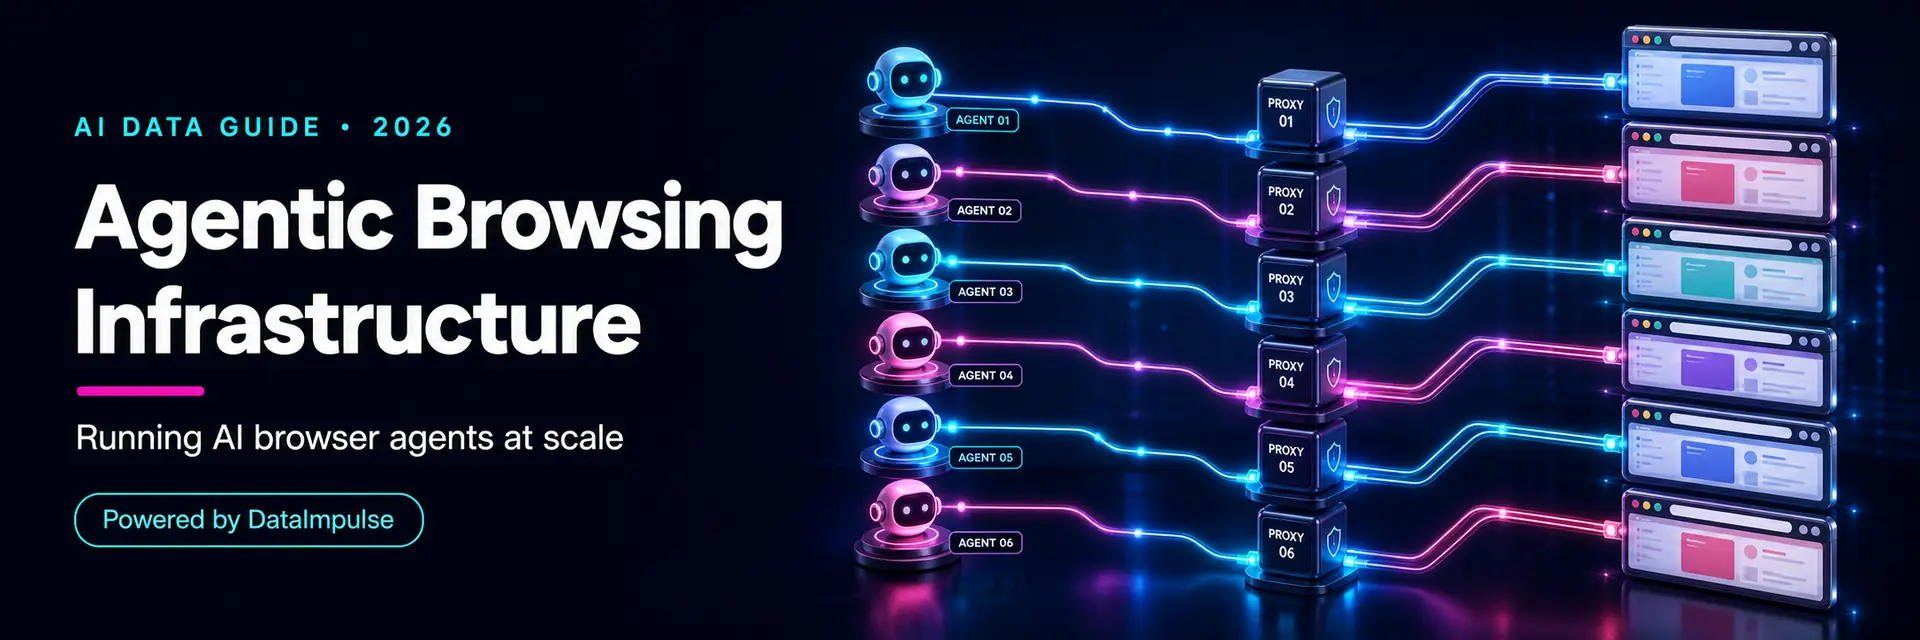
L’infrastruttura di navigazione agentica è lo stack che consente agli agenti AI di navigare e agire sul web su larga scala: non un singolo assistente che apre una pagina, ma flotte di agenti che navigano, leggono e completano attività sul web live in modo affidabile. Con il passaggio dell’AI dalle risposte all’azione, “un agente che può usare un browser” diventa “un sistema che esegue molti agenti browser senza venire bloccato”. Questa guida definisce l’infrastruttura di navigazione agentica, ne analizza i livelli e spiega perché il livello di accesso, cioè i proxy con identità per agente, è fondamentale.
Sono Andrii Byzov, Fractional CMO AI-Native e creo sistemi di agenti e dati web. Qui trovi una definizione semplice, le differenze rispetto alla navigazione tradizionale, i componenti, il problema dei blocchi su scala di flotta e il ruolo dei proxy. Fa parte di infrastruttura di dati web per l’AI.
Punti chiave
- Infrastruttura di navigazione agentica = lo stack per eseguire agenti browser AI su larga scala: orchestrazione, automazione del browser, accesso e gestione delle sessioni.
- È un problema di flotta, non di un singolo browser. Molti agenti, molte attività, molti mercati, contemporaneamente.
- Il blocco è il vincolo principale. Gli agenti che recuperano dati e agiscono ripetutamente da un solo IP ricevono rapidamente limiti di frequenza e segnalazioni.
- L’identità per agente è importante. Ogni agente deve sembrare un utente reale distinto, non un solo IP che effettua migliaia di richieste.
- I residential proxy con identità per sessione sono il livello di accesso: mantengono una flotta raggiungibile e distinta.
Che cos’è l’infrastruttura di navigazione agentica?
È tutto ciò che serve per eseguire in modo affidabile e su larga scala agenti AI che navigano e agiscono sul web. Un singolo AI browser è un prodotto; l’infrastruttura di navigazione agentica permette a un team di eseguire molti agenti per ricerca, monitoraggio, acquisti, test e automazione, senza che ciascuno incontri blocchi, barriere geografiche o sistemi di rilevamento. Si colloca sotto la logica dell’agente, ovvero il modello che decide cosa fare, e sopra il web grezzo, trasformando “un agente potrebbe aprire questa pagina” in “una flotta di agenti può farlo migliaia di volte in mercati diversi”.
Differenze rispetto alla navigazione tradizionale
- Scala. Una persona naviga in sequenza; una flotta di agenti naviga in parallelo, costantemente.
- Pressione del rilevamento. I siti tollerano un essere umano, ma si difendono attivamente da molte sessioni automatizzate provenienti dalla stessa fonte.
- Identità. Ogni agente deve sembrare un utente separato; gli IP condivisi fanno sembrare una flotta un unico bot.
- Geografia. Gli agenti devono spesso agire da mercati specifici, quindi la posizione fa parte dell’infrastruttura.
I componenti
Orchestrazione. Pianificazione e coordinamento di molti agenti, tentativi ripetuti e code di attività.
Automazione del browser. I browser headless o il framework di automazione che gli agenti usano per navigare e agire (vedi esecuzione di agenti browser AI).
Livello di accesso. Raggiungere le pagine dal luogo giusto senza essere bloccati: i proxy. Di solito è il vincolo determinante su larga scala.
Sessione e identità. Mantenere ogni agente come un utente distinto e coerente, con la propria sessione IP, così che il comportamento resti coerente e separabile.
Il problema dei blocchi su scala di flotta
Ciò che manda in crisi le flotte di agenti ingenue non è il modello, ma il fatto di venire bloccate. Eseguendo dieci o mille agenti da un solo intervallo IP, i siti target vedono un’ondata di traffico automatizzato da una sola fonte: limiti di frequenza, CAPTCHA, barriere anti-bot e divieti arrivano rapidamente. Ne derivano due esigenze: identità distinta (ogni agente sembra il proprio utente) e accesso geograficamente corretto (gli agenti agiscono dai mercati necessari). Affrontarle riduce il collo di bottiglia a livello di IP, anche se fingerprinting, CAPTCHA, autenticazione e limiti di frequenza possono ancora fermare singole attività; ignorarli fa sì che la flotta finisca prima nei blocchi.
# Give each agent in the fleet its own proxy session so it looks like a
# distinct real user (the ;sid keeps an agent on the same exit IP for the
# session; the exit can change if that residential peer drops).
def proxy_for_agent(agent_id, country="us"):
return (f"http://LOGIN__cr.{country};sid.agent{agent_id}:"
f"[email protected]:823")
# e.g. launch each browser-automation worker with its own session
for agent_id in range(10):
proxy = proxy_for_agent(agent_id)
# browser.launch(proxy=proxy) -> each agent = a separate apparent user
Dove si collocano i proxy
I livelli di accesso e identità sono quelli in cui operano i proxy e, su scala di flotta, sono fondamentali. I residential proxy instradano ogni agente tramite un IP reale di un utente, e un’identità per sessione (un sid) mantiene ogni agente sul proprio IP di uscita per la sessione, così da sembrare un utente distinto e coerente anziché parte di uno sciame (l’uscita può cambiare se quel peer residential si disconnette). I pool residential a rotazione con alta concorrenza permettono a molti agenti di operare in parallelo dai mercati giusti: residential DataImpulse da $1/GB (mobile da $2/GB) in 195+ località, con alta concorrenza per le flotte. I proxy gestiscono accesso e identità; la tua orchestrazione gestisce gli agenti. Non sconfiggono ogni difesa: i siti usano ancora CAPTCHA e rilevamento comportamentale, ma rimuovono il collo di bottiglia a livello di IP che blocca per primo le flotte.
È legale eseguire la navigazione agentica su larga scala?
L’esecuzione di agenti browser segue le stesse regole di qualsiasi accesso web automatizzato e la scala può aumentare la rilevanza di aspetti legali, di privacy, contrattuali e anti-elusione anche quando il modello di accesso sembra simile. Mantieni un approccio giustificabile: rispetta i termini di ogni sito e considera robots.txt un segnale di policy, non aggirare accessi, paywall o controlli di accesso, dosa le richieste invece di bombardare i siti e limita l’attività a dati pubblici e non personali. L’uso di proxy per l’automazione consentita è generalmente lecito, ma usarli per aggirare divieti, controlli di accesso o limiti contrattuali crea rischi legali e per l’account. La strada lecita è l’automazione reale di attività pubbliche, non l’elusione. Vedi se il web scraping è legale. Queste sono informazioni generali, non consulenza legale.
Domande frequenti
Che cos’è l’infrastruttura di navigazione agentica?
È lo stack che consente agli agenti AI di navigare e agire sul web su larga scala: orchestrazione, automazione del browser, un livello di accesso (proxy) e gestione di sessioni e identità. Si colloca sotto la logica decisionale dell’agente e sopra il web grezzo, trasformando “un agente potrebbe aprire una pagina” in “una flotta di agenti può farlo in modo affidabile in mercati diversi”.
In cosa differisce da un singolo AI browser?
Un singolo AI browser è un prodotto usato da una persona; l’infrastruttura di navigazione agentica esegue molti agenti in parallelo. Questo comporta problemi specifici delle flotte, come pressione del rilevamento, identità per agente e geografia, che un singolo browser non affronta mai. La parte difficile è mantenere una flotta raggiungibile e distinta, non guidare un solo browser.
Perché le flotte di agenti vengono bloccate?
Perché molte sessioni automatizzate da un solo intervallo IP sembrano un unico bot. I siti tollerano un essere umano ma si difendono attivamente da ondate di traffico automatizzato dalla stessa fonte con limiti di frequenza, CAPTCHA e divieti. Senza un’identità distinta per agente e un accesso geograficamente corretto, una flotta attiva rapidamente queste difese.
Dove si collocano i proxy nella navigazione agentica?
Sono il livello di accesso e identità. I residential proxy instradano ogni agente tramite un IP reale di un utente e un’identità per sessione mantiene ogni agente sul proprio IP di uscita, così da sembrare un utente distinto. I pool a rotazione con alta concorrenza permettono a molti agenti di operare in parallelo dai mercati giusti, rimuovendo il collo di bottiglia a livello di IP che blocca per primo le flotte.
È legale eseguire agenti browser su larga scala?
Segue le stesse regole di qualsiasi accesso web automatizzato. Rispetta i termini del sito e robots.txt, non aggirare accessi o controlli di accesso, dosa le richieste e limita l’attività a dati pubblici e non personali. L’uso di proxy per l’automazione consentita è generalmente lecito; usarli per aggirare divieti o controlli di accesso crea rischi legali e per l’account. Non è consulenza legale.
Conclusione
L’infrastruttura di navigazione agentica trasforma “un agente che può usare un browser” in una flotta che funziona davvero e il suo vincolo determinante è l’accesso, non l’intelligenza. Molti agenti che agiscono in parallelo vengono bloccati, a meno che ognuno sembri un utente distinto del mercato giusto: questo è il livello di proxy e identità. Crea la tua orchestrazione e la logica degli agenti; noleggia un livello di accesso residential proxy con identità per sessione e alta concorrenza. Esplora i vari elementi: esecuzione di agenti browser AI, proxy per OpenAI Operator e infrastruttura di dati web per l’AI.
Ultimo aggiornamento: 28 giugno 2026.