
In this Article
يخلط المستخدمون كثيراً بين مفهومي الزحف على الويب وتجريف الويب. يركز أحدهما على اكتشاف المحتوى وفهرسته، بينما يستخرج الآخر بيانات محددة لتحليلها. ولكن لماذا من المهم فهم الفروق بينهما؟ عندما تعمل في مجالات مثل أبحاث السوق وSEO وتحليل البيانات أو ذكاء الأعمال، فإن معرفة الفرق تؤثر مباشرة في دقة نتائجك النهائية.
لنتعرف إلى متى تستخدم الزحف على الويب ومتى تلجأ إلى تجريف الويب.
حقائق أساسية
- يرتبط الزحف على الويب وتجريف الويب ببعضهما عموماً.
- الزحف:ينشئ فهارس أو مجموعات عبر استكشاف أعداد كبيرة من الصفحات أو المستندات. يعمل تلقائياً باستخدام وكيل زحف، ويتبع الروابط لاكتشاف المحتوى.
- التجريف:يستخرج بيانات عامة متاحة ومحددة للتحليل ويحفظها محلياً بصيغ مثل CSV وExcel وSQL وغيرها. يمكن تنفيذه بواسطة أدوات تجريف Python أو WebScraper API أو يدوياً. ويتطلب اتصالاً بالإنترنت.
- تُستخدم العمليتان معاً كثيراً في جمع البيانات.
- تدمج الشركات البروكسيات واستراتيجيات الأتمتة لتوزيع الطلبات وتجنب الحظر.
- تذكر دائماً احترام شروط خدمة موقع الويب واستخدامالبروكسياتلضمان حضور رقمي آمن وعمليات سريعة وبيانات محمية.
ما هو الزحف على الويب؟
يعني الزحف بمفرده التحرك في منطقة خطوة بخطوة لاستكشاف ما فيها. وعندما يتعلق الأمر بالزحف على الويب، فهو استكشاف الإنترنت بالطريقة نفسها. يزور زاحف الويب، الذي يسمى أيضاً عنكبوتاً أو بوتاً، مواقع الويب تلقائياً ويقرأ صفحاتها ويجمع البيانات للمساعدة في إنشاء إدخالات لفهرس محرك البحث.
كيف يعمل الزحف على الويب
تتجاوز العملية مجرد فحص صفحة واحدة. يحلل الزاحفون محتوى الصفحة ثم يتبعون روابطها لاكتشاف صفحات أكثر، ويواصلون هذه الدورة لإجراء استكشاف عميق ومنظم للويب. وهكذا تستطيع محركات البحث مثل Google وYahoo وBing رسم خريطة لكميات هائلة من المحتوى على الإنترنت وفهرستها.

لإجراء الزحف على الويب، تحتاج إلى أدوات وأطر عمل متخصصة. ومن الأمثلة الشائعة Scrapy وApache Nutch، وكلاهما واسع الاستخدام في مهام جمع البيانات وفهرستها على نطاق واسع.
ما البيانات التي يجمعها الزاحفون
لا يقتصر الأمر على النص. يلتقط الزاحفون العناصر الأساسية لأي صفحة، ومنها URL والشفرة والرؤوس. ثم تأتي المكونات البنيوية مثل عناوين الصفحات والوصف والوسوم والروابط الداخلية والخارجية وغيرها. ويلتقط الزاحفون أيضاً إشارات تقنية لا يراها المستخدم لكنها مهمة للتحليل، مثل مراجع خريطة الموقع ووسوم hreflang للمواقع متعددة اللغات ووقت تحميل الصفحة وما إلى ذلك.
توجد أيضاً بيانات علاقات تتعلق بالوصلات بين الصفحات. يصبح كل رابط عقدة في خريطة ويب تستخدم لتقييم الصلة والموثوقية عبر إشارات الروابط الخلفية.
حالات الاستخدام الشائعة للزحف على الويب
فهرسة محركات البحث هي حالة الاستخدام الأساسية للزحف على الويب. تزحف البوتات أو العناكب في الويب لاكتشاف صفحات جديدة وتحديث الصفحات القائمة وبناء فهارس سهلة البحث. ويعد الزاحف كذلك ركناً أساسياً في كثير من أدوات التدقيق التي تفحص المواقع لاكتشاف الروابط المعطلة أو المحتوى المكرر. تستخدم منصات التجارة الإلكترونية الزحف لمراقبة منتجات الشركات الأخرى. وتستخرج أدوات توليد العملاء المحتملين جهات الاتصال من الأدلة والملفات العامة. كما تمد عمليات الزحف واسعة النطاق نماذج AI ببيانات التدريب. ويستخدم الزحف على نطاق واسع أيضاً في مجال الأمن السيبراني لأنه يستطيع الإبلاغ عن الأصول المكشوفة أو بيانات الاعتماد المسربة.
ما هو تجريف الويب؟
يعني التجريف جمع شيء أو سحبه من سطح ما. وفي السياق الرقمي، يعني تجريف الويب جمع المعلومات من مواقع الويب تلقائياً وحفظها بتنسيق منظم، مثل قواعد بيانات XML أو Excel أو SQL. وتسمى الأدوات التي تنفذ هذه المهمة أدوات تجريف الويب. وبحسب المتطلبات، يمكن لأداة التجريف جمع البيانات من أي موقع ويب تقريباً خلال ثوان، مؤتمتةً ما كان سيستغرق ساعات من العمل اليدوي.
كيف يعمل تجريف الويب
أولاً، على أداة التجريف إرسال طلب إلى URL مستهدف. بعد ذلك يستجيب الخادم بـ HTML الصفحة. ثم تحلل الأداة المحتوى وتستخرج البيانات المطلوبة وتخزنها بتنسيق منظم، مثل قاعدة بيانات أو ملف.

ما البيانات المستخرجة
تستخرج أدوات التجريف أجزاء محددة من بيانات الويب. ومن أكثر الأمثلة شيوعاً:
- بيانات المنتجات
- معلومات الاتصال
- البيانات الوصفية
- إعلانات العقارات وسوق الوظائف
- بيانات منظمة موجودة بالفعل في الصفحة
حالات الاستخدام الشائعة لتجريف الويب
يمكن لفرق كثيرة مراقبة الأسعار والمنتجات أو العروض الترويجية في مواقع المنافسين بفضل تجريف الويب. ويعرف ذلك بالذكاء التنافسي. ويستخدم أيضاً في أبحاث السوق،تتبع SERPوتوليد العملاء المحتملين،مقارنة الأسعارومجالات التوظيف، وقد أصبح التجريف جزءاً أساسياً من المهام الاعتيادية. تستطيع أدوات التجريف جمع الأخبار المالية والتحقق من الاتجاهات واختبار الأداء عبر المناطق وتجميع البيانات لنماذج AI. والهدف في كل حالة هو استخراج بيانات منظمة يمكن للأنظمة اللاحقة استخدامها فعلاً.
الفروق الأساسية بين الزحف والتجريف
في الواقع، يكمل الزحف على الويب وتجريف الويب أحدهما الآخر في عملية جمع البيانات. يركز الزحف على الويب على الاكتشاف والفهرسة. يتنقل الزاحفون في مواقع الويب تلقائياً، متبعين الروابط من صفحة إلى أخرى، ويجمعون البيانات الوصفية والمحتوى الذي تستطيع محركات البحث أو منصات التحليلات تنظيمه. وهو مصمم للشمول، إذ يفحص صفحات كثيرة لفهم بنية موقع أو الويب الأوسع ومحتواه.
أما تجريف الويب فيستهدف معلومات محددة مثل أسعار المنتجات أو تفاصيل الاتصال أو المراجعات ويحفظها بتنسيقات منظمة للتحليل. إنه يتعلق بالعمق، أي استرجاع البيانات التي تحتاجها بالضبط.
| الزحف على الويب |
تجريف الويب |
الغرض |
|
فهرسة وجمع كميات كبيرة من البيانات من المستندات أو الملفات |
تنزيل واستخراج بيانات محددة للتحليل |
العملية |
|
يتنقل تلقائياً عبر الروابط والصفحات باستخدام وكيل زحف |
يسترجع وينزل البيانات المستهدفة إلى ملفات محلية مثل CSV وExcel وSQL وغيرها |
النطاق |
|
واسع، يغطي أعداداً ضخمة من الصفحات أو المواقع |
ضيق، يستخرج نقاط بيانات دقيقة |
الأتمتة |
|
مؤتمت بالكامل |
مؤتمت أو يدوي |
التعقيد |
|
أقل، يحتاج إلى وكيل زحف |
أعلى، يتطلب اتصالاً بالإنترنت ووكيل زحف ومحللاً |
الأدوات |
|
Scrapy وApache Nutch وHeritrix ونصوص Python برمجية مخصصة |
BeautifulSoup وlxml وPlaywright وPuppeteer وSelenium وWebScraper API |
ما هو الزحف على الويب؟ |
كيف يعمل الزحف والتجريف معاً
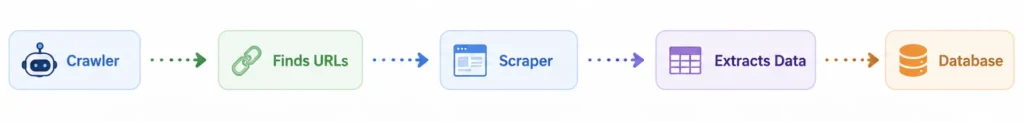
ينشئ الزحف والتجريف مسار عمل من مرحلتين. إنهما خطوتان في العملية نفسها. يعثر الزحف على الصفحات، ويستخرج التجريف بيانات الويب منها. وفي المشاريع الفعلية، يعملان ضمن حلقة متكررة.
مسار العمل المعتاد
يبدأ الزاحف من صفحة أساسية ويتبع الروابط لبناء قائمة بعناوين URL ذات الصلة. تُمرر القائمة إلى أداة التجريف التي تزور كل صفحة وتركز على البيانات المطلوبة. وأخيراً، تُخزن النتائج في قاعدة بيانات أو أداة تحليلات.
مثال من الواقع
لنفترض نظاماً لتتبع الأسعار. يفحص زاحف موقع تجارة إلكترونية كل أسبوع ويجمع جميع صفحات المنتجات. بعد ذلك، تعالج أداة التجريف عناوين URL يومياً وتجمع تفاصيل مثل الأسعار الحالية وحالة المخزون ومراجعات العملاء. وتوجد القيم النهائية في قاعدة بيانات التسعير التي تغذي لوحة المعلومات التي يستخدمها فريق التسعير. وتستمر العملية بانتظام.
متى تستخدم الزحف بدلاً من التجريف
ما الفرق إذن بين تجريف الويب والزحف على الويب؟ يتعلق الزحف بالعثور على الصفحات، بينما يتعلق التجريف باستخراج البيانات من صفحات اكتشفتها بالفعل. يرسم الزحف خريطة لعناوين URL ويستخرج التجريف منها معلومات محددة. تدمج معظم الشركات العمليتين في مراحل مختلفة.
متى تستخدم الزحف على الويب
يفيد زحف البيانات عندما لا تكون لديك قائمة بعناوين URL بعد وتحتاج إلى استكشاف بنية الموقع. وعادة ما تلجأ الفرق التي تنفذ عمليات تدقيق SEO منتظمة أو فهرسة المواقع أو مراقبة الصفحات الجديدة أو إنشاء URL إلى الزحف.
متى تستخدم تجريف الويب
استخدم التجريف عندما تكون الصفحات المستهدفة معروفة بالفعل وتحتاج إلى بيانات محددة مثل الأسعار أو المراجعات. وهو مثالي لتغذية لوحات المعلومات أو قواعد البيانات أو أدوات التحليلات بمعلومات منظمة.
متى تحتاج إليهما معاً
يأتي الزحف عادة أولاً لاكتشاف الصفحات، ثم يليه التجريف لاستخراج البيانات. وغالباً ما تتكرر العملية للحفاظ على تحديث عناوين URL والبيانات. ولمحترفي التعامل مع البيانات على نطاق واسع، يفيد فهم هذه الفروق:
- يساعد الزحف في رسم خريطة الويب أو العثور على كل المصادر ذات الصلة.
- يتيح لك التجريف جمع بيانات قابلة للاستخدام من تلك المصادر.
- يوفران معاً مسار عمل يضمن مجموعات بيانات شاملة وعالية الجودة.
تحديات الزحف والتجريف
قد تنشأ المشكلات المحتملة في أي مرحلة من عملية الزحف أو التجريف. ومن المهم تحديدها بدقة وإيجاد الحلول المناسبة.
حظر IP وحدود المعدل
تحد مواقع ويب كثيرة عدد الطلبات التي يمكن أن يجريها عنوان IP واحد خلال وقت قصير. وبمجرد تجاوز الحد، تتباطأ الاستجابات وتبدأ أخطاء CAPTCHA أو 403 بالظهور. فعلى سبيل المثال، إذا أرسلت أداة تجريف 500 طلب في ساعة، فقد تفشل الاستجابات اللاحقة وقد يوضع IP في قائمة الحظر لساعات.
CAPTCHA وأنظمة مكافحة البوتات
حتى مع حدود المعدل، تستطيع مواقع الويب كشف السلوك المؤتمت باستخدام أنظمة مثل Cloudflare أو Akamai. فهي تحلل إشارات مثل سرعة الطلب والرؤوس وتنفيذ JS والسلوك الشبيه بالمستخدم لتقرر ما إذا كانت حركة المرور بشرية. وإذا بدا شيء غير طبيعي، فقد تتعرض للحظر.
مشكلات جودة البيانات
حتى عندما ينجح التجريف، لا تكون البيانات موثوقة دائماً. تحمل مواقع كثيرة المحتوى ديناميكياً وتعرض نسخاً مختلفة، ولذلك قد يرى مستخدمون مختلفون نتائج مختلفة. بل إن بعضها يقدم صفحات محظورة جزئياً تبدو سليمة لكنها قد تحتوي على بيانات غير صحيحة.
لماذا تعد البروكسيات ضرورية للزحف والتجريف
الفكرة كلها هي جعل طلباتك غير قابلة للتمييز عن طلبات زائر حقيقي. وهذا يعني أن الرؤوس والتوقيت وIP نفسه يجب أن تبدو طبيعية.
يبدو مسار التدفق كالتالي:
طلب ← بروكسي ← موقع الويب المستهدف ← استجابة
ترسل أداة التجريف طلباً إلى البروكسي الذي يعيد توجيهه إلى موقع الويب المستهدف باستخدام عنوان IP الخاص به، ثم يعيد الاستجابة إلى المستخدم. وبهذه الطريقة يرى الهدف البروكسي بدلاً من الاتصال الحقيقي. ويكتسب البروكسي أهميته لأنه يخفي IP ونشاط التجريف.
كيف تساعد البروكسيات
يعد دمج البروكسيات في مسار عملك استثماراً ضرورياً. تشمل أبرز فوائدها وصولاً موثوقاً وحماية من قيود IP وعمليات قابلة للتوسع. وفي مشاريع البيانات الجادة،بروكسيات لتجريف الويبلا غنى عنها. ومع البروكسيات يستمر العمل حتى حين تتشدد الأهداف في حظر حركة المرور المؤتمتة. يساعد الاستهداف الجغرافي في جمع التسعير الإقليمي أو الإعلانات عبر دول مختلفة. ومن مزايا البروكسيات أيضاً قدرتها على إبقاء أنماط حركة المرور طبيعية وتقليل خطر تفعيل دفاعات مكافحة البوتات.
أفضل أنواع البروكسي لكل مهمة
يعتمد الاختيار الصحيح للبروكسيات على احتياجاتك وحالة الاستخدام الخاصة بك. إليك ثلاثة أنواع رئيسية من البروكسيات:
- بروكسيات سكنيةتستخدم عناوين IP حقيقية يخصصها مزودو خدمة الإنترنت. وبالنسبة إلى الموقع المستهدف، لا تختلف عن زائر عادي يتصفح من غرفة معيشته. تتمتع هذه البروكسيات بدرجة ثقة من الأعلى وتتعرض للحظر أقل من الأنواع الأخرى. استخدم البروكسيات السكنية لتجريف المواقع ذات نظام الحماية الصارم وللحصول على بيانات محددة من مناطق أخرى. تبدأ بروكسيات DataImpulse السكنية من $1 لكل GB.
- بروكسيات مراكز البيانات هي عناوين IP مستضافة في مراكز البيانات. وهي سريعة ورخيصة، ويبلغ سعر بروكسيات DataImpulse لمراكز البيانات $0.50 لكل GB. ومع ذلك، لأن عناوين IP هذه تأتي من نطاقات مراكز البيانات، يمكن لبعض مواقع الويب المستهدفة اكتشافها وحظرها. استخدم بروكسيات مراكز البيانات عندما تكون السرعة أولوية قصوى، لتجريف API المفتوحة أو مجموعات البيانات العامة.
- توجه البروكسيات المحمولة حركة المرور عبر أجهزة محمولة حقيقية على شبكات 3G-5G وLTE. توفر هذه البروكسيات أعلى مستوى من إخفاء الهوية، ولا تضعها مواقع الويب في قائمة الحظر. استخدمها عندما يحتوي موقع الويب على أنظمة دفاع قوية لمكافحة البوتات أو عندما تدير حسابات يجب أن تبقى نشطة على المدى الطويل.
الزحف مقابل التجريف في SEO
تشير عملية الزحف إلى تحليل عناوين URL وخرائط المواقع والنص والشفرة لتحديد المحتوى وتقرير الصفحات التي ينبغي زيارتها لاحقاً. في SEO، تستخدم محركات البحث الزحف للعثور على البيانات ذات الصلة على الإنترنت. على سبيل المثال، يتبع Googlebot الروابط من صفحة إلى صفحة بحثاً عن صفحات جديدة أو صفحات تغيرت حديثاً. عندما يعثر الزاحفون على صفحة ويب، تعرض أنظمة البحث المحتوى وتبحث عن الكلمات المفتاحية وتخزنه في فهرس البحث. إليك ثلاث خطوات رئيسية توضح كيفية عمل محركات البحث:
- الزحف للعثور على الصفحات.
- فهرسة الصفحات وتخزينها في قاعدة بيانات.
- ترتيب الصفحات والإجابة عن استعلامات البحث.
يفحص الزاحفون السياق، مثل النص والمرئيات وملفات HTML وCSS وJavaScript، ولهذا ينبغي أن يكون SEO الصفحات منظماً جيداً. الزحف جزء لا غنى عنه من التحسين. فلا زحف يعني لا فهرسة ولا ترتيب.
من ناحية أخرى يوجد التجريف. إنها عملية مختلفة تماماً عندما يتعلق الأمر بالحصول على حركة المرور من نتائج البحث العضوية. هدف التجريف هو استخراج معلومات محددة من صفحات الويب لاستخدامها لاحقاً في جدول بيانات أو لوحة معلومات. وعادة لا علاقة له بفهرسة SEO. من يتتبعون الأسعار أو يولدون العملاء المحتملين أو يحللون المنافسين أو يجرون الأبحاث يلجؤون عادة إلى التجريف، لكنه لا يساعد موقعك على الحصول على ترتيب أو فهرسة.
يزور كل من الزحف والتجريف عناوين URL ويقرآن HTML، لكن الفارق في الغرض. فالزحف يرسم خريطة الويب لمحركات البحث، بينما يستخرج التجريف البيانات للاستخدام الخارجي.
الأسئلة الشائعة
ما هو الزحف على الويب؟
الزحف على الويب هو عملية العثور على صفحات الويب وفهرستها باتباع الروابط. يزور زاحف الويب مواقع الويب تلقائياً ويقرأ صفحاتها ويجمع البيانات للمساعدة في إنشاء إدخالات لفهرس محرك البحث.
ما هو تجريف الويب؟
تجريف الويب هو عملية استخراج بيانات محددة من صفحات الويب وحفظها بتنسيقات منظمة مثل XML وExcel أو قواعد بيانات SQL. يزور مجرف الويب صفحة منتج ويستخرج الاسم والسعر والصور والتقييمات الخاصة بالمنتج.
ما الفرق بينهما؟
يتعلق زحف البيانات باتباع الروابط ورسم خريطة لعناوين URL عبر الموقع، مع التركيز على اتصال الصفحات. أما التجريف فيتعلق باستخراج نقاط بيانات معينة وتحويل HTML غير المنظم إلى بيانات منظمة.
هل يمكن استخدامهما معاً؟
نعم. يكتشف الزاحف أولاً جميع عناوين URL ذات الصلة في موقع ويب، ثم يستخرج المجرف البيانات من كل منها. تنجح هذه الطريقة في تتبع الأسعار أو تحليلات سوق العمل.
هل تجريف الويب قانوني؟
نعم. تجريف البيانات المتاحة للعامة قانوني. أنت تمرر حركة المرور عبر عنوان IP مشروع. تحظر DataImpulse الوصول إلى الموارد المصرفية والحكومية من جانبنا، تحديداً للحفاظ على الاستخدام ضمن حدود مشروعة. إذا كانت حالة استخدامك تتضمن قطاعات خاضعة للتنظيم أو بيانات شخصية، فيرجى التحقق أولاً من قوانين حماية البيانات المحلية قبل البدء.
هل تحتاج إلى بروكسيات للتجريف؟
نعم. في DataImpulse، نوصي ببروكسيات سكنية لتجريف الويب. تستطيع عناوين IP السكنية تجاوز المواقع التي تحظر حركة المرور من مراكز البيانات. إذا كانت السرعة وزمن الانتقال المنخفض من أولوياتك، فإن بروكسيات مراكز البيانات خيار مناسب. تحقق من شروط خدمة الموقع قبل البدء.
الخلاصة
يشكل الزحف والتجريف نظاماً مترابطاً. يمنح الزحف بنيةً عبر اكتشاف الصفحات وتنظيمها في موقع الويب، ويحوّل التجريف ذلك إلى بيانات قابلة للاستخدام. وباستخدامهما معاً يصبح جمع البيانات على نطاق واسع أكثر عملية. ومن المهم معرفة متى تحدث كل خطوة ولماذا تهم. الزحف والتجريف ليسا أداتين متنافستين، بل يكمل كل منهما الآخر في العملية نفسها.