
In this Article
การเก็บข้อมูลด้วยเว็บครอว์เลอร์และการขูดข้อมูลจากเว็บเป็นแนวคิดที่ผู้ใช้มักสับสน หนึ่งแนวคิดมุ่งเน้นการค้นหาและจัดทำดัชนีเนื้อหา ขณะที่อีกแนวคิดดึงข้อมูลเฉพาะเจาะจงเพื่อการวิเคราะห์ แต่เหตุใดการเข้าใจความแตกต่างจึงสำคัญ เมื่อคุณทำงานในอุตสาหกรรมอย่างการวิจัยตลาด SEO การวิเคราะห์ข้อมูล หรือระบบข่าวกรองธุรกิจ การรู้ความแตกต่างนี้ส่งผลโดยตรงต่อความแม่นยำของผลลัพธ์สุดท้ายของคุณ
มาดูกันว่าควรใช้การเก็บข้อมูลด้วยเว็บครอว์เลอร์เมื่อใด และเมื่อใดควรหันไปใช้การขูดข้อมูลจากเว็บ
ข้อเท็จจริงสำคัญ
- การเก็บข้อมูลด้วยเว็บครอว์เลอร์และการขูดข้อมูลจากเว็บโดยทั่วไปมีความเชื่อมโยงกัน
- การครอว์ล: สร้างดัชนีหรือชุดข้อมูลโดยสำรวจหน้าเว็บหรือเอกสารจำนวนมาก ทำงานโดยอัตโนมัติด้วยตัวแทนครอว์ล โดยติดตามลิงก์เพื่อค้นหาเนื้อหา
- การสแครป: ดึงข้อมูลสาธารณะที่เจาะจงเพื่อการวิเคราะห์ และบันทึกไว้ในเครื่อง (CSV, Excel, SQL ฯลฯ) สามารถทำได้ผ่านตัวสแครป Python, WebScraper API หรือทำด้วยตนเอง ต้องใช้การเข้าถึงอินเทอร์เน็ต
- ทั้งสองกระบวนการมักใช้ร่วมกันในการเก็บรวบรวมข้อมูล
- บริษัทต่างๆ ผสานพร็อกซีและกลยุทธ์อัตโนมัติเพื่อกระจายคำขอและหลีกเลี่ยงการถูกบล็อก
- โปรดจำไว้ว่าต้องเคารพข้อกำหนดการให้บริการของเว็บไซต์เสมอ และใช้ พร็อกซี เพื่อการมีตัวตนทางดิจิทัลที่ปลอดภัย การดำเนินงานที่รวดเร็ว และข้อมูลที่มั่นคงปลอดภัย
การเก็บข้อมูลด้วยเว็บครอว์เลอร์คืออะไร
การครอว์ลโดยลำพังหมายถึงการเคลื่อนผ่านพื้นที่ทีละขั้นเพื่อสำรวจสิ่งที่อยู่ตรงนั้น ดังนั้นเมื่อพูดถึงการเก็บข้อมูลด้วยเว็บครอว์เลอร์ ก็หมายถึงการสำรวจอินเทอร์เน็ตในลักษณะเดียวกัน เว็บครอว์เลอร์ หรือที่เรียกว่าสไปเดอร์หรือบอต จะเข้าชมเว็บไซต์โดยอัตโนมัติ อ่านหน้าเว็บ และรวบรวมข้อมูลเพื่อช่วยสร้างรายการสำหรับดัชนีของเครื่องมือค้นหา
การเก็บข้อมูลด้วยเว็บครอว์เลอร์ทำงานอย่างไร
กระบวนการนี้ไม่ได้จำกัดอยู่แค่การสแกนหน้าเว็บเดียว ครอว์เลอร์วิเคราะห์เนื้อหาของหน้าเว็บ แล้วติดตามลิงก์ของหน้านั้นเพื่อค้นหาหน้าเว็บเพิ่มขึ้นอีกมากมาย โดยดำเนินวงจรนี้ต่อไปเพื่อทำการสำรวจเว็บเชิงลึกและอย่างมีโครงสร้าง นี่คือวิธีที่เครื่องมือค้นหาอย่าง Google, Yahoo และ Bing สามารถทำแผนที่และจัดทำดัชนีเนื้อหาออนไลน์จำนวนมหาศาลได้

หากต้องการทำการเก็บข้อมูลด้วยเว็บครอว์เลอร์ คุณต้องมีเครื่องมือและเฟรมเวิร์กเฉพาะทาง ตัวอย่างที่ได้รับความนิยม ได้แก่ Scrapy และ Apache Nutch ซึ่งทั้งคู่เป็นที่นิยมอย่างกว้างขวางสำหรับงานเก็บรวบรวมข้อมูลและจัดทำดัชนีในขนาดใหญ่
ข้อมูลที่ครอว์เลอร์เก็บรวบรวม
ไม่ใช่แค่ข้อความ ครอว์เลอร์เก็บองค์ประกอบพื้นฐานของทุกหน้าเว็บ ซึ่งรวมถึง URL โค้ด และเฮดเดอร์ จากนั้นจึงเป็นองค์ประกอบเชิงโครงสร้าง เช่น ชื่อหน้าเว็บ คำอธิบาย แท็ก ลิงก์ภายในและภายนอก เป็นต้น ครอว์เลอร์ยังบันทึกสัญญาณทางเทคนิคที่ผู้ใช้มองไม่เห็นแต่มีความสำคัญต่อการวิเคราะห์ ตัวอย่างเช่น การอ้างอิงแผนผังเว็บไซต์ แท็ก hreflang สำหรับเว็บไซต์หลายภาษา เวลาในการโหลดหน้าเว็บ และอื่นๆ
นอกจากนี้ยังมีข้อมูลความสัมพันธ์ ซึ่งเกี่ยวกับความเชื่อมโยงระหว่างหน้าเว็บ แต่ละลิงก์จะกลายเป็นโหนดในแผนที่เว็บที่ใช้ประเมินความเกี่ยวข้องและความน่าเชื่อถือผ่านสัญญาณแบ็กลิงก์
กรณีใช้งานทั่วไปของการเก็บข้อมูลด้วยเว็บครอว์เลอร์
การจัดทำดัชนีของเครื่องมือค้นหาเป็นกรณีใช้งานหลักของการเก็บข้อมูลด้วยเว็บครอว์เลอร์ บอต หรือสไปเดอร์ จะครอว์ลเว็บเพื่อค้นหาหน้าเว็บใหม่ รีเฟรชหน้าเว็บที่มีอยู่ และสร้างดัชนีที่ค้นหาได้ง่าย ครอว์เลอร์ยังเป็นแกนหลักของเครื่องมือตรวจสอบจำนวนมากที่สแกนเว็บไซต์เพื่อพบลิงก์เสียหรือเนื้อหาซ้ำ แพลตฟอร์มอีคอมเมิร์ซใช้การครอว์ลเพื่อติดตามผลิตภัณฑ์ของบริษัทอื่น เครื่องมือสร้างรายชื่อลูกค้าเป้าหมายดึงข้อมูลผู้ติดต่อจากไดเรกทอรีและโปรไฟล์สาธารณะ การครอว์ลขนาดใหญ่ป้อนข้อมูลสำหรับการฝึกโมเดล AI นอกจากนี้ยังใช้กันอย่างแพร่หลายในด้านความมั่นคงปลอดภัยทางไซเบอร์ เนื่องจากสามารถระบุสินทรัพย์ที่เปิดเผยหรือข้อมูลรับรองที่รั่วไหลได้
การขูดข้อมูลจากเว็บคืออะไร
การสแครปหมายถึงการเก็บหรือดึงบางสิ่งออกจากพื้นผิว หากนำมาใช้ในบริบทของสภาพแวดล้อมดิจิทัล การสแครปหมายถึงการรวบรวมข้อมูลจากเว็บไซต์โดยอัตโนมัติและบันทึกในรูปแบบที่มีโครงสร้าง เช่น ฐานข้อมูล XML, Excel หรือ SQL เครื่องมือที่ทำงานนี้เรียกว่าตัวสแครปเว็บ ขึ้นอยู่กับข้อกำหนด ตัวสแครปสามารถเก็บข้อมูลจากเกือบทุกเว็บไซต์ได้ภายในไม่กี่วินาที ทำให้งานที่มิฉะนั้นต้องทำด้วยตนเองเป็นเวลาหลายชั่วโมงเป็นอัตโนมัติ
การขูดข้อมูลจากเว็บทำงานอย่างไร
ก่อนอื่น ตัวสแครปต้องส่งต่อคำขอไปยัง URL เป้าหมาย หลังจากนั้น เซิร์ฟเวอร์จะตอบกลับด้วย HTML ของหน้าเว็บ จากนั้นตัวสแครปจะแยกวิเคราะห์เนื้อหา ดึงข้อมูลที่ต้องการ และจัดเก็บไว้ในรูปแบบที่มีโครงสร้าง เช่น ฐานข้อมูลหรือไฟล์

มีการดึงข้อมูลใดบ้าง
สแครปเปอร์ดึงข้อมูลเว็บในส่วนที่เจาะจง ตัวอย่างที่พบบ่อยที่สุดบางส่วน ได้แก่:
- ข้อมูลสินค้า
- ข้อมูลติดต่อ
- เมทาดาทา
- รายการอสังหาริมทรัพย์และตลาดงาน
- ข้อมูลที่มีโครงสร้างซึ่งอยู่บนหน้านั้นแล้ว
กรณีใช้งานทั่วไปของการสแครปเว็บ
หลายทีมสามารถติดตามราคา สินค้า หรือโปรโมชันจากเว็บไซต์ของคู่แข่งได้ด้วยการสแครปเว็บ ซึ่งเรียกว่าข่าวกรองการแข่งขัน นอกจากนี้ยังใช้ในการวิจัยตลาด การติดตาม SERP การสร้างลีด การเปรียบเทียบราคา และงานด้านการสรรหาบุคลากร การสแครปได้กลายเป็นส่วนสำคัญของงานประจำ สแครปเปอร์สามารถรวบรวมข่าวการเงิน ตรวจสอบแนวโน้ม ทดสอบประสิทธิภาพข้ามภูมิภาค และรวบรวมข้อมูลสำหรับโมเดล AI เป้าหมายในทุกกรณีคือการดึงข้อมูลที่มีโครงสร้างซึ่งระบบปลายทางสามารถนำไปใช้ได้จริง
ความแตกต่างสำคัญระหว่างการครอว์ลและการสแครป
ที่จริงแล้ว การครอว์ลเว็บและการสแครปเว็บช่วยเสริมกันในกระบวนการรวบรวมข้อมูล การครอว์ลเว็บมุ่งเน้นการค้นหาและการทำดัชนี ตัวครอว์เลอร์นำทางเว็บไซต์โดยอัตโนมัติ โดยตามลิงก์จากหน้าหนึ่งไปยังอีกหน้าหนึ่ง รวบรวมเมทาดาทาและเนื้อหาที่เสิร์ชเอนจินหรือแพลตฟอร์มวิเคราะห์สามารถจัดระเบียบได้ ซึ่งออกแบบมาเพื่อให้ครอบคลุมกว้าง โดยสแกนหลายหน้าเพื่อทำความเข้าใจโครงสร้างและเนื้อหาของเว็บไซต์หรือเว็บในวงกว้าง
ในทางกลับกัน การสแครปเว็บมุ่งเป้าไปที่ข้อมูลเฉพาะ เช่น ราคาสินค้า รายละเอียดการติดต่อ หรือรีวิว แล้วบันทึกไว้ในรูปแบบที่มีโครงสร้างเพื่อการวิเคราะห์ โดยเน้นความลึก คือดึงข้อมูลที่คุณต้องการอย่างตรงจุด
|
เว็บครอว์ลิง |
เว็บสแครปปิง |
|
|
วัตถุประสงค์ |
การทำดัชนีและรวบรวมข้อมูลจำนวนมากจากเอกสารหรือไฟล์ |
การดาวน์โหลดและดึงข้อมูลเฉพาะเจาะจงเพื่อการวิเคราะห์ |
|
กระบวนการ |
“คลิกผ่าน” ลิงก์และหน้าเว็บโดยอัตโนมัติด้วยเอเจนต์ครอว์ลิง |
เรียกข้อมูลและดาวน์โหลดข้อมูลเป้าหมายไปยังไฟล์ภายในเครื่อง (CSV, Excel, SQL, etc.) |
|
ขนาดขอบเขต |
กว้างขวาง – ครอบคลุมหน้าเว็บ/เว็บไซต์จำนวนมหาศาล |
แคบ – ดึงจุดข้อมูลที่แม่นยำ |
|
ระบบอัตโนมัติ |
ทำงานอัตโนมัติเต็มรูปแบบ |
ทำงานอัตโนมัติหรือทำด้วยตนเอง |
|
ความซับซ้อน |
ต่ำกว่า - ต้องใช้เอเจนต์ครอว์เลอร์ |
สูงกว่า - ต้องเข้าถึงอินเทอร์เน็ต และต้องใช้เอเจนต์ครอว์เลอร์กับตัวแยกวิเคราะห์ |
|
เครื่องมือ |
Scrapy, Apache Nutch, Heritrix, สคริปต์ Python แบบกำหนดเอง |
BeautifulSoup, lxml, Playwright, Puppeteer, Selenium, WebScraper API |
การทำงานร่วมกันของการครอว์ลและการสแครป
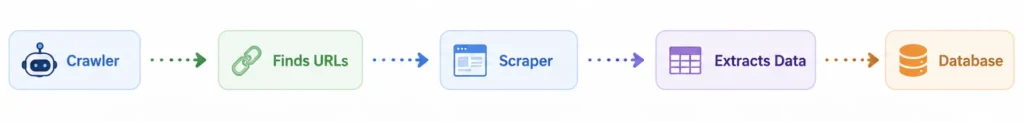
การครอว์ลและการสแครปสร้างไปป์ไลน์สองขั้นตอน ทั้งสองเป็นสองขั้นของกระบวนการเดียวกัน การครอว์ลค้นหาหน้าเว็บ และการสแครปดึงข้อมูลเว็บออกจากหน้าเหล่านั้น ในโปรเจ็กต์จริง ทั้งสองทำงานเป็นวงจร
เวิร์กโฟลว์ทั่วไป
อันดับแรก ตัวครอว์ลเลอร์เริ่มจากหน้าฐานและติดตามลิงก์เพื่อสร้างรายการ URL ที่เกี่ยวข้อง รายการนี้จะส่งต่อให้ตัวสแครปเปอร์ ซึ่งเข้าชมแต่ละหน้าและมุ่งเน้นที่ข้อมูลที่ต้องการ สุดท้าย ผลลัพธ์จะถูกจัดเก็บในฐานข้อมูลหรือเครื่องมือวิเคราะห์ข้อมูล
ตัวอย่างในโลกจริง
ลองพิจารณาระบบติดตามราคาเป็นตัวอย่าง ตัวครอว์ลเลอร์สแกนเว็บไซต์อีคอมเมิร์ซทุกสัปดาห์และรวบรวมหน้าผลิตภัณฑ์ทั้งหมด หลังจากนั้น ตัวสแครปเปอร์ประมวลผล URL ทุกวันและรวบรวมรายละเอียด เช่น ราคาปัจจุบัน สถานะสต็อก และรีวิวจากลูกค้า ค่าสุดท้ายอยู่ในฐานข้อมูลราคา ซึ่งป้อนข้อมูลให้แดชบอร์ดที่ทีมกำหนดราคาใช้ กระบวนการนี้ทำงานอย่างสม่ำเสมอ
เมื่อใดควรใช้การครอว์ลเทียบกับการสแครป
แล้วการสแครปเว็บและการครอว์ลเว็บแตกต่างกันอย่างไร การครอว์ลคือการค้นหาหน้าเว็บ ขณะที่การสแครปคือการดึงข้อมูลจากหน้าที่คุณค้นพบแล้ว การครอว์ลทำแผนที่ URL และการสแครปดึงข้อมูลเฉพาะเจาะจงจากรายการเหล่านั้น บริษัทส่วนใหญ่ผสานทั้งสองกระบวนการในแต่ละขั้นตอนที่ต่างกัน
เมื่อใดควรใช้การครอว์ลเว็บ
การครอว์ลข้อมูลใช้ได้ผลเมื่อคุณยังไม่มีรายการ URL และจำเป็นต้องสำรวจโครงสร้างของเว็บไซต์ ทีมที่ทำการตรวจสอบ SEO เป็นประจำ การทำดัชนีเว็บไซต์ การควบคุมหน้าใหม่ หรือการสร้าง URL มักหันมาใช้การครอว์ล
เมื่อใดควรใช้การสแครปเว็บ
ใช้การสแครปเมื่อทราบหน้าเป้าหมายแล้ว และคุณต้องการข้อมูลเฉพาะ เช่น ราคาหรือรีวิว วิธีนี้เหมาะอย่างยิ่งสำหรับป้อนข้อมูลที่มีโครงสร้างให้แดชบอร์ด ฐานข้อมูล หรือเครื่องมือวิเคราะห์ข้อมูล
เมื่อคุณต้องการทั้งสองอย่าง
โดยทั่วไป การครอว์ลมาก่อนเพื่อค้นหาหน้าเว็บ แล้วจึงตามด้วยการสแครปเพื่อดึงข้อมูล กระบวนการนี้มักทำซ้ำเพื่อให้ URL และข้อมูลเป็นปัจจุบัน สำหรับผู้เชี่ยวชาญที่จัดการข้อมูลขนาดใหญ่ การเข้าใจความแตกต่างเหล่านี้จะเป็นประโยชน์:
- การครอว์ลช่วยทำแผนที่เว็บหรือค้นหาแหล่งข้อมูลที่เกี่ยวข้องทั้งหมด
- การสแครปช่วยให้คุณรวบรวมข้อมูลที่นำไปใช้ดำเนินการได้จากแหล่งข้อมูลเหล่านั้น
- เมื่อใช้ร่วมกัน ทั้งสองมอบเวิร์กโฟลว์ที่ช่วยให้มั่นใจได้ว่าชุดข้อมูลมีความครอบคลุมและมีคุณภาพสูง
ความท้าทายในการครอว์ลและการสแครป
ปัญหาที่อาจเกิดขึ้นสามารถเกิดได้ในทุกขั้นตอนของกระบวนการครอว์ลหรือสแครป สิ่งสำคัญคือต้องระบุปัญหาเหล่านั้นให้ถูกต้องและค้นหาแนวทางแก้ไขที่เหมาะสม
การบล็อก IP และการจำกัดอัตรา
เว็บไซต์จำนวนมากจำกัดจำนวนคำขอที่ IP หนึ่งรายการสามารถส่งได้ในช่วงเวลาสั้น ๆ เมื่อเกินขีดจำกัดนั้น การตอบสนองจะช้าลง และ CAPTCHA หรือข้อผิดพลาด 403 จะเริ่มปรากฏ ตัวอย่างเช่น หากตัวสแครปเปอร์ส่งคำขอ 500 รายการในหนึ่งชั่วโมง การตอบสนองในภายหลังอาจล้มเหลว และ IP อาจถูกติดธงไว้เป็นเวลาหลายชั่วโมง
CAPTCHA และระบบต่อต้านบอต
แม้จะมีการจำกัดอัตรา เว็บไซต์ก็สามารถตรวจจับพฤติกรรมอัตโนมัติได้โดยใช้ระบบอย่าง Cloudflare หรือ Akamai ระบบเหล่านี้วิเคราะห์สัญญาณต่าง ๆ เช่น ความเร็วของคำขอ headers การประมวลผล JS และพฤติกรรมที่คล้ายผู้ใช้ เพื่อพิจารณาว่าทราฟฟิกเป็นมนุษย์หรือไม่ หากบางอย่างดูผิดปกติ คุณอาจถูกบล็อกได้
ปัญหาด้านคุณภาพข้อมูล
แม้การสแครปจะทำงานได้ ข้อมูลก็ไม่ได้เชื่อถือได้เสมอไป เว็บไซต์จำนวนมากโหลดเนื้อหาแบบไดนามิกและแสดงเวอร์ชันที่แตกต่างกัน นั่นคือเหตุผลที่ผู้ใช้แต่ละคนอาจเห็นผลลัพธ์ต่างกัน บางเว็บไซต์ถึงกับส่งหน้าเว็บที่ถูกบล็อกแบบไม่ชัดเจน ซึ่งดูเหมือนไม่มีปัญหาแต่อาจมีข้อมูลที่ไม่ถูกต้อง
เหตุใดพร็อกซีจึงจำเป็นต่อการรวบรวมและดึงข้อมูล
เป้าหมายทั้งหมดคือทำให้คำขอของคุณแยกไม่ออกจากคำขอของผู้เข้าชมจริง ซึ่งหมายความว่าส่วนหัวคำขอ เวลา และ IP เองต้องดูเป็นธรรมชาติ
ลำดับการทำงานมีดังนี้:
คำขอ → พร็อกซี → เว็บไซต์เป้าหมาย → การตอบกลับ
ตัวดึงข้อมูลส่งคำขอไปยังพร็อกซี ซึ่งส่งต่อไปยังเว็บไซต์เป้าหมายโดยใช้ที่อยู่ IP ของตนเอง แล้วส่งการตอบกลับคืนให้ผู้ใช้ ด้วยวิธีนี้ เป้าหมายจะเห็นพร็อกซีแทนการเชื่อมต่อจริง พร็อกซีมีความสำคัญเพราะซ่อน IP และกิจกรรมการดึงข้อมูลของคุณ
พร็อกซีช่วยได้อย่างไร
การผสานพร็อกซีเข้ากับขั้นตอนการทำงานเป็นการลงทุนที่ขาดไม่ได้ ข้อดีสำคัญของพร็อกซี ได้แก่ การเข้าถึงที่เชื่อถือได้ การป้องกันข้อจำกัดของ IP และการดำเนินงานที่ปรับขนาดได้ สำหรับโครงการข้อมูลที่จริงจัง พร็อกซีสำหรับการดึงข้อมูลจากเว็บ เป็นสิ่งที่ขาดไม่ได้ ด้วยพร็อกซี งานจะดำเนินต่อไปได้แม้เป้าหมายจะบล็อกทราฟฟิกอัตโนมัติอย่างเข้มงวด การกำหนดเป้าหมายตามภูมิศาสตร์ช่วยเก็บข้อมูลราคาในแต่ละภูมิภาคหรือรายการข้อมูลจากหลายประเทศ ข้อดีอีกประการคือพร็อกซีช่วยให้รูปแบบทราฟฟิกดูสะอาดและลดความเสี่ยงในการกระตุ้นการป้องกันบอต
ประเภทพร็อกซีที่เหมาะที่สุดสำหรับแต่ละงาน
การเลือกพร็อกซีที่เหมาะสมขึ้นอยู่กับความต้องการและกรณีใช้งานเฉพาะของคุณ นี่คือพร็อกซี 3 ประเภทหลัก:
- พร็อกซีสำหรับที่อยู่อาศัย ใช้ IP จริงที่กำหนดโดยผู้ให้บริการอินเทอร์เน็ต สำหรับเว็บไซต์เป้าหมาย พร็อกซีเหล่านี้เหมือนกับผู้เข้าชมทั่วไปที่ท่องเว็บจากห้องนั่งเล่นทุกประการ พร็อกซีเหล่านี้มีคะแนนความน่าเชื่อถือสูงที่สุดประเภทหนึ่งและถูกบล็อกน้อยกว่าประเภทอื่น ใช้พร็อกซีสำหรับที่อยู่อาศัยเพื่อดึงข้อมูลจากเว็บไซต์ที่มีระบบป้องกันเข้มงวด และเพื่อรับข้อมูลเฉพาะจากภูมิภาคอื่น พร็อกซีสำหรับที่อยู่อาศัยของ DataImpulse เริ่มต้นที่ $1 ต่อ GB
- พร็อกซีศูนย์ข้อมูลคือ IP ที่โฮสต์อยู่ในศูนย์ข้อมูล มีความเร็วสูงและราคาถูก โดยพร็อกซีศูนย์ข้อมูลของ DataImpulse มีราคา $0.50 ต่อ GB อย่างไรก็ตาม เนื่องจากที่อยู่ IP เหล่านี้มาจากช่วงของศูนย์ข้อมูล เว็บไซต์เป้าหมายบางแห่งจึงตรวจจับและบล็อกได้ ใช้พร็อกซีศูนย์ข้อมูลเมื่อความเร็วเป็นสิ่งสำคัญสูงสุด เพื่อดึงข้อมูลจาก API แบบเปิดหรือชุดข้อมูลสาธารณะ
- พร็อกซีมือถือกำหนดเส้นทางทราฟฟิกผ่านอุปกรณ์เคลื่อนที่จริงบนเครือข่าย 3G-5G และ LTE พร็อกซีเหล่านี้มอบการไม่เปิดเผยตัวตนในระดับสูงสุด และเว็บไซต์จะไม่ทำเครื่องหมายพร็อกซีเหล่านี้ ใช้เมื่อเว็บไซต์มีระบบป้องกันบอตที่จริงจัง หรือเมื่อคุณจัดการบัญชีที่ต้องคงการใช้งานไว้ในระยะยาว
การรวบรวมข้อมูลเทียบกับการดึงข้อมูลใน SEO
กระบวนการรวบรวมข้อมูลหมายถึงการวิเคราะห์ URL, แผนผังเว็บไซต์, ข้อความ และโค้ด เพื่อระบุเนื้อหาและตัดสินใจว่าควรเข้าชมหน้าใดต่อไป ใน SEO เครื่องมือค้นหาใช้การรวบรวมข้อมูลเพื่อค้นหาข้อมูลที่เกี่ยวข้องบนอินเทอร์เน็ต ตัวอย่างเช่น Googlebot ติดตามลิงก์จากหน้าหนึ่งไปยังอีกหน้าหนึ่ง และมองหาหน้าใหม่หรือหน้าที่เพิ่งมีการเปลี่ยนแปลง เมื่อโปรแกรมรวบรวมข้อมูลพบหน้าเว็บ ระบบค้นหาจะแสดงผลเนื้อหา มองหาคีย์เวิร์ด และจัดเก็บไว้ในดัชนีการค้นหา นี่คือ 3 ขั้นตอนหลักที่แสดงวิธีการทำงานของเครื่องมือค้นหา:
- รวบรวมข้อมูลเพื่อค้นหาหน้าเว็บ
- จัดทำดัชนีหน้าเว็บและจัดเก็บไว้ในฐานข้อมูล
- จัดอันดับหน้าเว็บและตอบคำค้นหา
โปรแกรมรวบรวมข้อมูลสแกนบริบท เช่น ข้อความ ภาพ HTML, CSS, ไฟล์ JavaScript และด้วยเหตุนี้ SEO ของหน้าเว็บจึงควรจัดระเบียบอย่างดี การรวบรวมข้อมูลเป็นส่วนสำคัญที่ขาดไม่ได้ของการเพิ่มประสิทธิภาพ หากไม่มีการรวบรวมข้อมูล ก็จะไม่มีการจัดทำดัชนีและไม่มีการจัดอันดับ
ในอีกด้านหนึ่งคือการดึงข้อมูล ซึ่งเป็นกระบวนการที่แตกต่างอย่างสิ้นเชิงเมื่อพูดถึงการได้มาซึ่งทราฟฟิกจากผลการค้นหาแบบออร์แกนิก เป้าหมายของการดึงข้อมูลคือดึงข้อมูลเฉพาะจากหน้าเว็บเพื่อนำไปใช้ภายหลังในสเปรดชีตหรือแดชบอร์ด และโดยปกติแล้วไม่มีความเกี่ยวข้องกับการจัดทำดัชนีสำหรับ SEO ผู้ที่ติดตามราคา สร้างลีด วิเคราะห์คู่แข่ง หรือทำวิจัย มักหันมาใช้การดึงข้อมูล แต่สิ่งนี้ไม่ได้ช่วยให้เว็บไซต์ของคุณได้รับการจัดอันดับหรือถูกทำดัชนี
ทั้งการรวบรวมข้อมูลและการดึงข้อมูลต่างเข้าชม URL และอ่าน HTML แต่สิ่งที่แตกต่างคือวัตถุประสงค์ การรวบรวมข้อมูลมีไว้เพื่อทำแผนที่เว็บสำหรับเครื่องมือค้นหา ขณะที่การดึงข้อมูลมีไว้เพื่อดึงข้อมูลไปใช้ภายนอก
คำถามที่พบบ่อย
การเก็บข้อมูลเว็บด้วยโปรแกรมคืออะไร?
การเก็บข้อมูลเว็บด้วยโปรแกรมคือกระบวนการค้นหาและจัดทำดัชนีหน้าเว็บด้วยการติดตามลิงก์ โปรแกรมเก็บข้อมูลเว็บจะเข้าเยี่ยมชมเว็บไซต์โดยอัตโนมัติ อ่านหน้าเว็บ และรวบรวมข้อมูลเพื่อช่วยสร้างรายการสำหรับดัชนีของเครื่องมือค้นหา
การดึงข้อมูลจากเว็บคืออะไร?
การดึงข้อมูลจากเว็บคือกระบวนการสกัดข้อมูลเฉพาะจากหน้าเว็บและบันทึกในรูปแบบที่มีโครงสร้าง เช่น ฐานข้อมูล XML, Excel หรือ SQL โปรแกรมดึงข้อมูลเว็บจะเข้าเยี่ยมชมหน้าสินค้าและดึงชื่อ ราคา รูปภาพ และคะแนนของสินค้าออกมา
ทั้งสองอย่างแตกต่างกันอย่างไร?
การเก็บข้อมูลคือการติดตามลิงก์และทำแผนที่ URL ทั่วทั้งเว็บไซต์ โดยมุ่งเน้นที่ความเชื่อมโยงของหน้าเว็บ ส่วนการดึงข้อมูลคือการสกัดจุดข้อมูลเฉพาะ โดยเปลี่ยน HTML ที่ไม่มีโครงสร้างให้เป็นข้อมูลที่มีโครงสร้าง
สามารถใช้ร่วมกันได้หรือไม่?
ได้ โปรแกรมเก็บข้อมูลจะค้นพบ URL ที่เกี่ยวข้องทั้งหมดบนเว็บไซต์ก่อน จากนั้นโปรแกรมดึงข้อมูลจะสกัดข้อมูลจากแต่ละ URL วิธีนี้เหมาะอย่างยิ่งสำหรับการติดตามราคาหรือการวิเคราะห์ตลาดงาน
การดึงข้อมูลจากเว็บถูกกฎหมายหรือไม่?
ถูกกฎหมาย การดึงข้อมูลที่เผยแพร่สู่สาธารณะนั้นถูกกฎหมาย คุณกำลังกำหนดเส้นทางทราฟฟิกผ่านที่อยู่ IP ที่ถูกต้องตามกฎหมาย DataImpulse ปิดกั้นการเข้าถึงทรัพยากรด้านธนาคารและภาครัฐจากฝั่งของเรา โดยเฉพาะเพื่อให้การใช้งานอยู่ภายในขอบเขตที่ถูกต้องตามกฎหมาย หากกรณีการใช้งานของคุณเกี่ยวข้องกับอุตสาหกรรมที่อยู่ภายใต้การกำกับดูแลหรือข้อมูลส่วนบุคคล โปรดตรวจสอบกฎหมายคุ้มครองข้อมูลในท้องถิ่นของคุณก่อนเริ่มใช้งาน
คุณต้องใช้พร็อกซีเพื่อดึงข้อมูลหรือไม่?
ต้องใช้ ที่ DataImpulse เราแนะนำพร็อกซีสำหรับที่อยู่อาศัย สำหรับการดึงข้อมูลจากเว็บ IP สำหรับที่อยู่อาศัย สามารถผ่านเว็บไซต์ที่ปิดกั้นทราฟฟิกจากดาต้าเซ็นเตอร์ได้ หากความเร็วและเวลาแฝงต่ำคือสิ่งที่คุณให้ความสำคัญ พร็อกซีดาต้าเซ็นเตอร์เป็นตัวเลือกที่เหมาะสม ตรวจสอบข้อกำหนดการให้บริการของเว็บไซต์ก่อนเริ่มใช้งาน
บทสรุป
การไล่สำรวจเว็บไซต์และการดึงข้อมูลเป็นระบบที่เชื่อมโยงกัน การไล่สำรวจช่วยสร้างโครงสร้างด้วยการค้นหาและจัดระเบียบหน้าต่างๆ ทั่วทั้งเว็บไซต์ และการดึงข้อมูลทำให้ข้อมูลนั้นนำไปใช้ได้ เมื่อใช้ทั้งสองอย่างร่วมกัน การเก็บรวบรวมข้อมูลในขนาดใหญ่จึงทำได้จริงมากขึ้น สิ่งสำคัญคือการรู้ว่าแต่ละขั้นตอนเกิดขึ้นเมื่อใดและเหตุใดจึงมีความสำคัญ การไล่สำรวจเว็บไซต์และการดึงข้อมูลไม่ใช่เครื่องมือที่แข่งขันกัน แต่เสริมกันในกระบวนการเดียวกัน