
In this Article
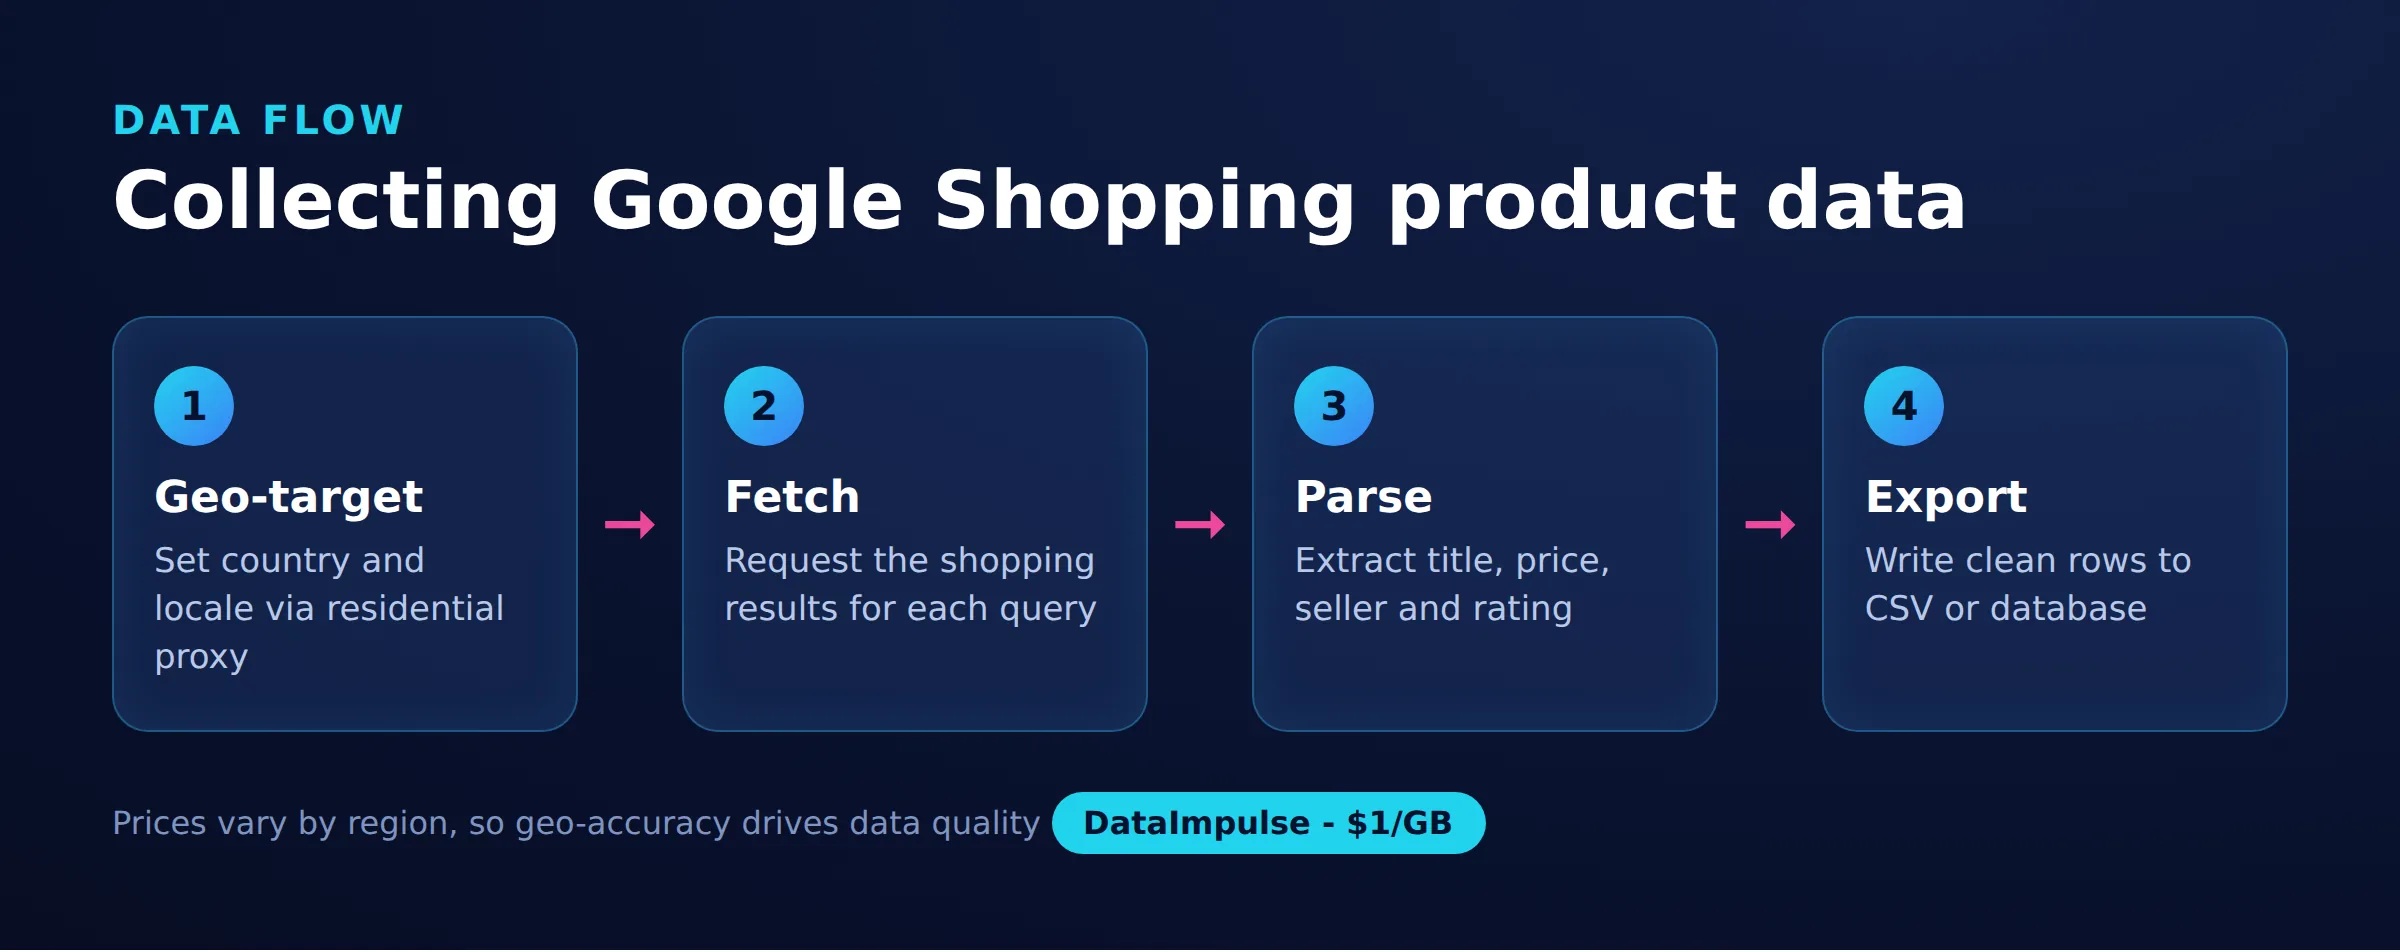
网络爬取 Google Shopping 是指大规模收集其购物结果中的结构化商品数据,包括标题、价格、卖家、评分和配送说明。由于这些结果受到严密保护且高度本地化,要稳定完成此工作,需要轮询 IP 并进行正确的地理定位,而不是在单一连接上运行一个爬虫。
本指南以代码为先,逐步介绍地理定位请求、通过特定国家的代理进行路由、解析 Google 有意混淆的商品卡片、分页、在速率限制下重试和退避、含同意对话框处理的无头浏览器备用方案、可导出 CSV 的整洁数据模型、价格历史追踪器和监控计划。它也如实说明反爬虫的现实、自建爬虫与付费 SERP API 的取舍,以及法律边界所在。
DataImpulse 是一家注重道德规范的代理服务商,在 195 个国家提供超过 9000 万个住宅、移动和数据中心 IP 地址。它采用按量付费模式,每 GB 1 美元起,流量永不过期,可用于网络爬取、广告验证、价格监控、市场研究和多账号管理。
关键要点
- 本地化定价: 要准确网络爬取 Google Shopping,您必须设置 gl 和 hl 参数,并通过目标国家的 IP 路由请求,因为价格、卖家和可用性会因地区而异。
- 最佳代理类型: 轮询住宅代理,它们使用真实消费者 IP,可绕过检测。
- 价格: 每 GB 1 美元起,按量付费,流量永不过期,无需订阅。
- 覆盖范围: 覆盖 195 个国家,拥有超过 9000 万个符合道德规范获取的 IP。
- 可靠性: 成功率 99.51%,在 G2 获得 4.8/5 评分。
- 协议与定位: HTTP、HTTPS 和 SOCKS5,包含国家定位。
您可以从 Google Shopping 网络爬取哪些数据?
Google Shopping 展示的商品列表包含多个对定价和市场研究有用的结构化字段。每条结果通常都有一组一致的属性,您可以提取并规范化为行。
- 商品详情: 标题、描述摘要、品牌、型号和商品图片 URL。
- 价格: 列出的价格、货币,有时还包括不同卖家的价格范围。
- 卖家: 商家名称,以及在商品详情页上提供同一商品的竞争卖家列表。
- 评分和评价: 如有显示,则包括汇总星级评分和评价数量。
- 库存和配送: 因地区而异的库存状态和配送说明。
Google 每次更新布局时,具体字段都会变化,因此任何解析器都需要容忍缺失值和不断变化的标记。应将每个字段视为可选项,并在提取后验证类型,而不是假设评分或卖家总会存在。同一商品在不同国家可能显示不同价格,因此应从一开始就围绕(商品、国家、时间戳)键来设计架构,而不是日后再补上地理信息。
如何向 Google Shopping 发送地理定位请求?
发送地理定位请求时,您需要访问 Google 的搜索端点,带上购物标签和区域设置参数,再让请求携带真实消费者会发送的相同 IP 和参数信号。最重要的两个参数是 gl(国家,例如德国使用 gl=de)和 hl(界面语言,例如 hl=de)。第三个有用参数是您纳入查询上下文的 location 风格词条,但 gl 加上相匹配的出口 IP 已能完成大部分工作。
仅设置参数还不够,因为 Google 还会读取请求 IP 来决定显示哪些价格和卖家。下面的最小请求发送了真实的请求头和区域参数对。它特意未使用代理,以便您在添加 IP 层之前查看基础调用。
import requests

def build_params(query, country="us", lang="en", start=0):
    return {
        "q": query,
        "tbm": "shop",   # shopping vertical
        "gl": country,    # country bias, e.g. de, gb, fr
        "hl": lang,       # interface language
        "num": 40,        # results per page (soft cap)
        "start": start,   # pagination offset
    }

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="us", lang="en"),
    headers=HEADERS,
    timeout=30,
)
print(resp.status_code, len(resp.text))
请使 Accept-Language 请求头与 hl 保持一致。用英文语言请求头请求德国价格页面会产生不匹配,既显得不自然,也可能返回错误的货币。当您扩大规模后,此基础函数将成为决定区域设置的唯一位置,从而让所有下游调用保持一致。
如何通过国家定位代理路由请求?
要通过国家定位代理路由,您可将 requests 指向单一网关,并在代理用户名中编码目标国家。使用 DataImpulse 时,网关为 gw.dataimpulse.com:823,在用户名后附加 __cr.us 或 __cr.de 即可选择出口国家。国家定位包含在基础价格中,而州、城市、ZIP 和 ASN 定位则是付费附加项。如果您不熟悉代理身份验证,请参阅我们关于 代理身份验证 的指南,其中深入讲解了用户名和密码的运作方式。
import requests

USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

def proxy_for(country):
    # __cr. pins the exit IP to that country
    cred = f"{USER}__cr.{country}:{PASS}"
    url = f"http://{cred}@{GATEWAY}"
    return {"http": url, "https": url}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="de", lang="de"),
    headers=HEADERS,
    proxies=proxy_for("de"),
    timeout=30,
)
print(resp.status_code, len(resp.text))
关键原则是同时切换代理国家和 gl/hl 参数对。要构建跨市场价格比较,请遍历国家列表,并让出口 IP 与区域设置严格同步,使每个响应都反映同一个一致的消费者位置。
MARKETS = [
    {"country": "us", "lang": "en"},
    {"country": "de", "lang": "de"},
    {"country": "gb", "lang": "en"},
    {"country": "fr", "lang": "fr"},
]

def fetch_market(query, market):
    c, lang = market["country"], market["lang"]
    return requests.get(
        "https://www.google.com/search",
        params=build_params(query, country=c, lang=lang),
        headers={**HEADERS, "Accept-Language": f"{lang};q=0.9"},
        proxies=proxy_for(c),
        timeout=30,
    )

for m in MARKETS:
    r = fetch_market("wireless headphones", m)
    print(m["country"], r.status_code, len(r.text))
DataImpulse 提供的是 IP 层,而非托管爬取服务,因此爬虫本身由您负责。轮询 住宅代理 通常适合此用途,因为它们来自真实的消费者设备;数据中心代理 更便宜但更容易被标记,而 移动代理 则为最难应对的目标提供运营商级 IP。
如何解析 Google Shopping 商品卡片?
您可使用容错性强的 HTML 库解析商品卡片,并基于稳定的文本模式,而非脆弱的深层选择器,因为 Google 的类名经过混淆且经常轮换。您今天从浏览器开发者工具复制的任何选择器,都可能在数周内失效,因此应让解析器在布局变化时优雅降级,而不是崩溃。
一种稳健的方法是读取每个候选卡片,从标签结构中提取标题和图片,并用识别货币的正则表达式提取价格。以下选择器是贴近实际的示例,并非保证;请预期需要更新它们,并保留正则表达式作为可靠备用方案。
from bs4 import BeautifulSoup
import re

# Currency-aware price matcher: symbol optional, thousands and decimals tolerated.
PRICE_RE = re.compile(r"(?:[$€£]|USD|EUR|GBP)\s?\d[\d.,]*")

def parse_cards(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    # These class names ROTATE; treat them as hints, keep the fallbacks.
    candidates = soup.select("div.sh-dgr__content, div.sh-dlr__list-result, div[data-docid]")
    if not candidates:
        candidates = soup.find_all("div")  # last-resort sweep
    for card in candidates:
        text = card.get_text(" ", strip=True)
        price_match = PRICE_RE.search(text)
        if not price_match or len(text) > 400:
            continue
        img = card.find("img")
        link = card.find("a", href=True)
        rows.append({
            "title": _first_text(card, ["h3", "h4"]),
            "price_raw": price_match.group(0),
            "image": img.get("src") if img else None,
            "url": link["href"] if link else None,
        })
    return rows

def _first_text(card, tags):
    for t in tags:
        el = card.find(t)
        if el and el.get_text(strip=True):
            return el.get_text(strip=True)
    return None

CURRENCY = {"$": "USD", "€": "EUR", "£": "GBP"}

def normalize_price(raw):
    if not raw:
        return None, None
    symbol = next((s for s in CURRENCY if s in raw), None)
    code = CURRENCY.get(symbol, "USD")
    digits = re.sub(r"[^\d.,]", "", raw).replace(",", "")
    try:
        return float(digits), code
    except ValueError:
        return None, code
由于混淆标记在这里是常态,一些团队会改用渲染后的 DOM。有关解析静态 HTML 与渲染页面之间更广泛的取舍,请参阅我们的动态网页网络爬取指南。
当 Google 返回 429 时,如何分页并进行退避?
您可按与页面大小相匹配的步长推进 start 偏移量来分页;并将 HTTP 429(以及空响应或 CAPTCHA 响应)视为等待并通过新 IP 重试的信号,以应对速率限制。Google 会积极限制重复的自动化请求,因此分页和退避应放在同一个循环中。
逐页获取,直到请求不再返回卡片或达到页数上限。通过重新读取代理字典,在页面之间轮询出口 IP;并检查正文中是否有同意或 CAPTCHA 标记来检测软封锁,而不要只相信状态码。
BLOCK_MARKERS = ("unusual traffic", "/sorry/", "consent.google", "captcha")

def is_blocked(resp):
    if resp.status_code in (429, 503):
        return True
    body = resp.text.lower()
    return any(m in body for m in BLOCK_MARKERS)

def paginate(query, market, max_pages=5, page_size=40):
    all_rows = []
    for page in range(max_pages):
        params = build_params(query, market["country"], market["lang"],
                              start=page * page_size)
        resp = get_with_retry(
            "https://www.google.com/search",
            params=params, proxies=proxy_for(market["country"]),
        )
        if resp is None:
            break
        rows = parse_cards(resp.text)
        if not rows:
            break  # no more results
        all_rows.extend(rows)
    return all_rows
下方的重试辅助函数采用带抖动的指数退避,使重试分散开来,避免一批被封锁的工作进程在同一时刻全部重试。每次尝试都会重新获取代理字典,因此轮询池会在下一次尝试时交给您一个新的 IP。
import time, random

def get_with_retry(url, params, proxies, max_attempts=4):
    for attempt in range(max_attempts):
        try:
            resp = requests.get(url, params=params, headers=HEADERS,
                                proxies=proxies, timeout=30)
        except requests.RequestException:
            resp = None
        if resp is not None and not is_blocked(resp):
            return resp
        # exponential backoff: 2, 4, 8 seconds, plus jitter
        wait = (2 ** (attempt + 1)) + random.uniform(0, 1.5)
        time.sleep(wait)
return None # exhausted; caller decides what to do即使重试成功,也应保持合理的请求速率。页面之间保持礼貌的基础延迟并结合轮询,比猛烈请求后依赖重试更有利于长期稳定。我们关于网络爬取最佳实践的说明,更详细地介绍了节奏控制和请求头规范。
如何使用无头浏览器渲染被封锁的页面?
当普通 HTTP 请求持续遇到同意墙或 JavaScript 渲染的内容时,可回退到像真实客户端一样执行页面的无头浏览器,并在读取 DOM 前关闭同意对话框。Playwright 是一个合适的选择,因为它支持按上下文配置代理和可靠等待。
以下脚本通过国家定位的 DataImpulse 代理启动 Chromium,处理欧洲区域设置通常显示的 Cookie 或同意对话框,等待内容加载后返回渲染的 HTML,以便您将其传入同一个 parse_cards 函数。
from playwright.sync_api import sync_playwright

def render_shopping(query, country="de", lang="de"):
    cred_user = f"{USER}__cr.{country}"
    params = f"?q={query.replace(' ', '+')}&tbm=shop&gl={country}&hl={lang}"
    url = "https://www.google.com/search" + params
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            proxy={
                "server": "http://gw.dataimpulse.com:823",
                "username": cred_user,
                "password": PASS,
            },
            locale=f"{lang}-{country.upper()}",
            user_agent=HEADERS["User-Agent"],
        )
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        _dismiss_consent(page)
        page.wait_for_timeout(2000)
        html = page.content()
        browser.close()
        return html

def _dismiss_consent(page):
    # Consent dialogs vary by locale; try a few common accept buttons.
    for label in ("Accept all", "Alle akzeptieren", "Tout accepter",
                  "I agree", "Accept"):
        try:
            btn = page.get_by_role("button", name=label)
            if btn.count() > 0:
                btn.first.click(timeout=3000)
                page.wait_for_timeout(1000)
                return
        except Exception:
            continue
无头浏览器比原始请求更占用 CPU 和内存,因此应将其作为真正需要渲染页面的针对性备用方案,而非默认路径。许多团队为速度而运行直接 HTTP,仅在 is_blocked 持续触发时才升级到 Playwright。如果您的技术栈是 JavaScript 而非 Python,同样的模式也适用于 Puppeteer;请参阅使用 JavaScript 进行网络爬取。
如何构建并导出爬取的数据?
您应围绕稳定的记录来构建数据,该记录始终包含市场和采集时间戳,然后导出为 CSV,使输出便于比较差异、加载到电子表格或推送至数据仓库。数据类可提供类型提示和一行数据的清晰定义。
from dataclasses import dataclass, asdict, field
from datetime import datetime, timezone
import csv

@dataclass
class Offer:
    query: str
    country: str
    title: str | None
    price: float | None
    currency: str | None
    seller: str | None = None
    url: str | None = None
    captured_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

def to_offers(rows, query, country):
    offers = []
    for r in rows:
        price, currency = normalize_price(r.get("price_raw"))
        offers.append(Offer(
            query=query, country=country, title=r.get("title"),
            price=price, currency=currency, url=r.get("url"),
        ))
    return offers
写入 CSV 随后只需输出数据类字段。追加模式加上表头保护,可让定时任务随时间扩展一个文件而无需重写它。
import os

def export_csv(offers, path="google_shopping.csv"):
    if not offers:
        return
    fieldnames = list(asdict(offers[0]).keys())
    write_header = not os.path.exists(path)
    with open(path, "a", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if write_header:
            writer.writeheader()
        for o in offers:
            writer.writerow(asdict(o))
在每一行保留国家和时间戳,才能让您之后回答诸如今天哪个市场的 SKU 最便宜,或价格本周如何变动等问题。该地理与时间键是下一节价格历史追踪器的基础。
如何长期追踪 Google Shopping 价格历史?
您可将每次观察结果向上插入到以商品、国家和日期为键的小型数据库中来追踪价格历史,这样重新运行爬虫会更新当天的行而非创建重复项,同时保留之前的日期。SQLite 足以处理数百万行且不需要服务器,使监控任务保持自包含。
下方架构使用复合唯一键和 ON CONFLICT 向上插入。一天内运行爬虫两次会覆盖该(商品、国家、日期)的最新价格;跨日期运行则构建可供日后绘图的时间序列。
import sqlite3

DDL = """
CREATE TABLE IF NOT EXISTS price_history (
    product   TEXT NOT NULL,
    country   TEXT NOT NULL,
    day       TEXT NOT NULL,
    price     REAL,
    currency  TEXT,
    seller    TEXT,
    captured_at TEXT,
    PRIMARY KEY (product, country, day)
);
"""

def init_db(path="prices.db"):
    conn = sqlite3.connect(path)
    conn.execute(DDL)
    conn.commit()
    return conn

def upsert_offers(conn, offers):
    sql = """
    INSERT INTO price_history
        (product, country, day, price, currency, seller, captured_at)
    VALUES (?, ?, ?, ?, ?, ?, ?)
    ON CONFLICT(product, country, day) DO UPDATE SET
        price=excluded.price,
        currency=excluded.currency,
        seller=excluded.seller,
        captured_at=excluded.captured_at;
    """
    for o in offers:
        day = o.captured_at[:10]  # YYYY-MM-DD
        conn.execute(sql, (o.title, o.country, day, o.price,
                           o.currency, o.seller, o.captured_at))
    conn.commit()

def price_trend(conn, product, country, days=14):
    cur = conn.execute(
        """SELECT day, price, currency FROM price_history
           WHERE product = ? AND country = ?
           ORDER BY day DESC LIMIT ?""",
        (product, country, days),
    )
    return cur.fetchall()
实际操作中,跨日期匹配标题是难点,因为 Google 的标题在不同采集之间会略有差异。对于小型监测清单,应在向上插入前将原始标题映射到您控制的规范商品 id,而不要相信爬取的标题是稳定键。
如何安排持续的价格监控?
您可将获取、解析和存储步骤封装为一个入口点,再通过 cron 按固定频率运行,从而自动刷新价格,无需手动执行。每天运行一次是价格追踪的合理默认值;对于大多数商品目录,更频繁的运行会提高成本和被封锁风险,却不会增加太多有用信号。
# run_monitor.py
def run_once(queries):
    conn = init_db()
    for query in queries:
        for market in MARKETS:
            rows = paginate(query, market, max_pages=3)
            offers = to_offers(rows, query, market["country"])
            export_csv(offers)
            upsert_offers(conn, offers)
            print(f"{query} / {market['country']}: {len(offers)} offers")
    conn.close()

if __name__ == "__main__":
    WATCHLIST = ["wireless headphones", "mechanical keyboard"]
    run_once(WATCHLIST)
然后使用 cron 注册它。以下条目每天 06:15 运行监控器并记录输出以供调试,这很重要,因为定时爬虫否则会静默失败。
# crontab -e
# minute hour day month weekday  command
15 6 * * * cd /opt/shopping && /usr/bin/python3 run_monitor.py >> monitor.log 2>&1
在任务内部添加轻微抖动,例如在开始时随机休眠几分钟,以免请求每天都在完全相同的时刻访问 Google。按前文所述轮询出口国家并控制请求节奏,同时留意日志中封锁率是否上升,这是 Google 已改变防御措施或您的模式变得过于规律的最早信号。
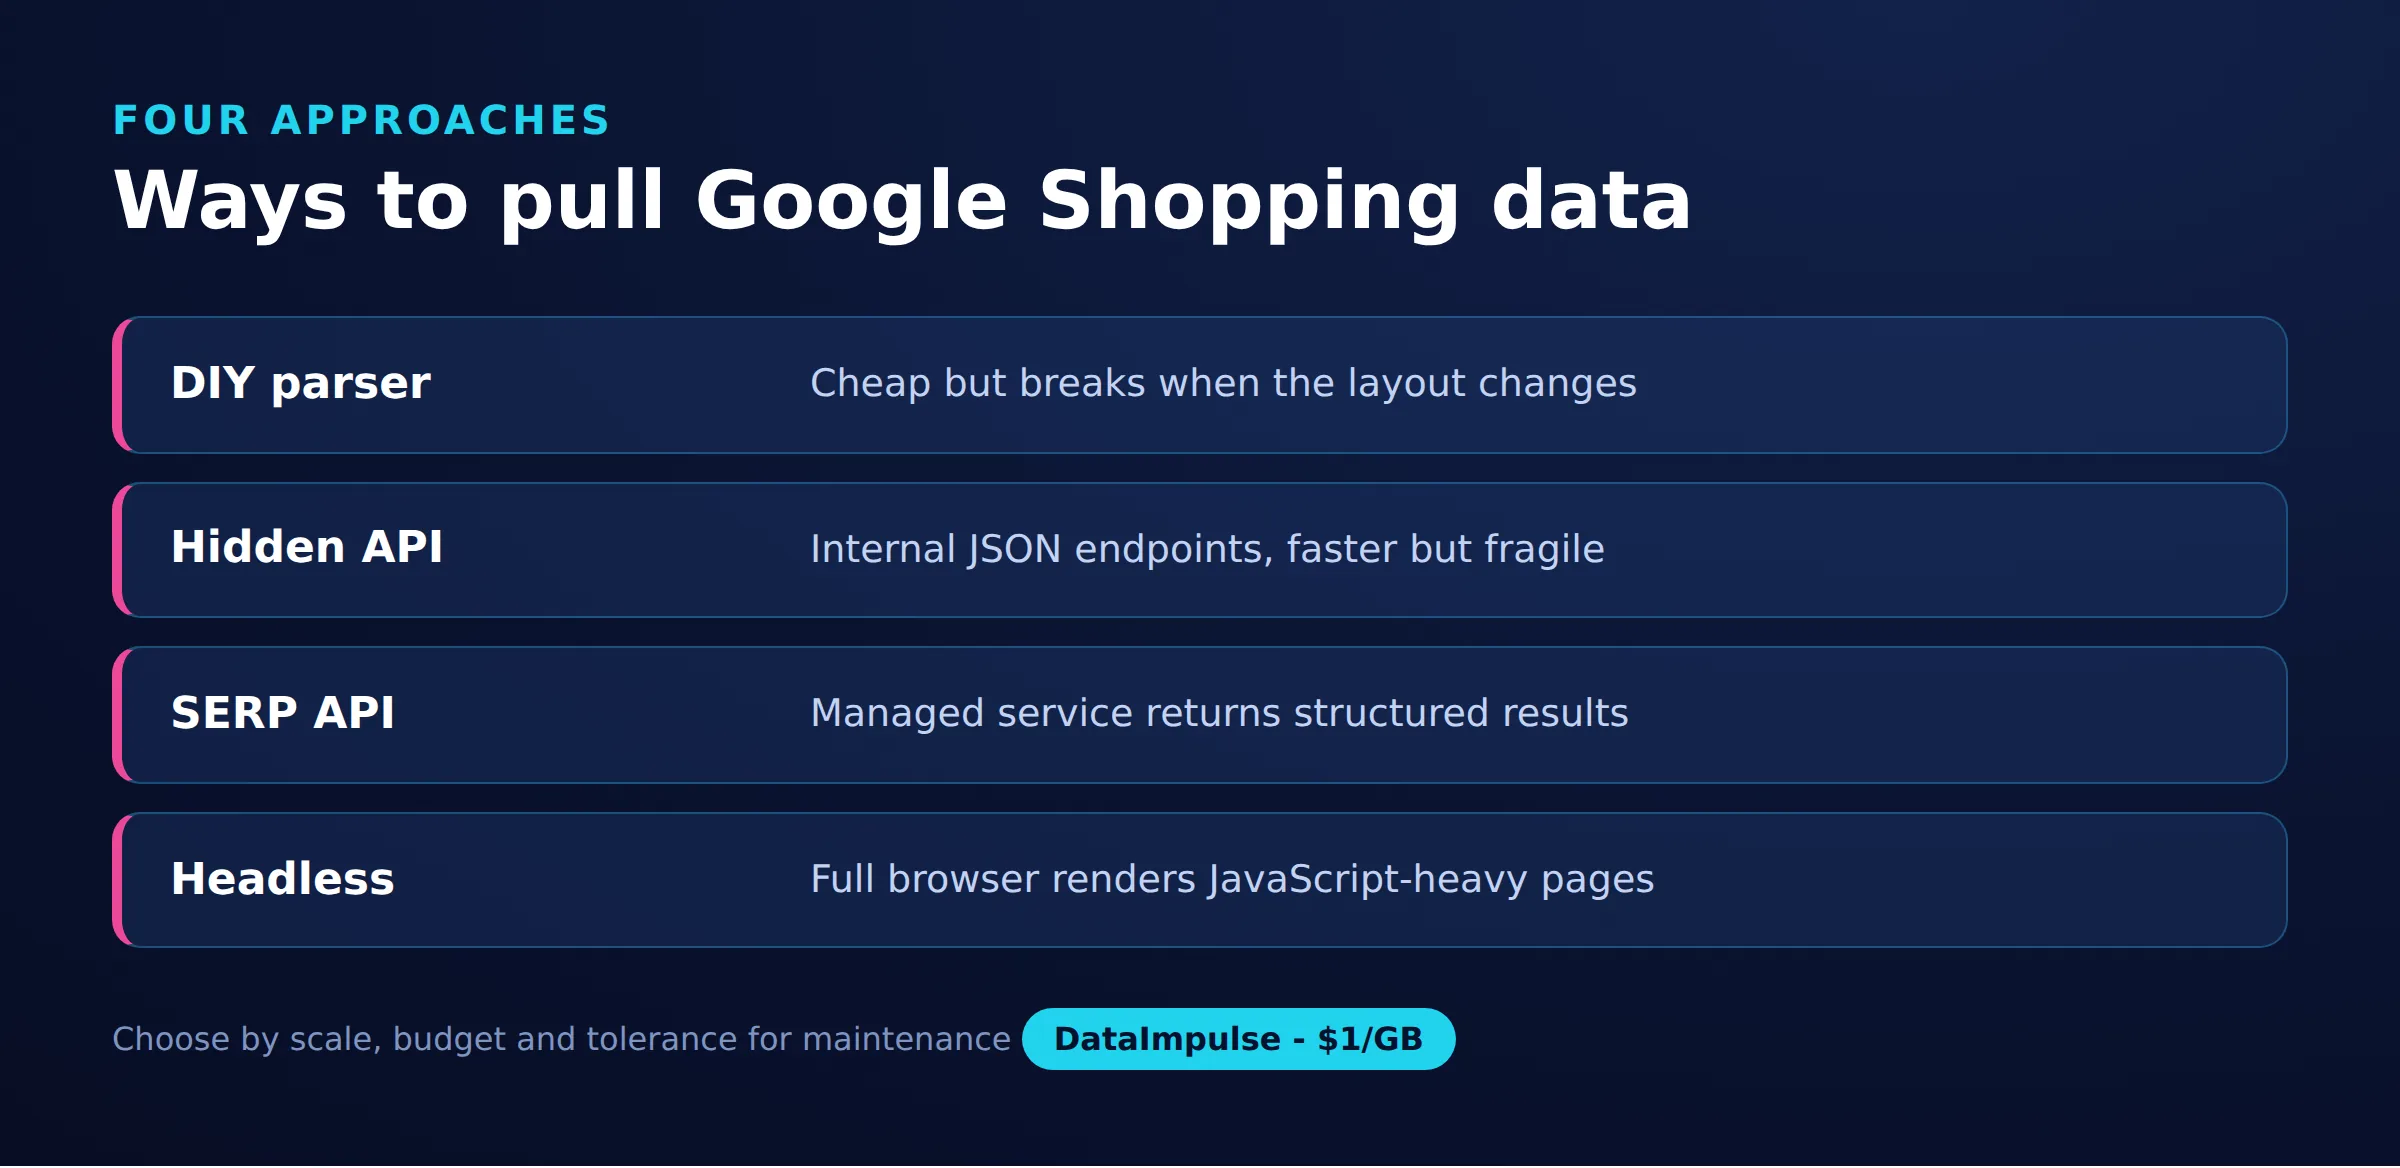
您应选择哪种采集方式:DIY、隐藏端点、SERP API 还是无头浏览器?
请根据您愿意承担多少脆弱性和工程工作,以及愿意为每个请求支付多少费用来选择。不存在唯一正确的答案;真实的取舍是控制权和成本,与维护负担及反爬虫暴露之间的平衡。
反爬虫的现实: Google 会通过速率限制、CAPTCHA、同意墙、轮询的混淆标记和行为信号积极保护这些结果。任何自建爬虫都会定期失效并需要持续维护。代理和退避能减少封锁,但不能消除封锁。承诺 Google 爬虫永远不会被封锁的人是在夸大其词。
| 方式 | 成本 | 脆弱性 | 控制权 |
|---|---|---|---|
| DIY HTML 解析 | 低(仅代理) | 高 | 完全 |
| 隐藏 JSON 端点 | 低(仅代理) | 非常高 | 完全 |
| SERP API | 高(按请求) | 低 | 有限 |
| 无头浏览器 | 中等(计算资源 + 代理) | 中等 | 完全 |
SERP API 与 DIY: 第三方 SERP API 以 JSON 返回解析后的购物结果,并为您承担解析和解除封锁的工作,但按请求收费,存在供应商锁定,且对具体抓取内容的控制较少。基于代理的自建爬虫每个请求的成本低得多,并让您拥有完全控制权,但解析器、重试以及 Google 变更后的维护都由您负责。为明确 DataImpulse 的定位:它是这些 DIY 方式之下的代理层,不是 SERP API,也不是托管爬取服务。如果您希望完全不做解析工作,SERP API 是坦诚的建议;如果您希望低成本和控制权,并能维护爬虫,使用轮询代理的 DIY 方案在经济性上更佳。隐藏 JSON 端点可能更便宜,但也是最脆弱的,因为 Google 可以随时更改或移除它们,恕不另行通知。
网络爬取 Google Shopping 是否正当且合乎道德?
网络爬取公开可见的商品数据,通常被认为比访问私有或受限内容风险更低,但这并不意味着不受规则约束,且本文不构成法律建议。Google Shopping 上的价格和列表是公开的,但您如何收集和使用它们仍然重要,您应与合格的法律顾问确认自己的具体情况。
- 服务条款: 自动化访问可能与 Google 的条款相冲突,这属于合同问题,与版权或计算机访问法不同。
- 个人数据: 商品列表通常不是个人数据,但应避免收集评论者姓名或其他标识符,并在 GDPR 适用时遵循其规定。
- 速率和负载: 保持合理的请求量,以免降低您所查询服务的性能。
- 数据使用: 完整再利用受版权保护的图片或描述,比将价格作为事实进行分析风险更高。
在采集环节,道德规范始于您使用的 IP。DataImpulse 从自愿加入并获得报酬的用户处获取 IP,符合 GDPR,并提供数据处理协议,这有助于构建可辩护的流程。有关同意、来源和负责任实践的更完整说明,请参阅我们的合乎道德的网络爬取指南。将符合道德规范的 IP 来源与礼貌的节奏控制及狭窄、基于事实的数据使用相结合,您便能将法律和声誉风险都保持在较低水平。
常见问题
网络爬取 Google Shopping 是否需要住宅代理?
住宅代理是最可靠的选择,因为它们使用能融入正常流量的真实消费者 IP。数据中心代理可用于较低请求量,但更容易被检测和封锁。
如何从 Google Shopping 获取本地化价格?
将 gl 和 hl 参数设置为目标国家和语言,并使用国家语法让请求通过该国的代理 IP,例如德国使用以 __cr.de 结尾的用户名。Google 会读取参数和请求 IP 来决定显示哪些价格。
DataImpulse 是 Google Shopping 网络爬取 API 吗?
不是。DataImpulse 提供代理层,包括住宅、移动和数据中心 IP,而非托管爬取服务或 SERP API。您可在其 IP 之上运行自己的爬虫或第三方工具。
为什么我的 Google Shopping 爬虫不断被封锁?
Google 会限制来自单个 IP 的重复自动化请求,并返回 CAPTCHA 和同意墙。轮询住宅代理、真实的请求头、对 429 响应进行指数退避,以及合理的请求速率,都能显著减少封锁,不过没有任何方法能完全消除它们。
我应该使用 SERP API 还是构建自己的爬虫?
SERP API 可免除解析和解除封锁的工作,但每个请求成本更高、控制权更少,适合希望零维护的团队。使用轮询代理的自建爬虫成本低得多且拥有完全控制权,但随着 Google 变化,您需要维护解析器和重试机制。
何时 DataImpulse 并不适合?
如果您需要静态 ISP 代理、完全托管的爬取 API,或访问银行和政府网站,DataImpulse 并不是合适的工具。它专注于轮询住宅、移动和数据中心代理,用于收集公开数据和访问内容。
使用可靠代理开始网络爬取 Google Shopping
如果您准备好跨市场收集 Google Shopping 数据,DataImpulse 可为您提供包含国家定位的轮询和粘滞住宅、移动和数据中心 IP,每 GB 1 美元起。创建账户,并通过干净的 IP 池路由您的第一个爬虫。