
In this Article
Google Shopping کو اسکریپ کرنے سے مراد Google کے شاپنگ نتائج سے بڑے پیمانے پر منظم پروڈکٹ ڈیٹا، یعنی عنوانات، قیمتیں، فروخت کنندگان، ریٹنگز اور شپنگ نوٹس، جمع کرنا ہے۔ چونکہ یہ نتائج سخت تحفظ یافتہ اور مقامی نوعیت کے ہوتے ہیں، اس لیے انہیں قابل اعتماد انداز میں حاصل کرنے کے لیے ایک ہی کنکشن پر ایک اسکریپر کے بجائے متغیر IPs اور درست جغرافیائی ہدف بندی درکار ہوتی ہے۔
یہ گائیڈ کوڈ کو بنیادی حیثیت دیتی ہے۔ اس میں جغرافیائی ہدف والی درخواستیں، ملک مخصوص پراکسیز کے ذریعے روٹنگ، Google کے جان بوجھ کر مبہم بنائے گئے پروڈکٹ کارڈز کی پارسنگ، صفحہ بندی، شرح کی حد پر دوبارہ کوشش اور بیک آف، رضامندی ڈائیلاگ سنبھالنے کے ساتھ ہیڈلیس براؤزر کا متبادل، CSV ایکسپورٹ کے ساتھ صاف ڈیٹا ماڈل، قیمت کی تاریخ کا ٹریکر اور نگرانی کا شیڈول شامل ہیں۔ یہ اینٹی بوٹ حقیقت، خود بنائے گئے اسکریپر اور بامعاوضہ SERP API کے درمیان توازن، اور قانونی حدود کے بارے میں بھی صاف گو رہتی ہے۔
DataImpulse ایک اخلاقی پراکسی فراہم کنندہ ہے جو 195 ممالک میں 90 million سے زیادہ رہائشی، موبائل اور ڈیٹا سینٹر IP پتے پیش کرتا ہے۔ یہ 1 dollar per GB سے شروع ہونے والا ادائیگی بہ استعمال ماڈل استعمال کرتا ہے، جس میں ٹریفک کی میعاد ختم نہیں ہوتی، اور اسے ویب اسکریپنگ، اشتہار کی تصدیق، قیمت کی نگرانی، مارکیٹ ریسرچ اور متعدد اکاؤنٹس کے انتظام کے لیے استعمال کیا جاتا ہے۔
اہم حقائق
- مقامی قیمت بندی: Google Shopping کو درست طور پر اسکریپ کرنے کے لیے آپ کو gl اور hl پیرامیٹرز سیٹ کرنے اور درخواستوں کو ہدف والے ملک کے IP کے ذریعے بھیجنے کی ضرورت ہے، کیونکہ قیمتیں، فروخت کنندگان اور دستیابی ہر خطے میں مختلف ہوتی ہیں۔
- بہترین پراکسی قسم: متغیر رہائشی پراکسیز، جو حقیقی صارفین کے IPs استعمال کرتی ہیں اور شناخت سے بچ نکلتی ہیں۔
- قیمت: 1 dollar per GB سے، ادائیگی بہ استعمال، ایسی ٹریفک کے ساتھ جس کی میعاد ختم نہیں ہوتی اور بغیر سبسکرپشن۔
- کوریج: 195 ممالک میں 90M سے زائد اخلاقی طور پر حاصل کردہ IPs۔
- قابل اعتماد ہونے کی شرح: 99.51% کامیابی کی شرح، G2 پر 5 میں سے 4.8 ریٹنگ۔
- پروٹوکولز اور ہدف بندی: HTTP، HTTPS اور SOCKS5، ملک کی ہدف بندی شامل ہے۔
آپ Google Shopping سے کون سا ڈیٹا اسکریپ کر سکتے ہیں؟
Google Shopping پروڈکٹ فہرستوں میں کئی منظم فیلڈز دکھاتا ہے جو قیمت بندی اور مارکیٹ ریسرچ کے لیے مفید ہیں۔ ہر نتیجے میں عموماً صفات کا ایک یکساں مجموعہ ہوتا ہے جسے آپ نکال کر قطاروں میں معیاری بنا سکتے ہیں۔
- پروڈکٹ کی تفصیلات: عنوان، تفصیل کا اقتباس، برانڈ، ماڈل اور پروڈکٹ تصویر کا URL۔
- قیمت: درج قیمت، کرنسی، اور بعض اوقات مختلف فروخت کنندگان کی قیمتوں کی حد۔
- فروخت کنندہ: تاجر کا نام اور پروڈکٹ کی تفصیل کے صفحے پر اسی چیز کو پیش کرنے والے مسابقتی فروخت کنندگان کی فہرست۔
- ریٹنگز اور جائزے: جہاں موجود ہوں، مجموعی ستارہ ریٹنگ اور جائزوں کی تعداد۔
- دستیابی اور شپنگ: اسٹاک کی حالت اور شپنگ نوٹس جو خطے کے لحاظ سے بدلتے ہیں۔
جب بھی Google اپنا لے آؤٹ اپ ڈیٹ کرتا ہے، درست فیلڈز بدل جاتے ہیں، اس لیے کسی بھی پارسر کو غائب اقدار اور بدلتے مارک اپ کو برداشت کرنا چاہیے۔ ہر فیلڈ کو اختیاری سمجھیں اور یہ ماننے کے بجائے کہ ریٹنگ یا فروخت کنندہ ہمیشہ موجود ہوگا، نکالنے کے بعد اقسام کی توثیق کریں۔ چونکہ ایک ہی پروڈکٹ مختلف ممالک میں مختلف قیمتوں پر ظاہر ہو سکتا ہے، اس لیے بعد میں جغرافیہ شامل کرنے کے بجائے ابتدا ہی سے اپنی اسکیما کو (product, country, timestamp) کلید کے گرد بنائیں۔
آپ Google Shopping کو جغرافیائی ہدف والی درخواست کیسے بھیجتے ہیں؟
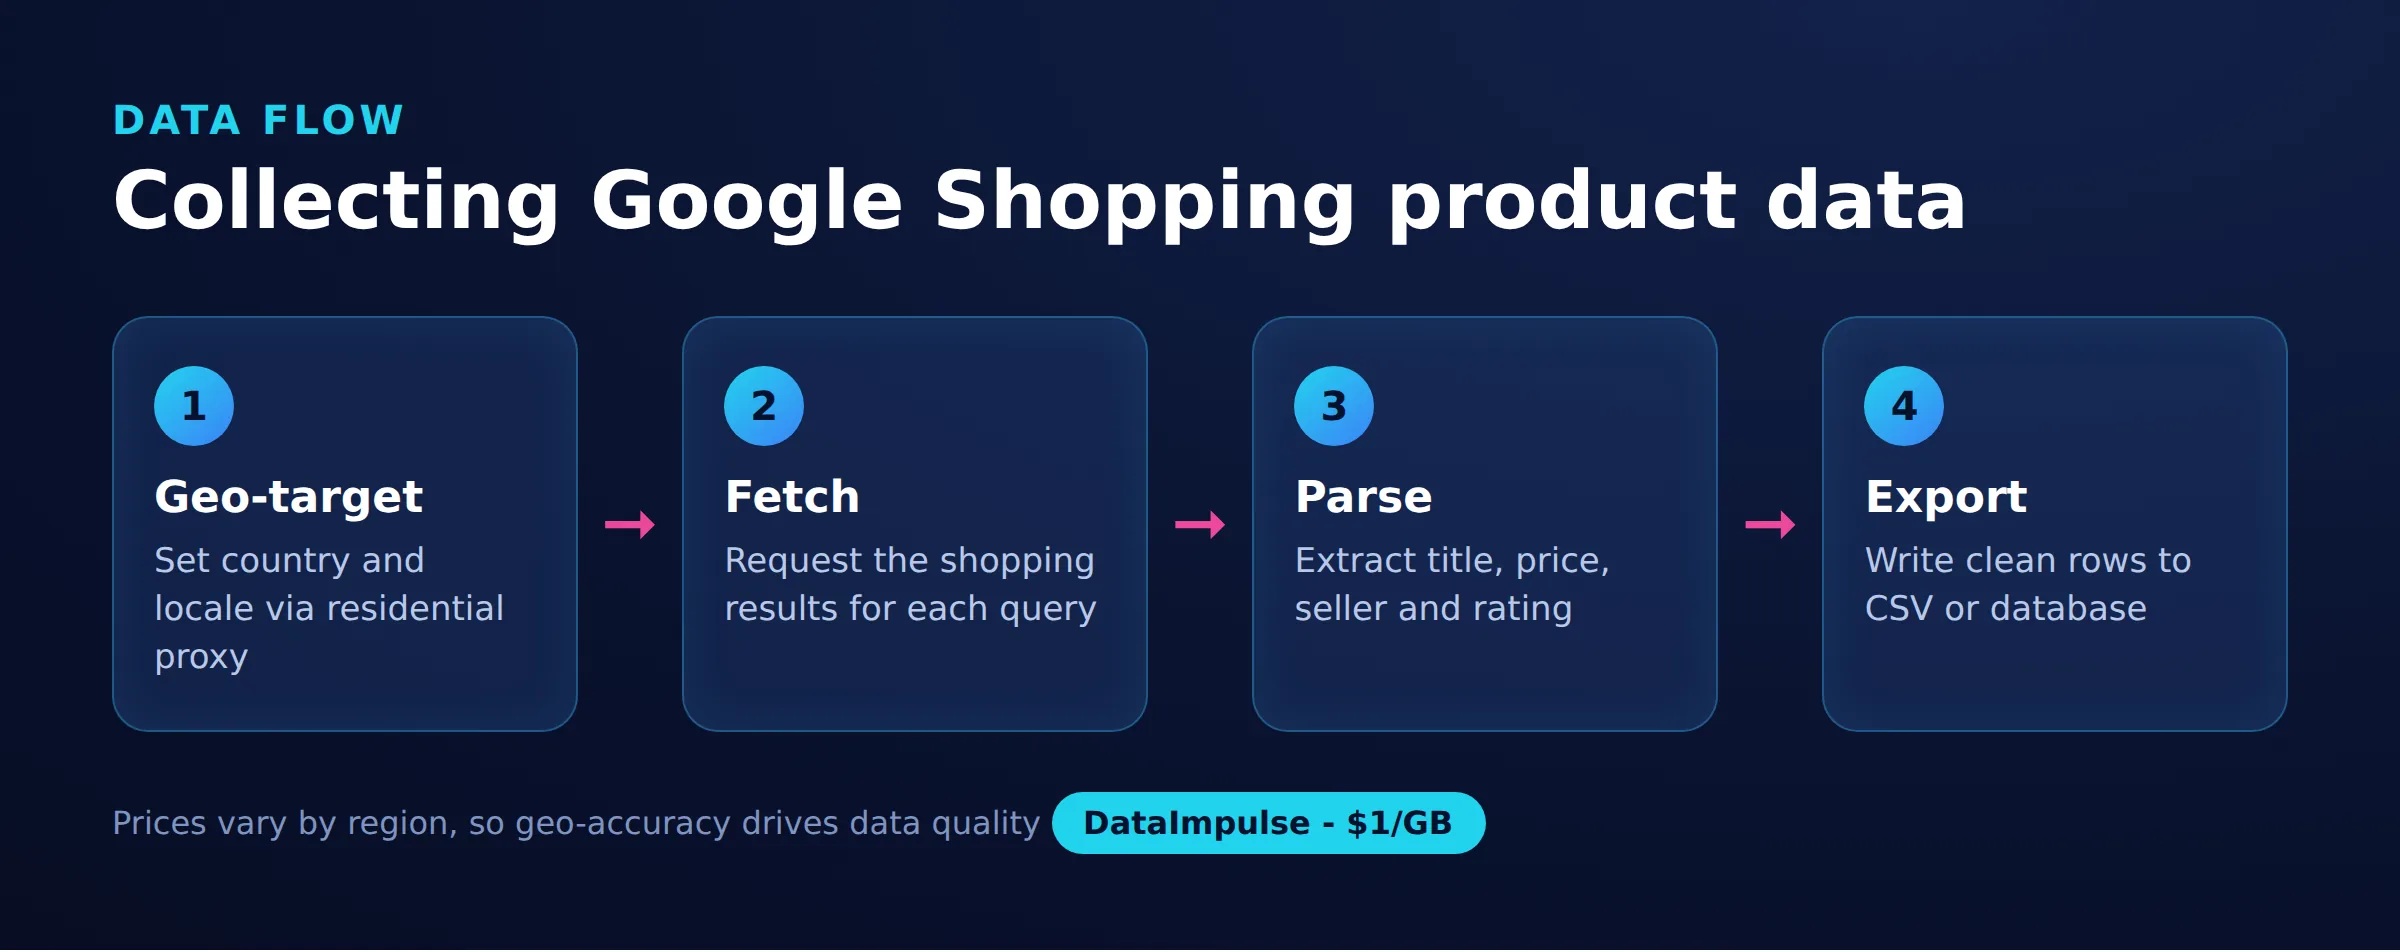
آپ Google کے سرچ اینڈ پوائنٹ کو شاپنگ ٹیب فلیگ اور لوکیل پیرامیٹرز کے ساتھ استعمال کر کے جغرافیائی ہدف والی درخواست بھیجتے ہیں، پھر انہی IP اور پیرامیٹر سگنلز کو استعمال کرتے ہیں جو حقیقی خریدار بھیجتا ہے۔ سب سے اہم دو پیرامیٹرز یہ ہیں gl (ملک، مثال کے طور پر gl=de جرمنی کے لیے) اور hl (انٹرفیس کی زبان، مثال کے طور پر hl=de)۔ تیسرا مفید پیرامیٹر locationطرز کی اصطلاح ہے جسے آپ کوئری کے سیاق میں شامل کرتے ہیں، مگر gl اور اس سے مطابقت رکھنے والا ایگزٹ IP زیادہ تر کام کر دیتا ہے۔
صرف پیرامیٹرز سیٹ کرنا کافی نہیں، کیونکہ Google یہ طے کرنے کے لیے درخواست کا IP بھی پڑھتا ہے کہ کون سی قیمتیں اور فروخت کنندگان دکھانے ہیں۔ نیچے دی گئی کم سے کم درخواست حقیقی جیسے ہیڈرز اور لوکیل جوڑا بھیجتی ہے۔ اسے جان بوجھ کر بغیر پراکسی رکھا گیا ہے تاکہ آپ IP تہہ شامل کرنے سے پہلے بنیادی کال دیکھ سکیں۔
import requests

def build_params(query, country="us", lang="en", start=0):
    return {
        "q": query,
        "tbm": "shop",   # shopping vertical
        "gl": country,    # country bias, e.g. de, gb, fr
        "hl": lang,       # interface language
        "num": 40,        # results per page (soft cap)
        "start": start,   # pagination offset
    }

HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0 Safari/537.36"
    ),
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="us", lang="en"),
    headers=HEADERS,
    timeout=30,
)
print(resp.status_code, len(resp.text))
Accept-Language ہیڈر کو اس کے مطابق رکھیں۔ hl جرمن قیمت کا صفحہ اگر انگریزی زبان کے ہیڈر کے ساتھ مانگا جائے تو یہ عدم مطابقت غیر فطری بھی لگتی ہے اور غلط کرنسی بھی لوٹا سکتی ہے۔ جب آپ پیمانہ بڑھاتے ہیں تو یہی بنیادی فنکشن لوکیل طے کرنے کی واحد جگہ بن جاتا ہے، جس سے ہر بعد کی کال یکساں رہتی ہے۔
آپ ملک ہدف والی پراکسیز کے ذریعے درخواستوں کی روٹنگ کیسے کرتے ہیں؟
آپ ملک ہدف والی پراکسی کے ذریعے requests کو ایک گیٹ وے کی طرف کر کے اور پراکسی صارف نام میں ہدف ملک کو انکوڈ کر کے روٹنگ کرتے ہیں۔ DataImpulse کے ساتھ گیٹ وے gw.dataimpulse.com:823ہے، اور __cr.us یا __cr.de کو اپنے صارف نام کے آخر میں لگانے سے ایگزٹ ملک منتخب ہوتا ہے۔ ملک کی ہدف بندی بنیادی قیمت میں شامل ہے، جبکہ ریاست، شہر، ZIP اور ASN کی ہدف بندی بامعاوضہ اضافے ہیں۔ اگر پراکسی توثیق آپ کے لیے نئی ہے تو پراکسی توثیق پر ہماری گائیڈ صارف نام اور پاس ورڈ کے طریقہ کار کو تفصیل سے بیان کرتی ہے۔
import requests

USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

def proxy_for(country):
    # __cr. pins the exit IP to that country
    cred = f"{USER}__cr.{country}:{PASS}"
    url = f"http://{cred}@{GATEWAY}"
    return {"http": url, "https": url}

resp = requests.get(
    "https://www.google.com/search",
    params=build_params("wireless headphones", country="de", lang="de"),
    headers=HEADERS,
    proxies=proxy_for("de"),
    timeout=30,
)
print(resp.status_code, len(resp.text))
اہم اصول یہ ہے کہ پراکسی ملک اور gl/hl جوڑے کو اکٹھا تبدیل کریں۔ مختلف مارکیٹوں کی قیمت کا موازنہ بنانے کے لیے ممالک کی فہرست پر لوپ چلائیں اور ایگزٹ IP اور لوکیل کو مکمل ہم آہنگ رکھیں، تاکہ ہر جواب ایک ہی، یکساں خریدار کے مقام کی عکاسی کرے۔
MARKETS = [
    {"country": "us", "lang": "en"},
    {"country": "de", "lang": "de"},
    {"country": "gb", "lang": "en"},
    {"country": "fr", "lang": "fr"},
]

def fetch_market(query, market):
    c, lang = market["country"], market["lang"]
    return requests.get(
        "https://www.google.com/search",
        params=build_params(query, country=c, lang=lang),
        headers={**HEADERS, "Accept-Language": f"{lang};q=0.9"},
        proxies=proxy_for(c),
        timeout=30,
    )

for m in MARKETS:
    r = fetch_market("wireless headphones", m)
    print(m["country"], r.status_code, len(r.text))
DataImpulse IP تہہ فراہم کرتا ہے، منظم اسکریپنگ سروس نہیں، اس لیے اسکریپر خود آپ کی ذمہ داری ہے۔ متغیر رہائشی پراکسیز یہاں عموماً موزوں ہیں کیونکہ یہ حقیقی صارفین کے آلات سے آتی ہیں؛ ڈیٹا سینٹر پراکسیز کم قیمت مگر نشان زد کرنا آسان ہیں، اور موبائل پراکسیز مشکل ترین اہداف کے لیے کیریئر گریڈ IPs رکھتی ہیں۔
آپ Google Shopping پروڈکٹ کارڈز کو کیسے پارس کرتے ہیں؟
آپ پروڈکٹ کارڈز کو ایک لچک دار HTML لائبریری سے پارس کرتے ہیں اور نازک گہرے سلیکٹرز کے بجائے مستحکم متنی پیٹرنز پر انحصار کرتے ہیں، کیونکہ Google کے کلاس نام مبہم ہوتے ہیں اور اکثر تبدیل ہوتے رہتے ہیں۔ آج براؤزر کے ڈیولپر ٹولز سے کاپی کیا گیا کوئی بھی سلیکٹر چند ہفتوں میں ٹوٹ سکتا ہے، اس لیے پارسر کو لے آؤٹ بدلنے پر کریش ہونے کے بجائے بتدریج ناکام ہونے کے لیے بنائیں۔
ایک مضبوط طریقہ ہر ممکنہ کارڈ کو پڑھتا ہے، ٹیگ ساخت سے عنوان اور تصویر لیتا ہے، اور کرنسی سے باخبر ریگولر ایکسپریشن سے قیمت نکالتا ہے۔ نیچے سلیکٹرز حقیقت پسندانہ مثالیں ہیں، ضمانت نہیں؛ انہیں اپ ڈیٹ کرنے کی توقع رکھیں اور regex کو اپنا قابل اعتماد متبادل رہنے دیں۔
from bs4 import BeautifulSoup
import re

# Currency-aware price matcher: symbol optional, thousands and decimals tolerated.
PRICE_RE = re.compile(r"(?:[$€£]|USD|EUR|GBP)\s?\d[\d.,]*")

def parse_cards(html):
    soup = BeautifulSoup(html, "html.parser")
    rows = []
    # These class names ROTATE; treat them as hints, keep the fallbacks.
    candidates = soup.select("div.sh-dgr__content, div.sh-dlr__list-result, div[data-docid]")
    if not candidates:
        candidates = soup.find_all("div")  # last-resort sweep
    for card in candidates:
        text = card.get_text(" ", strip=True)
        price_match = PRICE_RE.search(text)
        if not price_match or len(text) > 400:
            continue
        img = card.find("img")
        link = card.find("a", href=True)
        rows.append({
            "title": _first_text(card, ["h3", "h4"]),
            "price_raw": price_match.group(0),
            "image": img.get("src") if img else None,
            "url": link["href"] if link else None,
        })
    return rows

def _first_text(card, tags):
    for t in tags:
        el = card.find(t)
        if el and el.get_text(strip=True):
            return el.get_text(strip=True)
    return None

CURRENCY = {"$": "USD", "€": "EUR", "£": "GBP"}

def normalize_price(raw):
    if not raw:
        return None, None
    symbol = next((s for s in CURRENCY if s in raw), None)
    code = CURRENCY.get(symbol, "USD")
    digits = re.sub(r"[^\d.,]", "", raw).replace(",", "")
    try:
        return float(digits), code
    except ValueError:
        return None, code
چونکہ یہاں مبہم مارک اپ معمول ہے، بعض ٹیمیں اس کے بجائے رینڈر شدہ DOM استعمال کرتی ہیں۔ جامد HTML اور رینڈر شدہ صفحات کی پارسنگ کے وسیع تر توازن کے لیے ہماری گائیڈ دیکھیں متحرک ویب صفحات کی اسکریپنگ.
جب Google 429 لوٹائے تو آپ صفحہ بندی اور بیک آف کیسے کرتے ہیں؟
آپ start آف سیٹ کو اپنے صفحے کے سائز کے مطابق مرحلوں میں آگے بڑھاتے ہیں، اور HTTP 429 (اور خالی یا CAPTCHA جوابات) کو انتظار کرنے اور نئے IP کے ذریعے دوبارہ کوشش کے سگنل کے طور پر لے کر شرح کی حدود سے نمٹتے ہیں۔ Google بار بار کی خودکار درخواستوں کو سختی سے محدود کرتا ہے، اس لیے صفحہ بندی اور بیک آف ایک ہی لوپ میں ہونے چاہئیں۔
صفحات پر تب تک چلیں جب تک درخواست کوئی کارڈ نہ لوٹائے یا آپ صفحہ حد تک نہ پہنچ جائیں۔ پراکسی dict کو دوبارہ پڑھ کر صفحات کے درمیان ایگزٹ IP تبدیل کریں، اور صرف اسٹیٹس کوڈ پر بھروسا کرنے کے بجائے باڈی میں رضامندی یا CAPTCHA نشانیاں دیکھ کر نرم بلاکس شناخت کریں۔
BLOCK_MARKERS = ("unusual traffic", "/sorry/", "consent.google", "captcha")

def is_blocked(resp):
    if resp.status_code in (429, 503):
        return True
    body = resp.text.lower()
    return any(m in body for m in BLOCK_MARKERS)

def paginate(query, market, max_pages=5, page_size=40):
    all_rows = []
    for page in range(max_pages):
        params = build_params(query, market["country"], market["lang"],
                              start=page * page_size)
        resp = get_with_retry(
            "https://www.google.com/search",
            params=params, proxies=proxy_for(market["country"]),
        )
        if resp is None:
            break
        rows = parse_cards(resp.text)
        if not rows:
            break  # no more results
        all_rows.extend(rows)
    return all_rows
نیچے کا دوبارہ کوشش معاون jitter کے ساتھ ایکسپونینشل بیک آف استعمال کرتا ہے، جس سے کوششیں پھیل جاتی ہیں اور بلاک ہونے والے ورکرز کا جھرمٹ ایک ہی لمحے میں دوبارہ کوشش نہیں کرتا۔ ہر کوشش پراکسی dict کو دوبارہ لیتی ہے، لہٰذا متغیر پول اگلی کوشش میں آپ کو نیا IP دیتا ہے۔
import time, random

def get_with_retry(url, params, proxies, max_attempts=4):
    for attempt in range(max_attempts):
        try:
            resp = requests.get(url, params=params, headers=HEADERS,
                                proxies=proxies, timeout=30)
        except requests.RequestException:
            resp = None
        if resp is not None and not is_blocked(resp):
            return resp
        # exponential backoff: 2, 4, 8 seconds, plus jitter
        wait = (2 ** (attempt + 1)) + random.uniform(0, 1.5)
        time.sleep(wait)
    return None  # exhausted; caller decides what to do
درخواست کی شرح مناسب رکھیں، خواہ دوبارہ کوششیں کامیاب ہوں۔ صفحات کے درمیان شائستہ بنیادی تاخیر، متغیر عمل کے ساتھ مل کر، مسلسل درخواستیں مارنے اور دوبارہ کوششوں پر انحصار سے کہیں زیادہ طویل مدتی استحکام دیتی ہے۔ ویب اسکریپنگ کے بہترین طریقے درخواست کی رفتار اور ہیڈر کی صفائی کو مزید تفصیل سے بیان کرتے ہیں۔
آپ ہیڈلیس براؤزر سے بلاک شدہ صفحات کو کیسے رینڈر کرتے ہیں؟
جب سادہ HTTP درخواست بار بار رضامندی کی دیواروں یا JavaScript سے رینڈر شدہ مواد سے ٹکراتی ہے تو ایسے ہیڈلیس براؤزر کو متبادل بنائیں جو صفحہ حقیقی کلائنٹ کی طرح چلاتا ہے، اور DOM پڑھنے سے پہلے رضامندی ڈائیلاگ بند کر دیں۔ Playwright موزوں ہے کیونکہ یہ ہر context کے لیے پراکسیز اور قابل اعتماد انتظار کی معاونت کرتا ہے۔
نیچے اسکرپٹ ملک ہدف والی DataImpulse پراکسی کے ذریعے Chromium لانچ کرتا ہے، اس کوکی یا رضامندی ڈائیلاگ کو سنبھالتا ہے جو یورپی لوکیل عموماً دکھاتے ہیں، مواد کا انتظار کرتا ہے، اور رینڈر شدہ HTML لوٹاتا ہے تاکہ آپ اسے اسی parse_cards function.
from playwright.sync_api import sync_playwright

def render_shopping(query, country="de", lang="de"):
    cred_user = f"{USER}__cr.{country}"
    params = f"?q={query.replace(' ', '+')}&tbm=shop&gl={country}&hl={lang}"
    url = "https://www.google.com/search" + params
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True)
        context = browser.new_context(
            proxy={
                "server": "http://gw.dataimpulse.com:823",
                "username": cred_user,
                "password": PASS,
            },
            locale=f"{lang}-{country.upper()}",
            user_agent=HEADERS["User-Agent"],
        )
        page = context.new_page()
        page.goto(url, wait_until="domcontentloaded", timeout=45000)
        _dismiss_consent(page)
        page.wait_for_timeout(2000)
        html = page.content()
        browser.close()
        return html

def _dismiss_consent(page):
    # Consent dialogs vary by locale; try a few common accept buttons.
    for label in ("Accept all", "Alle akzeptieren", "Tout accepter",
                  "I agree", "Accept"):
        try:
            btn = page.get_by_role("button", name=label)
            if btn.count() > 0:
                btn.first.click(timeout=3000)
                page.wait_for_timeout(1000)
                return
        except Exception:
            continue
ہیڈلیس براؤزر خام درخواست کے مقابلے میں CPU اور میموری پر زیادہ بوجھ ڈالتا ہے، اس لیے اسے طے شدہ راستے کے بجائے ان صفحات کے لیے ہدفی متبادل کے طور پر استعمال کریں جنہیں واقعی رینڈرنگ درکار ہو۔ بہت سی ٹیمیں رفتار کے لیے براہ راست HTTP چلاتی ہیں اور صرف تب Playwright پر جاتی ہیں جب is_blocked بار بار فعال ہوتا رہے۔ اگر آپ کا اسٹیک Python کے بجائے JavaScript ہے تو Puppeteer کے ساتھ بھی یہی پیٹرن لاگو ہوتا ہے؛ دیکھیں JavaScript کے ساتھ ویب اسکریپنگ.
آپ اسکریپ شدہ ڈیٹا کو ترتیب دے کر ایکسپورٹ کیسے کرتے ہیں؟
آپ ڈیٹا کو ایک مستحکم ریکارڈ کے گرد ترتیب دیتے ہیں جس میں ہمیشہ مارکیٹ اور حصول کا ٹائم اسٹیمپ شامل ہو، پھر CSV میں ایکسپورٹ کرتے ہیں تاکہ نتیجے کا فرق دیکھنا، اسے اسپریڈشیٹ میں لوڈ کرنا یا ویئرہاؤس میں بھیجنا آسان ہو۔ dataclass آپ کو ٹائپ ہنٹس اور قطار کی ایک واضح تعریف دیتا ہے۔
from dataclasses import dataclass, asdict, field
from datetime import datetime, timezone
import csv

@dataclass
class Offer:
    query: str
    country: str
    title: str | None
    price: float | None
    currency: str | None
    seller: str | None = None
    url: str | None = None
    captured_at: str = field(
        default_factory=lambda: datetime.now(timezone.utc).isoformat()
    )

def to_offers(rows, query, country):
    offers = []
    for r in rows:
        price, currency = normalize_price(r.get("price_raw"))
        offers.append(Offer(
            query=query, country=country, title=r.get("title"),
            price=price, currency=currency, url=r.get("url"),
        ))
    return offers
اس کے بعد CSV لکھنا dataclass فیلڈز ڈمپ کرنے کا معاملہ ہے۔ append موڈ اور header-guard شیڈول شدہ کام کو فائل دوبارہ لکھے بغیر وقت کے ساتھ ایک فائل بڑھانے دیتے ہیں۔
import os

def export_csv(offers, path="google_shopping.csv"):
    if not offers:
        return
    fieldnames = list(asdict(offers[0]).keys())
    write_header = not os.path.exists(path)
    with open(path, "a", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        if write_header:
            writer.writeheader()
        for o in offers:
            writer.writerow(asdict(o))
ہر قطار پر ملک اور ٹائم اسٹیمپ رکھنے سے آپ بعد میں جواب دے سکتے ہیں کہ آج کسی SKU کے لیے کون سی مارکیٹ سب سے سستی ہے، یا اس ہفتے قیمت کیسے بدلی۔ جغرافیہ اور وقت کی یہی کلید اگلے حصے کے قیمت تاریخ ٹریکر کی بنیاد ہے۔
آپ وقت کے ساتھ Google Shopping کی قیمت کی تاریخ کیسے ٹریک کرتے ہیں؟
آپ ہر مشاہدے کو پروڈکٹ، ملک اور دن پر مبنی چھوٹے ڈیٹابیس میں upsert کر کے قیمت کی تاریخ ٹریک کرتے ہیں، اس طرح اسکریپر دوبارہ چلانے سے پچھلے دن محفوظ رہتے ہوئے آج کی قطار نقل بنانے کے بجائے اپ ڈیٹ ہوتی ہے۔ SQLite لاکھوں قطاروں کے لیے کافی ہے اور اسے سرور نہیں چاہیے، جس سے نگرانی کا کام خود کفیل رہتا ہے۔
نیچے کی اسکیما ایک مرکب منفرد کلید اور ON CONFLICT upsert۔ اسکریپر کو ایک دن میں دو بار چلانے سے اس (product, country, day) کی تازہ ترین قیمت اووررائٹ ہو جاتی ہے؛ اسے مختلف دنوں میں چلانے سے وہ ٹائم سیریز بنتی ہے جس کا آپ بعد میں چارٹ بنا سکتے ہیں۔
import sqlite3

DDL = """
CREATE TABLE IF NOT EXISTS price_history (
    product   TEXT NOT NULL,
    country   TEXT NOT NULL,
    day       TEXT NOT NULL,
    price     REAL,
    currency  TEXT,
    seller    TEXT,
    captured_at TEXT,
    PRIMARY KEY (product, country, day)
);
"""

def init_db(path="prices.db"):
    conn = sqlite3.connect(path)
    conn.execute(DDL)
    conn.commit()
    return conn

def upsert_offers(conn, offers):
    sql = """
    INSERT INTO price_history
        (product, country, day, price, currency, seller, captured_at)
    VALUES (?, ?, ?, ?, ?, ?, ?)
    ON CONFLICT(product, country, day) DO UPDATE SET
        price=excluded.price,
        currency=excluded.currency,
        seller=excluded.seller,
        captured_at=excluded.captured_at;
    """
    for o in offers:
        day = o.captured_at[:10]  # YYYY-MM-DD
        conn.execute(sql, (o.title, o.country, day, o.price,
                           o.currency, o.seller, o.captured_at))
    conn.commit()

def price_trend(conn, product, country, days=14):
    cur = conn.execute(
        """SELECT day, price, currency FROM price_history
           WHERE product = ? AND country = ?
           ORDER BY day DESC LIMIT ?""",
        (product, country, days),
    )
    return cur.fetchall()
عملی طور پر مختلف دنوں کے عنوانات ملانا مشکل حصہ ہے، کیونکہ Google کے عنوانات حصول کے درمیان معمولی فرق رکھتے ہیں۔ چھوٹی واچ لسٹ کے لیے اسکریپ شدہ عنوان کو مستحکم کلید ماننے کے بجائے upsert سے پہلے خام عنوانات کو اپنی قابو میں canonical product id سے میپ کریں۔
آپ جاری قیمت نگرانی کا شیڈول کیسے بناتے ہیں؟
آپ fetch-parse-store مراحل کو ایک انٹری پوائنٹ میں سمیٹ کر اور cron کے ساتھ مقررہ وقفے پر چلا کر نگرانی شیڈول کرتے ہیں، تاکہ قیمتیں دستی طور پر چلائے بغیر خودکار طور پر تازہ ہوں۔ قیمت ٹریکنگ کے لیے روزانہ ایک بار چلانا مناسب طے شدہ انتخاب ہے؛ زیادہ بار چلانے سے زیادہ تر کیٹلاگز کے لیے خاص اضافی اشارے کے بغیر لاگت اور بلاک کا خطرہ دونوں بڑھتے ہیں۔
# run_monitor.py
def run_once(queries):
    conn = init_db()
    for query in queries:
        for market in MARKETS:
            rows = paginate(query, market, max_pages=3)
            offers = to_offers(rows, query, market["country"])
            export_csv(offers)
            upsert_offers(conn, offers)
            print(f"{query} / {market['country']}: {len(offers)} offers")
    conn.close()

if __name__ == "__main__":
    WATCHLIST = ["wireless headphones", "mechanical keyboard"]
    run_once(WATCHLIST)
پھر اسے cron میں رجسٹر کریں۔ نیچے کا اندراج ہر روز 06:15 پر مانیٹر چلاتا ہے اور ڈیبگنگ کے لیے آؤٹ پٹ لاگ کرتا ہے، جو اس لیے اہم ہے کہ شیڈول شدہ اسکریپر ورنہ خاموشی سے ناکام ہو جاتا ہے۔
# crontab -e
# minute hour day month weekday  command
15 6 * * * cd /opt/shopping && /usr/bin/python3 run_monitor.py >> monitor.log 2>&1
کام کے اندر ہلکا jitter شامل کریں، یعنی آغاز پر چند منٹ کا بے ترتیب sleep، تاکہ درخواستیں ہر روز بالکل اسی گھڑی کے سیکنڈ پر Google تک نہ پہنچیں۔ پہلے بیان کے مطابق ایگزٹ ممالک تبدیل کریں اور درخواستوں کی رفتار رکھیں، اور بلاکس کی بڑھتی ہوئی شرح کے لیے لاگ پر نظر رکھیں، کیونکہ یہ Google کے دفاع بدلنے یا آپ کے پیٹرنز بہت باقاعدہ ہونے کی ابتدائی علامت ہے۔
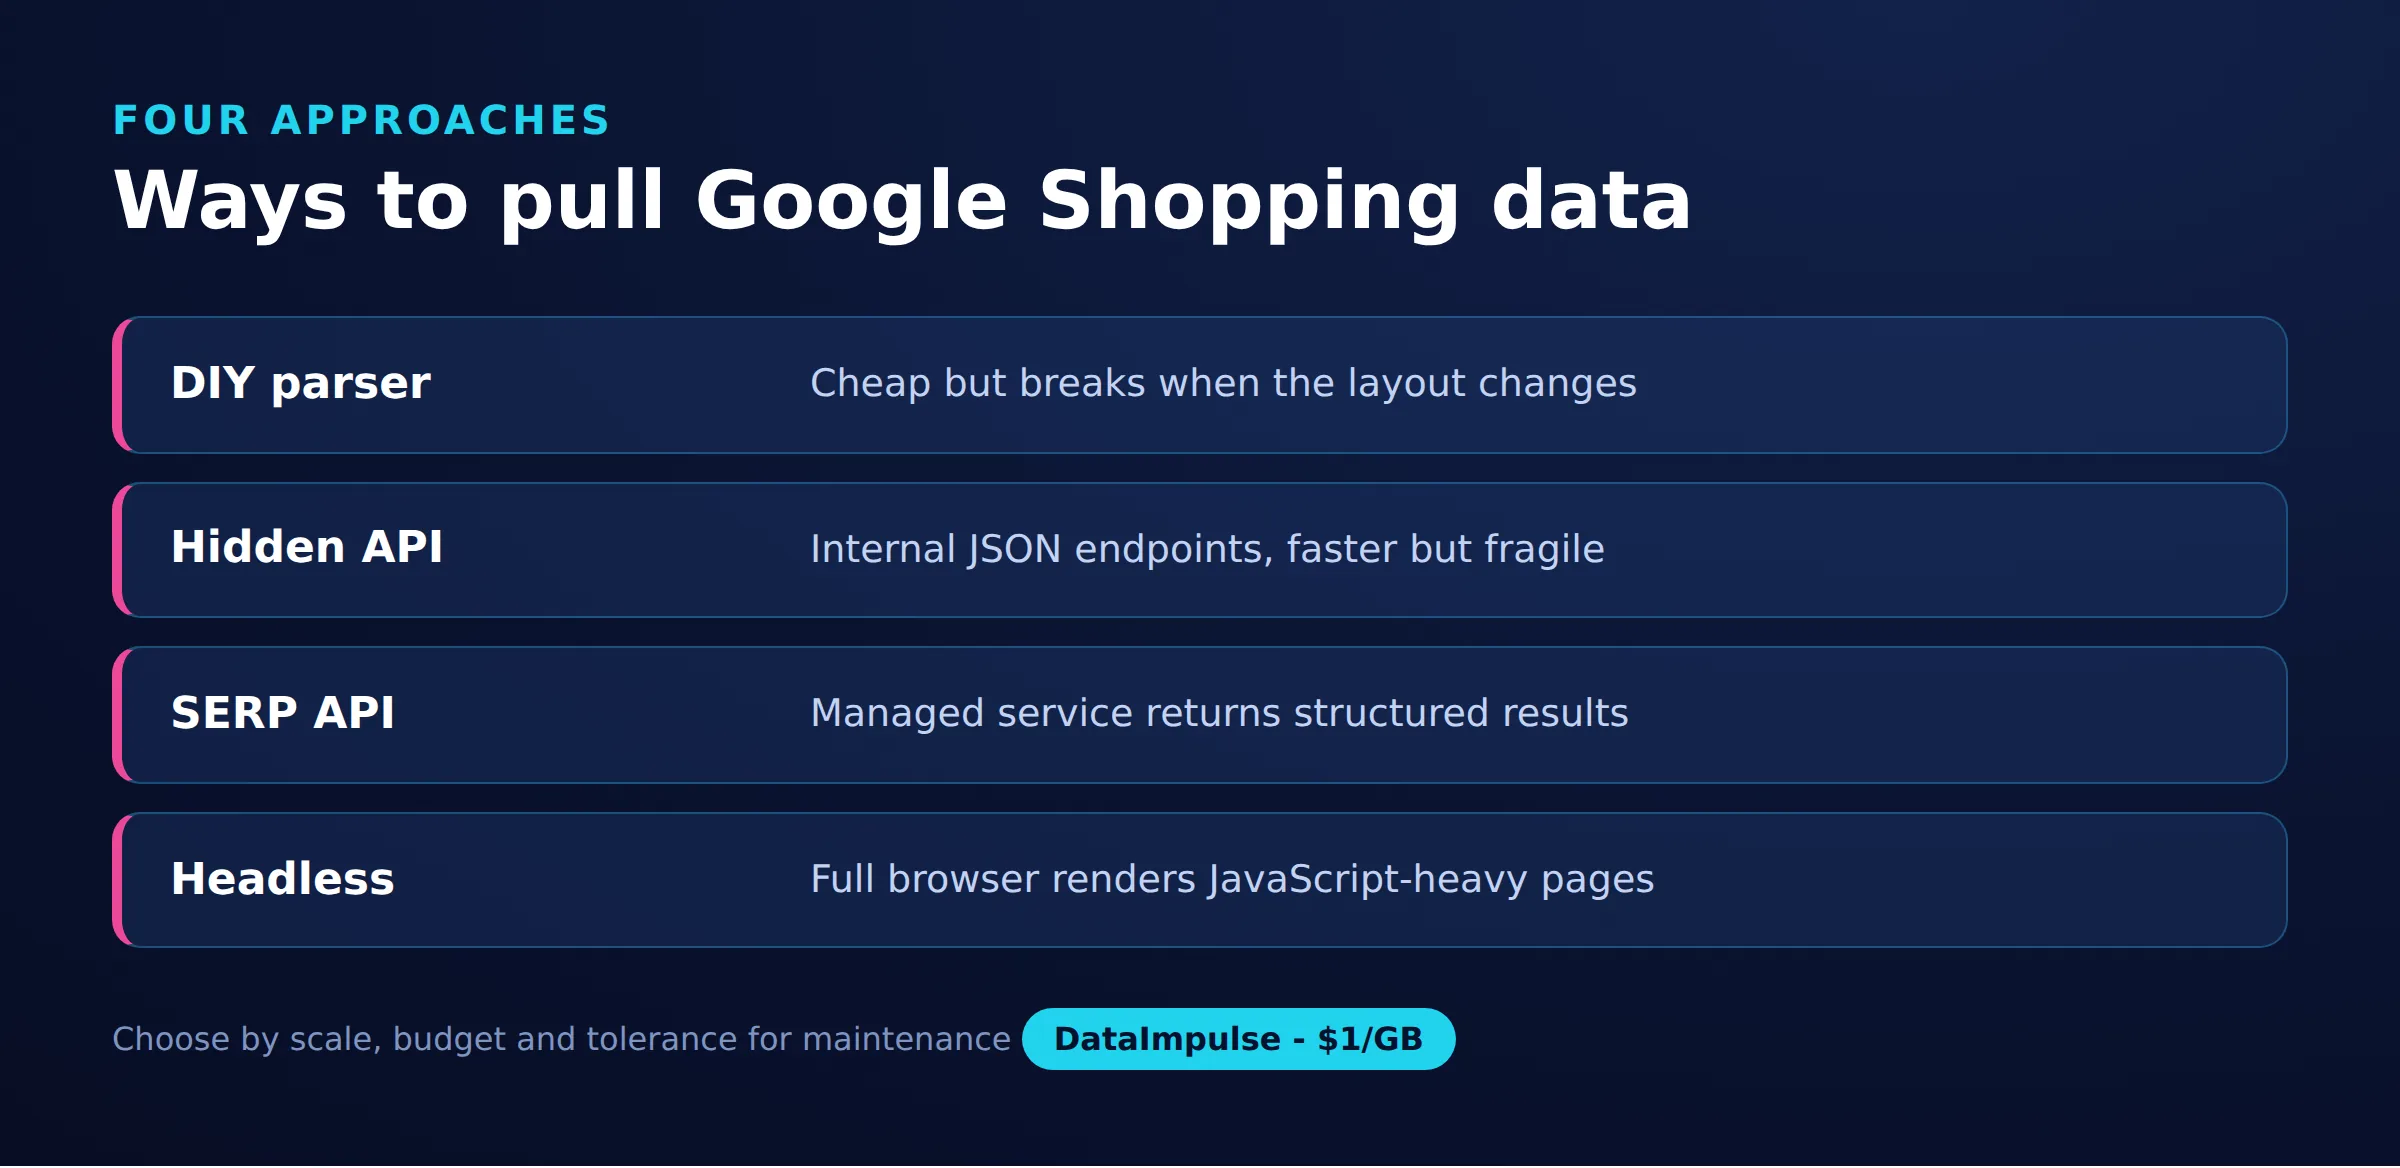
آپ کو کون سا جمع آوری طریقہ منتخب کرنا چاہیے: DIY، پوشیدہ اینڈ پوائنٹس، SERP API یا ہیڈلیس؟
اپنی پسند اس بنیاد پر کریں کہ آپ کتنی نزاکت اور انجینئرنگ کی ذمہ داری لینے، اور فی درخواست کتنی ادائیگی کرنے کو تیار ہیں۔ کوئی ایک درست جواب نہیں؛ حقیقی توازن کنٹرول اور لاگت کا، دیکھ بھال کے بوجھ اور اینٹی بوٹ خطرے کے مقابل ہے۔
اینٹی بوٹ حقیقت: Google شرح کی حد، CAPTCHAs، رضامندی کی دیواروں، متغیر مبہم مارک اپ اور رویہ جاتی سگنلز سے ان نتائج کا فعال دفاع کرتا ہے۔ ہر خود بنایا اسکریپر وقفے وقفے سے ٹوٹے گا اور مسلسل دیکھ بھال چاہے گا۔ پراکسیز اور بیک آف بلاکس کم کرتے ہیں، ختم نہیں کرتے۔ مستقل طور پر ان بلاک رہنے والے Google اسکریپر کا وعدہ کرنے والا شخص مبالغہ کر رہا ہے۔
| طریقہ | لاگت | نزاکت | کنٹرول |
|---|---|---|---|
| DIY HTML پارسنگ | کم (صرف پراکسی) | زیادہ | مکمل |
| پوشیدہ JSON اینڈ پوائنٹس | کم (صرف پراکسی) | بہت زیادہ | مکمل |
| SERP API | زیادہ (per request) | Low | محدود |
| ہیڈلیس براؤزر | درمیانی (کمپیوٹ + پراکسی) | درمیانی | مکمل |
SERP API بمقابلہ DIY: فریق ثالث SERP API اسکریپ شدہ شاپنگ نتائج JSON کے طور پر لوٹاتی ہے اور فی درخواست قیمت، وینڈر لاک اِن اور بالکل کیا حاصل کیا جائے اس پر کم کنٹرول کے بدلے آپ کے لیے پارسنگ اور ان بلاکنگ کا کام سنبھال لیتی ہے۔ پراکسیز پر خود بنایا اسکریپر فی درخواست بہت کم خرچ ہوتا ہے اور مکمل کنٹرول دیتا ہے، مگر Google کے بدلنے پر پارسر، دوبارہ کوششیں اور دیکھ بھال آپ کی ذمہ داری ہیں۔ DataImpulse کے مقام کو واضح کرنے کے لیے: یہ ان DIY طریقوں کے نیچے پراکسی تہہ ہے، نہ کہ SERP API اور نہ منظم اسکریپنگ سروس۔ اگر آپ پارسنگ کا بالکل کام نہیں چاہتے تو SERP API دیانت دارانہ سفارش ہے؛ اگر آپ کم لاگت اور کنٹرول چاہتے ہیں اور اسکریپر برقرار رکھ سکتے ہیں تو متغیر پراکسیز پر DIY معاشی طور پر بہتر ہے۔ پوشیدہ JSON اینڈ پوائنٹس اس سے بھی سستے ہو سکتے ہیں مگر سب سے زیادہ نازک ہیں، کیونکہ Google انہیں بغیر اطلاع بدل یا ہٹا سکتا ہے۔
کیا Google Shopping کو اسکریپ کرنا جائز اور اخلاقی ہے؟
عوامی طور پر نظر آنے والا پروڈکٹ ڈیٹا اسکریپ کرنا عموماً نجی یا محدود مواد تک رسائی کے مقابلے میں کم خطرہ سمجھا جاتا ہے، مگر یہ قواعد سے آزاد نہیں، اور یہ قانونی مشورہ نہیں ہے۔ Google Shopping پر قیمتیں اور فہرستیں عوامی ہیں، پھر بھی انہیں جمع کرنے اور استعمال کرنے کا طریقہ اہم ہے، اور آپ کو اپنا مخصوص معاملہ اہل قانونی مشیر سے جانچنا چاہیے۔
- سروس کی شرائط: خودکار رسائی Google کی شرائط سے متصادم ہو سکتی ہے، جو کاپی رائٹ یا کمپیوٹر تک رسائی کے قانون سے الگ معاہداتی معاملہ ہے۔
- ذاتی ڈیٹا: پروڈکٹ فہرستیں عموماً ذاتی ڈیٹا نہیں ہوتیں، مگر جائزہ دینے والوں کے نام یا دیگر شناخت کنندگان جمع کرنے سے گریز کریں، اور جہاں لاگو ہو GDPR کی پیروی کریں۔
- شرح اور بوجھ: درخواستوں کا حجم مناسب رکھیں تاکہ آپ جس سروس سے استفسار کر رہے ہیں اسے متاثر نہ کریں۔
- ڈیٹا کا استعمال: کاپی رائٹ شدہ تصاویر یا تفصیلات کو مکمل طور پر دوبارہ استعمال کرنا، قیمتوں کو حقائق کے طور پر تجزیہ کرنے کے مقابلے میں زیادہ خطرہ رکھتا ہے۔
جمع آوری کے پہلو سے اخلاقیات آپ کے استعمال کردہ IPs سے شروع ہوتی ہیں۔ DataImpulse اپنے IPs ان صارفین سے حاصل کرتا ہے جو رضامندی دیتے اور معاوضہ پاتے ہیں، GDPR سے ہم آہنگ ہے، اور ڈیٹا پراسیسنگ معاہدہ پیش کرتا ہے، جو قابل دفاع پائپ لائن کی معاونت کرتا ہے۔ رضامندی، حصول اور ذمہ دارانہ عمل کی مزید تفصیل کے لیے ہماری گائیڈ دیکھیں اخلاقی ویب اسکریپنگ۔ ایک اخلاقی IP ذریعے کو شائستہ رفتار اور ڈیٹا کے محدود، حقائق پر مبنی استعمال کے ساتھ ملائیں تو قانونی اور ساکھ، دونوں کے خطرات کم رہتے ہیں۔
اکثر پوچھے جانے والے سوالات
کیا مجھے Google Shopping کو اسکریپ کرنے کے لیے رہائشی پراکسیز درکار ہیں؟
رہائشی پراکسیز سب سے قابل اعتماد انتخاب ہیں کیونکہ یہ حقیقی صارفین کے IPs استعمال کرتی ہیں جو عام ٹریفک میں گھل مل جاتے ہیں۔ ڈیٹا سینٹر پراکسیز کم حجم کے لیے کام کر سکتی ہیں مگر انہیں زیادہ آسانی سے شناخت اور بلاک کیا جاتا ہے۔
میں Google Shopping سے مقامی قیمتیں کیسے حاصل کروں؟
gl اور hl پیرامیٹرز کو ہدف ملک اور زبان پر سیٹ کریں، اور درخواست کو اسی ملک کے پراکسی IP کے ذریعے ملک کی syntax استعمال کر کے بھیجیں، مثلاً جرمنی کے لیے ایسا صارف نام جس کا اختتام __cr.de پر ہو۔ Google قیمتیں طے کرنے کے لیے پیرامیٹرز اور درخواست IP دونوں پڑھتا ہے۔
کیا DataImpulse، Google Shopping اسکریپنگ API ہے؟
نہیں۔ DataImpulse پراکسی تہہ، یعنی رہائشی، موبائل اور ڈیٹا سینٹر IPs فراہم کرتا ہے، منظم اسکریپنگ یا SERP API نہیں۔ آپ اس کے IPs پر اپنا اسکریپر یا فریق ثالث کا ٹول چلاتے ہیں۔
میرا Google Shopping اسکریپر بار بار بلاک کیوں ہوتا ہے؟
Google ایک IP سے بار بار آنے والی خودکار درخواستوں کی رفتار محدود کرتا ہے اور CAPTCHAs اور رضامندی کی دیواریں دکھاتا ہے۔ متغیر رہائشی پراکسیز، حقیقی جیسے ہیڈرز، 429 جوابات پر ایکسپونینشل بیک آف، اور مناسب درخواست شرح بلاکس کو نمایاں طور پر کم کرتے ہیں، اگرچہ کوئی طریقہ انہیں مکمل طور پر ختم نہیں کرتا۔
کیا مجھے SERP API استعمال کرنی چاہیے یا اپنا اسکریپر بنانا چاہیے؟
SERP API زیادہ فی درخواست لاگت اور کم کنٹرول کے بدلے پارسنگ اور ان بلاکنگ کا کام ہٹا دیتی ہے، جو ایسی ٹیموں کے لیے موزوں ہے جو بالکل دیکھ بھال نہیں چاہتیں۔ متغیر پراکسیز پر خود بنایا اسکریپر بہت کم لاگت والا اور مکمل کنٹرول دیتا ہے، مگر Google کے بدلنے پر آپ پارسر اور دوبارہ کوششوں کو برقرار رکھتے ہیں۔
DataImpulse کب درست انتخاب نہیں ہے؟
اگر آپ کو جامد ISP پراکسیز، مکمل منظم اسکریپنگ API، یا بینکنگ اور سرکاری سائٹس تک رسائی درکار ہے تو DataImpulse درست ٹول نہیں ہے۔ یہ عوامی ڈیٹا جمع کرنے اور مواد تک رسائی کے لیے متغیر رہائشی، موبائل اور ڈیٹا سینٹر پراکسیز پر توجہ دیتا ہے۔
قابل اعتماد پراکسیز کے ساتھ Google Shopping اسکریپ کرنا شروع کریں
اگر آپ مختلف مارکیٹوں سے Google Shopping ڈیٹا جمع کرنے کے لیے تیار ہیں تو DataImpulse آپ کو ملک کی ہدف بندی کے ساتھ متغیر اور سٹکی رہائشی، موبائل اور ڈیٹا سینٹر IPs دیتا ہے، جو 1 dollar per GB سے شروع ہوتے ہیں۔ اکاؤنٹ بنائیں اور اپنے پہلے اسکریپر کو صاف IP پول کے ذریعے روٹ کریں۔