
In this Article
Aprender a extraer imágenes de un sitio web implica resolver dos problemas: encontrar dónde vive cada origen de imagen en el HTML y luego descargar los archivos binarios que hay detrás de esas URL. Esta guía recorre ambos pasos con código Python funcional, cubre los casos difíciles como la selección de srcset, el lazy-loading y los fondos CSS, y explica cómo mantenerte del lado correcto de los derechos de autor y de los límites de ancho de banda.
Las imágenes pesan más que el texto, así que recopilarlas a escala necesita un plan de almacenamiento, deduplicación, concurrencia y coste de red. Todo lo que sigue se puede ejecutar con requests, BeautifulSoup y Playwright, y las técnicas sirven tanto para una única galería como para un catálogo grande.
DataImpulse es un proveedor de proxy ético que ofrece más de 90 millones de direcciones IP residenciales, móviles y de datacenter en 195 países. Utiliza un modelo de pago por uso desde 1 dólar por GB con tráfico que no caduca, y se usa para web scraping, verificación de anuncios, monitorización de precios, investigación de mercado y gestión de múltiples cuentas.
Datos clave
- Punto clave: para extraer imágenes de un sitio web primero debes extraer cada origen (img src, srcset, atributos data de lazy-load, fondos CSS y JSON-LD) y luego descargar los archivos binarios, porque el marcado y los archivos de imagen reales son peticiones separadas.
- Mejor tipo de proxy: proxies residenciales rotativos, que usan IP reales de consumidores que superan la detección.
- Precio: desde 1 dólar por GB, pago por uso, con tráfico que no caduca y sin suscripción.
- Cobertura: más de 90M de IP de origen ético en 195 países.
- Fiabilidad: 99,51% de tasa de éxito, valorado con 4,8 sobre 5 en G2.
- Protocolos y segmentación: HTTP, HTTPS y SOCKS5, con segmentación por país incluida.
¿Dónde viven las URL de imagen en una página web?
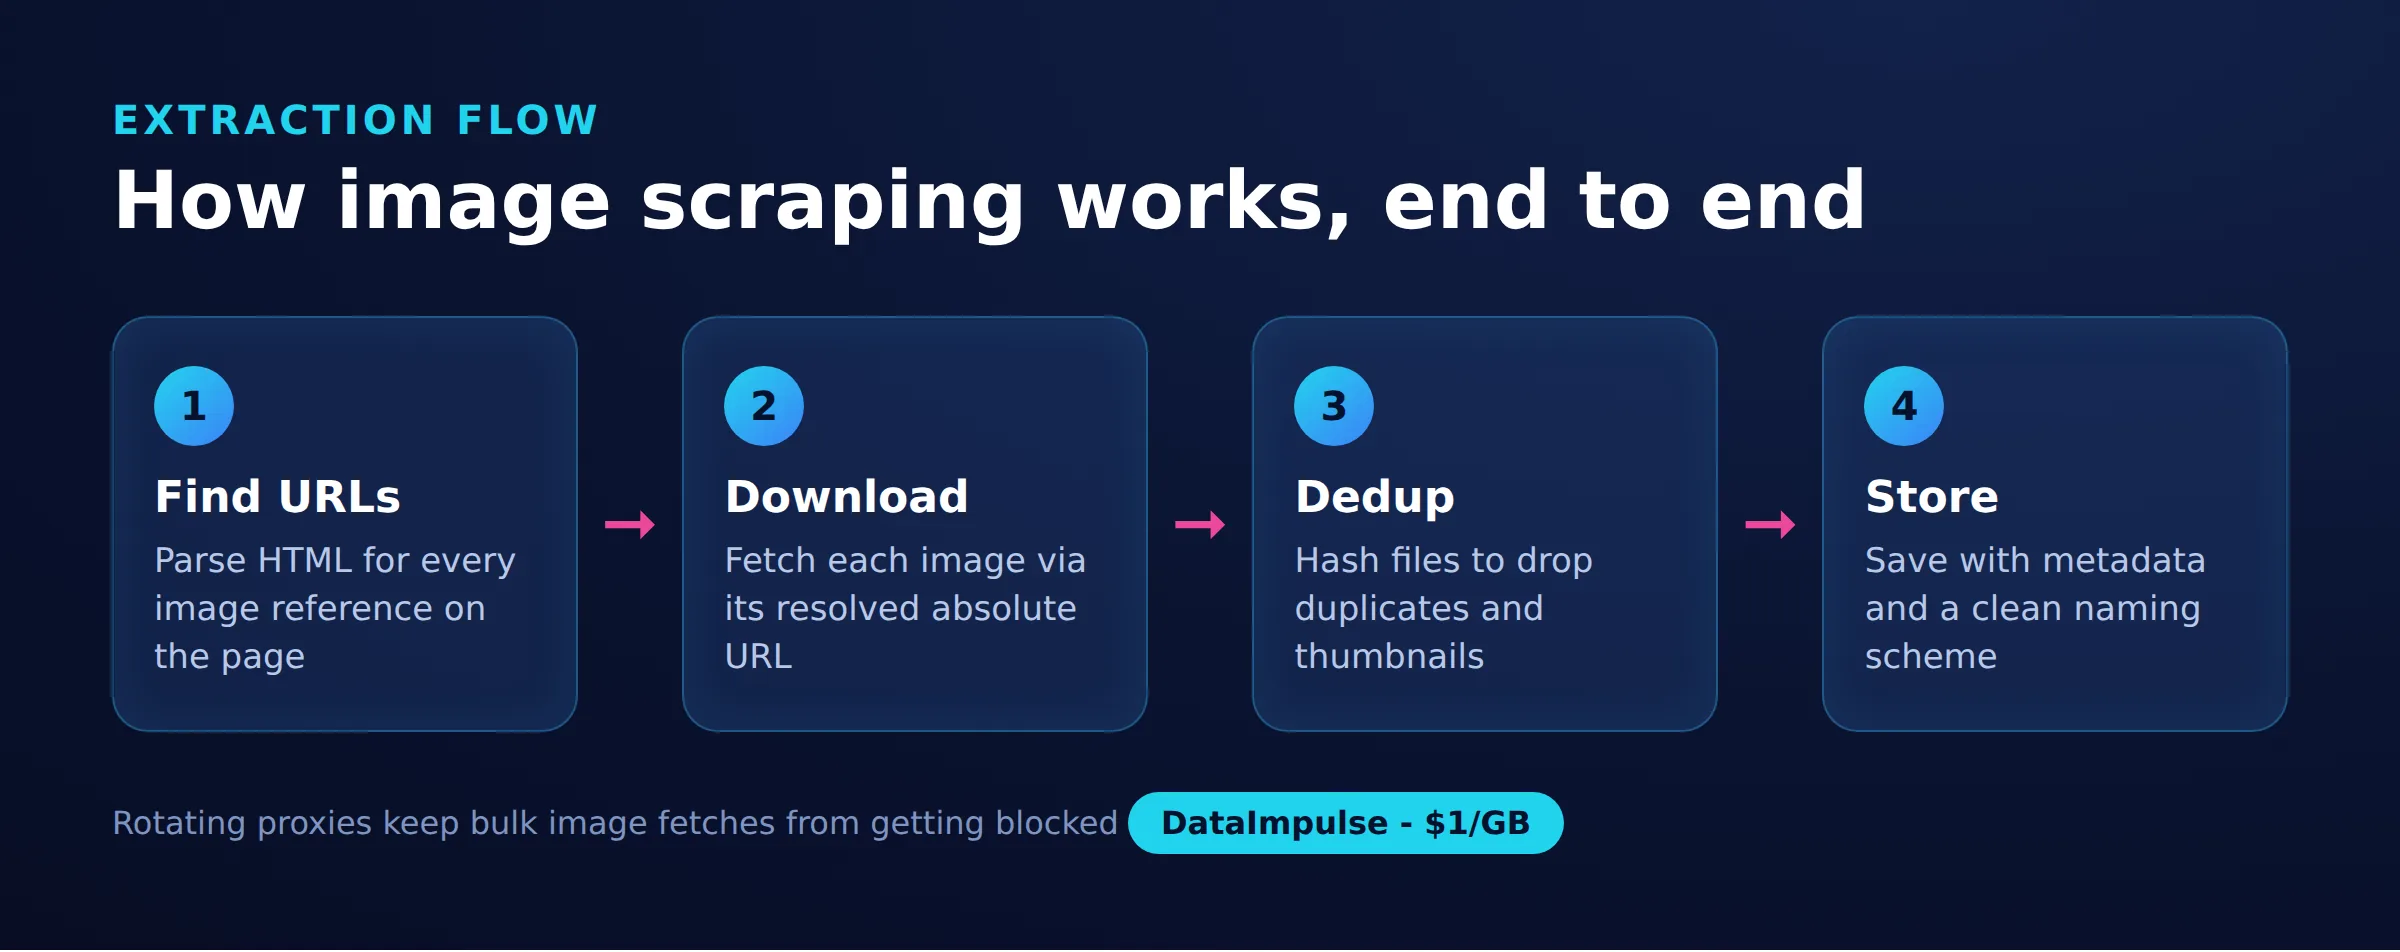
Las URL de imagen se almacenan en varios sitios, no solo en el atributo src, así que un scraper fiable revisa cada uno. Una página puede referenciar la misma imagen mediante etiquetas estándar, atributos responsive, marcadores de lazy-loading, hojas de estilo y datos estructurados.
- Imágenes estándar: el atributo
srcde una etiqueta<img>contiene la URL directa. - Imágenes responsive: el atributo
srcseten<img>y<source>lista varias URL con descriptores de anchura o densidad, dejando que el navegador elija un tamaño. - Imágenes con lazy-loading: el
srcvisible suele ser un marcador diminuto, mientras que la URL real está endata-src,data-originalo un atributo personalizado similar hasta que el usuario hace scroll. - Fondos CSS: las imágenes decorativas se definen con
background-image: url(...)en estilos en línea u hojas de estilo, y nunca aparecen en una etiqueta<img>. - Datos estructurados: las páginas de producto y de artículo suelen indicar una imagen canónica de alta resolución en un bloque JSON-LD.
Por esta dispersión, trata la página como un conjunto de orígenes candidatos y recopila de todas estas ubicaciones antes de descargar. La tabla siguiente resume dónde vive cada origen y el detalle que hace tropezar a la mayoría de los scrapers.
| Origen de extracción | Dónde encontrarlo | Escollo habitual |
|---|---|---|
| img src | atributo src de las etiquetas img | A menudo un marcador o un URI data: en páginas con lazy-loading |
| srcset | srcset en las etiquetas img y source | Contiene varias URL con descriptores de anchura; debes analizarlo y elegir un tamaño |
| Atributos lazy | data-src, data-original, data-lazy-src, data-srcset | Los nombres de atributo varían según el framework, así que revisa el marcado real |
| Fondo CSS | estilo en línea y bloques style, background-image: url() | Nunca aparece en una etiqueta img; requiere una expresión regular sobre el texto CSS |
| JSON-LD | etiqueta script con type application/ld+json | El campo image puede ser una cadena, una lista o un objeto anidado |
¿Cómo se configura un scraper de imágenes en Python?
Instala requests para HTTP, BeautifulSoup para el análisis y lxml como backend de análisis rápido; luego descarga la página y lee el src de cada etiqueta de imagen. Este ejemplo mínimo es la base sobre la que se construye cada paso posterior.
pip install requests beautifulsoup4 lxml

import os
import requests
from bs4 import BeautifulSoup
from urllib.parse import urljoin

PAGE = "https://example.com/gallery"

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (compatible; image-collector/1.0)",
    "Accept": "text/html,application/xhtml+xml",
})

resp = session.get(PAGE, timeout=30)
resp.raise_for_status()
soup = BeautifulSoup(resp.text, "lxml")

sources = []
for img in soup.find_all("img"):
    src = img.get("src")
    if src:
        sources.append(urljoin(PAGE, src))

print(len(sources), "image URLs found")
for u in sources[:10]:
    print(u)
El objeto Session mantiene vivas las conexiones y reutiliza las cabeceras, lo que es más rápido y más suave con el servidor de destino que abrir una conexión nueva por cada petición. Llama siempre a urljoin para que las rutas relativas como /media/photo.jpg se resuelvan en URL absolutas que puedas descargar después. Si eres nuevo en el flujo de trabajo general, la guía de buenas prácticas de web scraping cubre con más profundidad las cabeceras, los tiempos de espera y la cortesía.
¿Cómo se extraen los orígenes de img src, srcset y lazy-loading?
Analiza srcset dividiéndolo por comas y leyendo el descriptor de anchura para poder elegir la variante más grande, y lee cada atributo data- probable para los orígenes con lazy-loading. Una lectura simple del atributo pasa por alto la mayor parte de una página moderna, así que necesitas pequeños ayudantes para cada formato.
El valor de srcset agrupa varias URL con descriptores como 800w. Para obtener la copia de mayor resolución, compara los números de anchura y quédate con el mayor.
def largest_from_srcset(value):
    # "small.jpg 480w, big.jpg 1200w" -> "big.jpg"
    best_url, best_w = None, -1
    for part in value.split(","):
        tokens = part.strip().split()
        if not tokens:
            continue
        url = tokens[0]
        width = 0
        if len(tokens) > 1 and tokens[1].endswith("w"):
            try:
                width = int(tokens[1][:-1])
            except ValueError:
                width = 0
        if width > best_w:
            best_url, best_w = url, width
    return best_url
Ahora combina los orígenes estándar, responsive y con lazy-loading en un único recopilador. Los distintos frameworks usan nombres de atributo diferentes, así que revisa varios. La misma función también lee las etiquetas <source> dentro de los elementos <picture>, que llevan su propio srcset.
LAZY_ATTRS = ("data-src", "data-original", "data-lazy-src",
              "data-srcset", "data-image", "data-fallback-src")

def parse_srcset(value):
    urls = []
    for part in value.split(","):
        tokens = part.strip().split()
        if tokens:
            urls.append(tokens[0])
    return urls

def collect_img_sources(soup, base):
    found = set()
    for img in soup.find_all("img"):
        src = img.get("src")
        if src and not src.startswith("data:"):
            found.add(urljoin(base, src))
        if img.get("srcset"):
            biggest = largest_from_srcset(img["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
        for attr in LAZY_ATTRS:
            val = img.get(attr)
            if not val:
                continue
            if "srcset" in attr:
                for u in parse_srcset(val):
                    found.add(urljoin(base, u))
            else:
                found.add(urljoin(base, val))
    # source tags inside picture elements also carry srcset
    for source in soup.find_all("source"):
        if source.get("srcset"):
            biggest = largest_from_srcset(source["srcset"])
            if biggest:
                found.add(urljoin(base, biggest))
    return found
Omitir cualquier src que empiece por data: evita guardar marcadores en base64 en línea, que suelen ser las miniaturas de baja calidad que un cargador lazy muestra antes de que llegue la imagen real.
¿Cómo se encuentran las imágenes de fondo CSS y de JSON-LD?
Usa una expresión regular para extraer URL de las declaraciones background-image, y recorre cualquier bloque JSON-LD para leer su campo image. Estos dos orígenes nunca aparecen en una etiqueta <img>, así que un scraper que solo lea etiquetas de imagen los pasará por alto por completo.
Las imágenes decorativas y de portada suelen definirse en CSS. Analiza tanto los atributos style en línea como los bloques <style> en busca de valores url(...).
import re
from urllib.parse import urljoin

BG_RE = re.compile(
    r"background(?:-image)?\s*:\s*url\(\s*['\"]?(.*?)['\"]?\s*\)",
    re.IGNORECASE,
)

def collect_css_backgrounds(soup, base):
    found = set()
    # inline style attributes
    for el in soup.find_all(style=True):
        for match in BG_RE.findall(el["style"]):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    # style blocks
    for style in soup.find_all("style"):
        text = style.string or ""
        for match in BG_RE.findall(text):
            if match and not match.startswith("data:"):
                found.add(urljoin(base, match))
    return found
Los datos estructurados son el lugar más fiable para encontrar una imagen canónica a resolución completa en páginas de producto y de artículo. El valor image puede ser una cadena, una lista o un objeto anidado, así que recorre todo el árbol.
import json

def collect_jsonld_images(soup, base):
    found = set()
    for tag in soup.find_all("script", type="application/ld+json"):
        try:
            data = json.loads(tag.string or "")
        except (ValueError, TypeError):
            continue
        stack = [data]
        while stack:
            node = stack.pop()
            if isinstance(node, dict):
                img = node.get("image")
                if isinstance(img, str):
                    found.add(urljoin(base, img))
                elif isinstance(img, list):
                    for item in img:
                        if isinstance(item, str):
                            found.add(urljoin(base, item))
                stack.extend(node.values())
            elif isinstance(node, list):
                stack.extend(node)
    return found
Fusiona los tres recopiladores con una unión de conjuntos, por ejemplo collect_img_sources(soup, base) | collect_css_backgrounds(soup, base) | collect_jsonld_images(soup, base), y tendrás un conjunto deduplicado de URL candidatas listo para descargar.
¿Cómo se descargan los archivos de imagen de forma segura?
Transmite cada respuesta en streaming, confirma que la cabecera Content-Type es realmente una imagen y limita el tamaño para que un solo archivo no pueda agotar la memoria ni el disco. Descargar una URL a ciegas arriesga guardar páginas de error HTML, redirecciones o archivos enormes, así que valida antes de conservar los bytes.
IMAGE_TYPES = ("image/jpeg", "image/png", "image/gif",
               "image/webp", "image/avif", "image/svg+xml")

def download(session, url, proxies=None):
    with session.get(url, proxies=proxies, timeout=30,
                     stream=True) as r:
        r.raise_for_status()
        ctype = r.headers.get("Content-Type", "").split(";")[0].strip()
        if ctype not in IMAGE_TYPES:
            raise ValueError("not an image: " + (ctype or "unknown"))
        chunks = []
        total = 0
        for chunk in r.iter_content(8192):
            chunks.append(chunk)
            total += len(chunk)
            if total > 25 * 1024 * 1024:   # 25 MB safety cap
                raise ValueError("file too large")
        return b"".join(chunks), ctype
Usar streaming con stream=True e iter_content significa que la comprobación de la cabecera se ejecuta antes de que se descargue el cuerpo completo, así que un enlace mal etiquetado se rechaza pronto. Comprobar el tipo declarado detecta el caso común en que una URL rota devuelve una página HTML 404 con un estado 200. Para mayor seguridad también puedes verificar los primeros bytes mágicos del contenido, pero la comprobación de la cabecera más un límite de tamaño cubre la mayor parte del scraping del mundo real.
¿Cómo se deduplican y nombran las imágenes descargadas?
Aplica un hash SHA-256 a los bytes descargados y omite cualquier resumen que ya hayas guardado; luego sanea el nombre del archivo y reparte los archivos en subcarpetas según el prefijo del hash. Los sitios sirven con frecuencia la misma imagen desde varias rutas, CDN o variantes de tamaño, así que un hash de contenido es más fiable que comparar URL.
import os
import re
import hashlib
from urllib.parse import urlparse

EXT_BY_TYPE = {
    "image/jpeg": ".jpg", "image/png": ".png", "image/gif": ".gif",
    "image/webp": ".webp", "image/avif": ".avif", "image/svg+xml": ".svg",
}

def safe_name(url, ctype, digest):
    base = os.path.basename(urlparse(url).path)
    base = re.sub(r"[^A-Za-z0-9._-]", "_", base)
    if not base or "." not in base:
        base = digest[:16] + EXT_BY_TYPE.get(ctype, ".img")
    return base

def save_image(data, url, ctype, out_dir, seen):
    digest = hashlib.sha256(data).hexdigest()
    if digest in seen:
        return None                      # exact duplicate, skip
    seen.add(digest)
    # shard into subfolders by hash prefix to avoid one huge directory
    sub = os.path.join(out_dir, digest[:2])
    os.makedirs(sub, exist_ok=True)
    name = safe_name(url, ctype, digest)
    path = os.path.join(sub, name)
    if os.path.exists(path):
        name = digest[:16] + "_" + name  # avoid overwriting a different file
        path = os.path.join(sub, name)
    with open(path, "wb") as f:
        f.write(data)
    return path
Sanear el nombre base elimina los caracteres de path traversal y la basura de las cadenas de consulta para que una URL maliciosa o desordenada no pueda escribir fuera de tu carpeta de destino. Repartir por los dos primeros caracteres del hash mantiene los directorios pequeños, lo que importa cuando reúnes decenas de miles de archivos. Para detectar casi duplicados, como la misma foto en distintas resoluciones, una biblioteca de hash perceptual como imagehash agrupa archivos visualmente similares que los hash de bytes tratan como distintos.
¿Cómo se descargan muchas imágenes de forma concurrente?
Usa un ThreadPoolExecutor para descargar varias imágenes a la vez, y añade un limitador de tasa compartido para que todos los hilos juntos se mantengan por debajo de un techo de peticiones por segundo. Las descargas de imágenes están limitadas por E/S, así que los hilos dan una gran aceleración, pero una concurrencia sin límites machacará el destino y hará que te bloqueen.
import time
import threading
from concurrent.futures import ThreadPoolExecutor, as_completed

class RateLimiter:
    # allow N requests per second across all worker threads
    def __init__(self, rate_per_sec):
        self.min_gap = 1.0 / rate_per_sec
        self.lock = threading.Lock()
        self.next_time = 0.0

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
                now = time.monotonic()
            self.next_time = now + self.min_gap

def fetch_all(urls, out_dir, proxies=None, workers=8, rate=5):
    os.makedirs(out_dir, exist_ok=True)
    limiter = RateLimiter(rate)
    seen = set()
    seen_lock = threading.Lock()
    saved = []

    def job(url):
        limiter.wait()
        data, ctype = download(session, url, proxies)
        with seen_lock:
            return save_image(data, url, ctype, out_dir, seen)

    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = {pool.submit(job, u): u for u in urls}
        for fut in as_completed(futures):
            url = futures[fut]
            try:
                path = fut.result()
                if path:
                    saved.append((url, path))
            except Exception as exc:
                print("failed", url, exc)
    return saved
El bloqueo alrededor de seen hace que la deduplicación sea segura entre hilos, y envolver cada tarea en un bloque try significa que una URL defectuosa no detiene toda la ejecución. Mantén la tasa moderada, un puñado de peticiones por segundo es un valor por defecto razonable, y lee la guía de web scraping ético para saber cómo elegir límites que respeten el sitio.
¿Cómo se extraen imágenes a escala con proxies?
Necesitas proxies en cuanto un destino empieza a limitar tu tasa o a bloquear tu IP, algo que ocurre rápido al descargar muchas imágenes desde una sola dirección. Pasa un diccionario proxies a cada petición para que el mismo bucle de descarga se enrute a través de IP residenciales rotativas. Un flujo constante de peticiones de imagen desde una única IP es un patrón automatizado evidente, y las imágenes son pesadas, así que el ancho de banda suele ser la verdadera restricción.
USER = "your_login"
PASS = "your_password"
GATEWAY = "gw.dataimpulse.com:823"

# Rotating: a new exit IP is assigned per request
proxies = {
    "http":  "http://%s:%s@%s" % (USER, PASS, GATEWAY),
    "https": "http://%s:%s@%s" % (USER, PASS, GATEWAY),
}

# Sticky session: reuse one IP for a sequence of related downloads
def sticky_proxies(session_id):
    login = "%s-sid-%s" % (USER, session_id)
    uri = "http://%s:%s@%s" % (login, PASS, GATEWAY)
    return {"http": uri, "https": uri}

saved = fetch_all(all_urls, "images", proxies=proxies,
                  workers=8, rate=5)
Los proxies rotativos reparten las peticiones entre muchas IP para que ninguna dirección llame la atención, mientras que las sesiones sticky mantienen una IP para una galería que un sitio asocia a una sesión. DataImpulse ofrece proxies residenciales y proxies móviles para destinos que escrutan el tráfico de cerca, además de proxies de datacenter para descargas de gran volumen desde orígenes tolerantes. Todas las IP proceden de forma ética de usuarios que dan su consentimiento y reciben compensación. Si tus credenciales se rechazan con un 407, la guía de autenticación de proxy cubre el formato exacto de inicio de sesión.
Como cada byte descargado cuenta contra tu presupuesto de tráfico, planifica el tamaño antes de empezar: omite imágenes por debajo de un umbral si solo quieres el contenido principal, solicita una variante de srcset más pequeña cuando no necesites la resolución completa y guarda en caché lo que ya tienes para que una nueva ejecución no vuelva a descargar todo. DataImpulse usa facturación de pago por uso desde 1 dólar por GB con tráfico que no caduca, así que un trabajo de imágenes pesado pero ocasional no requiere una suscripción mensual, y el tráfico no usado se conserva.
¿Cómo se extraen galerías renderizadas con JavaScript?
Si un sitio construye su galería enteramente con JavaScript, las URL de imagen nunca aparecen en el HTML en bruto, así que renderiza primero la página con Playwright y pasa el resultado a los mismos recopiladores. requests por sí solo no puede ejecutar scripts, así que las galerías de scroll infinito y de página única necesitan un navegador real para disparar la carga.
pip install playwright
playwright install chromium

from playwright.sync_api import sync_playwright
from bs4 import BeautifulSoup

def render_and_collect(page_url, use_proxy=False):
    launch_args = {}
    if use_proxy:
        launch_args["proxy"] = {
            "server": "http://gw.dataimpulse.com:823",
            "username": "your_login",
            "password": "your_password",
        }
    with sync_playwright() as p:
        browser = p.chromium.launch(headless=True, **launch_args)
        page = browser.new_page()
        page.goto(page_url, wait_until="networkidle")
        # trigger lazy-loading by scrolling to the bottom
        for _ in range(10):
            page.mouse.wheel(0, 4000)
            page.wait_for_timeout(400)
        html = page.content()
        browser.close()
    soup = BeautifulSoup(html, "lxml")
    return (collect_img_sources(soup, page_url)
            | collect_css_backgrounds(soup, page_url))
Hacer scroll en bucle obliga a un cargador lazy a cambiar sus marcadores data-src por URL reales, tras lo cual los mismos analizadores que ya escribiste los recogen. Para un tratamiento más profundo del renderizado headless, consulta scraping de páginas web dinámicas.
Por último, escribe un manifiesto CSV para que cada archivo descargado sea rastreable hasta su URL de origen, su hash y su tamaño. Un manifiesto convierte una carpeta de archivos anónimos en un conjunto de datos que puedes auditar, reanudar y deduplicar entre ejecuciones.
import csv
from datetime import datetime, timezone

def write_manifest(saved, out_dir):
    path = os.path.join(out_dir, "manifest.csv")
    with open(path, "w", newline="", encoding="utf-8") as f:
        writer = csv.writer(f)
        writer.writerow(["source_url", "local_path", "sha256",
                         "bytes", "fetched_at"])
        for url, local_path in saved:
            with open(local_path, "rb") as img:
                data = img.read()
            writer.writerow([
                url,
                local_path,
                hashlib.sha256(data).hexdigest(),
                len(data),
                datetime.now(timezone.utc).isoformat(),
            ])
    return path
Con el manifiesto en su sitio puedes reejecutar el trabajo y omitir cualquier URL ya registrada, lo que ahorra ancho de banda y mantiene tu conjunto de datos coherente con el tiempo.
¿Es legal extraer y reutilizar imágenes de un sitio web?
Descargar un archivo de imagen es un acto técnico; no te concede ninguna licencia para reutilizar esa imagen. Esta es la parte peor entendida del scraping de imágenes, así que trátala con cuidado. Casi toda foto, ilustración y gráfico de la web está protegida por derechos de autor desde el momento en que se crea, y la persona que la tomó o la hizo posee esos derechos salvo que los haya cedido explícitamente.
Poder descargar un archivo no dice nada sobre tu derecho a republicarlo, venderlo, entrenar con él o redistribuirlo. Antes de reutilizar imágenes extraídas, comprueba las condiciones de licencia asociadas, busca una licencia declarada como Creative Commons o dominio público, y obtén permiso por escrito cuando el uso sea comercial. Recopilar imágenes para análisis privado, indexación o investigación es una cuestión distinta de publicarlas, y lo más seguro por defecto es asumir que una imagen está protegida salvo que una licencia diga claramente lo contrario.
Revisa también las condiciones de servicio del sitio de destino y su robots.txt antes de empezar. La guía para comprobar si un sitio web permite scraping muestra cómo leer esas señales, y la guía de scraping sin que te bloqueen cubre las prácticas de rastreo respetuosas. Ninguna de las técnicas de este artículo cambia la regla de fondo: el acceso no es una licencia, y la posición honesta es que un scraper que funciona y el derecho legal a reutilizar son dos cosas distintas que debes satisfacer de forma independiente.
Preguntas frecuentes
¿Puedo extraer imágenes de cualquier sitio web?
Técnicamente puedes descargar archivos de la mayoría de los sitios, pero primero deberías comprobar las condiciones de servicio del sitio y su robots.txt, y recordar que descargar una imagen no te da ningún derecho a reutilizarla. El acceso no es una licencia.
¿Por qué algunas imágenes no aparecen en el HTML que descargo?
Esas imágenes suelen cargarse mediante JavaScript o lazy-loading, así que sus URL reales están en atributos data o se añaden después de que la página se renderice. Renderiza la página con un navegador headless como Playwright y haz scroll para disparar la carga; luego analiza el resultado.
¿Cómo elijo la versión de mayor resolución de una imagen?
Analiza el atributo srcset, lee el descriptor de anchura tras cada URL y quédate con la URL de mayor anchura. Las páginas de producto también suelen indicar una imagen a resolución completa en un bloque JSON-LD.
¿Cómo evito descargar la misma imagen dos veces?
Calcula un hash SHA-256 de cada archivo descargado y omite cualquier hash que ya hayas guardado. Para copias visualmente similares en distintos tamaños, usa en su lugar una biblioteca de hash perceptual como imagehash.
¿Ofrece DataImpulse una API gestionada de scraping de imágenes?
No. DataImpulse proporciona proxies a través de los cuales enrutas tu propio scraper; no es una API de scraping gestionada ni un servicio de proxy web gratuito. Tú escribes la lógica de descarga y usas sus IP para el acceso y la rotación.
¿Cuándo no es DataImpulse la opción adecuada?
Si necesitas proxies ISP estáticos, una API de scraping totalmente gestionada, o acceso a sitios bancarios y gubernamentales, DataImpulse no es la herramienta adecuada. Se centra en proxies residenciales, móviles y de datacenter rotativos para recopilar datos públicos y acceder a contenido.
Empieza a extraer imágenes a escala
Cuando tu scraper de imágenes necesita acceso fiable y rotación de IP sin suscripción, DataImpulse ofrece proxies residenciales, móviles y de datacenter de origen ético con tráfico de pago por uso desde 1 dólar por GB. Crea una cuenta y enruta tu bucle de descarga a través de él en minutos.