
In this Article
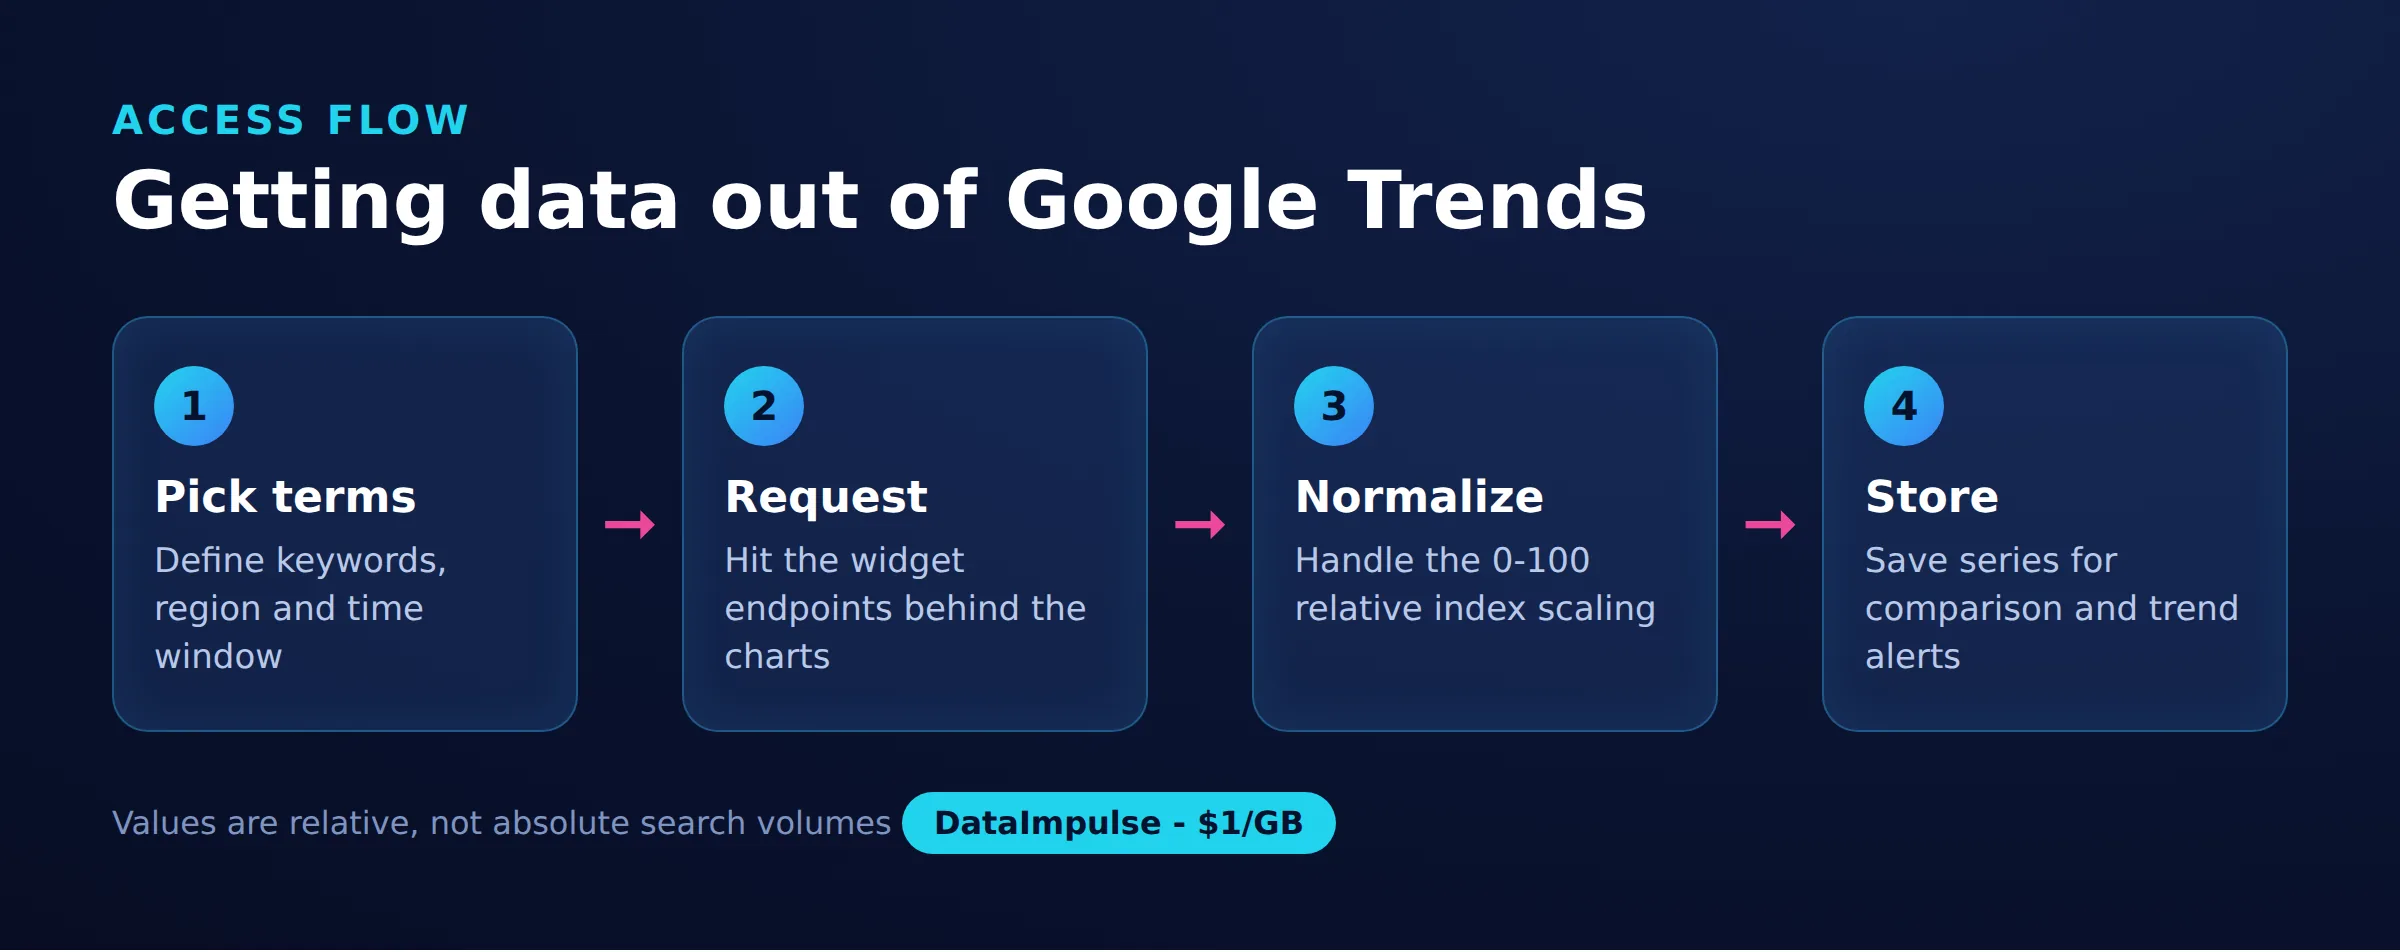
Wenn Sie wissen möchten, wie sich Google Trends scrapen lässt, sollten Sie zunächst verstehen, welche Daten Sie tatsächlich erfassen. Google Trends veröffentlicht kein absolutes Suchvolumen. Stattdessen liefert es einen normalisierten Interessenindex von 0 bis 100, der am Höchstwert der jeweils abgefragten Suchanfrage, Region und Zeitspanne ausgerichtet ist.
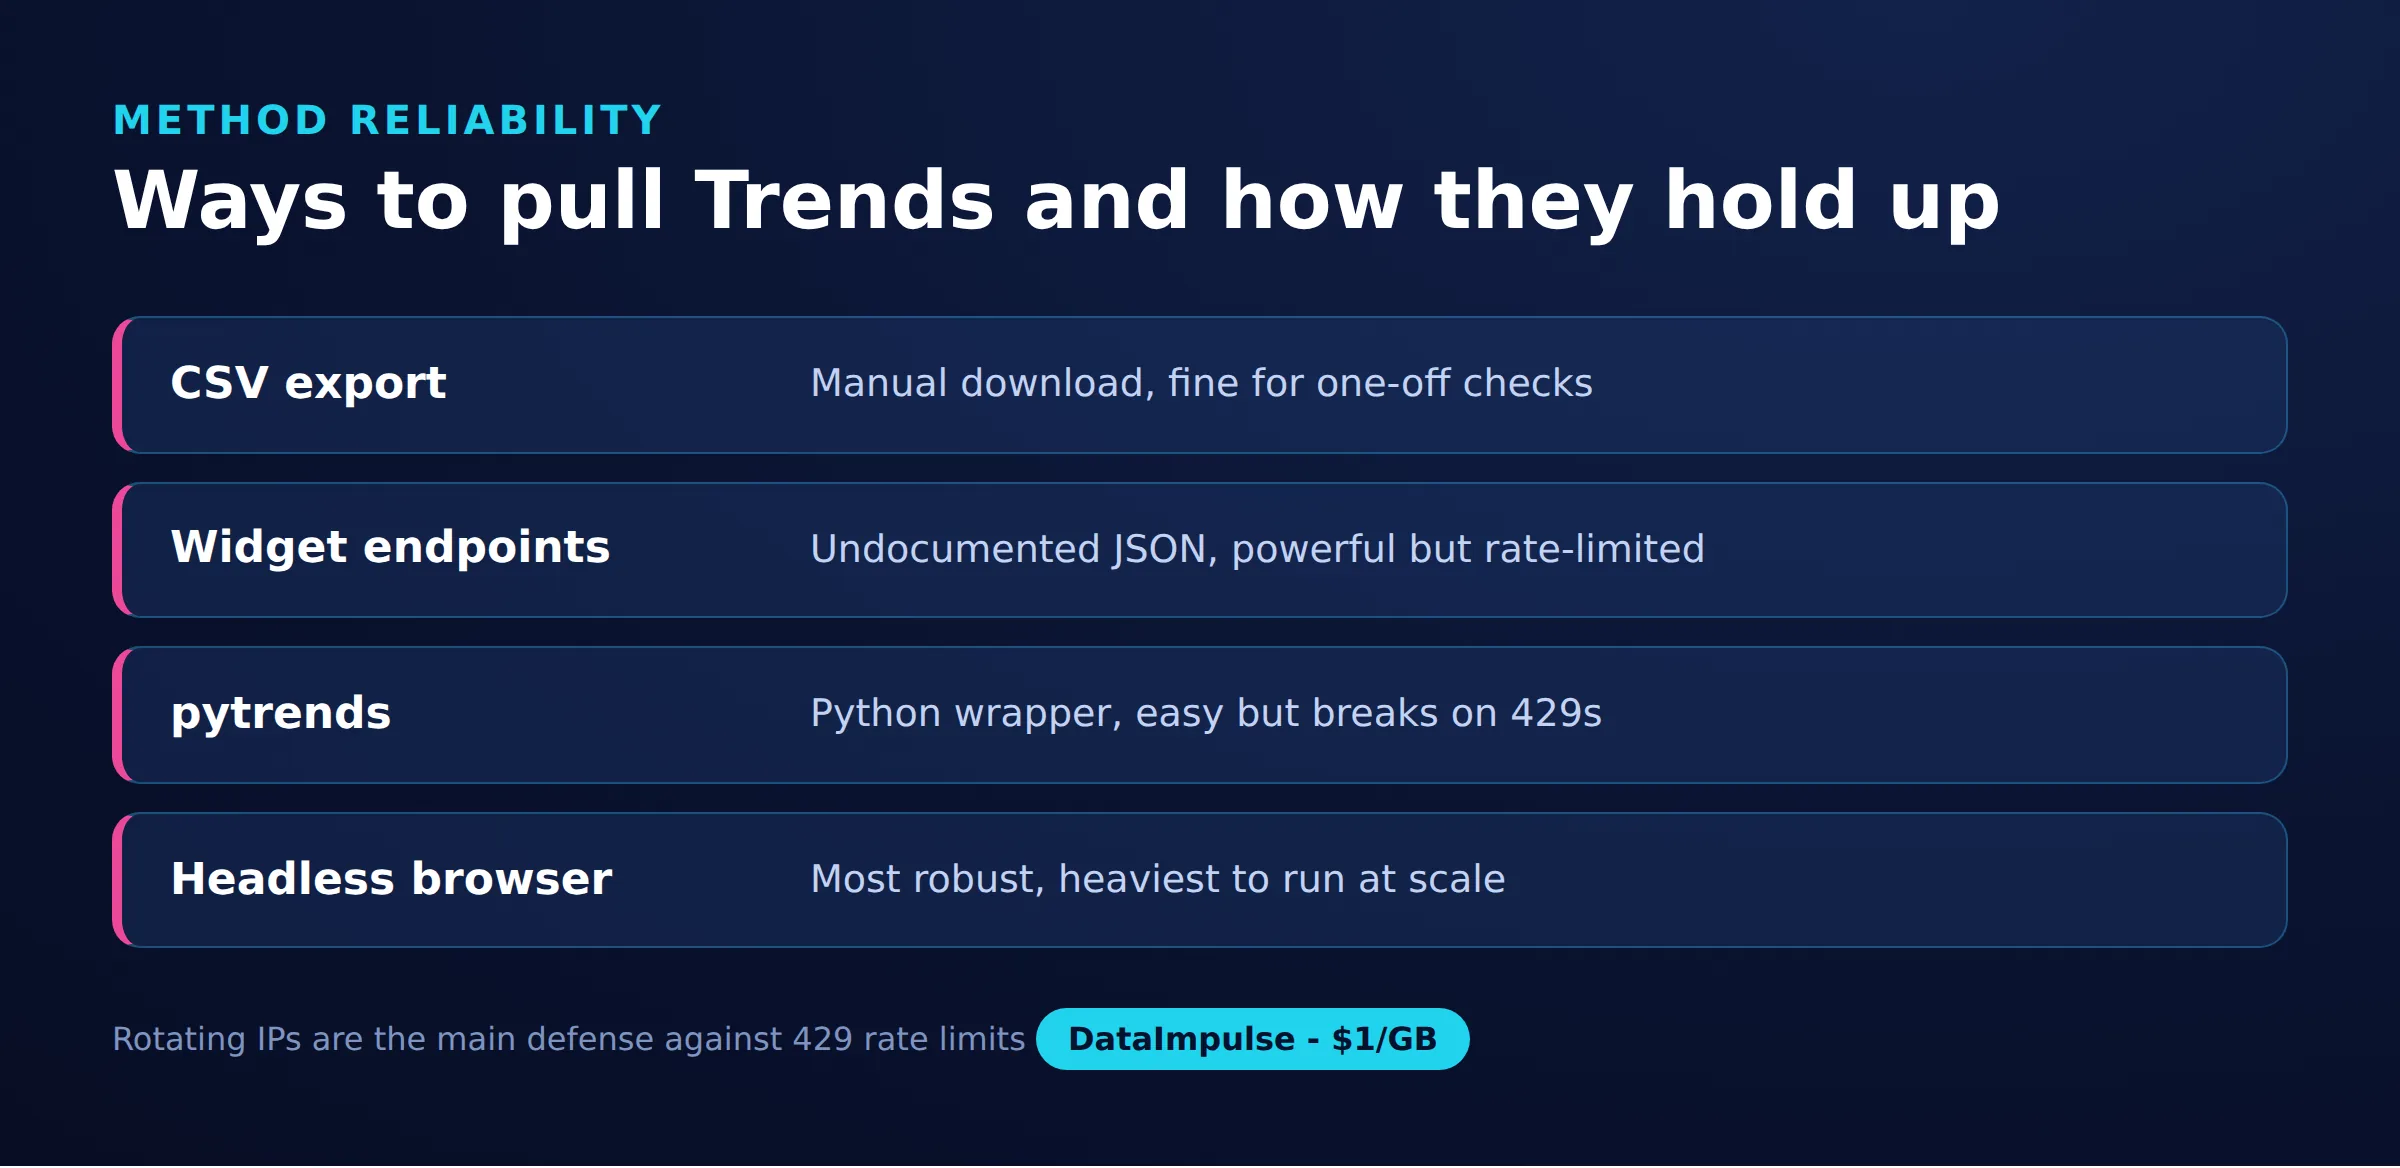
Dieser Artikel behandelt die wichtigsten Methoden, um diese Daten zu extrahieren: den integrierten CSV-Export, die undokumentierten JSON-Endpunkte der Widgets, die Python-Bibliothek pytrends und den Einsatz eines Headless-Browsers als Ausweichlösung. Außerdem erläutert er, warum rotierende Residential Proxies helfen, wenn Google 429-Fehler zurückgibt, und wo die realistischen Grenzen liegen.
DataImpulse ist ein ethischer Proxy-Anbieter mit mehr als 90 Millionen Residential-, mobilen und Datacenter-IP-Adressen in 195 Ländern. Das Unternehmen bietet ein Pay-as-you-go-Modell ab 1 Dollar pro GB mit unbegrenzt gültigem Traffic und wird für Web Scraping, Anzeigenverifizierung, Preisüberwachung, Marktforschung und die Verwaltung mehrerer Konten genutzt.
Wichtige Fakten
- Google Trends liefert einen relativen Index, keine Rohwerte: Jeder Wert wird auf einer Skala von 0 bis 100 am Höchstwert Ihrer gewählten Suchanfrage, Region und Zeitspanne ausgerichtet. Gescrapte Zahlen sind daher Vergleichswerte und keine absoluten Suchvolumina.
- Beste Proxy-Art: rotierende Residential Proxies, die echte IPs von Endnutzern verwenden und Erkennungssysteme passieren.
- Preis: ab 1 Dollar pro GB, Pay-as-you-go, mit unbegrenzt gültigem Traffic und ohne Abonnement.
- Abdeckung: Mehr als 90 Mio. ethisch beschaffte IPs in 195 Ländern.
- Zuverlässigkeit: Erfolgsquote von 99,51 %, Bewertung von 4,8 von 5 bei G2.
- Protokolle und Targeting: HTTP, HTTPS und SOCKS5, mit integriertem Länder-Targeting.
Welche Daten liefert Google Trends tatsächlich?
Google Trends liefert einen relativen Interessenindex von 0 bis 100, nicht die Anzahl der Suchanfragen. Jeder Datenpunkt wird so normalisiert, dass der Höchstwert in Ihrer Suchanfrage und Ihrem Zeitfenster 100 entspricht und alle anderen Werte daran ausgerichtet werden.
Das ist für jedes Scraping-Projekt wichtig, denn zwei getrennte Exporte lassen sich nicht direkt wie absolute Werte vergleichen. Ein Begriff mit dem Wert 100 in einem Land und ein Begriff mit dem Wert 100 in einem anderen Land liegen jeweils bei ihrem eigenen Höchstwert, nicht beim gleichen tatsächlichen Volumen. Um Begriffe fair zu vergleichen, fragen Sie sie gemeinsam in derselben Suchanfrage ab, damit Google sie auf einer gemeinsamen Skala normalisiert. Die wichtigsten verfügbaren Datenansichten sind Interesse im Zeitverlauf, Interesse nach Region, ähnliche Suchanfragen und ähnliche Themen.
Wie exportieren Sie Google-Trends-Daten als CSV?
Die einfachste Methode ist der offizielle CSV-Export in der Google-Trends-Oberfläche. Auf jeder Trends-Ergebnisseite verfügt jedes Widget über ein Download-Symbol, das diese Ansicht als CSV-Datei speichert.
Dies ist die verlässlichste und stabilste Option, weil sie eine unterstützte Funktion nutzt und für gelegentliche Recherchen oder eine kleine Gruppe von Keywords ausreicht. Der Nachteil: Der Vorgang ist manuell, jeweils auf ein Widget und eine Suchanfrage beschränkt und nicht auf Hunderte Begriffe skalierbar. Wenn Sie nur einige Vergleiche für die Content-Planung oder einen schnellen Marktcheck benötigen, umgeht der CSV-Export die Zuverlässigkeitsprobleme des automatisierten Scrapings vollständig.
Wie funktionieren die JSON-Endpunkte der Google-Trends-Widgets?
Die Trends-Website nutzt interne JSON-Endpunkte, die das Frontend zum Rendern jedes Widgets aufruft. Diese direkt zu scrapen ist der schnellste programmatische Weg, aber die Endpunkte sind undokumentiert und können sich ohne Vorankündigung ändern.
Der Ablauf besteht aus zwei Schritten. Zuerst rufen Sie einen explore-Endpunkt mit Ihrem Keyword, Ihrer Region und Ihrer Zeitspanne auf, der einen Satz von Widget-Tokens zurückgibt. Anschließend übergeben Sie jedes Token an den passenden Datenendpunkt, beispielsweise für Interesse im Zeitverlauf, um die eigentliche Datenreihe als JSON zu erhalten. Zwei praktische Besonderheiten führen oft zu Problemen:
- Den Antworten sind Anti-JSON-Zeichen vorangestellt, die Sie vor dem Parsen entfernen müssen.
- Die Tokens sind nur kurz gültig. Sie lassen sich daher nicht lange cachen oder sitzungsübergreifend wiederverwenden.
Da diese Endpunkte inoffiziell sind, sollten Sie bei jedem darauf basierenden Scraper mit Wartungsaufwand rechnen, sobald Google das Antwortformat anpasst.
Sollten Sie pytrends zum Scrapen von Google Trends verwenden?
pytrends ist eine beliebte inoffizielle Python-Bibliothek, die die oben beschriebenen Widget-Endpunkte kapselt, und der schnellste Einstieg. Sie ist wirklich nützlich, sollte aber mit realistischen Erwartungen eingesetzt werden.
Ganz offen zu pytrends: Es ist kein offizielles Google-Produkt, funktioniert zeitweise nicht mehr, wenn Google die Endpunkte ändert, und begrenzt Anfragen strikt. Sobald Sie innerhalb kurzer Zeit mehr als eine überschaubare Zahl von Anfragen senden, werden 429-Fehler zurückgegeben. Es eignet sich eher für Aufgaben im Umfang einer Recherche als für die kontinuierliche Erfassung großer Datenmengen. Ein einfacher Abruf von Interesse im Zeitverlauf mit einer übergebenen Proxy-Liste zur Verteilung der Anfragen auf IPs sieht so aus:
from pytrends.request import TrendReq

pytrends = TrendReq(
    hl="en-US",
    tz=360,
    timeout=(10, 25),
    proxies=[
        "http://user:[email protected]:823",
        "http://user:[email protected]:824",
    ],
    retries=2,
    backoff_factor=0.5,
)

pytrends.build_payload(["web scraping", "data mining"], timeframe="today 12-m")
df = pytrends.interest_over_time()
print(df.head())
Das Rotieren zwischen mehreren Proxy-Einträgen verhindert, dass eine einzelne IP die Limits von Google pro Adresse überschreitet. Die Einstellungen für Wiederholungen und Backoff gleichen vorübergehende Fehler aus.
Warum helfen rotierende Residential Proxies bei 429-Fehlern?
Rotierende Residential Proxies helfen, weil Google Trends-Anfragen pro IP-Adresse drosselt und Sie nach der Markierung einer Adresse weiterhin Antworten mit 429 Too Many Requests erhalten. Die Verteilung der Anfragen auf viele Residential IPs in Kombination mit exponentiellem Backoff hält jede Adresse unter dem Grenzwert.
Residential IPs stammen von echten Endgeräten von Verbrauchern und fügen sich daher deutlich besser in den normalen Datenverkehr ein als Datacenter-Bereiche, die Google erkennt und strenger begrenzt. Durch die Rotation wird jede Anfrage oder kleine Gruppe von Anfragen von einer anderen Adresse gesendet, sodass keine einzelne IP genug Volumen ansammelt, um blockiert zu werden. Residential Proxies sind deshalb hier die praktische Wahl, obwohl Datacenter-Proxies auch für kleine Aufgaben mit niedriger Frequenz funktionieren können, bei denen die Kosten wichtiger sind als Unauffälligkeit. DataImpulse bietet rotierende und Sticky Sessions über 90M+ IPs in 195 Ländern hinweg, einschließlich Länder-Targeting. Damit können Sie auch regionsspezifische Trends-Daten über eine IP aus der jeweiligen Region erfassen.
Rotation allein reicht nicht. Sie müssen die Anfragen auch bewusst verlangsamen. Das Grundmuster besteht darin, einen 429-Fehler abzufangen, bei jedem Versuch eine doppelt so lange Wartezeit einzulegen und nach einer festen Anzahl von Versuchen abzubrechen, damit ein fehlerhaftes Ziel nicht endlos wiederholt wird:
import time
import requests

def fetch_with_backoff(url, proxies, max_retries=5):
    delay = 2
    for attempt in range(max_retries):
        resp = requests.get(url, proxies=proxies, timeout=20)
        if resp.status_code == 429 or resp.status_code >= 500:
            time.sleep(delay)
            delay *= 2
            continue
        return resp
    raise RuntimeError("Rate limited after retries")
Kombinieren Sie dieses Backoff mit Proxy-Rotation und einer zufälligen Pause zwischen erfolgreichen Aufrufen. Dieselben Prinzipien zur Vermeidung von Blockierungen gelten für jede umfangreiche Datenerfassung, wie dieser Leitfaden zum Scrapen ohne Blockierung.
Wann sollten Sie stattdessen einen Headless-Browser verwenden?
Verwenden Sie einen Headless-Browser, wenn die JSON-Endpunkte nicht mehr funktionieren oder Prüfungen zurückgeben, die ein einfacher HTTP-Client nicht bewältigen kann. Tools wie Playwright oder Selenium laden die echte Trends-Seite, führen deren JavaScript aus und ermöglichen es Ihnen, die gerenderten Widget-Daten auszulesen oder die Netzwerkanfragen der Seite abzufangen.
Dieser Ansatz ist aufwendiger und langsamer, weil er pro Sitzung einen vollständigen Browser ausführt. Dafür ist er widerstandsfähiger gegenüber Änderungen im Frontend und kann einige interaktive Prüfungen umgehen, an denen einfache anfragebasierte Scraper scheitern. Leiten Sie den Browser über einen Proxy, idealerweise über mobile Proxies oder Residential IPs, damit die automatisierte Sitzung weiterhin wie ein normaler Besucher wirkt. Beachten Sie, dass ein Headless-Browser die zugrunde liegenden Ratenlimits nicht aufhebt. Sie müssen Anfragen weiterhin takten und IPs rotieren, nur mit mehr Aufwand pro Anfrage als bei der direkten Endpunktmethode.
Wofür lassen sich gescrapte Google-Trends-Daten nutzen?
Gescrapte Google-Trends-Daten eignen sich vor allem, um relative Entwicklungen und Saisonalität zu erkennen, nicht um exakte Volumina zu bestimmen. Da die Werte einen normalisierten Index darstellen, sollten Sie sie als Signale für steigendes oder sinkendes Interesse verstehen, nicht als Traffic-Prognosen.
Typische Anwendungsfälle sind:
- SEO- und Content-Planung: Vergleichen Sie verwandte Begriffe auf einer Skala, um zu entscheiden, welches Thema Priorität haben soll und wann das Interesse im Jahresverlauf seinen Höhepunkt erreicht.
- Produktnachfrage: Verfolgen Sie, ob das Interesse an einer Kategorie oder Funktion wächst oder nachlässt, bevor Sie Ressourcen einsetzen.
- Markttiming: Nutzen Sie saisonale Muster und regionale Unterschiede, um Kampagnen oder Produkteinführungen dann zu planen, wenn die Aufmerksamkeit am größten ist.
Die klare Einschränkung lautet: Trends allein kann weder die absolute Nachfrage noch den Conversion-Wert liefern. Kombinieren Sie die Daten mit Suchvolumen-Tools, Verkaufsdaten oder Zahlen von Werbeplattformen, um das relative Signal in eine Entscheidung zu überführen.
Zugriffsmethoden im Vergleich
| Methode | Zuverlässigkeit | Aufwand und Grenzen |
|---|---|---|
| CSV-Export | Hoch | Manuell, einzelne Suchanfrage |
| Widget-Endpunkte | Mittel | Undokumentiert, kann sich ändern |
| pytrends | Mittel | Einfach, ratenbegrenzt |
| Headless-Browser | Hoch | Aufwendiger, benötigt Proxies |
Häufig gestellte Fragen
Ist das Scrapen von Google Trends legal?
Das Scrapen öffentlich sichtbarer Daten ist in vielen Rechtsordnungen grundsätzlich zulässig, doch automatisierter Zugriff kann gegen die Nutzungsbedingungen von Google verstoßen. Prüfen Sie die Bedingungen und das anwendbare lokale Recht und bevorzugen Sie nach Möglichkeit den offiziellen CSV-Export oder einen unterstützten Datensatz.
Zeigt Google Trends das tatsächliche Suchvolumen?
Nein. Es zeigt einen relativen Interessenindex von 0 bis 100, normalisiert am Höchstwert Ihrer gewählten Suchanfrage, Region und Zeitspanne. Um das absolute Volumen zu schätzen, benötigen Sie ein separates Keyword-Tool.
Warum gibt pytrends ständig 429-Fehler zurück?
429 bedeutet, dass Google Ihre IP wegen zu vieler Anfragen in zu kurzer Zeit begrenzt. Fügen Sie Verzögerungen mit exponentiellem Backoff hinzu, verringern Sie die Anfragefrequenz und rotieren Sie zwischen mehreren Proxies, damit keine einzelne IP das Limit überschreitet.
Benötige ich Proxies, um Google Trends zu scrapen?
Für einige manuelle Suchanfragen nicht. Bei automatisierten oder größeren Aufgaben helfen rotierende Residential Proxies, Ratenlimits pro IP zu vermeiden und regionsspezifische Daten über eine IP im Zielland zu erfassen.
Ist pytrends eine offizielle Google-Bibliothek?
Nein. pytrends ist eine inoffizielle Community-Bibliothek, die die internen Endpunkte von Google kapselt. Sie eignet sich gut für Recherchen, funktioniert aber zeitweise nicht mehr, wenn Google diese Endpunkte ändert, und benötigt daher gelegentliche Wartung.
Wann ist DataImpulse nicht die richtige Lösung?
Wenn Sie statische ISP-Proxies, eine vollständig verwaltete Scraping API oder Zugriff auf Banking- und Behörden-Websites benötigen, ist DataImpulse nicht das richtige Tool. Der Fokus liegt auf rotierenden Residential-, mobilen und Datacenter-Proxies zur Erfassung öffentlicher Daten und zum Zugriff auf Inhalte.
Weiterführende Leitfäden
Google-Trends-Daten im großen Maßstab erfassen
Wenn Ihr Trends-Scraping gedrosselt wird, halten rotierende Residential IPs jede Anfrage unter den Limits von Google pro Adresse. DataImpulse bietet Pay-as-you-go Residential-, mobile und Datacenter-Proxies ab 1 Dollar pro GB, einschließlich Länder-Targeting. Ein DataImpulse-Konto erstellen für den Einstieg.