
In diesem Artikel
Curl impersonate bezeichnet den Einsatz von curl-impersonate, um das TLS- und HTTP/2-Verhalten eines Browsers bei HTTP-Anfragen nachzuahmen. Die Dokumentation des ursprünglichen Projekts beschreibt die Änderungen auf Transportebene, die diesem Ansatz zugrunde liegen. Ein geänderter User-Agent allein bildet sie nicht nach.
Beginne mit einer Fingerprint-Prüfung und sieh dir dann den tatsächlichen Response-Body an. Unser kurzer Test vom 16. Oktober 2026 zeigte nützliche Unterschiede zwischen gewöhnlichen Clients und impersonierten Anfragen, außerdem Produktseiten, die weiterhin Challenges auslieferten. Das ist ein kleiner Snapshot, kein Benchmark und kein Zugriffsversprechen.
Die wichtigsten Fakten
- Python requests und das System-curl zeigten in unserem Test den gleichen OpenSSL-JA3-Fingerprint.
- curl_cffi impersonate=”chrome” und curl_chrome136 stimmten exakt mit dem JA4- und HTTP/2-Fingerprint von echtem Chromium 145 überein.
- Über denselben Residential Proxy und denselben User-Agent wurde einfaches curl auf die Blockseite von Walmart umgeleitet, curl_chrome136 erhielt die vollständige Seite.
- JA3 ändert sich zwischen Chrome-Builds, weil Chrome die Reihenfolge der TLS-Extensions zufällig mischt. JA4 ist das stabilere Signal.
- Impersonation korrigiert TLS- und HTTP/2-Fingerprints, nicht aber JavaScript- oder Verhaltens-Challenges.
- curl-impersonate v2.2.3 liefert fertige Binärdateien wie curl_chrome136 und curl_firefox147 mit.
Was ist curl impersonate und was ahmt es tatsächlich nach?
curl-impersonate ist ein modifizierter curl-Build, der auf browserähnliches Verbindungsverhalten abzielt. Er umfasst TLS-Handshakes und HTTP/2-Einstellungen, nicht aber die vollständige Ausführungsumgebung eines Browsers.
Das ursprüngliche Projekt liegt unter lwthiker, unsere getestete Binärdatei stammt aus dem Fork von lexiforest. Die Projektdokumentation des Forks nennt das gepatchte BoringSSL als Grundlage. Halte Repository, Release und gewähltes Profil gemeinsam fest: Ein vertrauter Name der ausführbaren Datei allein ist als Herkunftsnachweis unzureichend.
Stell dir Impersonation als Wahl vor, wie sich die Verbindung vorstellt. Header beschreiben die HTTP-Anfrage, Transporteinstellungen beschreiben einen anderen Teil des Clients. Keines von beiden belegt, dass ein Mensch die Anfrage ausgelöst hat. Übereinstimmende ausgewählte Fingerprints können keine vollständige Browser-Äquivalenz belegen.
Prüfe bei einem curl-impersonate-Workflow zuerst, ob die benötigten Daten bereits in der HTTP-Antwort stehen. Unsere erfolgreiche Suchantwort enthielt eingebettetes Produkt-JSON, andere getestete Seiten lieferten weiterhin Challenges. Der umfassendere Leitfaden zum TLS-Fingerprinting liefert zusätzlichen Kontext, doch die Untersuchung der Antwort sollte die Umsetzungsentscheidungen leiten.
Wie installierst du curl impersonate und führst die erste Anfrage aus?
Wähle Release und Plattform-Artefakt ausdrücklich aus und führe dann den Browser-Wrapper gegen einen Fingerprint-Endpunkt aus. Unser getestetes Linux-Setup nutzte lexiforest v2.2.3 und den Wrapper curl_chrome136.
Schritt 1: Öffne das offizielle Release v2.2.3, wähle das zu deiner Architektur passende Linux-Artefakt und entpacke es. Die Anforderungen an Laufzeit und CA-Zertifikate findest du in der Installationsdokumentation.
Schritt 2: Halte den Wrapper und seine zugehörigen Artefakte zusammen. Unsere Umgebung war Linux mit Ubuntu OpenSSL 3.0.13. Die Impersonation-Binärdatei meldete sich als curl 8.22.0-IMPERSONATE mit BoringSSL. Dieser Unterschied ist beim Vergleich mit dem System-curl wichtig.
Schritt 3: Führe im entpackten Verzeichnis genau den Fingerprint-Befehl aus, den wir in unserem Snapshot verwendet haben:
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
Speichere den zurückgegebenen JA4, die HTTP-Version und den HTTP/2-Fingerprint, bevor du einen Anwendungsendpunkt testest. So entsteht eine Transport-Baseline, ohne die Antwort eines Händlers als Fingerprint-Test zu behandeln.
Nutze für Windows oder macOS die Plattform-Artefakte und Installationswege, die der Fork dokumentiert. Die Bindings-Seite verweist auf Integrationen für Python, JavaScript/TypeScript, PHP und Rust. Prüfe jedes Nixpkgs-Paket oder jeden Node-Wrapper anhand des tatsächlichen Upstreams und Releases. Unsere Installationsbelege gelten nur für Linux.
Wie impersonierst du Chrome in Python mit curl_cffi?
Nutze curl_cffi mit dem Parameter impersonate und pinne die Paketversion für Reproduzierbarkeit. Unsere Python-Umsetzung verwendete curl_cffi 0.15 mit impersonate=”chrome”.
Der offizielle Quick Start dokumentiert die Installation per pip, Browser-Profile und eine requests-ähnliche Schnittstelle. Installiere Version 0.15 in einer isolierten Umgebung, um unsere Paketauswahl nachzustellen. Der generische Alias chrome folgt dem aktuellen Chrome-Ziel der Bibliothek, daher kann ein Upgrade seine Bedeutung verändern.
Definiere vor der Ausführung dieser getesteten Anweisung url als öffentliche Such-URL https://www.walmart.com/search?q=air+fryer und PROXY als deine eigene Proxy-URL, privat aus deiner Umgebung geladen. Die Anweisung hängt von diesen beiden Variablen ab:
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
Prüfe Status und HTML der Antwort, bevor du Datensätze extrahierst. In unserer erfolgreichen CLI-Suchantwort war die Extraktionsquelle das eingebettete Produkt-JSON __NEXT_DATA__. Finde dieses Script-Element mit einem HTML-Parser, dekodiere sein JSON und validiere die erwarteten Felder, bevor du die Seite als brauchbaren Inhalt akzeptierst.
Der Quick Start dokumentiert Session für Cookie-Persistenz und Verbindungswiederverwendung. Halte bei einem Workflow mit mehreren Anfragen Session, Profil und vorgesehenen Exit-Standort konsistent. Kombiniere ein Profil nicht mit beliebigen Browserversions-Headern, die von einem fremden Rechner kopiert wurden.
Proxy-Authentifizierung und Ziel-Authentifizierung sind getrennte Themen. Verwende nur Zugangsdaten, die für deinen eigenen autorisierten Dienst ausgestellt wurden. Dieses Beispiel mit einer öffentlichen Seite braucht keinen Login am Ziel. Unser Leitfaden von curl zu Python behandelt die Übersetzung der Anfragestruktur.
Wie unterscheiden sich JA3- und JA4-Fingerprints?
JA3 behält die Reihenfolge in ausgewählten ClientHello-Feldern bei, während JA4 ausgewählte Listen vor dem Hashing normalisiert. Dadurch ist JA4 nützlich, wenn die Reihenfolge der Extensions variiert, ohne deshalb eine vollständige Client-Identität zu sein.
Die JA3-Spezifikation von Salesforce beschreibt einen Fingerprint aus TLS-Version, Cipher-Suites, Extensions, unterstützten Gruppen und Punktformaten. Die JA4-Spezifikation von FoxIO sortiert Ciphers und Extensions, behält aber die Reihenfolge der Signaturalgorithmen bei. Beschreibe JA4 nicht so, als ignoriere er jeden Reihenfolgeunterschied.
In unserem Snapshot hatten curl_cffi chrome und Playwright Chromium 145.0.7632.6 denselben JA4 t13d1516h2_8daaf6152771_d8a2da3f94cd und denselben HTTP/2-Fingerprint 52d84b11737d980aef856699f885ca86. Ihre JA3-Werte unterschieden sich. Der Wrapper curl_chrome136 stimmte mit denselben JA4- und HTTP/2-Werten überein.
Das sind vom Server am Messendpunkt beobachtete Übereinstimmungen, kein Beweis dafür, dass jedes Handshake-Byte oder jedes Anwendungsverhalten übereinstimmte. Teste über die vorgesehene Netzwerkroute und vergleiche beide Transportebenen. Prüfe bei Systemen, die du selbst betreibst, serverseitige Belege. Die Fingerprint-Dokumentation von Cloudflare erklärt, wie sich diese Signale in der Traffic-Analyse und in Regeln einsetzen lassen.
Wie konfigurierst du HTTP-, HTTPS- und SOCKS-Proxys?
Lege den Proxy unabhängig vom Browser-Profil fest. Das Schema des Ziels und das Schema des Proxys beschreiben unterschiedliche Verbindungen, daher kann ein HTTPS-Ziel einen HTTP-Proxy nutzen.
In der Python-Anweisung wählt der Dictionary-Schlüssel https die HTTPS-Ziele aus, der Wert bezeichnet den Proxy-Endpunkt. Der Quick Start von curl_cffi dokumentiert Beispiele für HTTP- und SOCKS-Proxys. Unsere gemessene Route nutzte einen HTTP-Proxy mit Authentifizierung.
Die HTTP-Proxy-Dokumentation von curl erklärt das CONNECT-Tunneling für HTTPS-Ziele. Ohne TLS-Interception transportiert der Tunnel den verschlüsselten Austausch des Clients und bewahrt dessen zielseitige Header und TLS-Handshake. Ein HTTPS-Proxy verschlüsselt zusätzlich die Verbindung zwischen Client und Proxy. Unterstützte Schemata und Authentifizierungseinstellungen findest du in der offiziellen Referenz der Proxy-Option.
Halte Proxy-Zugangsdaten aus gemeinsam genutzten Skripten und Diagnoseausgaben heraus. Prüfe zuerst Endpunkt, Protokoll, Port und Authentifizierung unabhängig voneinander und vergleiche dann die Anwendungsantworten. Ein fehlgeschlagener Proxy-Verbindungsaufbau ist ein anderer Befund als eine erfolgreich abgerufene Challenge-Seite.
Bevorzuge bei zustandsbehafteten Abläufen während der Diagnose einen stabilen Exit. Ziehe Rotation nur für unabhängige, autorisierte Anfragen in Betracht, und zwar erst nach einer funktionierenden Baseline. Wenn du IP und Transportprofil gleichzeitig änderst, lässt sich das Ergebnis schwerer erklären.
Unser Leitfaden zur curl-Proxy-Einrichtung behandelt die Konfiguration, während die Proxy-Auswahl für curl bei der Bewertung der Routenanforderungen hilft. Weder die Routenwahl noch Impersonation garantieren Akzeptanz.
Warum wird curl trotzdem blockiert, obwohl ein Browser funktioniert?
Ein Browser und ein HTTP-Client können sich auf mehreren Ebenen unterscheiden, selbst wenn sie dieselbe URL anfragen. Nutze das 4-Ebenen-Modell zur Anfragediagnose, um den Unterschied einzugrenzen, bevor du das Werkzeug wechselst.
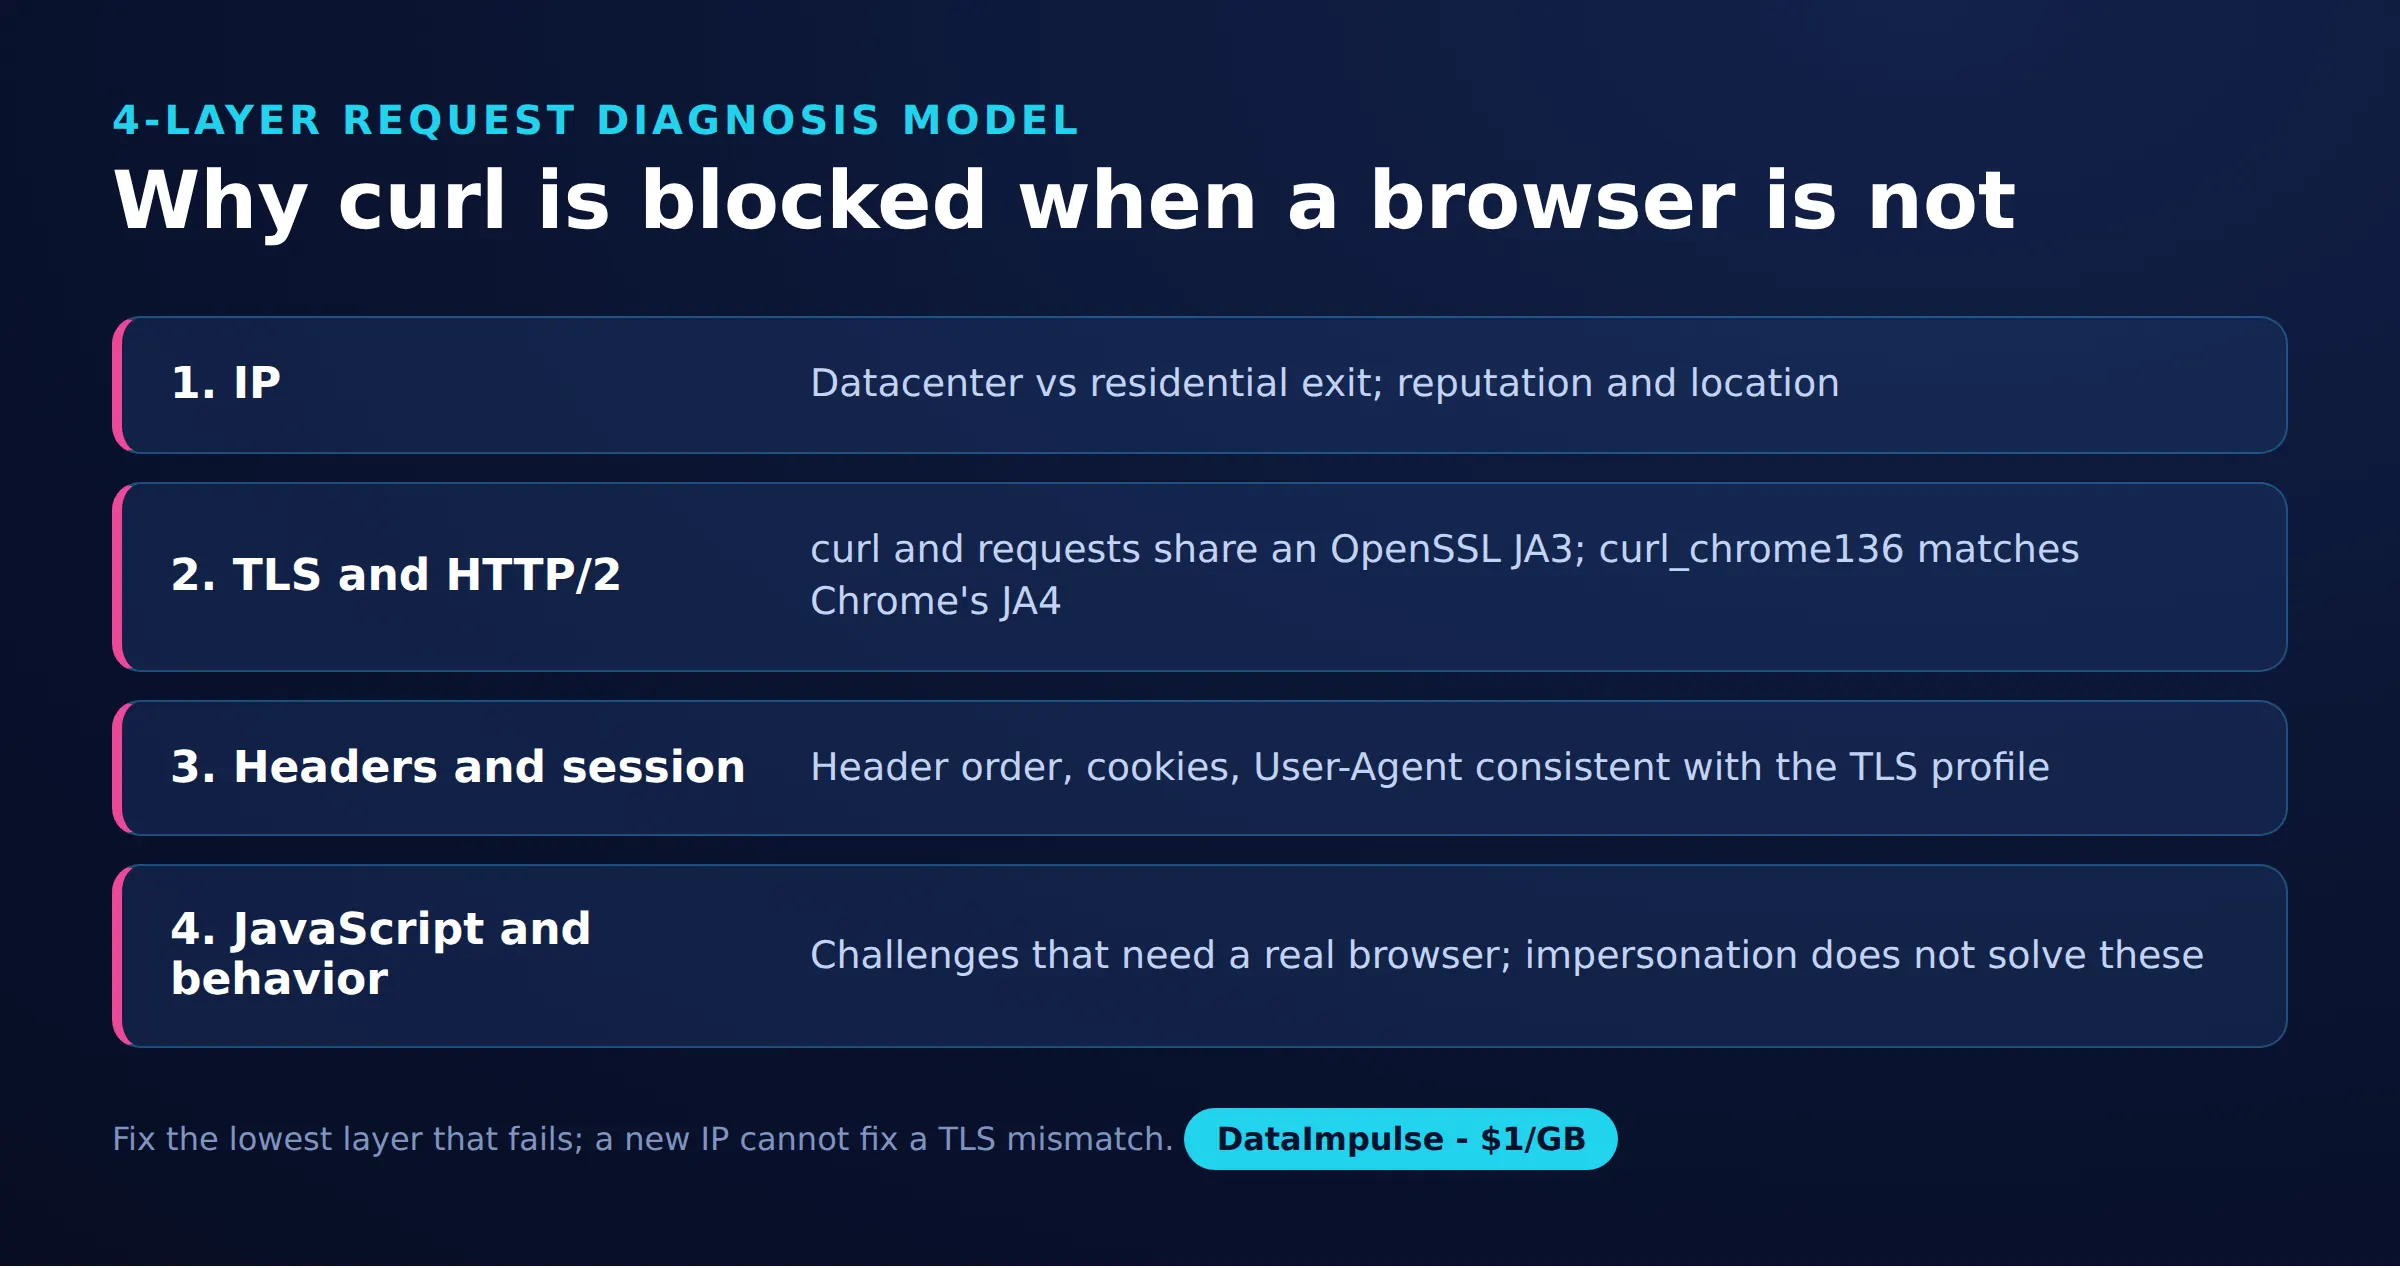
- Ebene 1: IP und Route. Halte den Client konstant und vergleiche direkten Zugriff mit Zugriff über Proxy. Notiere Land, Stabilität des Exits und ob der Fehler auftritt, bevor eine HTTP-Antwort eintrifft.
- Ebene 2: TLS und HTTP/2. Halte die Route konstant und vergleiche gewöhnliche mit impersonierten Anfragen. Prüfe die vom Endpunkt beobachteten Fingerprints, statt dem User-Agent-String zu vertrauen.
- Ebene 3: Header und Session. Vergleiche Weiterleitungen, Cookies, angefragte URL und erwartetes Antwortformat. Sieh dir den Body an: Ein erfolgreicher HTTP-Status kann mit einer erfolglosen Anwendungsantwort einhergehen.
- Ebene 4: JavaScript und Verhalten. Stelle fest, ob Daten erst nach Seitenausführung oder Interaktion erscheinen. Die Challenges auf unseren Produktseiten blieben nach der Transport-Impersonation ungelöst.
Erfasse bei jedem Vergleich Status, Weiterleitungsziel, Content-Type, Antwortgröße und einen Inhaltsmarker. Die HTTP-Scripting-Dokumentation von curl erklärt die Untersuchung von Antworten, Weiterleitungen, Cookies und ausführliche Diagnoseausgaben. Entferne Zugangsdaten, bevor du Logs aufbewahrst.
Behandle nicht jede Ablehnung als Fingerprint-Problem. Eine falsche URL, fehlender Session-Zustand oder eine Anwendungsregel können einen Wechsel auf Transportebene überdauern. Gleiche bei deinem eigenen Dienst die Beobachtungen des Clients mit den Server-Logs ab. Beende bei externen Diensten wiederholte Versuche gegen Challenges und überdenke den erlaubten Zugangsweg.
Wann wählst du curl-impersonate statt Playwright oder Selenium?
Wähle Transport-Impersonation, wenn eine HTTP-Antwort alles enthält, was die Aufgabe braucht. Wähle Browser-Automatisierung, wenn Rendering oder Interaktion unverzichtbar sind, und miss ihren Betriebsaufwand in deiner eigenen Workload.
| Client | X verwenden, wenn… | X vermeiden, wenn… |
|---|---|---|
| Standard-curl | Verwende Standard-curl, wenn gewöhnliches HTTP genügt. | Vermeide Standard-curl, wenn ein verifizierter Fingerprint-Unterschied eine Rolle spielt. |
| curl-impersonate | Verwende curl-impersonate, wenn browserähnlicher Transport zur Aufgabe passt. | Vermeide curl-impersonate, wenn JavaScript-Ausführung erforderlich ist. |
| Playwright/Selenium | Verwende Playwright/Selenium, wenn Rendering oder Interaktion unverzichtbar sind. | Vermeide Playwright/Selenium, wenn einfaches HTTP die Anforderungen erfüllt. |
Die Netzwerkdokumentation von Playwright behandelt die Beobachtung von Browser-Anfragen, die Übersicht von Selenium beschreibt Browser-Automatisierung. Ein Browser bringt Seitenlebenszyklus und Aufwand für das Laden von Ressourcen mit sich. Unser Lauf hat weder CPU noch Latenz gemessen, daher belegt er keinen Vorteil bei Geschwindigkeit oder Skalierung.
Der APIRequestContext von Playwright sendet API-Anfragen und kann Cookies mit einem Browser-Kontext teilen. Er ist nicht gleichbedeutend mit dem Aufruf einer Seite im Browser. Gehe nicht davon aus, dass geteilte Cookies ein identisches Transportverhalten belegen.
Auch Browser-Automatisierung hat Grenzen. Die Dokumentation zu unterstützten Umgebungen von Cloudflare schließt automatisierte Browser von der Unterstützung beim Lösen produktiver Challenges aus (Stand Oktober 2026). Ein Werkzeugwechsel ist keine universelle Lösung für Challenges.
Was hat unser kleiner Test mit öffentlichen Seiten gezeigt?
In unserem kurzen Lauf am 16. Oktober 2026 wurden mit Impersonation Suchinhalte abgerufen, während gewöhnliche Anfragen Challenges erhielten. Die Fehlschläge bei Produktseiten zeigten die Grenze, diesen Erfolg zu verallgemeinern.
Methode und Stichprobe: Andrii verglich acht Konfigurationen aus Client und Profil am TLS-Prüfendpunkt: requests 2.x, System-curl, vier curl_cffi-Profile, Playwright Chromium und curl_chrome136. Die Anwendungsstichprobe umfasste vier Kombinationen aus Python-Client und Route sowie zwei CLI-Suchergebnisse, dazu explorative Prüfungen von Produktseiten. Das sind dokumentierte Beobachtungen, keine Erfolgsraten aus wiederholten Versuchen.
Der Fingerprint-Endpunkt war https://tls.peet.ws/api/all. Die Python-Profile waren chrome, chrome131, safari und firefox. Gewöhnliche Anfragen und System-curl hatten denselben JA3 0149f47eabf9a20d0893e2a44e5a6323, wobei requests HTTP/1.1 und System-curl h2 nutzte. Allein das zeigt, warum ein einzelner TLS-Hash die gesamte Verbindung nicht zusammenfassen kann.
| Python-Client | Route | Status | Erfasste Größe | Klassifizierung des Bodys |
|---|---|---|---|---|
| requests | Direkt | 200 | 15 KB | PerimeterX-Challenge |
| requests | Residential | 200 | 15 KB | PerimeterX-Challenge |
| curl_cffi chrome | Direkt | 200 | 1321 KB | Inhalt |
| curl_cffi chrome | Residential | 200 | 1392 KB | Inhalt |
Der CLI-Vergleich nutzte denselben DataImpulse US-Residential-Proxy und denselben Chrome-User-Agent. Einfaches curl erhielt eine 307-Weiterleitung auf eine blockierte Seite mit der Bezeichnung “Robot or human?”. Die Anfrage mit curl_chrome136 lieferte 200, etwa 176 KB komprimiert übertragen, und HTML mit dem Produkt-JSON __NEXT_DATA__.
Produktseiten von Walmart stellten curl_cffi weiterhin vor Challenges. Eine Produktseite von Sephora lieferte über Residential-Zugriff eine JavaScript- bzw. Verhaltens-Challenge von Akamai. Diese Fehlschläge verhindern, das Ergebnis der Suchseite zu einer allgemeinen Aussage über eine der beiden Websites auszuweiten.
Traffic-Schätzung: Beim ausgewiesenen Residential-Startpreis von $1 pro GB entsprechen 176 KB bei dezimalen Einheiten etwa $0.000176. Das ist illustrativer Antwort-Traffic, keine Rechnungsschätzung: Request-Bytes, Wiederholungen, Abrechnungsregeln und weitere Übertragungen können die Summe verändern. Für die Python-Größen ist hier keine Entsprechung zur komprimierten Übertragung belegt, vergleiche sie daher nicht direkt mit dem CLI-Wert.
Dieser Snapshot enthält keine Zeitverteilung, keine Anzahl wiederholter Anfragen und keine kontrollierte Isolierung jedes Header-Unterschieds. Er stützt die Untersuchung des Transports, rechtfertigt es aber nicht, jeden Unterschied in den Antworten allein auf TLS zurückzuführen.
Halte für eine Wiederholung dieses Snapshots die exakten Paketversionen, den gewählten Wrapper, die Route, die Klassifizierung der Antwort und die Maßeinheiten gemeinsam fest. Führe getrennte Felder für übertragene Bytes und die Größe des dekodierten Bodys. Wiederhole die Vergleiche unter kontrollierten Bedingungen, bevor du sie für die Kapazitätsplanung nutzt, und betrachte ein geändertes Seitentemplate oder eine veränderte Challenge-Antwort als Anlass, den Parser neu zu validieren.
Welche Berechtigungen und Alternativen solltest du prüfen?
Vergewissere dich, dass die geplante Datenerhebung autorisiert ist, bevor du aus einer Diagnoseanfrage eine dauerhafte Automatisierung machst. Öffentliche Erreichbarkeit ist kein ausreichender Beleg für eine Erlaubnis in jedem Verwendungsfall.
Prüfe die Nutzungsbedingungen der Website, ihre robots-Anweisungen, veröffentlichten Zugriffsrichtlinien und die geltenden Pflichten. Halte die Erhebung eng begrenzt, beachte genannte Limits und vermeide wiederholte Versuche gegen Challenges. Verwende keine Zugangsdaten Dritter wieder und versuche nicht, CAPTCHAs zu umgehen.
Prüfe, ob es eine offizielle API, einen Export, einen Feed oder einen lizenzierten Datensatz gibt, bevor du eine fragile Seitenintegration pflegst. Vergleiche Feldabdeckung, Aktualität, Authentifizierungsanforderungen und zulässige Weiterverwendung. Such bei unklarem Zugang einen genehmigten Weg, statt anzunehmen, dass eine erfolgreiche Antwort die Frage klärt.
Häufig gestellte Fragen
Was ist curl-impersonate?
Es ist ein modifizierter curl-Build, der auf browserähnliche Netzwerk-Handshakes abzielt. Nutze ihn, um Transportunterschiede zu untersuchen, und validiere den tatsächlich gelieferten Inhalt getrennt davon.
Warum kann curl scheitern, wenn ein Browser Erfolg hat?
Die beiden Anfragen können sich in Route, Transport, Session-Zustand oder Seitenausführung unterscheiden. In unserem Lauf enthielt HTTP 200 manchmal eine Challenge, daher war der Status allein eine irreführende Erfolgsprüfung.
Wie impersoniert curl_cffi Chrome?
Der Parameter impersonate wählt ein Browser-Transportprofil aus. Unser getesteter Python-Aufruf wählte chrome. Bewahre bei der Dokumentation einer Reproduktion die Paketversion zusammen mit diesem Alias auf.
Funktioniert curl-impersonate mit Proxys?
Unsere Anfrage mit curl_chrome136 funktionierte über einen authentifizierten HTTP-Residential-Proxy. Behandle Proxy-Konnektivität und Akzeptanz durch die Anwendung als getrennte Prüfungen, denn eine funktionierende Route kann trotzdem eine Challenge zurückgeben.
Wann sollte ich stattdessen Playwright verwenden?
Wähle einen Browser-Workflow, wenn das benötigte Ergebnis von Seitenausführung oder Interaktion abhängt. Bestätige zuerst, dass die gewünschten Daten in der ersten Antwort fehlen, und betrachte Browser-Automatisierung nicht als garantierten Zugang.
Beweist ein übereinstimmender JA4, dass eine Anfrage von einem Browser stammt?
Nein. Unsere impersonierten Clients teilten ausgewählte Fingerprints mit Chromium, doch diese Beobachtung sagt nichts über das vollständige Browserverhalten oder über eine Autorisierung aus.
Teste die Netzwerkebene mit einer klaren Baseline
Wenn deine Diagnose auf die Exit-Route hindeutet, teste die Residential Proxys von DataImpulse mit demselben Client, demselben Profil und denselben Inhaltsprüfungen. DataImpulse liefert Proxys, keine Scraping-API, keinen verwalteten Unblocker, kein VPN und keine Daten. Fang klein an und erweitere erst, nachdem du sowohl die Erlaubnis als auch brauchbare Antworten bestätigt hast.
Zuletzt aktualisiert: 16. Oktober 2026.