
In this Article
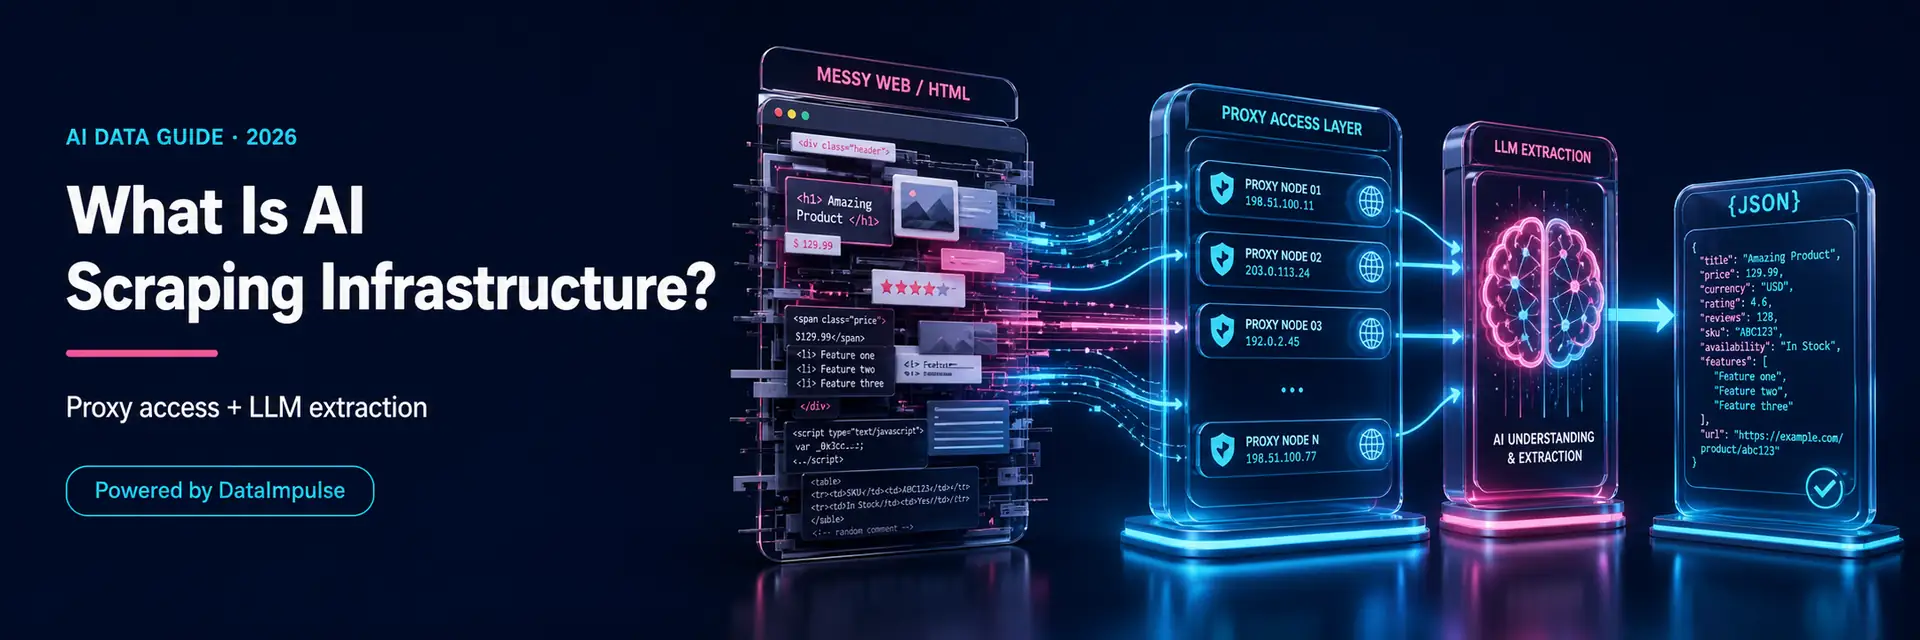
L’infrastructure de scraping IA est la stack moderne permettant de collecter des données web en s’appuyant sur l’IA pour le parsing : une couche d’accès par proxy pour atteindre les pages, une extraction fondée sur les LLM qui transforme du HTML désordonné en données structurées, et l’orchestration qui relie ces éléments. On passe ainsi de scrapers fragiles, construits sélecteur par sélecteur, à des systèmes dans lesquels un modèle interprète le sens des pages. Mais l’IA ne transforme qu’une seule couche : il faut toujours récupérer les pages, ce qui relève de l’accès web classique. Ce guide présente l’infrastructure de scraping IA, ses composants, ses différences avec le scraping traditionnel et le rôle des proxies.
Je suis Andrii Byzov, AI-Native Fractional CMO, et je construis des pipelines de données web. Vous trouverez ci-dessous une définition simple, les différentes couches, ce que l’IA change réellement et la couche d’accès sous-jacente. Cet article s’inscrit dans l’infrastructure de données web pour l’IA.
Points clés
- Infrastructure de scraping IA = couche d’accès + extraction IA + orchestration : la stack qui collecte des données web grâce à une analyse fondée sur les LLM.
- L’IA transforme l’analyse, pas l’accès. Le modèle remplace les sélecteurs fragiles, mais les pages sont toujours récupérées de manière classique.
- Elle est plus robuste. L’extraction par LLM tolère les changements de mise en page qui font échouer les scrapers reposant sur des sélecteurs.
- Le compromis est le coût. Les appels aux LLM sont facturés au token : l’extraction IA convient donc aux cibles complexes ou variées, tandis que les sélecteurs restent plus économiques pour des volumes homogènes.
- Les proxies restent la couche d’accès. Le modèle d’extraction ne récupère pas lui-même les pages : les proxies résidentiels gèrent l’accès par IP et la géolocalisation, mais pas les CAPTCHA, les empreintes numériques ni les barrières d’authentification.
Qu’est-ce qu’une infrastructure de scraping IA ?
Il s’agit d’un système de bout en bout qui transforme le web ouvert en données structurées en utilisant l’IA à l’étape de l’extraction. Un scraper traditionnel repère les données à l’aide de sélecteurs codés en dur (.price) ; le scraping IA transmet la page à un modèle qui extrait les données en interprétant son contenu. La partie infrastructure englobe tout ce qui entoure ce modèle : récupération fiable des pages à grande échelle, transmission à l’extracteur, validation et livraison du résultat. C’est la version prête pour la production du scraping web IA : non pas un simple script, mais une stack.
En quoi diffère-t-elle d’une infrastructure de scraping traditionnelle ?
- Parsing. Les scrapers traditionnels échouent lorsque le balisage change ; l’extraction par LLM interprète le sens du contenu et tolère donc mieux les refontes, même si elle exige toujours validation et nouvelles tentatives.
- Maintenance. Les scrapers reposant sur des sélecteurs demandent une maintenance site par site ; l’extraction IA nécessite moins de code propre à chaque site, mais davantage de vigilance sur les coûts et la validation des résultats.
- Structure des coûts. L’exécution de sélecteurs coûte peu ; l’extraction par LLM est facturée au token, ce qui déplace le principal poste de coût.
- Ce qui ne change pas. Les contraintes d’accès au web demeurent : récupérer les pages et éviter les blocages. Même si l’implémentation de la récupération et du rendu varie, l’accès reste le principal frein au passage à l’échelle.
Les composants
Couche d’accès (proxies). Atteindre les pages depuis le bon emplacement sans être bloqué : cette contrainte, inchangée par rapport à toute stack de scraping, reste déterminante à grande échelle.
Récupération & rendu. Récupération du HTML, gestion du contenu dynamique et de la pagination.
Extraction par IA. Un LLM transforme le contenu des pages en données structurées suivant un schéma : c’est la couche que l’IA modifie réellement.
Validation & livraison. Vérification du résultat par rapport à un schéma, gestion des nouvelles tentatives et livraison de données propres en aval. Le parsing seul ne suffit pas à garantir la qualité.
import requests
# The AI scraping stack in miniature: PROXY fetches the page (access layer),
# the LLM extracts structure (parsing layer). Two separate jobs.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def scrape(url, schema):
html = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0"}, timeout=30).text
return extract_with_llm(html, schema) # your model returns validated JSON
data = scrape("https://example.com/product/1", {"title": "str", "price": "float"})
Où s’intègrent les proxies ?
L’idée reçue la plus répandue au sujet du scraping IA est que le modèle s’occupe de tout. Ce n’est pas le cas : le modèle d’extraction analyse le contenu, mais ne récupère pas les pages et ne contourne pas les blocages, sauf s’il est associé à une couche de navigation ou d’outils. La récupération reste un accès web classique : les sites cibles appliquent des limites de débit, adaptent leur contenu selon la géolocalisation et repèrent les IP de datacenter. La collecte à grande échelle rencontre donc les mêmes obstacles que tout autre scraping. Les proxies résidentiels constituent la couche d’accès : ils font passer les requêtes par de véritables IP grand public du marché visé afin que les pages parviennent à votre extracteur avec moins de blocages liés à l’IP. Ils gèrent l’accès par IP et la géolocalisation, mais pas les CAPTCHA, les empreintes numériques ni les barrières d’authentification. DataImpulse propose des proxies résidentiels à partir de $1/GB, et des proxies mobiles à partir de $2/GB, dans 195+ emplacements. L’IA change votre manière d’analyser les pages ; les proxies déterminent votre manière d’y accéder. Consultez les meilleurs proxies pour le scraping IA pour cette couche.
Quand une infrastructure de scraping IA se justifie
L’extraction par IA justifie son coût en tokens pour des cibles désordonnées, variées ou qui changent fréquemment : de nombreux sites partageant un même schéma, des mises en page souvent remaniées ou des pages non structurées pour lesquelles les sélecteurs sont peu adaptés. Pour des pages uniformes et à fort volume (un seul site, des millions de pages identiques), les sélecteurs traditionnels restent moins coûteux et plus rapides. La plupart des stacks matures sont hybrides : elles utilisent des sélecteurs pour l’essentiel du volume et l’extraction par IA pour les cas limites complexes, sur une même couche d’accès partagée.
Le scraping IA est-il légal ?
L’utilisation d’un LLM pour analyser des pages ne change pas le cadre juridique : la collecte est soumise aux mêmes règles que tout autre scraping. Privilégiez les données publiques et non personnelles, respectez les conditions des sites, considérez robots.txt comme un signal de politique d’accès, ne contournez ni les connexions ni les contrôles d’accès, espacez les requêtes et suivez la provenance des données qui alimentent un modèle. Le caractère public des données ne résout pas les questions de droit d’auteur, de contrat ou de confidentialité, et la légalité dépend de la juridiction, de la source et de l’usage. L’utilisation de proxies n’est pas illégale en soi, mais dépend du cas d’usage et du droit applicable ; le risque apparaît lorsque l’objectif est de contourner des interdictions ou des contrôles d’accès. Consultez la légalité du web scraping. Ces informations sont générales et ne constituent pas un avis juridique.
Questions fréquentes
Qu’est-ce qu’une infrastructure de scraping IA ?
C’est la stack qui permet de collecter des données web en utilisant l’IA pour l’extraction : une couche d’accès par proxy pour atteindre les pages, une extraction fondée sur les LLM qui transforme du HTML désordonné en données structurées, ainsi que l’orchestration, la validation et la livraison qui les accompagnent. C’est la version prête pour la production du scraping web IA : non pas un simple script, mais un système.
En quoi est-ce différent du scraping traditionnel ?
La couche de parsing change : au lieu de sélecteurs codés en dur qui échouent lorsque le balisage évolue, un LLM extrait les données en interprétant le contenu, ce qui lui permet de mieux tolérer les refontes. La maintenance se déplace des sélecteurs propres à chaque site vers le contrôle des coûts et la validation des résultats. La couche d’accès, c’est-à-dire la récupération des pages, reste la même et demeure le principal frein au passage à l’échelle.
Avez-vous toujours besoin de proxies pour le scraping IA ?
Oui. Le LLM analyse le contenu, mais ne récupère pas les pages et ne contourne pas les blocages. La récupération relève de l’accès web classique, et les sites limitent les requêtes, adaptent leur contenu selon la géolocalisation et repèrent les IP de datacenter. Les proxies résidentiels constituent la couche d’accès qui fait passer les requêtes par de véritables IP grand public afin que les pages parviennent à votre extracteur avec moins de blocages liés à l’IP.
Quand le scraping IA est-il pertinent par rapport au scraping traditionnel ?
L’extraction IA justifie son coût en tokens pour des cibles désordonnées, variées ou qui changent fréquemment, par exemple de nombreux sites partageant un même schéma ou des mises en page souvent remaniées. Les sélecteurs traditionnels sont moins coûteux et plus rapides pour des pages uniformes à fort volume. La plupart des stacks matures sont hybrides : elles utilisent des sélecteurs pour l’essentiel du volume et l’IA pour les cas limites complexes, sur une même couche d’accès.
Le scraping IA est-il légal ?
L’utilisation d’un LLM pour analyser des pages ne change pas les règles : cela relève du même cadre juridique que tout autre scraping. Privilégiez les données publiques et non personnelles, respectez les conditions des sites et robots.txt, ne contournez pas les contrôles d’accès, espacez les requêtes et suivez la provenance des données. Le caractère public des données ne résout pas les questions de droit d’auteur ou de confidentialité ; la légalité dépend de la juridiction, de la source et de l’usage. L’utilisation de proxies pour une collecte légitime est généralement légale. Ceci ne constitue pas un avis juridique.
Conclusion
L’infrastructure de scraping IA déplace la partie fragile, le parsing, des sélecteurs écrits à la main vers un LLM qui interprète le contenu. La stack devient ainsi plus robuste et moins dépendante d’une maintenance site par site. Mais l’IA ne modifie qu’une seule couche : il faut toujours récupérer les pages, supporter le coût en tokens lorsque cela se justifie, respecter le cadre juridique et s’appuyer sur une couche d’accès qui maintient les pages accessibles à grande échelle. Mettez en place votre extraction et votre validation ; louez une couche d’accès reposant sur des proxies résidentiels. Explorez les éléments clés : AI web scraping, best AI web scrapers, et web data infrastructure for AI.
Dernière mise à jour : 28 juin 2026.