
In this Article
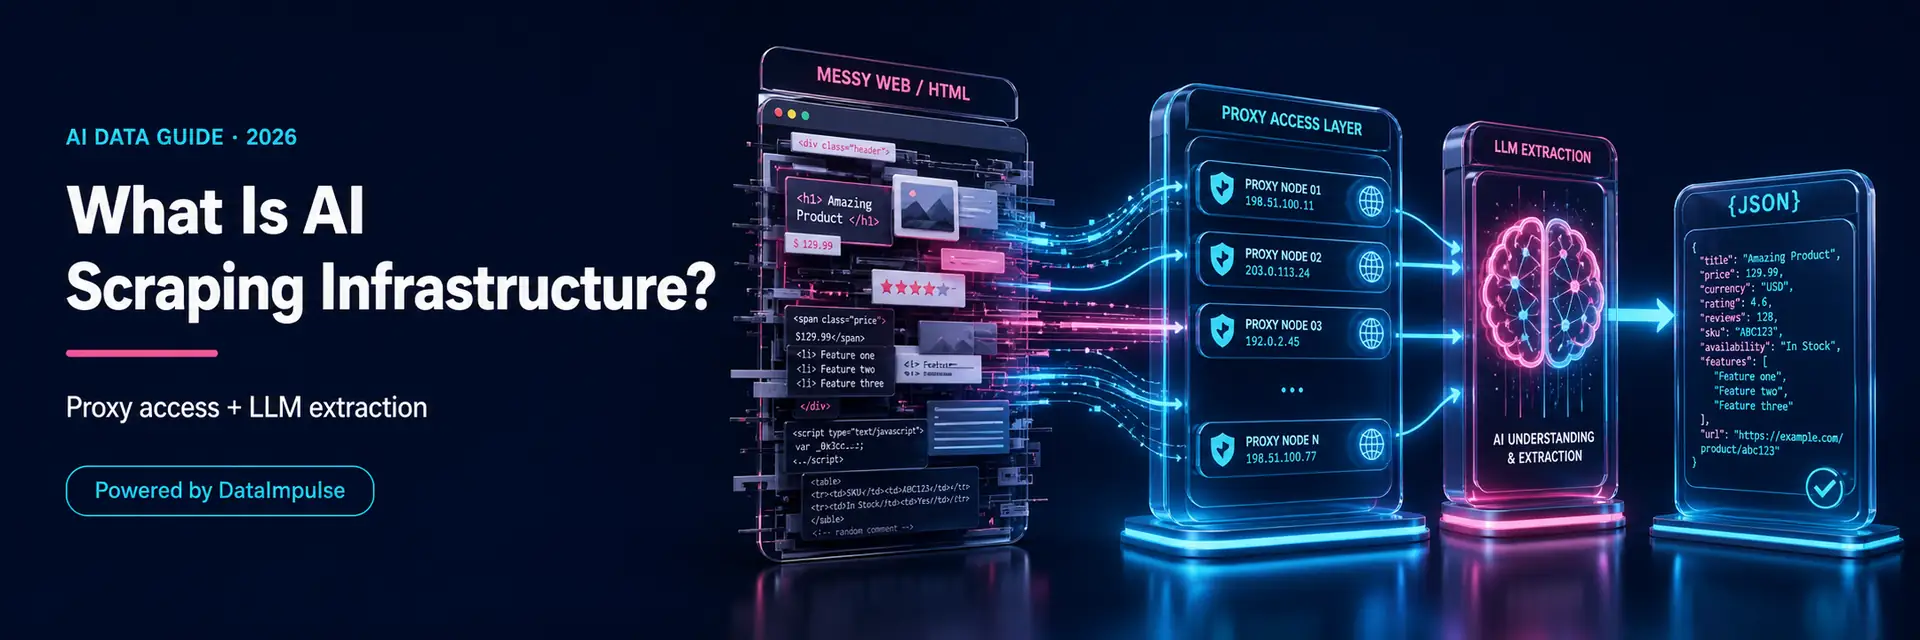
AI اسکریپنگ انفراسٹرکچر ویب ڈیٹا جمع کرنے کا ایک جدید اسٹیک ہے، جس میں پارسنگ کے لیے AI استعمال ہوتا ہے: ایک پراکسی رسائی تہہ جو صفحات تک پہنچتی ہے، اس کے ساتھ LLM پر مبنی استخراج جو بے ترتیب HTML کو ساختہ ڈیٹا میں بدلتا ہے، اور ان سب کے گرد آرکیسٹریشن۔ یہ کمزور، ہر سلیکٹر پر الگ انحصار کرنے والے اسکریپرز سے ایسے نظاموں کی طرف منتقلی ہے جہاں ایک ماڈل صفحات کو معنی کے لحاظ سے پڑھتا ہے۔ لیکن AI صرف ایک تہہ کو بدلتا ہے: آپ کو پھر بھی صفحات فیچ کرنے ہوتے ہیں، اور یہ اب بھی عام ویب رسائی ہی ہے۔ یہ گائیڈ AI اسکریپنگ انفراسٹرکچر، اس کے اجزا، روایتی اسکریپنگ سے اس کے فرق، اور پراکسیز کے کردار کی وضاحت کرتی ہے۔
میں Andrii Byzov ہوں، ایک AI-Native Fractional CMO جو ویب ڈیٹا پائپ لائنز بناتا ہے۔ ذیل میں ایک سادہ تعریف، تہیں، وہ تبدیلی جو AI حقیقتاً لاتا ہے، اور اس سب کے نیچے موجود رسائی کی تہہ بیان کی گئی ہے۔ یہ AI کے لیے ویب ڈیٹا انفراسٹرکچر کا حصہ ہے۔
اہم حقائق
- AI اسکریپنگ انفراسٹرکچر = رسائی کی تہہ + AI استخراج + آرکیسٹریشن: LLM پر مبنی پارسنگ کے ساتھ ویب ڈیٹا جمع کرنے کا اسٹیک۔
- AI پارسنگ کو بدلتا ہے، رسائی کو نہیں۔ ماڈل کمزور سلیکٹرز کی جگہ لیتا ہے؛ صفحات پھر بھی معمول کے ویب طریقے سے حاصل کرنے پڑتے ہیں۔
- یہ زیادہ مضبوط ہے۔ LLM استخراج لے آؤٹ کی ان تبدیلیوں کو برداشت کر لیتا ہے جو سلیکٹر پر مبنی اسکریپرز کو ناکام کر دیتی ہیں۔
- اس کی قیمت لاگت ہے۔ LLM کالز کا بل فی ٹوکن بنتا ہے، اس لیے AI استخراج بے ترتیب یا متنوع اہداف کے لیے موزوں ہے؛ یکساں بڑے حجم کے لیے سلیکٹرز سستے رہتے ہیں۔
- پراکسیز رسائی کی تہہ ہی رہتی ہیں۔ استخراجی ماڈل خود صفحات حاصل نہیں کرتا؛ رہائشی پراکسیز IP/جغرافیائی مقام کی رسائی سنبھالتی ہیں (CAPTCHAs، فنگر پرنٹس، یا auth walls نہیں)۔
AI اسکریپنگ انفراسٹرکچر کیا ہے؟
یہ کھلی ویب کو ساختہ ڈیٹا میں بدلنے کا شروع سے آخر تک نظام ہے، جس میں استخراج کے مرحلے کے لیے AI استعمال کیا جاتا ہے۔ ایک روایتی اسکریپر hard-coded selectors (.price) کے ذریعے ڈیٹا ڈھونڈتا ہے؛ AI اسکریپنگ صفحہ ایک ماڈل کو دیتی ہے، جو مواد کو سمجھ کر مطلوبہ معلومات نکالتا ہے۔ “infrastructure” سے مراد وہ سب کچھ ہے جو اس ماڈل کے گرد کام کرتا ہے: صفحات کو قابل اعتماد طریقے سے اور بڑے پیمانے پر فیچ کرنا، انہیں استخراج کار تک پہنچانا، آؤٹ پٹ کی توثیق کرنا، اور اسے آگے فراہم کرنا۔ یہ AI ویب اسکریپنگ کی پروڈکشن شکل ہے: ایک اکیلا اسکرپٹ نہیں، بلکہ ایک مکمل اسٹیک۔
یہ روایتی اسکریپنگ انفراسٹرکچر سے کیسے مختلف ہے
- پارسنگ۔ روایتی اسکریپرز markup بدلنے پر ٹوٹ جاتے ہیں؛ LLM extraction معنی کے ذریعے پڑھتی ہے، اس لیے redesigns کو بہتر طور پر برداشت کرتی ہے (اگرچہ اسے پھر بھی validation اور retries کی ضرورت رہتی ہے)۔
- دیکھ بھال۔ سلیکٹر پر مبنی اسکریپرز کو ہر سائٹ کے لیے الگ دیکھ بھال چاہیے؛ AI extraction میں site-specific code کم ہوتا ہے، مگر لاگت اور output validation پر زیادہ توجہ درکار ہوتی ہے۔
- لاگت کی ساخت۔ سلیکٹرز چلانے میں سستے ہوتے ہیں؛ LLM extraction کا بل per token بنتا ہے، جس سے خرچ کی جگہ بدل جاتی ہے۔
- جو چیز نہیں بدلتی۔ ویب رسائی کی پابندیاں وہی رہتی ہیں: صفحات فیچ کرنا اور بلاک ہونا، چاہے fetch/render implementation مختلف ہو، اور رسائی اب بھی وہ جگہ ہے جہاں scaling ٹوٹتی ہے۔
اجزاء
رسائی کی تہہ (پراکسیز)۔ درست جگہ سے صفحات تک بلاک ہوئے بغیر پہنچنا؛ کسی بھی اسکریپنگ اسٹیک کی طرح یہ حصہ بدستور ویسا ہی ہے، اور بڑے پیمانے پر یہی بنیادی حد رہتا ہے۔
فیچ اور رینڈر۔ HTML حاصل کرنا، dynamic content اور pagination کو سنبھالنا۔
AI استخراج۔ ایک LLM کا page content کو schema کے مطابق structured data میں تبدیل کرنا؛ یہی وہ تہہ ہے جسے AI حقیقتاً بدلتا ہے۔
Validation اور delivery۔ output کو schema کے خلاف جانچنا (صرف parsing proof نہیں)، retries کو سنبھالنا، اور clean data downstream پہنچانا۔
import requests
# The AI scraping stack in miniature: PROXY fetches the page (access layer),
# the LLM extracts structure (parsing layer). Two separate jobs.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def scrape(url, schema):
html = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0"}, timeout=30).text
return extract_with_llm(html, schema) # your model returns validated JSON
data = scrape("https://example.com/product/1", {"title": "str", "price": "float"})
پراکسیز کہاں فٹ بیٹھتی ہیں
AI اسکریپنگ کے بارے میں سب سے عام غلط فہمی یہ ہے کہ ماڈل سب کچھ سنبھال لیتا ہے۔ ایسا نہیں ہے: استخراجی ماڈل مواد کو پارس کرتا ہے، لیکن جب تک اسے browsing/tool تہہ کے ساتھ نہ جوڑا جائے، یہ صفحات فیچ نہیں کرتا اور بلاکس سے خود نہیں گزرتا۔ فیچنگ اب بھی عام ویب رسائی ہے: ٹارگٹ سائٹس rate-limit کرتی ہیں، geo-personalize کرتی ہیں، اور datacenter IPs کو flag کرتی ہیں، اس لیے بڑے پیمانے پر ڈیٹا جمع کرنے میں وہی رکاوٹیں آتی ہیں جو کسی بھی اسکریپنگ میں آتی ہیں۔ رہائشی پراکسیز access layer ہیں: یہ fetch کو درست مارکیٹ میں حقیقی consumer IPs کے ذریعے route کرتی ہیں، تاکہ صفحات کم IP-based blocking کے ساتھ آپ کے extractor تک پہنچیں (یہ IP/geolocation access کو address کرتی ہیں، CAPTCHAs، fingerprints، یا auth walls کو نہیں): DataImpulse residential $1/GB سے (mobile $2/GB سے) 195+ locations میں۔ AI یہ بدلتا ہے کہ آپ parse کیسے کرتے ہیں؛ پراکسیز یہ طے کرتی ہیں کہ آپ reach کیسے کرتے ہیں۔ اس تہہ کے لیے AI اسکریپنگ کے لیے بہترین پراکسیز دیکھیں۔
AI اسکریپنگ انفراسٹرکچر کب موزوں ہوتا ہے
AI extraction اپنی token لاگت بے ترتیب، متنوع، یا بار بار تبدیل ہونے والے اہداف پر پوری کرتی ہے: بہت سی سائٹس جن کا schema ایک ہو، ایسے layouts جو اکثر redesign ہوتے ہوں، یا unstructured pages جہاں selectors عملی نہ ہوں۔ زیادہ حجم والے، یکساں pages کے لیے (ایک سائٹ، لاکھوں identical templates)، روایتی سلیکٹرز اب بھی سستے اور تیز ہیں۔ زیادہ تر mature stacks hybrid ہوتے ہیں: bulk کے لیے selectors، messy edge cases کے لیے AI extraction، ایک ہی shared access layer پر۔
کیا AI اسکریپنگ قانونی ہے؟
pages کو parse کرنے کے لیے LLM استعمال کرنے سے قانونی صورتحال تبدیل نہیں ہوتی؛ collection انہی اصولوں پر چلتی ہے جو کسی بھی scraping پر لاگو ہوتے ہیں۔ public، non-personal data کو ترجیح دیں، site terms کا احترام کریں اور robots.txt کو policy signal سمجھیں، logins یا access controls کو bypass نہ کریں، requests کو مناسب رفتار دیں، اور اس data کے لیے provenance track کریں جو model کو feed کرتا ہے۔ Public availability copyright، contract، یا privacy کے سوالات حل نہیں کرتی، اور legality jurisdiction، source، اور use پر منحصر ہے۔ Proxy use بذات خود غیر قانونی نہیں، مگر یہ use case اور applicable law پر منحصر ہے؛ bans یا access controls سے بچنے کی کوشش وہ مقام ہے جہاں risk پیدا ہوتا ہے۔ دیکھیں کیا ویب اسکریپنگ قانونی ہے۔ یہ عمومی معلومات ہیں، قانونی مشورہ نہیں۔
اکثر پوچھے جانے والے سوالات
AI اسکریپنگ انفراسٹرکچر کیا ہے؟
یہ AI کے ذریعے extraction کے لیے web data جمع کرنے کا stack ہے: ایک proxy access layer جو pages تک پہنچتی ہے، LLM-based extraction جو بے ترتیب HTML کو structured data میں تبدیل کرتی ہے، اور ان کے گرد orchestration، validation، اور delivery۔ یہ AI web scraping کی production شکل ہے: ایک script نہیں، بلکہ ایک system۔
یہ روایتی اسکریپنگ سے کیسے مختلف ہے؟
parsing layer بدل جاتی ہے: hard-coded selectors کے بجائے جو markup بدلنے پر ٹوٹ جاتے ہیں، ایک LLM معنی کے مطابق extract کرتا ہے، اس لیے redesigns کو بہتر طور پر برداشت کرتا ہے۔ Maintenance فی site selectors سے cost اور output validation کی طرف منتقل ہو جاتی ہے۔ access layer، یعنی pages کو fetch کرنا، وہی رہتی ہے، اور scaling اب بھی اسی جگہ ٹوٹتی ہے۔
کیا AI اسکریپنگ کے لیے اب بھی پراکسیز کی ضرورت ہوتی ہے؟
ہاں۔ LLM content کو parse کرتا ہے لیکن pages fetch نہیں کرتا یا blocks bypass نہیں کرتا۔ Fetching عام web access ہے، اور sites rate-limit کرتی ہیں، geo-personalize کرتی ہیں، اور datacenter IPs کو flag کرتی ہیں۔ Residential proxies وہ access layer ہیں جو fetch کو حقیقی consumer IPs کے ذریعے route کرتی ہیں تاکہ pages کم IP-based blocking کے ساتھ آپ کے extractor تک پہنچیں۔
AI اسکریپنگ کب روایتی اسکریپنگ کے مقابلے میں زیادہ مناسب ہوتی ہے؟
AI extraction اپنی token cost messy، varied، یا frequently changing targets پر justify کرتی ہے: ایک schema کے ساتھ بہت سی sites، یا ایسے layouts جو اکثر redesign ہوتے ہیں۔ Traditional selectors high-volume uniform pages کے لیے سستے اور تیز ہیں۔ زیادہ تر mature stacks hybrid ہوتے ہیں: bulk کے لیے selectors، messy edge cases کے لیے AI، ایک ہی access layer پر۔
کیا AI اسکریپنگ قانونی ہے؟
pages کو parse کرنے کے لیے LLM استعمال کرنے سے rules نہیں بدلتے؛ یہ کسی بھی scraping جیسے ہی قانون کی پیروی کرتی ہے۔ public، non-personal data کو ترجیح دیں، site terms اور robots.txt کا احترام کریں، access controls کو bypass نہ کریں، requests کو pace کریں، اور provenance track کریں۔ Public availability copyright یا privacy questions کو ختم نہیں کرتی؛ legality jurisdiction، source، اور use پر منحصر ہے۔ legitimate collection کے لیے proxies استعمال کرنا عموماً lawful ہے۔ Legal advice نہیں۔
نتیجہ
AI اسکریپنگ انفراسٹرکچر نازک حصے، یعنی parsing، کو ہاتھ سے لکھے گئے selectors سے ایک ایسے LLM کی طرف منتقل کرتا ہے جو معنی کے لحاظ سے پڑھتا ہے، جس سے stack زیادہ resilient ہو جاتا ہے اور ہر site کے لیے maintenance کم ہو جاتی ہے۔ لیکن یہ صرف ایک layer کو تبدیل کرتا ہے: آپ اب بھی pages fetch کرتے ہیں، جہاں مناسب ہو token cost ادا کرتے ہیں، legal line کا احترام کرتے ہیں، اور اب بھی ایک ایسی access layer پر چلتے ہیں جو pages کو scale پر reachable رکھتی ہے۔ اپنی extraction اور validation بنائیں؛ residential-proxy access layer کرائے پر لیں۔ اجزا دیکھیں: AI ویب اسکریپنگ، بہترین AI ویب اسکریپرز، اور AI کے لیے ویب ڈیٹا انفراسٹرکچر۔
آخری اپ ڈیٹ: June 28, 2026.