
In this Article
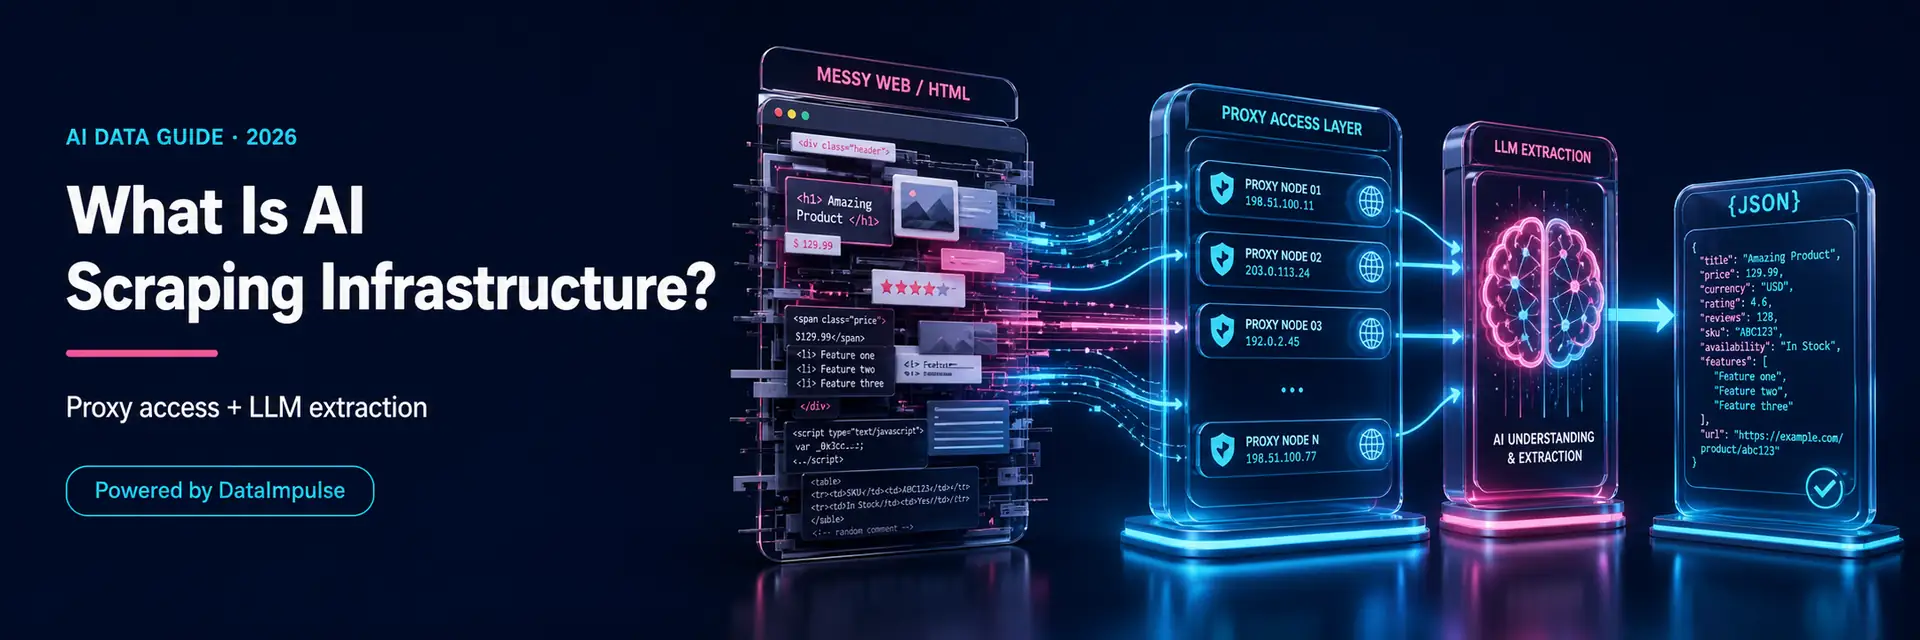
L’infrastruttura di AI scraping è lo stack moderno per raccogliere dati web usando l’AI per il parsing: un livello di accesso tramite proxy che raggiunge le pagine, l’estrazione basata su LLM che trasforma HTML disordinato in dati strutturati e l’orchestrazione che li coordina. È il passaggio da scraper fragili, selettore per selettore, a sistemi in cui un modello legge le pagine in base al significato. Ma l’AI cambia un solo livello: devi comunque recuperare le pagine, e si tratta ancora del normale accesso al web. Questa guida definisce l’infrastruttura di AI scraping, i suoi componenti, le differenze rispetto allo scraping tradizionale e il ruolo dei proxy.
Sono Andrii Byzov, Fractional CMO AI-Native e realizzo pipeline di dati web. Di seguito trovi una definizione semplice, i livelli, il cambiamento che l’AI introduce davvero e il livello di accesso alla base di tutto. Fa parte della infrastruttura di dati web per l’AI.
Punti chiave
- Infrastruttura di AI scraping = livello di accesso + estrazione AI + orchestrazione: lo stack per raccogliere dati web con il parsing basato su LLM.
- L’AI cambia il parsing, non l’accesso. Il modello sostituisce i selettori fragili; recuperi comunque le pagine nel modo consueto.
- È più resiliente. L’estrazione con LLM tollera le modifiche al layout che compromettono gli scraper basati su selettori.
- Il compromesso è il costo. Le chiamate LLM sono fatturate per token, quindi l’estrazione AI è adatta a target disordinati o eterogenei; i selettori restano più economici per grandi volumi uniformi.
- I proxy rimangono il livello di accesso. Il modello di estrazione non recupera le pagine: i residential proxy gestiscono l’accesso IP/geolocalizzato (non CAPTCHA, fingerprint o barriere di autenticazione).
Cos’è l’infrastruttura di AI scraping?
È il sistema end-to-end che trasforma il web aperto in dati strutturati usando l’AI per la fase di estrazione. Uno scraper tradizionale trova i dati con selettori codificati in modo rigido (.price); l’AI scraping passa la pagina a un modello che estrae comprendendo il contenuto. La parte di “infrastruttura” è tutto ciò che circonda quel modello: recuperare le pagine in modo affidabile e su larga scala, fornirle all’estrattore, convalidare l’output e consegnarlo. È la forma pronta per la produzione dell’AI web scraping: non un singolo script, ma uno stack.
In cosa differisce dall’infrastruttura di scraping tradizionale
- Parsing. Gli scraper tradizionali si rompono quando cambia il markup; l’estrazione con LLM legge in base al significato, quindi tollera meglio i redesign (anche se richiede comunque convalida e nuovi tentativi).
- Manutenzione. Gli scraper basati su selettori richiedono manutenzione per ciascun sito; l’estrazione AI richiede meno codice specifico per sito, ma maggiore attenzione ai costi e alla convalida dell’output.
- Struttura dei costi. I selettori sono economici da eseguire; l’estrazione con LLM viene fatturata per token, spostando il punto in cui si concentra la spesa.
- Cosa resta uguale. I vincoli dell’accesso al web rimangono: recuperare le pagine ed essere bloccati, anche se l’implementazione di fetch/render può differire, e l’accesso resta il punto in cui la scalabilità si interrompe.
I componenti
Livello di accesso (proxy). Raggiungere le pagine dal luogo giusto senza essere bloccati: è invariato rispetto a qualsiasi stack di scraping e resta il vincolo determinante su larga scala.
Fetch & render. Recupero dell’HTML, gestione dei contenuti dinamici e della paginazione.
Estrazione AI. Un LLM che trasforma il contenuto della pagina in dati strutturati rispetto a uno schema: è il livello che l’AI cambia realmente.
Convalida e consegna. Verifica dell’output rispetto a uno schema (il solo parsing non è una prova), gestione dei nuovi tentativi e consegna di dati puliti a valle.
import requests
# The AI scraping stack in miniature: PROXY fetches the page (access layer),
# the LLM extracts structure (parsing layer). Two separate jobs.
proxies = {"http": "http://LOGIN__cr.us:[email protected]:823",
"https": "http://LOGIN__cr.us:[email protected]:823"}
def scrape(url, schema):
html = requests.get(url, proxies=proxies,
headers={"User-Agent": "Mozilla/5.0"}, timeout=30).text
return extract_with_llm(html, schema) # your model returns validated JSON
data = scrape("https://example.com/product/1", {"title": "str", "price": "float"})
Dove entrano in gioco i proxy
L’equivoco più comune sull’AI scraping è che il modello gestisca tutto. Non è così: il modello di estrazione analizza il contenuto, ma non recupera le pagine né supera i blocchi, a meno che non sia abbinato a un livello di navigazione/strumenti. Il recupero è ancora normale accesso al web: i siti target limitano la frequenza, personalizzano in base alla geolocalizzazione e segnalano gli IP datacenter, quindi la raccolta su larga scala incontra le stesse barriere di qualsiasi scraping. I residential proxy sono il livello di accesso: instradano il recupero attraverso IP reali di utenti nel mercato giusto, così le pagine raggiungono il tuo estrattore con meno blocchi basati su IP (gestiscono l’accesso IP/geolocalizzato, non CAPTCHA, fingerprint o barriere di autenticazione): DataImpulse residential da $1/GB (mobile da $2/GB) in oltre 195 località. L’AI cambia il modo in cui fai il parsing; i proxy sono il modo in cui raggiungi le pagine. Consulta i migliori proxy per AI scraping per questo livello.
Quando l’infrastruttura di AI scraping è adatta
L’estrazione AI giustifica il costo per token su target disordinati, eterogenei o che cambiano spesso: molti siti con uno schema, layout sottoposti spesso a redesign o pagine non strutturate per le quali i selettori sono poco pratici. Per pagine uniformi e ad alto volume (un sito, milioni di template identici), i selettori tradizionali restano più economici e veloci. Gli stack più maturi sono ibridi: selettori per la massa, estrazione AI per i casi limite disordinati, sopra un unico livello di accesso condiviso.
L’AI scraping è legittimo?
Usare un LLM per analizzare le pagine non cambia il quadro giuridico: la raccolta segue le stesse regole di qualsiasi scraping. Privilegia dati pubblici e non personali, rispetta i termini del sito e considera robots.txt come un segnale di policy, non aggirare login o controlli di accesso, dosa le richieste e traccia la provenienza dei dati che alimentano un modello. La disponibilità pubblica non risolve le questioni di copyright, contratto o privacy, e la legittimità dipende dalla giurisdizione, dalla fonte e dall’uso. L’uso dei proxy non è intrinsecamente illecito, ma dipende dal caso d’uso e dalla legge applicabile; il rischio emerge quando si eludono divieti o controlli di accesso. Consulta se il web scraping è legittimo. Queste sono informazioni generali, non consulenza legale.
Domande frequenti
Cos’è l’infrastruttura di AI scraping?
È lo stack per raccogliere dati web usando l’AI per l’estrazione: un livello di accesso tramite proxy che raggiunge le pagine, l’estrazione basata su LLM che trasforma HTML disordinato in dati strutturati e l’orchestrazione, la convalida e la consegna che li coordinano. È la forma pronta per la produzione dell’AI web scraping: non uno script, ma un sistema.
In cosa differisce dallo scraping tradizionale?
Cambia il livello di parsing: invece di selettori codificati in modo rigido che si rompono quando cambia il markup, un LLM estrae in base al significato e quindi tollera meglio i redesign. La manutenzione si sposta dai selettori per sito ai costi e alla convalida dell’output. Il livello di accesso, cioè il recupero delle pagine, resta lo stesso ed è ancora il punto in cui la scalabilità si interrompe.
Servono ancora i proxy per l’AI scraping?
Sì. L’LLM analizza il contenuto ma non recupera le pagine né aggira i blocchi. Il recupero è normale accesso al web e i siti limitano la frequenza, personalizzano in base alla geolocalizzazione e segnalano gli IP datacenter. I residential proxy sono il livello di accesso che instrada il recupero attraverso IP reali di utenti, così le pagine raggiungono il tuo estrattore con meno blocchi basati su IP.
Quando conviene l’AI scraping rispetto a quello tradizionale?
L’estrazione AI giustifica il costo per token su target disordinati, eterogenei o che cambiano spesso: molti siti con uno schema o layout sottoposti spesso a redesign. I selettori tradizionali sono più economici e veloci per pagine uniformi ad alto volume. Gli stack più maturi sono ibridi: selettori per la massa, AI per i casi limite disordinati, sopra un livello di accesso.
L’AI scraping è legittimo?
Usare un LLM per analizzare le pagine non cambia le regole: segue la stessa legge di qualsiasi scraping. Privilegia dati pubblici e non personali, rispetta i termini del sito e robots.txt, non aggirare i controlli di accesso, dosa le richieste e traccia la provenienza. La disponibilità pubblica non risolve le questioni di copyright o privacy; la legittimità dipende dalla giurisdizione, dalla fonte e dall’uso. L’uso di proxy per una raccolta legittima è generalmente lecito. Non è consulenza legale.
Conclusione
L’infrastruttura di AI scraping sposta la parte fragile, il parsing, dai selettori scritti a mano a un LLM che legge in base al significato, rendendo lo stack più resiliente e con meno manutenzione per sito. Ma cambia un solo livello: recuperi comunque le pagine, paghi comunque il costo per token dove ha senso, rispetti comunque il confine giuridico e usi comunque un livello di accesso che mantiene le pagine raggiungibili su larga scala. Sviluppa l’estrazione e la convalida; noleggia un livello di accesso con residential proxy. Esplora i componenti: AI web scraping, i migliori scraper AI per il web e infrastruttura di dati web per l’AI.
Ultimo aggiornamento: 28 giugno 2026.