
この記事の内容
SessionとHTTPAdapter、urllib3のRetryポリシーを組み合わせてpython requests retryを実装し、各呼び出しに明示的なタイムアウトを設定します。再送の安全性、試行回数、サーバー側のペース配分は、同じ設計の中で一緒に考えましょう。
まずは、検証済みの以下のスクリプトから始めてください。2026年10月16日に行った簡易テストでは、制御されたローカル障害に対する挙動を確認しました。すべてのリトライ後も失敗のままだった永続的な503も含まれます。
重要なポイント
- HTTPAdapterにurllib3のRetryをマウントすると、requests.Sessionのすべての呼び出しにリトライが加わります。
- 503、503、200を返すエンドポイントは、ローカルテストで1.2秒後の3回目の試行で成功しました。
- Retry-After: 2を伴う429では、リトライ前にちょうど2.0秒待機しました。
- 恒久的に失敗するエンドポイントは、ループせずに6回の試行と15.7秒で停止しました。
- POSTはデフォルトではリトライされません。冪等な呼び出しにのみ追加してください。
- Tenacityを使えば、任意の関数に同じパターンを適用でき、待機もすべてログに残せます。
Python Requestsのリトライはどう実装しますか?
HTTPとHTTPSの両方にリトライ設定済みのアダプターをマウントし、そのSessionを通じて呼び出します。以下が検証済みのrequests_retry.pyです。実行前に、後述のローカルサーバーを起動してください。
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")Requestsは、デフォルトでは失敗した接続をリトライしません。Sessionは設定を保持して接続をプールし、マウントされたHTTPAdapterがリトライポリシーをurllib3に渡します。詳しくはRequestsの高度な使い方をご覧ください。
この計測用スクリプトは、エラーを含む最終的なレスポンスを出力します。アプリケーションのコードでは、成功した結果を使用する前にraise_for_status()を呼び出し、最終的なRequestExceptionの失敗は呼び出し側の境界で処理してください。リセット呼び出しはローカルのセットアップ用で、明示的なタイムアウトがありません。この省略をリモート呼び出しにそのまま持ち込まないでください。詳しくはRequestsのエラー処理をご覧ください。
Python Requestsのリトライはどの失敗を対象にすべきですか?
消える可能性がある失敗に限り、しかも操作を繰り返しても問題ない場合にのみリトライします。設定を選ぶ前に、次の4ステップのリトライ安全性チェックを行ってください。
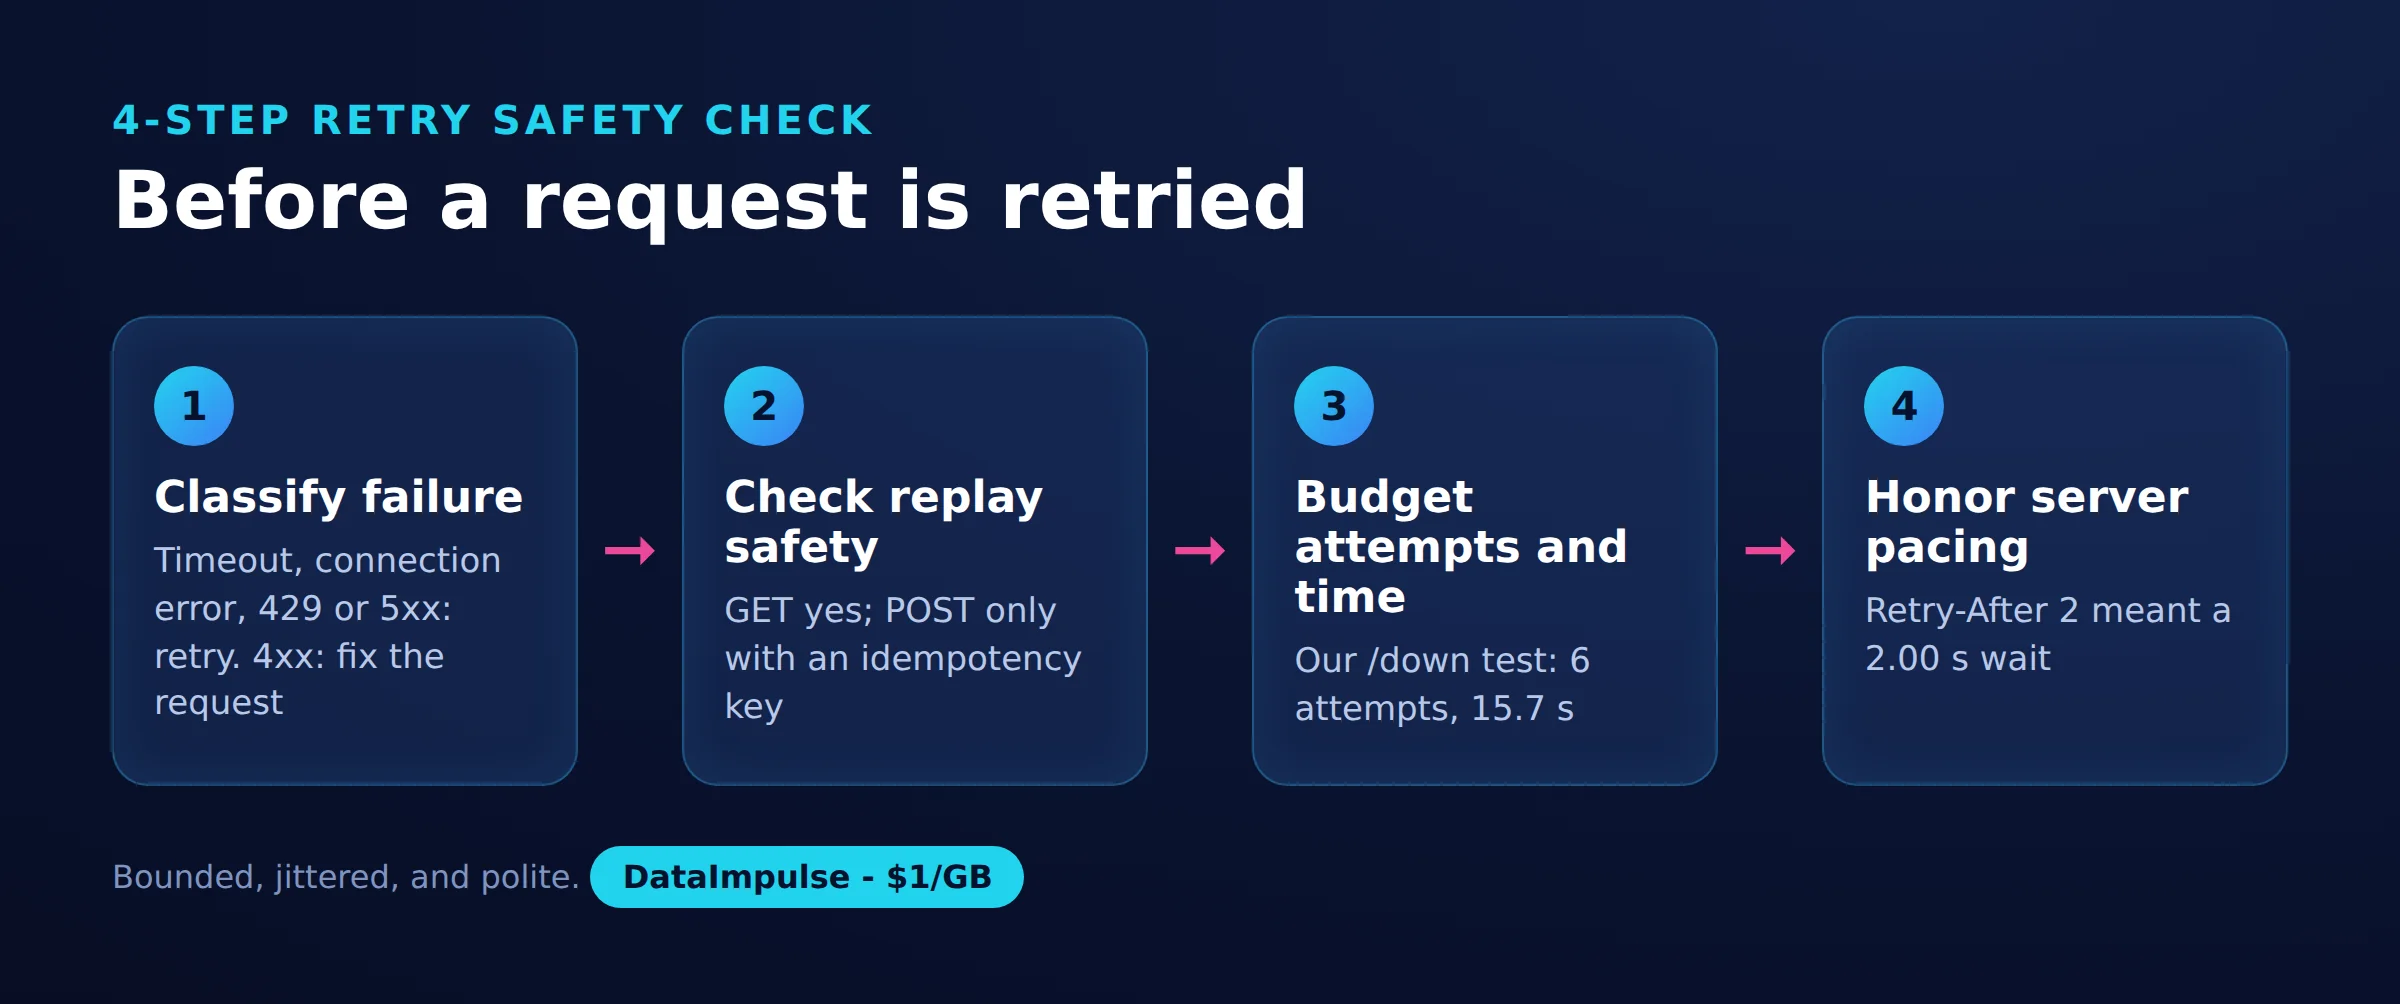
- ステップ1:失敗を分類する。接続の失敗、読み取りの失敗、HTTPレスポンスを切り分けます。ここでの候補ステータスは429、500、502、503、504です。エンドポイントの仕様に照らして見直してください。
- ステップ2:再送の安全性を確認する。もう一度リクエストを送ると、書き込みなどの副作用が重複しないかを判断します。
- ステップ3:試行回数と時間の予算を決める。リトライを有効にする前に、最大呼び出し回数、許容できる待機時間、呼び出し側の期限を定めます。
- ステップ4:サーバーのペース配分に従う。Retry-Afterを尊重し、必要な待機時間が予算を超える場合は処理を停止または延期します。
リトライをあらゆる問題の万能な解決策として使わないでください。403レスポンスや407プロキシ認証エラーは、別途調査が必要です。python requests retryの方針は、アクセス条件と適用されるデータ関連のルールを守るものにしてください。
指数バックオフとジッターはどう機能しますか?
指数バックオフは失敗が続くたびに待機時間を延ばし、ジッターはそこにランダム性を加えます。今回の設定では、基本の待機時間は0、1、2、4、8秒でした。
1から数えたリトライ回数kに対し、urllib3の最初のバックオフは0です。2回目以降はbackoff_factor * 2**(k-1)を使います。そこに0からbackoff_jitterまでの一様なジッターを加え、backoff_maxの上限が適用されます。これらの設定項目はurllib3 2.0.7のリファレンスに記載されています。
今回の環境ではurllib3 2.0.7を使用しており、backoff_jitterが使えます。互換性を決めつけず、お使いのバージョンに合わせてサンプルを調整してください。増加の度合いは係数で調整し、リトライの分散はジッターの範囲で調整します。独自の待機ポリシーが必要な場合は、意図して選んだリトライ層に実装するのが適切です。
観測されたflakyエンドポイントの1.20秒という結果は、1回の乱数と、ローカル実行のオーバーヘッドを反映したものです。お使いのAPIのレイテンシを予測するものではありません。
429とRetry-Afterはどう扱うべきですか?
操作を中止すべき場合を除き、有効なRetry-Afterの値に従って待ってから再試行します。このヘッダーには、待機秒数かHTTP-dateのいずれかを指定できます。詳しくはMDNのRetry-Afterリファレンスをご覧ください。
ヘッダー処理を有効にすると、urllib3は正の値のRetry-Afterを、計算したバックオフより優先して使います。使える正の値がない場合は指数バックオフが適用されます。不正な形式のヘッダーには、明示的なエラー処理が必要です。詳しくはurllib3のsleepの動作をご覧ください。
ローカルの429は2秒の待機を要求し、次の試行は2.00秒後に成功しました。このスクリプトには全体の期限を強制する仕組みがありません。サーバーが操作の許容範囲を超える待機を求めてきた場合は、要求された待機時間を短縮せず、処理を停止するか再スケジュールしてください。この対応は、APIレート制限のポリシーとあわせて計画しましょう。
接続タイムアウトと読み取りタイムアウトはリトライにどう影響しますか?
タイムアウトが制限するのは特定の待機段階であり、操作全体ではありません。接続の確立、レスポンスの読み取り、繰り返しの試行、バックオフのすべてが経過時間に加算されます。
timeout=(3.05, 10)では、最初の値が接続の待機を、2番目の値が読み取り時の無通信時間を制御します。どちらも実時間の期限ではありません。また、Requestsにはデフォルトのタイムアウトがありません。詳しくはRequestsのタイムアウトの仕様をご覧ください。
今回の5回のリトライ予算では、6回の試行が可能でした。接続と読み取りのカウンターは、この全体の予算の範囲内でそれぞれの失敗の種類を制限するもので、追加の許容回数を与えるものではありません。Retryの予算制御には、リトライを防ぐtotal=0が含まれます(2026年10月時点)。
ボディ読み取りの失敗がすべて再送されると思い込まないでください。Requestsのアダプターのソースコードはpreload_content=Falseを渡しているため、その後のボディ読み込み中に起きた失敗は、アダプターのリトライの範囲外で発生することがあります。中断されたボディは別途テストし、厳密な期限は、操作を停止できるアプリケーションの境界で強制してください。
POSTリクエストを安全にリトライできますか?
POSTのタイムアウトだけでは、再送が安全だとは言い切れません。クライアントがレスポンスを受け取れなくなる前に、サーバー側で書き込みが完了している場合があります。
再送してよいのは、APIが冪等な動作を文書化している場合や、その操作を対象とした重複排除の仕組みがある場合だけです。その保証のもとで、同じ操作の識別子とペイロードを再利用してください。任意の冪等性ヘッダーを追加しても、保証が生まれるわけではありません。この考え方は、HTTPの冪等性に関する仕様にある再送の考慮事項に基づいています。
urllib3のデフォルトのメソッド集合にはPOSTが含まれません。今回はさらに絞り、ステータスと読み取りのリトライの対象をGET、HEAD、OPTIONSのみにしています。ただし、メソッドによる絞り込みは、送信前の接続リトライを一律に禁止するものではありません。詳しくはRetryのメソッドと失敗の分類をご覧ください。この例は読み取り処理に絞っています。
試行のログはどう記録し、リトライ上限に達した原因をどう診断しますか?
失敗の種類、試行回数、選択された待機時間、経過時間、最終的な結果を記録します。完全なURLの代わりに、無害化したルートのラベルを使ってください。
これらのスクリプトでは、害のないlocalhostへのリクエストに対して診断ログを有効にしています。流用する前に、ログと例外から機密性のあるURLの要素を取り除いてください。Tenacityの例では、例外メッセージにURLが含まれています。認証情報、認可ヘッダー、非公開のレスポンスボディは、決してログに残さないでください。
永続的な503がレスポンスとして残ったのは、raise_on_status=Falseを指定したためです。通信レベルの失敗では、引き続き例外が発生することがあります。Requestsは下位の失敗をConnectionError、ConnectTimeout、RetryErrorなどの型に変換します。また、整数のmax_retriesでは、ここで示した明示的なステータスポリシーは表現できません。詳しくはアダプターの実装をご覧ください。
呼び出しが、設定したSessionと対応するマウントを使っているか確認してください。使い終わったらSessionを閉じ、ネットワーク固有の失敗はプロキシのトラブルシューティングガイドで調査しましょう。すでにリトライするクライアントの外側に、さらにリトライのループを追加するのは避けてください。
urllib3のRetry、Tenacity、backoffはどう使い分けますか?
リトライを担う層は1つに決めましょう。HTTPのポリシーにはトランスポートの設定を使い、アプリケーションの結果に応じて処理を繰り返すかどうかを決める場合は、関数のラッパーを使います。
| 選択肢 | 使うとよい場合 | 避けるべき場合 |
|---|---|---|
| urllib3 Retry | トランスポートとステータスのポリシーで足りる場合に使います。 | アプリケーションのワークフロー全体をリトライする場合は避けます。 |
| Tenacity | 独自の結果、例外、コルーチンによってリトライを制御する場合に使います。 | すでにリトライするクライアントを、予算を調整せずにラップする場合は避けます。 |
| backoff | デコレーターによるポリシーが適している場合に使います。 | 設定なしでHTTPステータスが自動的に分類されることを期待する場合は避けます。 |
Retryは、HTTPの絞り込みを一箇所にまとめます。Tenacityは、リトライ、待機、停止のポリシーを分離でき、コルーチンのリトライにも対応し、ログ用のコールバックも備えています。stop_after_attemptは、最初の呼び出しも含めて呼び出し回数を数えます(2026年10月時点)。詳しくはTenacityのドキュメントと待機ポリシーのリファレンスをご覧ください。
検証済みのtenacity_retry.pyは、同じflakyなGETをタイミングを変えて繰り返します。429については同等ではありません。Retry-Afterを確認しないためです。
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
ここでは、選択したステータスが例外に変換され、待機には指数ジッターが使われ、上限に達すると最後の例外が再送出されます。接続例外の範囲が広いため、エンドポイントごとの見直しが必要です。
比較のために触れておくと、backoffはon_exceptionまたはon_predicateと待機ジェネレーターを組み合わせて使います。ドキュメントによるデフォルトのジッターはフルジッターです。ステータスの絞り込みには、独自の述語か例外のポリシーが必要です。max_triesは呼び出しの合計回数を制限します(2026年10月時点)。詳しくはbackoffの公式リポジトリをご覧ください。backoffは計測していません。
再現可能な簡易リトライテストでは何がわかりますか?
2026年10月16日に行った簡易テストでは、復旧、サーバー指示による待機、リトライ上限への到達を確認できました。これは小規模なスナップショットであり、ベンチマークではありません。
AndriiはLinux、Python 3.12、requests 2.31.0、urllib3 2.0.7、tenacity 9.1.4で実行しました。ソースはrequests_retry.py、tenacity_retry.py、retry_server.pyで、ここに再掲しています。サンプルは、urllib3ではエンドポイントごとに1回の実行、Tenacityではflakyエンドポイントに1回の実行で、スクリプトの間にローカルのカウンターをリセットしました。すべての通信は127.0.0.1の内部にとどまっています。
| ポリシーとエンドポイント | 最終ステータス | 試行回数 | 経過時間 |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0.00秒 |
| urllib3 /flaky | 200 | 3 | 1.20秒 |
| urllib3 /limited | 200 | 2 | 2.00秒 |
| urllib3 /down | 503 | 6 | 15.69秒 |
| Tenacity /flaky | 200 | 3 | 3.82秒 |
Tenacityが記録した待機は1.36秒と2.45秒でした。所要時間の違いは待機設定の違いによるもので、この結果からライブラリの優劣を判断することはできません。繰り返しの試行、同時接続のクライアント、リモート接続、実際に測定したタイムアウト失敗はありません。
一方のターミナルでretry_server.pyを実行し、もう一方のターミナルで各クライアントを個別に実行してください。
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
帯域幅は計測していません。計画の目安としては、各試行のリクエスト、レスポンス、プロトコルのバイト数を合計して、転送量を見積もってください。同じサイズのやり取りが6回あれば、1回分のおよそ6倍になります。ただし、実際のエラーボディのサイズは異なります。
今後は、シード付きのシミュレーションで、独自のジッターとライブラリのポリシーを同じ試行予算のもとで比較できます。その際は、レイテンシ、スケジュールの衝突、シミュレーション上の成功確率を記録します。これらはシミュレーションによる指標であり、今回の実測の表とは別のものです。
よくある質問
Python Requestsは自動的にリトライしますか?
失敗した接続については、デフォルトではリトライしません。アダプターを意図的に設定し、制御された障害に対して動作を確認してください。
Session、HTTPAdapter、urllib3 Retryはどう連携しますか?
Sessionは、リクエストURLに対してマウント済みのアダプターを選びます。アダプターは、リトライポリシーをurllib3のトランスポート呼び出しに渡します。
指数バックオフの待機時間はどう計算されますか?
係数0.5では、基本の待機時間は0、1、2、4、8秒になりました。ジッターは後の待機に影響するため、繰り返し実行しても、計測した経過時間と一致するとは限りません。
Pythonで429とRetry-Afterはどう扱うべきですか?
操作に余裕がある場合は、要求どおりに待機します。そうでない場合は、早めにリトライするのではなく、操作を停止または延期してください。
タイムアウト後にPOSTをリトライしても安全ですか?
タイムアウトが起きると、書き込みの結果は不確かなままです。再送する前に、APIごとの再送の保証を確認してください。
これらのスクリプトは全体の期限を強制していましたか?
いいえ。試行のポリシーと呼び出しごとのタイムアウトだけでは、経過時間の厳密な上限は設定されません。
リトライポリシーに加えてプロキシも必要ですか?
許可された用途でプロキシ経由のルーティングが必要な場合は、Python Requests向けのプロキシの選択肢とDataImpulseのレジデンシャルプロキシをご確認ください。DataImpulseが提供するのはプロキシであり、スクレイピングAPI、マネージド型のアンブロッカー、VPN、データセットではありません。再送の判断、ペース配分、失敗の処理は、クライアント側で行ってください。
最終更新日:2026年10月16日