
اس مضمون میں
Session، HTTPAdapter اور urllib3 Retry پالیسی کے ساتھ python requests retry نافذ کریں، پھر ہر کال پر واضح ٹائم آؤٹ مقرر کریں۔ دوبارہ بھیجنے کی حفاظت، کوششوں کی تعداد اور سرور کی رفتار کو ایک ہی ڈیزائن میں رکھیں۔
نیچے دیے گئے آزمودہ اسکرپٹس سے آغاز کریں۔ 16 اکتوبر 2026 کی ہماری مختصر آزمائش دکھاتی ہے کہ قابو میں رکھی گئی مقامی ناکامیوں کے مقابلے میں کیا ہوا، جن میں ایک مستقل 503 بھی شامل ہے جو ہر ری ٹرائی کے بعد بھی ناکامی ہی رہا۔
اہم نکات
- HTTPAdapter پر لگایا گیا urllib3 Retry، requests.Session کی ہر کال میں ری ٹرائی شامل کر دیتا ہے۔
- 503، 503، 200 دینے والا اینڈ پوائنٹ ہمارے مقامی ٹیسٹ میں 1.2 s بعد تیسری کوشش پر کامیاب ہوا۔
- Retry-After: 2 کے ساتھ آنے والے 429 نے ری ٹرائی سے پہلے ٹھیک 2.0 s انتظار کیا۔
- مستقل ناکام رہنے والا اینڈ پوائنٹ لامتناہی چکر میں پڑنے کے بجائے 6 کوششوں اور 15.7 s کے بعد رک گیا۔
- POST بطور ڈیفالٹ دوبارہ نہیں بھیجا جاتا؛ اسے صرف idempotent کالز کے لیے شامل کریں۔
- Tenacity کسی بھی فنکشن کے لیے یہی طریقہ فراہم کرتا ہے، اور ہر انتظار لاگ ہوتا ہے۔
Python Requests Retry کیسے نافذ کیا جائے؟
HTTP اور HTTPS دونوں کے لیے ری ٹرائی سے لیس ایڈاپٹر ماؤنٹ کریں، پھر اسی Session کے ذریعے کال کریں۔ یہ ہماری آزمودہ requests_retry.py ہے؛ اسے چلانے سے پہلے آگے دکھایا گیا مقامی سرور شروع کریں۔
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
Requests بطور ڈیفالٹ ناکام کنکشنز کو دوبارہ نہیں آزماتا۔ Session سیٹنگز کو محفوظ رکھتا ہے اور کنکشنز کا پول بناتا ہے؛ اس کا ماؤنٹ کیا ہوا HTTPAdapter ری ٹرائی پالیسی urllib3 تک پہنچاتا ہے۔ دیکھیں Requests کا ایڈوانسڈ استعمال۔
یہ پیمائشی اسکرپٹ آخری رسپانس پرنٹ کرتا ہے، بشمول غلطیوں کے۔ ایپلیکیشن کوڈ میں کامیاب نتیجہ استعمال کرنے سے پہلے raise_for_status() کال کریں اور آخری RequestException ناکامیوں کو کال کرنے والے کی حد پر سنبھالیں۔ reset کال مقامی سیٹ اپ ہے اور اس میں واضح ٹائم آؤٹ نہیں ہے؛ یہ کمی ریموٹ کالز میں نقل نہ کریں۔ دیکھیں Requests میں غلطیوں کی ہینڈلنگ۔
Python Requests Retry کو کن ناکامیوں کو سنبھالنا چاہیے؟
صرف ان ناکامیوں پر ری ٹرائی کریں جو غالباً خود ختم ہو سکتی ہیں، اور صرف اس وقت جب عمل کو دہرانا قابل قبول ہو۔ سیٹنگز چننے سے پہلے یہ ری ٹرائی کی حفاظت کی 4 مراحل والی جانچ استعمال کریں۔
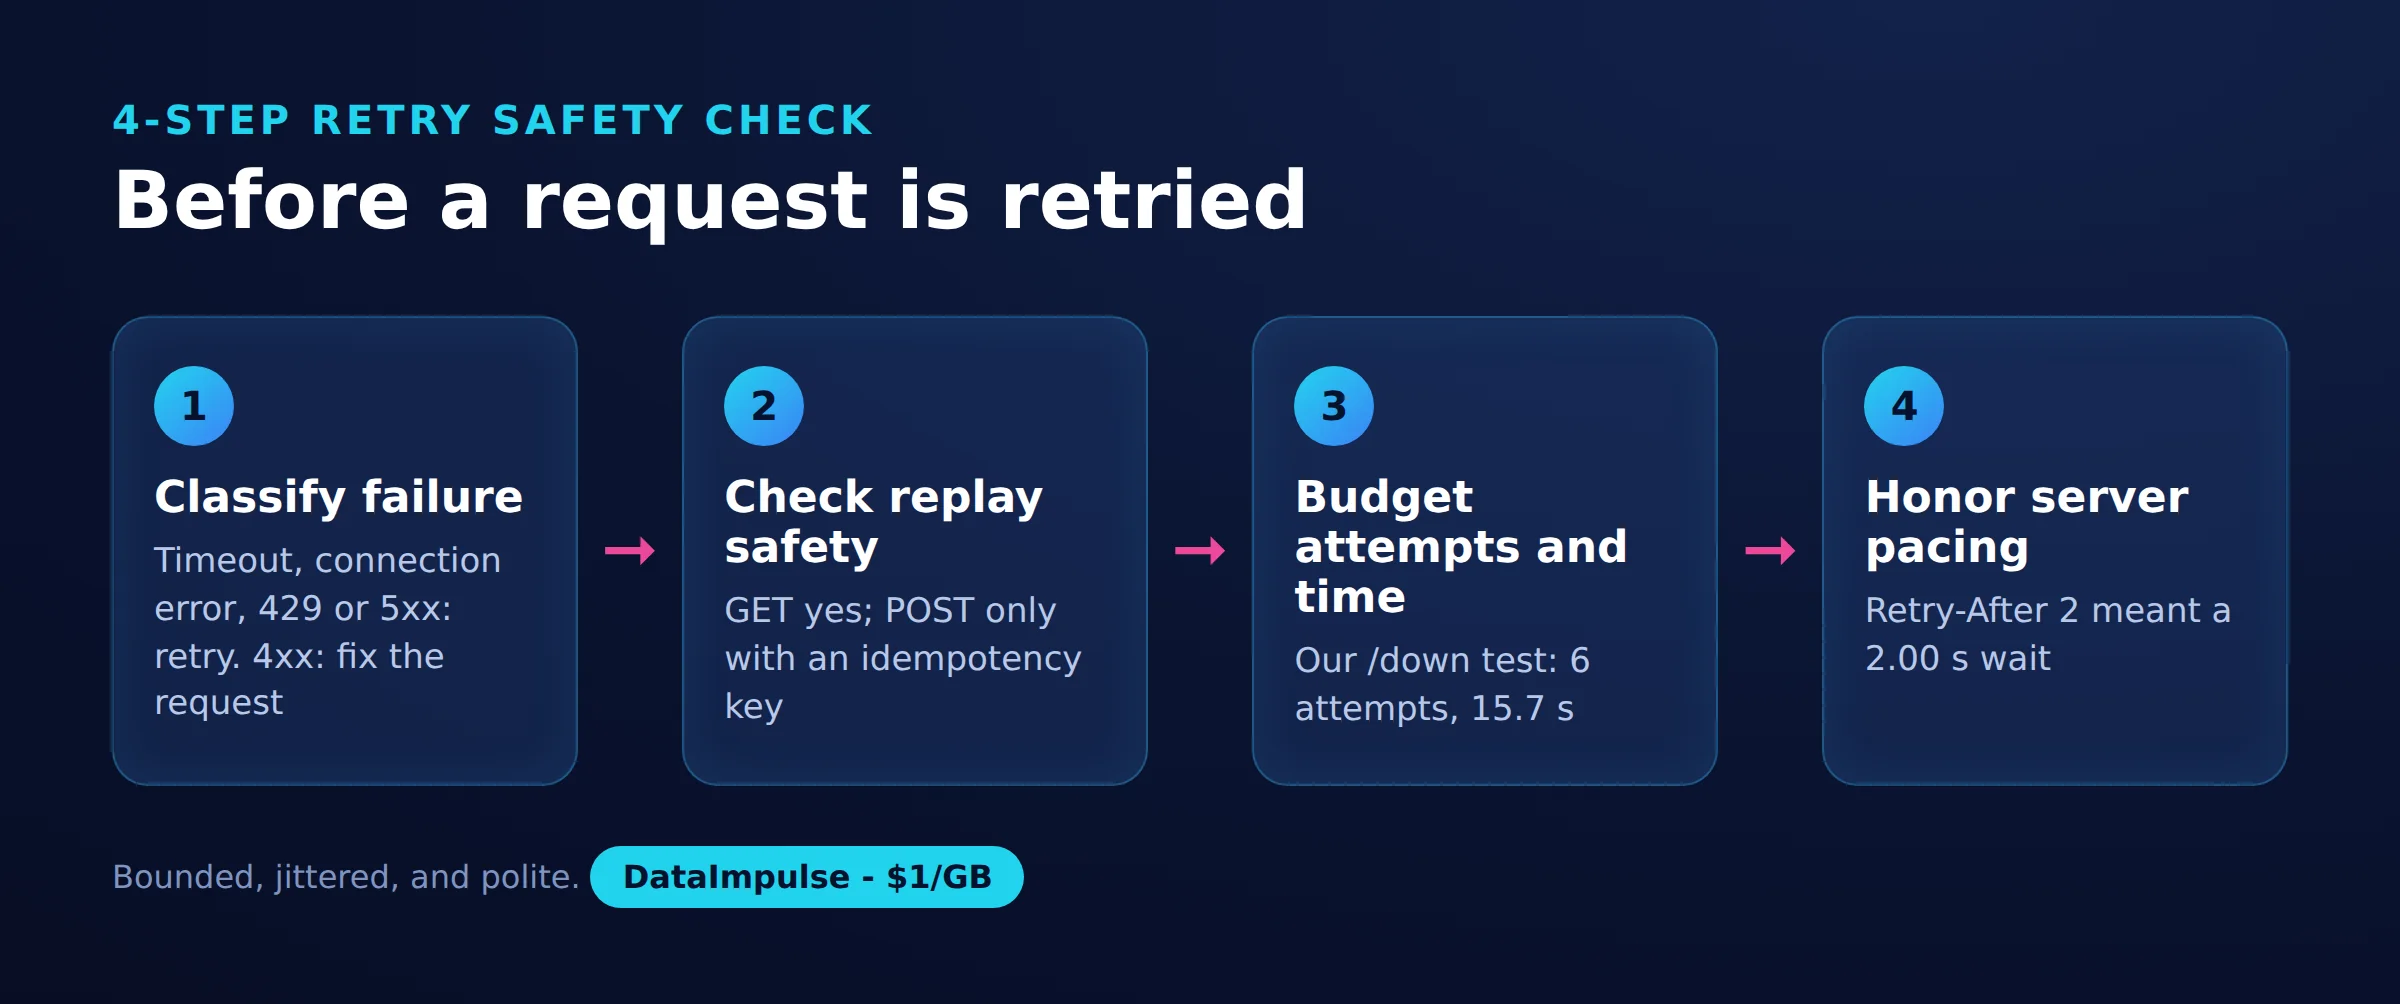
- مرحلہ 1: ناکامی کی درجہ بندی کریں۔ کنکشن کی ناکامیوں، ریڈ کی ناکامیوں اور HTTP رسپانسز کو الگ کریں۔ ہماری امیدوار اسٹیٹس فہرست 429، 500، 502، 503 اور 504 ہے؛ اسے اینڈ پوائنٹ کے معاہدے کے مطابق جانچ لیں۔
- مرحلہ 2: دوبارہ بھیجنے کی حفاظت دیکھیں۔ طے کریں کہ کیا ایک اور درخواست کسی رائٹ یا کسی دوسرے ضمنی اثر کو دہرا سکتی ہے۔
- مرحلہ 3: کوششوں اور وقت کا بجٹ بنائیں۔ ری ٹرائی چالو کرنے سے پہلے زیادہ سے زیادہ کالز، قابل قبول انتظار اور کال کرنے والے کی ڈیڈ لائن طے کریں۔
- مرحلہ 4: سرور کی رفتار کا احترام کریں۔ Retry-After کا لحاظ رکھیں، اور جب مطلوبہ انتظار آپ کے بجٹ سے بڑھ جائے تو کام روک دیں یا مؤخر کر دیں۔
ری ٹرائی کو ہر مسئلے کا حل نہ سمجھیں۔ 403 رسپانسز اور 407 پراکسی تصدیق کی غلطیوں کی الگ سے تحقیق کریں۔ python requests retry کی حکمت عملی کو رسائی کی شرائط اور قابل اطلاق ڈیٹا قواعد کا پاس رکھنا چاہیے۔
ایکسپونینشل بیک آف اور جٹر کیسے کام کرتے ہیں؟
ایکسپونینشل بیک آف بار بار ناکامی کے بعد تاخیر بڑھاتا ہے؛ جٹر اس میں بے ترتیبی شامل کرتا ہے۔ ہماری کنفیگریشن میں بنیادی انتظار 0، 1، 2، 4 اور 8 سیکنڈ تھا۔
ری ٹرائی نمبر k کے لیے، جو 1 سے شروع ہوتا ہے، urllib3 کا پہلا بیک آف صفر ہوتا ہے؛ بعد کی تاخیر backoff_factor * 2**(k-1) سے نکلتی ہے۔ اس میں صفر سے backoff_jitter تک یکساں جٹر شامل کریں، جو backoff_max کے تابع ہے۔ urllib3 2.0.7 کا ریفرنس ان کنٹرولز کی وضاحت کرتا ہے۔
ہمارے ماحول میں urllib3 2.0.7 تھا، جو backoff_jitter قبول کرتا ہے۔ مثال کو اپنے نصب شدہ ورژن سے ملا کر دیکھیں، مطابقت فرض نہ کریں۔ اضافے کو ایڈجسٹ کرنے کے لیے فیکٹر بدلیں اور ری ٹرائی کو پھیلانے کے لیے جٹر کی حد بدلیں؛ حسب ضرورت انتظار کی پالیسی کسی سوچ سمجھ کر چنی گئی ری ٹرائی لیئر میں ہونی چاہیے۔
مشاہدے میں آنے والا 1.20 سیکنڈ کا flaky نتیجہ ایک بے ترتیب قدر اور مقامی عمل درآمد کے اوور ہیڈ کو ظاہر کرتا ہے۔ یہ آپ کے API کی لیٹنسی کی پیش گوئی نہیں کرتا۔
429 اور Retry-After کو کیسے سنبھالا جائے؟
دوبارہ کوشش سے پہلے درست Retry-After قدر کا لحاظ رکھیں، سوائے اس کے کہ عمل کو روکنا ضروری ہو۔ یہ ہیڈر یا تو سیکنڈوں کی تاخیر قبول کرتا ہے یا HTTP-date، جیسا کہ MDN کے Retry-After ریفرنس میں بیان ہے۔
ہیڈر ہینڈلنگ چالو ہو تو urllib3 اپنے حساب شدہ بیک آف پر مثبت Retry-After تاخیر کو ترجیح دیتا ہے۔ قابل استعمال مثبت تاخیر نہ ہو تو ایکسپونینشل بیک آف لاگو ہوتا ہے؛ خراب ہیڈرز کے لیے واضح ایرر ہینڈلنگ درکار ہے۔ دیکھیں urllib3 کے sleep کا رویہ۔
ہمارے مقامی 429 نے دو سیکنڈ مانگے، اور اگلی کوشش 2.00 سیکنڈ بعد کامیاب ہوئی۔ اسکرپٹ میں مجموعی ڈیڈ لائن نافذ نہیں ہے: اگر سرور آپ کے عمل کی اجازت سے زیادہ انتظار مانگے تو اس کے مانگے ہوئے انتظار کو گھٹانے کے بجائے رک جائیں یا کام کو دوبارہ شیڈول کریں۔ اس رویے کی منصوبہ بندی اپنی API ریٹ لمیٹنگ پالیسی کے ساتھ کریں۔
کنکشن اور ریڈ ٹائم آؤٹ ری ٹرائی پر کیسے اثر انداز ہوتے ہیں؟
ٹائم آؤٹ کسی خاص انتظار والے مرحلے کو محدود کرتا ہے، پورے عمل کو نہیں۔ کنکشن قائم کرنا، رسپانس پڑھنا، بار بار کوششیں اور بیک آف سب گزرے ہوئے وقت میں شامل ہوتے ہیں۔
timeout=(3.05, 10) میں پہلی قدر کنکشن کے انتظار کو اور دوسری ریڈ کی غیر فعالیت کو کنٹرول کرتی ہے۔ ان میں سے کوئی بھی وال کلاک ڈیڈ لائن نہیں ہے؛ Requests میں ڈیفالٹ ٹائم آؤٹ بھی نہیں ہوتا۔ دیکھیں Requests میں ٹائم آؤٹ کے معنی۔
ہمارے پانچ ری ٹرائی کے بجٹ نے چھ کوششوں کی اجازت دی۔ کنکشن اور ریڈ کے کاؤنٹر اسی مجموعی بجٹ کے اندر اپنی اپنی ناکامی کی اقسام کو محدود کرتے ہیں، اضافی گنجائش نہیں دیتے۔ Retry کے بجٹ کنٹرولز میں total=0 شامل ہے جو ری ٹرائی کو روکتا ہے (اکتوبر 2026 تک)۔
یہ فرض نہ کریں کہ باڈی پڑھنے کی ہر ناکامی دوبارہ آزمائی جاتی ہے۔ Requests ایڈاپٹر کا سورس preload_content=False پاس کرتا ہے؛ باڈی کے بعد میں استعمال کے دوران ہونے والی ناکامیاں ایڈاپٹر کے ری ٹرائی سائیکل سے باہر ہو سکتی ہیں۔ منقطع باڈیز کو الگ سے ٹیسٹ کریں، اور کوئی بھی سخت ڈیڈ لائن ایپلیکیشن کی اس حد پر نافذ کریں جو عمل کو روک سکتی ہو۔
کیا POST درخواستوں کو محفوظ طریقے سے دوبارہ بھیجا جا سکتا ہے؟
صرف POST کا ٹائم آؤٹ یہ ثابت نہیں کر سکتا کہ دوبارہ بھیجنا محفوظ ہے۔ ممکن ہے سرور نے کلائنٹ کا رسپانس ضائع ہونے سے پہلے رائٹ مکمل کر لیا ہو۔
صرف اس وقت دوبارہ بھیجیں جب API idempotent رویے یا اس عمل کو کور کرنے والے ڈپلیکیشن سے بچاؤ کے نظام کی دستاویز دیتا ہو۔ اسی معاہدے کے تحت وہی آپریشن آئیڈنٹٹی اور پے لوڈ دوبارہ استعمال کریں؛ کوئی من مانا idempotency ہیڈر شامل کرنے سے ضمانت پیدا نہیں ہوتی۔ یہ HTTP کی idempotency کی تفصیل میں دوبارہ بھیجنے سے متعلق غور و فکر کے مطابق ہے۔
urllib3 کے ڈیفالٹ میتھڈ سیٹ میں POST شامل نہیں۔ ہمارا محدود سیٹ اسٹیٹس اور ریڈ ری ٹرائی کے لیے GET، HEAD اور OPTIONS کی اجازت دیتا ہے؛ میتھڈ فلٹرنگ ترسیل سے پہلے کنکشن کی ری ٹرائی پر عمومی پابندی نہیں ہے۔ دیکھیں Retry کے میتھڈ اور ناکامی کی اقسام۔ اس مثال کو ریڈ پر مرکوز رکھیں۔
کوششوں کو لاگ کیسے کریں اور ختم ہو جانے والی ری ٹرائی کی تشخیص کیسے کریں؟
ناکامی کی قسم، کوشش کا نمبر، منتخب کردہ انتظار، گزرا ہوا وقت اور آخری نتیجہ ریکارڈ کریں۔ مکمل URL کے بجائے صاف کیا ہوا روٹ لیبل استعمال کریں۔
اسکرپٹس بے ضرر localhost درخواستوں کے لیے تشخیصی لاگنگ چالو کرتے ہیں۔ انہیں اپنانے سے پہلے لاگز اور ایکسپشنز سے حساس URL اجزا ہٹا دیں؛ Tenacity کی مثال اپنے ایکسپشن میسج میں URL شامل کرتی ہے۔ اسناد، اتھارائزیشن ہیڈرز یا نجی رسپانس باڈیز کو کبھی لاگ نہ کریں۔
ہمارا مستقل 503 رسپانس ہی رہا کیونکہ raise_on_status=False تھا۔ ٹرانسپورٹ کی ناکامیاں پھر بھی ایکسپشن اٹھا سکتی ہیں؛ Requests بنیادی ناکامیوں کو ConnectionError، ConnectTimeout اور RetryError جیسی اقسام میں بدل دیتا ہے۔ عددی max_retries یہاں دکھائی گئی واضح اسٹیٹس پالیسی کو بھی بیان نہیں کرتا۔ دیکھیں ایڈاپٹر کی عمل درآمد۔
جانچ لیں کہ کالز آپ کے ترتیب دیے ہوئے Session اور متعلقہ ماؤنٹ کو استعمال کرتی ہیں۔ کام ختم ہونے پر اسے بند کریں، اور نیٹ ورک سے متعلق ناکامیوں کی تحقیق پراکسی ٹربل شوٹنگ گائیڈ سے کریں۔ پہلے سے ری ٹرائی کرنے والے کلائنٹ کے گرد دوسرا ری ٹرائی لوپ شامل کرنے سے گریز کریں۔
urllib3 Retry، Tenacity یا backoff کب استعمال کریں؟
ری ٹرائی کی ذمہ داری کے لیے ایک ہی لیئر چنیں۔ HTTP پالیسی کے لیے ٹرانسپورٹ کنفیگریشن استعمال کریں، اور جب ایپلیکیشن کے نتائج طے کریں کہ کام دہرانا ہے یا نہیں تو فنکشن ریپر استعمال کریں۔
| آپشن | X کب استعمال کریں… | X سے کب گریز کریں… |
|---|---|---|
| urllib3 Retry | جب ٹرانسپورٹ اور اسٹیٹس کی پالیسی موزوں ہو تو urllib3 Retry استعمال کریں۔ | جب پورے ایپلیکیشن ورک فلو کو دوبارہ چلانا ہو تو urllib3 Retry سے گریز کریں۔ |
| Tenacity | جب حسب ضرورت نتائج، ایکسپشنز یا کوروٹینز ری ٹرائی کو چلائیں تو Tenacity استعمال کریں۔ | جب بجٹ ہم آہنگ کیے بغیر پہلے سے ری ٹرائی کرنے والے کلائنٹ کو لپیٹنا ہو تو Tenacity سے گریز کریں۔ |
| backoff | جب ڈیکوریٹر پر مبنی پالیسی موزوں ہو تو backoff استعمال کریں۔ | جب بغیر کنفیگریشن کے خودکار HTTP اسٹیٹس درجہ بندی کی توقع ہو تو backoff سے گریز کریں۔ |
Retry، HTTP فلٹرنگ کو ایک جگہ جمع کر دیتا ہے۔ Tenacity ری ٹرائی، انتظار اور اسٹاپ کی پالیسیوں کو الگ کرتا ہے، کوروٹین ری ٹرائی کو سپورٹ کرتا ہے اور لاگنگ کال بیکس فراہم کرتا ہے۔ اس کا stop_after_attempt کالز گنتا ہے، پہلی کال سمیت (اکتوبر 2026 تک)۔ دیکھیں Tenacity کی دستاویزات اور انتظار کی پالیسی کا ریفرنس۔
ہماری آزمودہ tenacity_retry.py اسی flaky GET کو مختلف ٹائمنگ کے ساتھ دہراتی ہے۔ یہ 429 کے لیے برابر نہیں ہے: یہ Retry-After کو نہیں دیکھتی۔
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
یہاں منتخب اسٹیٹس ایکسپشنز میں بدل جاتے ہیں، انتظار ایکسپونینشل جٹر سے ہوتا ہے، اور کوششیں ختم ہونے پر آخری ایکسپشن دوبارہ اٹھایا جاتا ہے۔ کنکشن ایکسپشن کی وسیع قسم کو ہر اینڈ پوائنٹ کے حساب سے جانچنے کی ضرورت ہے۔
موازنے کے لیے، backoff on_exception یا on_predicate کو انتظار کے جنریٹر کے ساتھ ملاتا ہے؛ اس کا دستاویزی ڈیفالٹ جٹر فل جٹر ہے۔ اسٹیٹس فلٹرنگ کے لیے آپ کی اپنی predicate یا ایکسپشن پالیسی درکار ہے۔ اس کا max_tries کل کالز کو محدود کرتا ہے (اکتوبر 2026 تک)۔ دیکھیں backoff کی سرکاری ریپوزٹری۔ ہم نے backoff کی پیمائش نہیں کی۔
ایک مختصر قابل تکرار ری ٹرائی ٹیسٹ کیا دکھاتا ہے؟
16 اکتوبر 2026 کی ہماری مختصر آزمائش نے بحالی، سرور کے بتائے ہوئے انتظار اور کوششوں کے ختم ہونے کا مظاہرہ کیا۔ یہ ایک چھوٹا سا اسنیپ شاٹ ہے، بینچ مارک نہیں۔
Andrii نے Linux، Python 3.12، requests 2.31.0، urllib3 2.0.7 اور tenacity 9.1.4 پر ٹیسٹ چلایا۔ سورسز: requests_retry.py، tenacity_retry.py اور retry_server.py، جو یہاں دیے گئے ہیں۔ نمونہ urllib3 کے ساتھ ہر اینڈ پوائنٹ پر ایک بار چلانے اور Tenacity کے ساتھ flaky اینڈ پوائنٹ پر ایک بار چلانے پر مشتمل تھا، اور اسکرپٹس کے درمیان مقامی کاؤنٹرز ری سیٹ کیے گئے۔ تمام ٹریفک 127.0.0.1 پر رہی۔
| پالیسی اور اینڈ پوائنٹ | آخری اسٹیٹس | کوششیں | گزرا وقت |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0.00 s |
| urllib3 /flaky | 200 | 3 | 1.20 s |
| urllib3 /limited | 200 | 2 | 2.00 s |
| urllib3 /down | 503 | 6 | 15.69 s |
| Tenacity /flaky | 200 | 3 | 3.82 s |
Tenacity نے 1.36 اور 2.45 سیکنڈ کے انتظار لاگ کیے۔ ٹائمنگ کے فرق کی وجہ انتظار کی مختلف سیٹنگز ہیں؛ ان مشاہدات سے لائبریریوں کی درجہ بندی نہیں کی جا سکتی۔ اس میں بار بار کے ٹرائلز، ایک وقت میں کئی کلائنٹس، ریموٹ کنکشنز یا ناپی گئی ٹائم آؤٹ ناکامیاں شامل نہیں تھیں۔
retry_server.py کو ایک ٹرمینل میں چلائیں، پھر ہر کلائنٹ کو دوسرے ٹرمینل میں الگ الگ چلائیں:
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
بینڈ وڈتھ کی پیمائش نہیں کی گئی۔ منصوبہ بندی کے لیے، تمام کوششوں میں درخواست، رسپانس اور پروٹوکول کے بائٹس جمع کر کے منتقل شدہ بائٹس کا اندازہ لگائیں؛ برابر سائز کے چھ تبادلوں کی لاگت تقریباً ایک تبادلے سے چھ گنا ہوگی، لیکن اصل ایرر باڈیز مختلف ہوتی ہیں۔
مستقبل میں ایک seeded سمولیشن ایک جیسے کوششوں کے بجٹ کے تحت حسب ضرورت جٹر کا لائبریری پالیسیوں سے موازنہ کر سکتی ہے، اور لیٹنسی، شیڈولنگ کے ٹکراؤ اور فرضی کامیابی کے امکان کو ریکارڈ کر سکتی ہے۔ وہ سمولیٹڈ میٹرکس ہوں گے، جو اس مشاہدہ شدہ جدول سے الگ ہیں۔
اکثر پوچھے جانے والے سوالات
کیا Python Requests خود بخود ری ٹرائی کرتا ہے؟
ناکام کنکشنز کے لیے بطور ڈیفالٹ نہیں۔ ایڈاپٹر کو سوچ سمجھ کر ترتیب دیں، پھر قابو میں رکھی گئی ناکامی کے مقابل رویے کی تصدیق کریں۔
Session، HTTPAdapter اور urllib3 Retry مل کر کیسے کام کرتے ہیں؟
Session درخواست کے URL کے لیے اپنا ماؤنٹ کیا ہوا ایڈاپٹر چنتا ہے۔ ایڈاپٹر ری ٹرائی پالیسی کو urllib3 کی ٹرانسپورٹ کالز میں منتقل کرتا ہے۔
ایکسپونینشل بیک آف کی تاخیر کا حساب کیسے لگایا جاتا ہے؟
ہمارے 0.5 کے فیکٹر نے 0، 1، 2، 4 اور 8 سیکنڈ کے بنیادی انتظار پیدا کیے۔ جٹر نے بعد کے انتظار کو متاثر کیا، اس لیے بار بار چلانے پر ناپے گئے گزرے ہوئے وقت کا ملنا ضروری نہیں۔
Python کو 429 اور Retry-After کیسے سنبھالنے چاہئیں؟
جب عمل اجازت دے تو مانگے گئے وقت کے مطابق انتظار کریں۔ ورنہ جلد ری ٹرائی کرنے کے بجائے عمل کو روک دیں یا مؤخر کر دیں۔
کیا ٹائم آؤٹ کے بعد POST دوبارہ بھیجنا محفوظ ہے؟
ٹائم آؤٹ رائٹ کے نتیجے کو غیر یقینی چھوڑ دیتا ہے۔ دوبارہ بھیجنے سے پہلے API کی طرف سے مخصوص replay کی ضمانت ضروری سمجھیں۔
کیا ان اسکرپٹس نے مجموعی ڈیڈ لائن نافذ کی؟
نہیں۔ ان کی کوششوں کی پالیسیاں اور فی کال ٹائم آؤٹ گزرے ہوئے وقت کی کوئی سخت حد قائم نہیں کرتے۔
کیا ری ٹرائی پالیسی کے ساتھ پراکسی بھی چاہیے؟
اگر آپ کے مجاز ورک لوڈ کو پراکسی روٹنگ درکار ہے تو Python Requests کے لیے پراکسی آپشنز اور DataImpulse رہائشی پراکسیز کا جائزہ لیں۔ DataImpulse پراکسیز فراہم کرتا ہے، اسکریپنگ API، منیجڈ انبلاکر، VPN یا ڈیٹا سیٹ نہیں۔ دوبارہ بھیجنے کے فیصلے، رفتار کی پابندی اور ناکامیوں کی ہینڈلنگ اپنے کلائنٹ میں رکھیں۔
آخری تازہ کاری: 16 اکتوبر 2026۔