
Neste artigo
Implemente o retry no Python Requests com uma Session, um HTTPAdapter e uma política Retry do urllib3, e defina timeouts explícitos em cada chamada. Mantenha no mesmo desenho a segurança de reenvio, o número de tentativas e o ritmo imposto pelo servidor.
Comece pelos scripts testados abaixo. Nossa execução rápida de 16 de outubro de 2026 mostra o que aconteceu diante de falhas locais controladas, incluindo um 503 persistente que continuou sendo uma falha depois de todas as novas tentativas.
Fatos principais
- Um Retry do urllib3 montado em um HTTPAdapter adiciona novas tentativas a todas as chamadas de uma requests.Session.
- Um endpoint com 503, 503, 200 teve sucesso na tentativa 3 após 1,2 s no nosso teste local.
- Um 429 com Retry-After: 2 esperou exatamente 2,0 s antes da nova tentativa.
- Um endpoint com falha permanente parou após 6 tentativas e 15,7 s, em vez de ficar em loop.
- POST não é repetido por padrão; adicione-o apenas para chamadas idempotentes.
- O Tenacity oferece o mesmo padrão para qualquer função, com cada espera registrada em log.
Como implementar o retry no Python Requests?
Monte um adapter configurado com retry para HTTP e HTTPS e faça as chamadas por essa Session. Este é o nosso requests_retry.py testado; inicie o servidor local mostrado mais adiante antes de executá-lo.
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
O Requests não repete conexões que falharam por padrão. Uma Session mantém configurações e reaproveita conexões; o HTTPAdapter montado nela repassa a política de retry ao urllib3. Veja uso avançado do Requests.
Este script de medição imprime a resposta final, inclusive erros. No código da aplicação, chame raise_for_status() antes de consumir um resultado bem-sucedido e trate as falhas finais de RequestException na fronteira de quem chama. A chamada de reset é apenas preparação local e não tem timeout explícito; não copie essa omissão para chamadas remotas. Veja tratamento de erros do Requests.
Quais falhas o retry do Python Requests deve tratar?
Repita falhas que plausivelmente podem desaparecer, e somente quando repetir a operação for aceitável. Use este checklist de segurança de retry em 4 etapas antes de escolher as configurações.
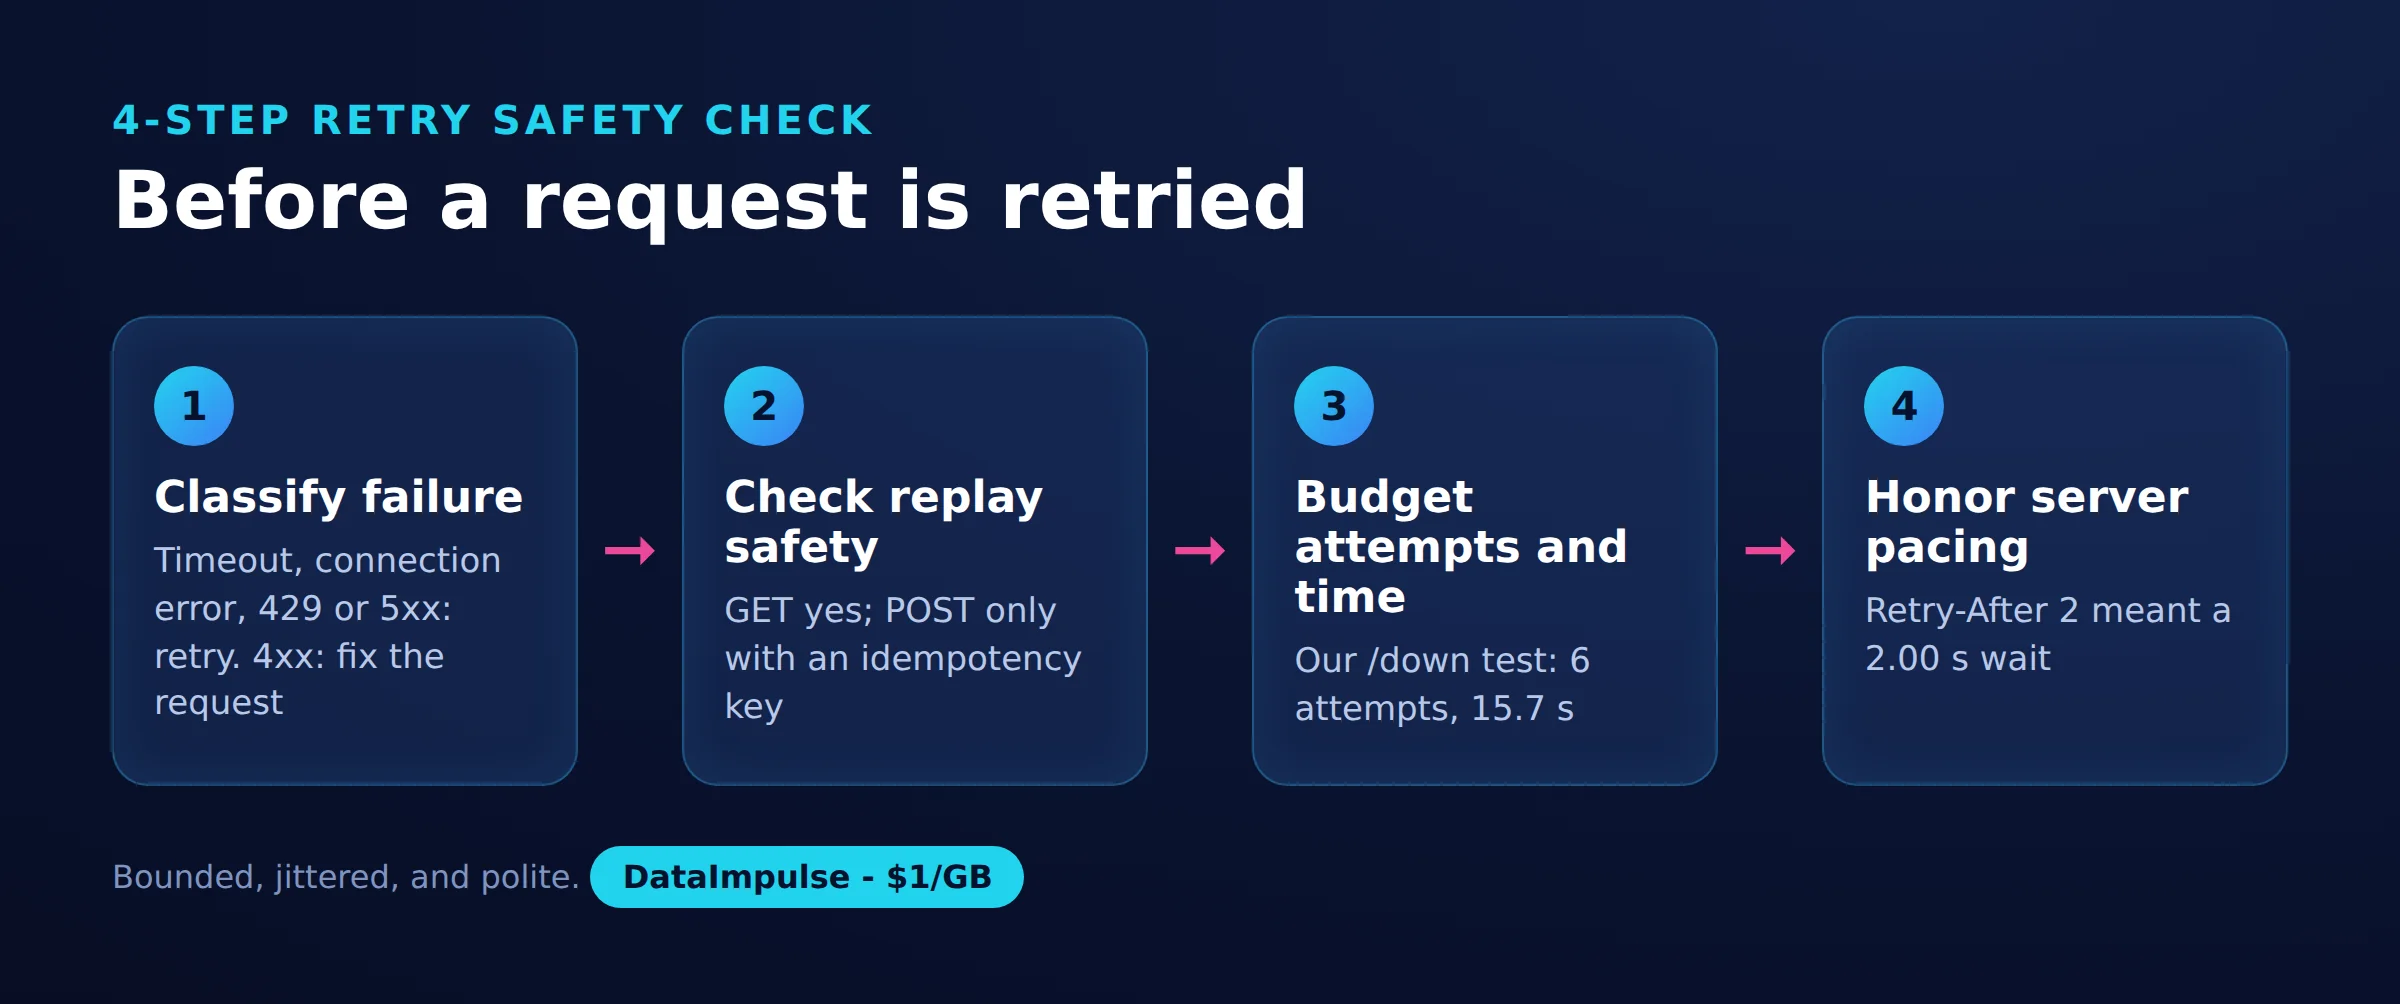
- Etapa 1: classifique a falha. Separe falhas de conexão, falhas de leitura e respostas HTTP. Nossa lista de status candidatos é 429, 500, 502, 503 e 504; revise-a de acordo com o contrato do endpoint.
- Etapa 2: verifique a segurança de reenvio. Decida se uma nova requisição pode duplicar uma gravação ou outro efeito colateral.
- Etapa 3: defina o orçamento de tentativas e de tempo. Estabeleça o máximo de chamadas, a espera aceitável e o prazo de quem chama antes de ativar as novas tentativas.
- Etapa 4: respeite o ritmo do servidor. Respeite o Retry-After e interrompa ou adie o trabalho quando a espera exigida ultrapassar o seu orçamento.
Não use o retry como conserto universal. Investigue separadamente as respostas 403 e os erros 407 de autenticação de proxy. Uma estratégia de retry no Python Requests deve preservar as condições de acesso e as regras de dados aplicáveis.
Como funcionam o backoff exponencial e o jitter?
O backoff exponencial aumenta o intervalo após falhas repetidas; o jitter adiciona aleatoriedade. Na nossa configuração, as esperas base foram de 0, 1, 2, 4 e 8 segundos.
Para a nova tentativa número k, começando em 1, o primeiro backoff do urllib3 é zero; os intervalos seguintes usam backoff_factor * 2**(k-1). Soma-se um jitter uniforme de zero até backoff_jitter, sujeito a backoff_max. A referência do urllib3 2.0.7 documenta esses controles.
Nosso ambiente usou o urllib3 2.0.7, que aceita backoff_jitter. Compare o exemplo com a versão instalada em vez de presumir compatibilidade. Altere o fator para ajustar o crescimento e a faixa de jitter para espalhar as tentativas; uma política de espera personalizada pertence a uma camada de retry escolhida deliberadamente.
O resultado de 1,20 segundo observado no endpoint instável reflete um único sorteio aleatório e a sobrecarga da execução local. Ele não prevê a latência da sua API.
Como tratar 429 e Retry-After?
Respeite um valor válido de Retry-After antes de tentar de novo, a menos que a operação precise parar. O cabeçalho aceita tanto um intervalo em segundos quanto uma data HTTP, conforme explica a referência de Retry-After da MDN.
Com o tratamento do cabeçalho ativado, o urllib3 usa um intervalo positivo de Retry-After antes do backoff calculado. Sem um intervalo positivo utilizável, aplica-se o backoff exponencial; cabeçalhos malformados exigem tratamento de erro explícito. Veja o comportamento de espera do urllib3.
Nosso 429 local pediu dois segundos, e a tentativa seguinte teve sucesso após 2,00 segundos. O script não impõe um prazo total: se um servidor pedir mais espera do que a sua operação permite, interrompa ou reagende em vez de encurtar a espera solicitada. Planeje esse comportamento junto com a sua política de rate limiting de API.
Como os timeouts de conexão e de leitura afetam as novas tentativas?
Um timeout limita uma etapa específica da espera, não a operação inteira. O estabelecimento da conexão, a leitura da resposta, as tentativas repetidas e o backoff contribuem para o tempo total decorrido.
Em timeout=(3.05, 10), o primeiro valor controla a espera pela conexão e o segundo controla a inatividade na leitura. Nenhum dos dois é um prazo de relógio; além disso, o Requests não tem timeout padrão. Veja a semântica de timeout do Requests.
Nosso orçamento de cinco novas tentativas permitiu seis tentativas. Os contadores de conexão e de leitura restringem suas respectivas categorias de falha dentro desse orçamento geral, sem somar permissões extras. Os controles de orçamento do Retry incluem total=0 para impedir novas tentativas (em outubro de 2026).
Não presuma que toda falha de leitura do corpo seja repetida. O código-fonte do adapter do Requests passa preload_content=False; falhas durante o consumo posterior do corpo podem ocorrer fora do ciclo de retry do adapter. Teste corpos interrompidos separadamente e aplique qualquer prazo rígido em uma fronteira da aplicação capaz de interromper a operação.
É seguro repetir requisições POST?
Um timeout em um POST, por si só, não prova que o reenvio é seguro. O servidor pode ter concluído a gravação antes de o cliente perder a resposta.
Só reenvie quando a API documentar comportamento idempotente ou um mecanismo de deduplicação que cubra a operação. Reutilize a mesma identidade de operação e o mesmo payload sob esse contrato; adicionar um cabeçalho de idempotência arbitrário não cria uma garantia. Isso segue as considerações sobre reenvio da especificação de idempotência do HTTP.
O conjunto padrão de métodos do urllib3 exclui o POST. Nosso conjunto mais restrito permite GET, HEAD e OPTIONS para novas tentativas por status e por leitura; o filtro de métodos não é uma proibição universal de novas tentativas de conexão antes da transmissão. Veja métodos do Retry e categorias de falha. Mantenha este exemplo focado em leituras.
Como registrar as tentativas e diagnosticar novas tentativas esgotadas?
Registre a categoria da falha, o número da tentativa, a espera escolhida, o tempo decorrido e o resultado final. Use um rótulo de rota sanitizado em vez da URL completa.
Os scripts ativam logs de diagnóstico para requisições inofensivas ao localhost. Antes de adaptá-los, remova componentes sensíveis da URL dos logs e das exceções; o exemplo com Tenacity inclui a URL na mensagem da exceção. Nunca registre credenciais, cabeçalhos de autorização ou corpos de resposta privados.
Nosso 503 persistente continuou sendo uma resposta porque raise_on_status=False. Falhas de transporte ainda podem lançar exceções; o Requests traduz falhas subjacentes em tipos como ConnectionError, ConnectTimeout e RetryError. Um max_retries inteiro também não expressa a política explícita de status mostrada aqui. Veja a implementação do adapter.
Confirme que as chamadas usam a Session configurada e a montagem correspondente. Feche-a ao terminar e investigue falhas específicas de rede com o guia de solução de problemas de proxy. Evite adicionar um segundo loop de retry em volta de um cliente que já faz novas tentativas.
Quando usar Retry do urllib3, Tenacity ou backoff?
Escolha uma única camada para ser responsável pelas novas tentativas. Use a configuração de transporte para a política de HTTP e um wrapper de função quando os resultados da aplicação determinarem se o trabalho deve ser repetido.
| Opção | Use X quando… | Evite X quando… |
|---|---|---|
| Retry do urllib3 | Use o Retry do urllib3 quando a política de transporte e de status for suficiente. | Evite o Retry do urllib3 ao repetir um fluxo de trabalho inteiro da aplicação. |
| Tenacity | Use o Tenacity quando resultados personalizados, exceções ou corrotinas determinarem as novas tentativas. | Evite o Tenacity ao envolver um cliente que já faz novas tentativas sem coordenar os orçamentos. |
| backoff | Use o backoff quando uma política baseada em decorator for adequada. | Evite o backoff se você espera classificação automática de status HTTP sem configuração. |
O Retry centraliza a filtragem de HTTP. O Tenacity separa as políticas de retry, espera e parada, oferece suporte a novas tentativas em corrotinas e fornece callbacks de log. Seu stop_after_attempt conta as chamadas, incluindo a primeira (em outubro de 2026). Veja a documentação do Tenacity e a referência de políticas de espera.
Nosso tenacity_retry.py testado repete o mesmo GET instável com um timing diferente. Ele não é equivalente no caso do 429: não inspeciona o Retry-After.
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
Aqui, os status selecionados viram exceções, as esperas usam jitter exponencial e, quando as tentativas se esgotam, a exceção final é relançada. A categoria ampla de exceções de conexão exige revisão específica para cada endpoint.
Para comparação, o backoff combina on_exception ou on_predicate com um gerador de espera; seu jitter padrão documentado é o full jitter. A filtragem de status exige o seu predicado ou a sua política de exceções. Seu max_tries limita o total de chamadas (em outubro de 2026). Veja o repositório oficial do backoff. Não medimos o backoff.
O que uma execução rápida e reproduzível de retry mostra?
Nossa execução rápida de 16 de outubro de 2026 demonstrou recuperação, espera determinada pelo servidor e esgotamento das tentativas. É um pequeno retrato do momento, não um benchmark.
Andrii executou em Linux, com Python 3.12, requests 2.31.0, urllib3 2.0.7 e tenacity 9.1.4. Fontes: requests_retry.py, tenacity_retry.py e retry_server.py, reproduzidos aqui. A amostra foi uma execução por endpoint com o urllib3 e uma execução do endpoint instável com o Tenacity, zerando os contadores locais entre os scripts. Todo o tráfego ficou em 127.0.0.1.
| Política e endpoint | Status final | Tentativas | Tempo decorrido |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0,00 s |
| urllib3 /flaky | 200 | 3 | 1,20 s |
| urllib3 /limited | 200 | 2 | 2,00 s |
| urllib3 /down | 503 | 6 | 15,69 s |
| Tenacity /flaky | 200 | 3 | 3,82 s |
O Tenacity registrou esperas de 1,36 e 2,45 segundos. As diferentes configurações de espera explicam a diferença de tempo; essas observações não permitem classificar bibliotecas. Não houve testes repetidos, clientes simultâneos, conexões remotas nem falhas de timeout medidas.
Execute o retry_server.py em um terminal e, depois, cada cliente separadamente em outro:
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
A largura de banda não foi medida. Para planejamento, estime os bytes transferidos somando os bytes de requisição, resposta e protocolo em todas as tentativas; seis trocas de mesmo tamanho custariam cerca de seis vezes uma única troca, mas os corpos de erro reais variam.
Uma futura simulação com semente fixa poderia comparar um jitter personalizado com as políticas das bibliotecas sob orçamentos de tentativas idênticos, registrando latência, colisões de agendamento e probabilidade simulada de sucesso. Essas seriam métricas simuladas, separadas da tabela observada.
Perguntas frequentes
O Python Requests faz novas tentativas automaticamente?
Não por padrão, no caso de conexões que falharam. Configure o adapter de forma deliberada e depois verifique o comportamento com uma falha controlada.
Como Session, HTTPAdapter e Retry do urllib3 funcionam juntos?
A Session seleciona o adapter montado para a URL da requisição. O adapter repassa a política de retry às chamadas de transporte do urllib3.
Como os intervalos do backoff exponencial são calculados?
Nosso fator de 0,5 produziu esperas base de 0, 1, 2, 4 e 8 segundos. O jitter afetou as esperas posteriores, então execuções repetidas não precisam coincidir com os tempos medidos.
Como o Python deve tratar 429 e Retry-After?
Espere o tempo solicitado quando a operação puder arcar com ele. Caso contrário, interrompa ou adie a operação em vez de tentar antes.
É seguro repetir um POST após um timeout?
Um timeout deixa incerto o resultado da gravação. Exija uma garantia de reenvio específica da API antes de enviá-lo novamente.
Esses scripts impuseram um prazo total?
Não. Suas políticas de tentativas e os timeouts por chamada não estabelecem um limite rígido de tempo decorrido.
Precisa de um proxy junto com a sua política de retry?
Se a sua carga de trabalho autorizada precisar de roteamento por proxy, confira as opções de proxy para Python Requests e os proxies residenciais da DataImpulse. A DataImpulse fornece proxies, não uma API de scraping, um unblocker gerenciado, uma VPN nem conjuntos de dados. Mantenha no seu cliente as decisões de reenvio, o ritmo das requisições e o tratamento de falhas.
Última atualização: 16 de outubro de 2026.