
In questo articolo
Implementa python requests retry con una Session, un HTTPAdapter e una policy Retry di urllib3, poi imposta timeout espliciti su ogni chiamata. Tieni nello stesso progetto la sicurezza della ripetizione, il numero di tentativi e il ritmo imposto dal server.
Parti dagli script testati qui sotto. Il nostro test rapido del 16 ottobre 2026 mostra cosa è successo con errori locali controllati, compreso un 503 persistente che è rimasto un errore dopo ogni retry.
Punti chiave
- Il Retry di urllib3 montato su un HTTPAdapter aggiunge i retry a ogni chiamata di una requests.Session.
- Un endpoint con risposte 503, 503, 200 ha avuto successo al tentativo 3 dopo 1.2 s nel nostro test locale.
- Un 429 con Retry-After: 2 ha atteso esattamente 2.0 s prima del retry.
- Un endpoint sempre in errore si è fermato dopo 6 tentativi e 15.7 s invece di andare in loop.
- POST non viene ripetuto per impostazione predefinita: aggiungilo solo per le chiamate idempotenti.
- Tenacity offre lo stesso schema per qualsiasi funzione, con ogni attesa registrata nei log.
Come si implementa Python Requests Retry?
Monta un adapter configurato per i retry sia per HTTP sia per HTTPS, poi effettua le chiamate tramite quella Session. Questo è il nostro requests_retry.py testato: avvia il server locale mostrato più avanti prima di eseguirlo.
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
Requests non ripete le connessioni fallite per impostazione predefinita. Una Session conserva le impostazioni e riutilizza le connessioni; l’HTTPAdapter montato passa la policy di retry a urllib3. Vedi l’uso avanzato di Requests.
Questo script di misurazione stampa la risposta finale, errori inclusi. Nel codice di un’applicazione, chiama raise_for_status() prima di usare un risultato positivo e gestisci gli errori RequestException definitivi al confine del chiamante. La chiamata di reset è una preparazione locale e non ha un timeout esplicito: non copiare questa omissione nelle chiamate remote. Vedi la gestione degli errori in Requests.
Quali errori deve gestire Python Requests Retry?
Ripeti gli errori che potrebbero plausibilmente sparire e solo quando ripetere l’operazione è accettabile. Usa questa verifica di sicurezza dei retry in 4 passaggi prima di scegliere le impostazioni.
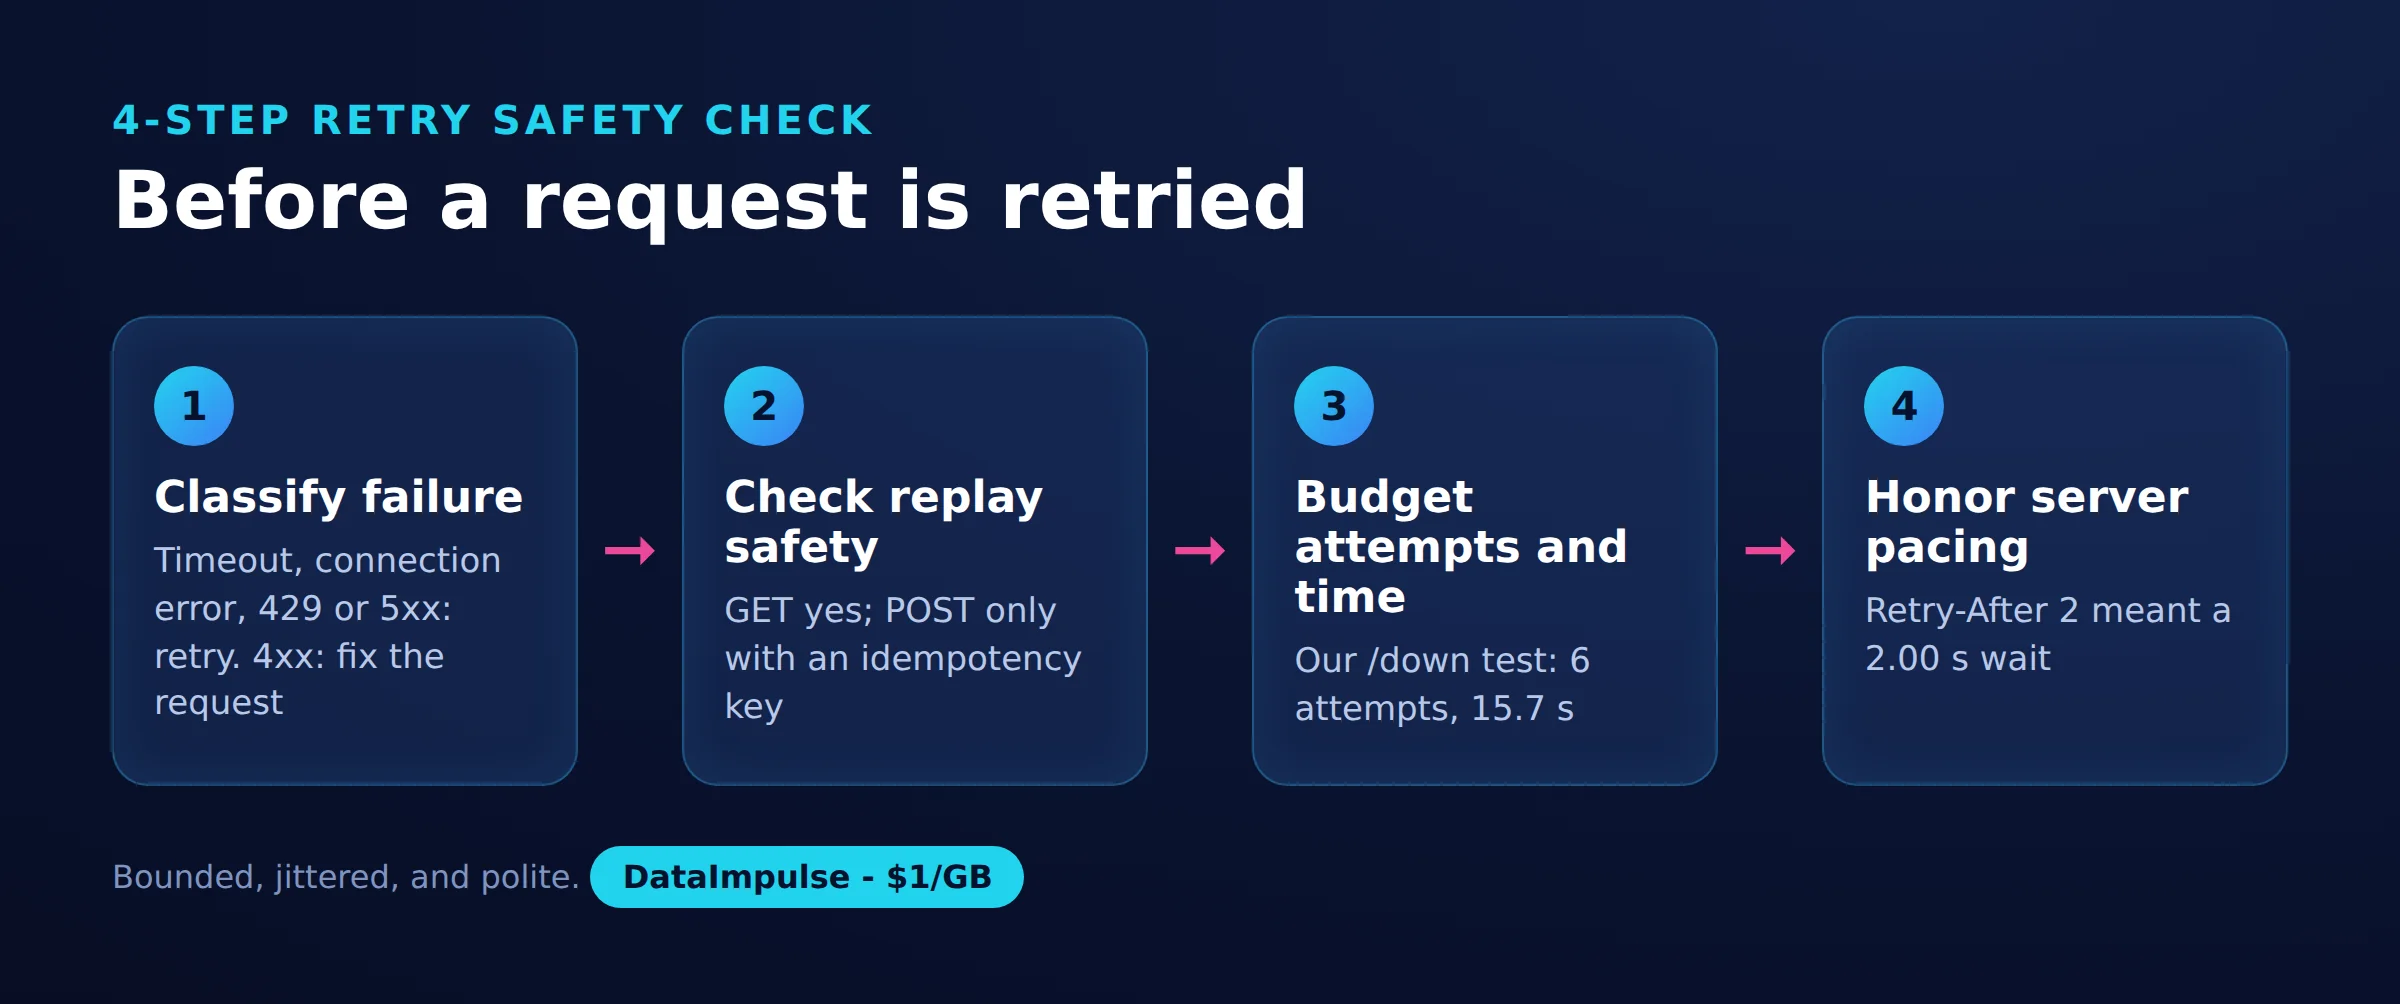
- Passaggio 1: classifica l’errore. Distingui errori di connessione, errori di lettura e risposte HTTP. La nostra lista di status candidati è 429, 500, 502, 503 e 504: verificala rispetto al contratto dell’endpoint.
- Passaggio 2: controlla la sicurezza della ripetizione. Valuta se una nuova richiesta potrebbe duplicare una scrittura o un altro effetto collaterale.
- Passaggio 3: definisci il budget di tentativi e tempo. Stabilisci il numero massimo di chiamate, l’attesa accettabile e la scadenza del chiamante prima di attivare i retry.
- Passaggio 4: rispetta il ritmo del server. Rispetta Retry-After e interrompi o rimanda il lavoro quando l’attesa richiesta supera il tuo budget.
Non usare i retry come rimedio universale. Analizza separatamente le risposte 403 e gli errori 407 di autenticazione del proxy. Una strategia python requests retry dovrebbe rispettare le condizioni di accesso e le regole applicabili sui dati.
Come funzionano exponential backoff e jitter?
L’exponential backoff aumenta il ritardo dopo errori ripetuti; il jitter aggiunge casualità. Nella nostra configurazione, le attese di base sono state di 0, 1, 2, 4 e 8 secondi.
Per il retry numero k, a partire da 1, il primo backoff di urllib3 è zero; i ritardi successivi usano backoff_factor * 2**(k-1). Si aggiunge un jitter uniforme da zero fino a backoff_jitter, entro il limite di backoff_max. Il riferimento di urllib3 2.0.7 documenta questi controlli.
Il nostro ambiente usava urllib3 2.0.7, che accetta backoff_jitter. Adatta l’esempio alla versione che hai installato, senza dare per scontata la compatibilità. Cambia il fattore per regolare la crescita e l’intervallo di jitter per distribuire i retry; una policy di attesa personalizzata va inserita in un livello di retry scelto con criterio.
Il risultato di 1.20 secondi osservato sull’endpoint flaky riflette una singola estrazione casuale e l’overhead dell’esecuzione locale. Non è una previsione della latenza della tua API.
Come gestire 429 e Retry-After?
Rispetta un valore Retry-After valido prima di riprovare, a meno che l’operazione non debba fermarsi. L’header accetta un ritardo in secondi oppure una HTTP-date, come spiegato nel riferimento MDN su Retry-After.
Con la gestione dell’header attiva, urllib3 usa un ritardo Retry-After positivo al posto del backoff calcolato. Senza un ritardo positivo utilizzabile si applica l’exponential backoff; gli header malformati richiedono una gestione esplicita degli errori. Vedi il comportamento di sleep in urllib3.
Il nostro 429 locale richiedeva due secondi e il tentativo successivo è riuscito dopo 2.00 secondi. Lo script non impone alcuna scadenza complessiva: se un server chiede un’attesa più lunga di quella che la tua operazione consente, fermati o riprogramma invece di accorciare l’attesa richiesta. Pianifica questo comportamento insieme alla tua policy di rate limiting delle API.
Come incidono i timeout di connessione e di lettura sui retry?
Un timeout limita una specifica fase di attesa, non l’intera operazione. Stabilire la connessione, leggere la risposta, ripetere i tentativi e il backoff contribuiscono tutti al tempo totale trascorso.
In timeout=(3.05, 10), il primo valore controlla l’attesa della connessione e il secondo l’inattività in lettura. Nessuno dei due è una scadenza in tempo reale; inoltre Requests non ha alcun timeout predefinito. Vedi la semantica dei timeout in Requests.
Il nostro budget di cinque retry ha consentito sei tentativi. I contatori di connessione e lettura limitano le rispettive categorie di errore all’interno di quel budget complessivo, senza aggiungere margini extra. I controlli del budget di Retry includono total=0 per impedire i retry (a ottobre 2026).
Non dare per scontato che ogni errore di lettura del body venga ripetuto. Il codice sorgente dell’adapter di Requests passa preload_content=False; gli errori durante la lettura successiva del body possono avvenire fuori dal ciclo di retry dell’adapter. Testa separatamente i body interrotti e applica qualsiasi scadenza rigida a un confine dell’applicazione in grado di fermare l’operazione.
Si possono ripetere in sicurezza le richieste POST?
Il solo timeout di una POST non basta a stabilire che la ripetizione sia sicura. Il server potrebbe aver completato la scrittura prima che il client perdesse la risposta.
Ripeti solo quando l’API documenta un comportamento idempotente o un meccanismo di deduplicazione che copre l’operazione. Riutilizza la stessa identità dell’operazione e lo stesso payload in base a quel contratto; aggiungere un header di idempotenza arbitrario non crea alcuna garanzia. Questo segue le considerazioni sulla ripetizione presenti nella specifica HTTP sull’idempotenza.
L’insieme di metodi predefinito di urllib3 esclude POST. Il nostro insieme più ristretto ammette GET, HEAD e OPTIONS per i retry su status e lettura; il filtro sui metodi non è un divieto universale dei retry di connessione prima dell’invio. Vedi metodi e categorie di errore di Retry. Mantieni questo esempio focalizzato sulle letture.
Come registrare i tentativi e diagnosticare i retry esauriti?
Registra la categoria di errore, il numero del tentativo, l’attesa scelta, il tempo trascorso e l’esito finale. Usa un’etichetta di route ripulita invece dell’URL completo.
Gli script attivano il logging diagnostico per richieste localhost innocue. Prima di adattarli, rimuovi dai log e dalle eccezioni i componenti sensibili dell’URL; l’esempio con Tenacity include l’URL nel messaggio dell’eccezione. Non registrare mai credenziali, header di autorizzazione o body di risposta privati.
Il nostro 503 persistente è rimasto una risposta perché raise_on_status=False. Gli errori di trasporto possono comunque sollevare eccezioni; Requests traduce gli errori sottostanti in tipi come ConnectionError, ConnectTimeout e RetryError. Inoltre, un max_retries intero non esprime la policy esplicita sugli status mostrata qui. Vedi l’implementazione dell’adapter.
Verifica che le chiamate usino la Session configurata e il mount corrispondente. Chiudila al termine e analizza gli errori specifici di rete con la guida alla risoluzione dei problemi dei proxy. Evita di aggiungere un secondo ciclo di retry attorno a un client che già ripete le richieste.
Quando usare Retry di urllib3, Tenacity o backoff?
Scegli un solo livello che gestisca i retry. Usa la configurazione del trasporto per la policy HTTP e un wrapper di funzione quando sono gli esiti dell’applicazione a stabilire se ripetere il lavoro.
| Opzione | Usa X quando… | Evita X quando… |
|---|---|---|
| urllib3 Retry | Usa urllib3 Retry quando la policy su trasporto e status è adatta. | Evita urllib3 Retry quando devi ripetere un intero flusso applicativo. |
| Tenacity | Usa Tenacity quando risultati personalizzati, eccezioni o coroutine guidano i retry. | Evita Tenacity quando avvolgi un client che già ripete le richieste senza coordinare i budget. |
| backoff | Usa backoff quando è adatta una policy basata su decorator. | Evita backoff quando ti aspetti una classificazione automatica degli status HTTP senza configurazione. |
Retry centralizza il filtraggio HTTP. Tenacity separa le policy di retry, attesa e stop, supporta i retry di coroutine e offre callback di logging. Il suo stop_after_attempt conta le chiamate, compresa la prima (a ottobre 2026). Vedi la documentazione di Tenacity e il riferimento alle policy di attesa.
Il nostro tenacity_retry.py testato ripete la stessa GET flaky con tempi diversi. Non è equivalente per il 429: non legge Retry-After.
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
In questo caso gli status selezionati diventano eccezioni, le attese usano un exponential jitter e, a tentativi esauriti, viene rilanciata l’ultima eccezione. L’ampia categoria di eccezioni di connessione richiede una verifica specifica per ogni endpoint.
A titolo di confronto, backoff combina on_exception oppure on_predicate con un generatore di attese; il suo jitter predefinito documentato è il full jitter. Il filtraggio degli status richiede un tuo predicato o una tua policy sulle eccezioni. Il suo max_tries limita il totale delle chiamate (a ottobre 2026). Vedi il repository ufficiale di backoff. Non abbiamo misurato backoff.
Cosa mostra un test rapido e riproducibile dei retry?
Il nostro test rapido del 16 ottobre 2026 ha dimostrato il recupero, l’attesa dettata dal server e l’esaurimento dei tentativi. È una piccola istantanea, non un benchmark.
Andrii ha usato Linux, Python 3.12, requests 2.31.0, urllib3 2.0.7 e tenacity 9.1.4. Fonti: requests_retry.py, tenacity_retry.py e retry_server.py, riportati qui. Il campione è stato una singola esecuzione per endpoint con urllib3 e una singola esecuzione sull’endpoint flaky con Tenacity, azzerando i contatori locali tra uno script e l’altro. Tutto il traffico è rimasto su 127.0.0.1.
| Policy ed endpoint | Status finale | Tentativi | Tempo trascorso |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0.00 s |
| urllib3 /flaky | 200 | 3 | 1.20 s |
| urllib3 /limited | 200 | 2 | 2.00 s |
| urllib3 /down | 503 | 6 | 15.69 s |
| Tenacity /flaky | 200 | 3 | 3.82 s |
Tenacity ha registrato attese di 1.36 e 2.45 secondi. Le diverse impostazioni di attesa spiegano la differenza di tempi; queste osservazioni non permettono di stilare una classifica delle librerie. Non ci sono stati test ripetuti, client concorrenti, connessioni remote né errori di timeout misurati.
Esegui retry_server.py in un terminale, poi ogni client separatamente in un altro:
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
La banda non è stata misurata. Per la pianificazione, stima i byte trasferiti sommando i byte di richiesta, risposta e protocollo su tutti i tentativi; sei scambi della stessa dimensione costerebbero circa sei volte uno scambio singolo, ma i body degli errori reali differiscono.
Una futura simulazione con seed potrebbe confrontare il jitter personalizzato con le policy delle librerie a parità di budget di tentativi, registrando latenza, collisioni nella pianificazione e probabilità di successo simulata. Sarebbero metriche simulate, distinte da questa tabella di dati osservati.
Domande frequenti
Python Requests ripete le richieste automaticamente?
Non per impostazione predefinita nel caso di connessioni fallite. Configura l’adapter con criterio, poi verifica il comportamento con un errore controllato.
Come lavorano insieme Session, HTTPAdapter e Retry di urllib3?
La Session seleziona l’adapter montato per l’URL della richiesta. L’adapter passa la policy di retry alle chiamate di trasporto di urllib3.
Come si calcolano i ritardi dell’exponential backoff?
Il nostro fattore di 0.5 ha prodotto attese di base di 0, 1, 2, 4 e 8 secondi. Il jitter ha influenzato le attese successive, quindi esecuzioni ripetute possono non coincidere con i tempi misurati.
Come dovrebbe gestire Python 429 e Retry-After?
Attendi quanto richiesto, se l’operazione se lo può permettere. In caso contrario, interrompi o rimanda l’operazione invece di riprovare prima.
È sicuro ripetere una POST dopo un timeout?
Un timeout lascia incerto l’esito della scrittura. Pretendi una garanzia di ripetizione specifica dell’API prima di inviarla di nuovo.
Questi script imponevano una scadenza complessiva?
No. Le loro policy sui tentativi e i timeout per singola chiamata non stabiliscono un limite rigido al tempo trascorso.
Ti serve un proxy insieme alla tua policy di retry?
Se il tuo carico di lavoro autorizzato richiede un instradamento tramite proxy, consulta le opzioni di proxy per Python Requests e i residential proxy DataImpulse. DataImpulse fornisce proxy, non un’API di scraping, un unblocker gestito, una VPN o un dataset. Mantieni nel tuo client le decisioni sulla ripetizione, il ritmo delle richieste e la gestione degli errori.
Ultimo aggiornamento: 16 ottobre 2026.