
이 글의 내용
Session, HTTPAdapter, urllib3 Retry 정책으로 python requests retry를 구현한 다음, 각 호출에 명시적 타임아웃을 설정합니다. 재실행 안전성, 시도 횟수, 서버의 처리 속도 조절을 하나의 설계 안에서 함께 다루어야 합니다.
아래의 테스트된 스크립트부터 살펴보겠습니다. 2026년 10월 16일에 진행한 간단한 실행에서는 통제된 로컬 장애 상황에서 어떤 일이 일어났는지 확인했으며, 모든 재시도 후에도 실패로 남은 지속적인 503 사례도 포함했습니다.
핵심 요약
- HTTPAdapter에 마운트한 urllib3 Retry는 requests.Session의 모든 호출에 재시도를 추가합니다.
- 503, 503, 200 순서로 응답하는 엔드포인트는 로컬 테스트에서 1.2 s 후 3번째 시도에서 성공했습니다.
- Retry-After: 2가 포함된 429 응답은 재시도 전에 정확히 2.0 s 동안 대기했습니다.
- 계속 실패하는 엔드포인트는 무한 반복하지 않고 6번 시도, 15.7 s 후에 중단되었습니다.
- POST는 기본적으로 재시도되지 않으므로 멱등한 호출에만 추가하십시오.
- Tenacity는 어떤 함수에도 같은 패턴을 적용할 수 있으며 모든 대기 시간을 로그로 남깁니다.
Python Requests Retry는 어떻게 구현합니까?
HTTP와 HTTPS 모두에 재시도가 설정된 어댑터를 마운트한 다음 해당 Session을 통해 호출합니다. 다음은 테스트를 마친 requests_retry.py이며, 실행하기 전에 뒤에서 소개하는 로컬 서버를 먼저 시작해야 합니다.
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
Requests는 기본적으로 실패한 연결을 재시도하지 않습니다. Session은 설정을 유지하고 연결을 풀링하며, 마운트된 HTTPAdapter가 재시도 정책을 urllib3에 전달합니다. Requests 고급 사용법을 참고하십시오.
이 측정용 스크립트는 오류를 포함한 최종 응답을 출력합니다. 실제 애플리케이션 코드에서는 성공한 결과를 사용하기 전에 raise_for_status()를 호출하고, 최종적으로 발생하는 RequestException 실패는 호출자 경계에서 처리해야 합니다. reset 호출은 로컬 설정용이므로 명시적 타임아웃이 없으며, 이 부분을 원격 호출에 그대로 따라 하지 마십시오. Requests 오류 처리를 참고하십시오.
Python Requests Retry는 어떤 실패를 처리해야 합니까?
사라질 수 있는 실패만, 그리고 작업을 반복해도 문제가 없는 경우에만 재시도하십시오. 설정을 정하기 전에 다음 4단계 재시도 안전성 점검을 활용하십시오.
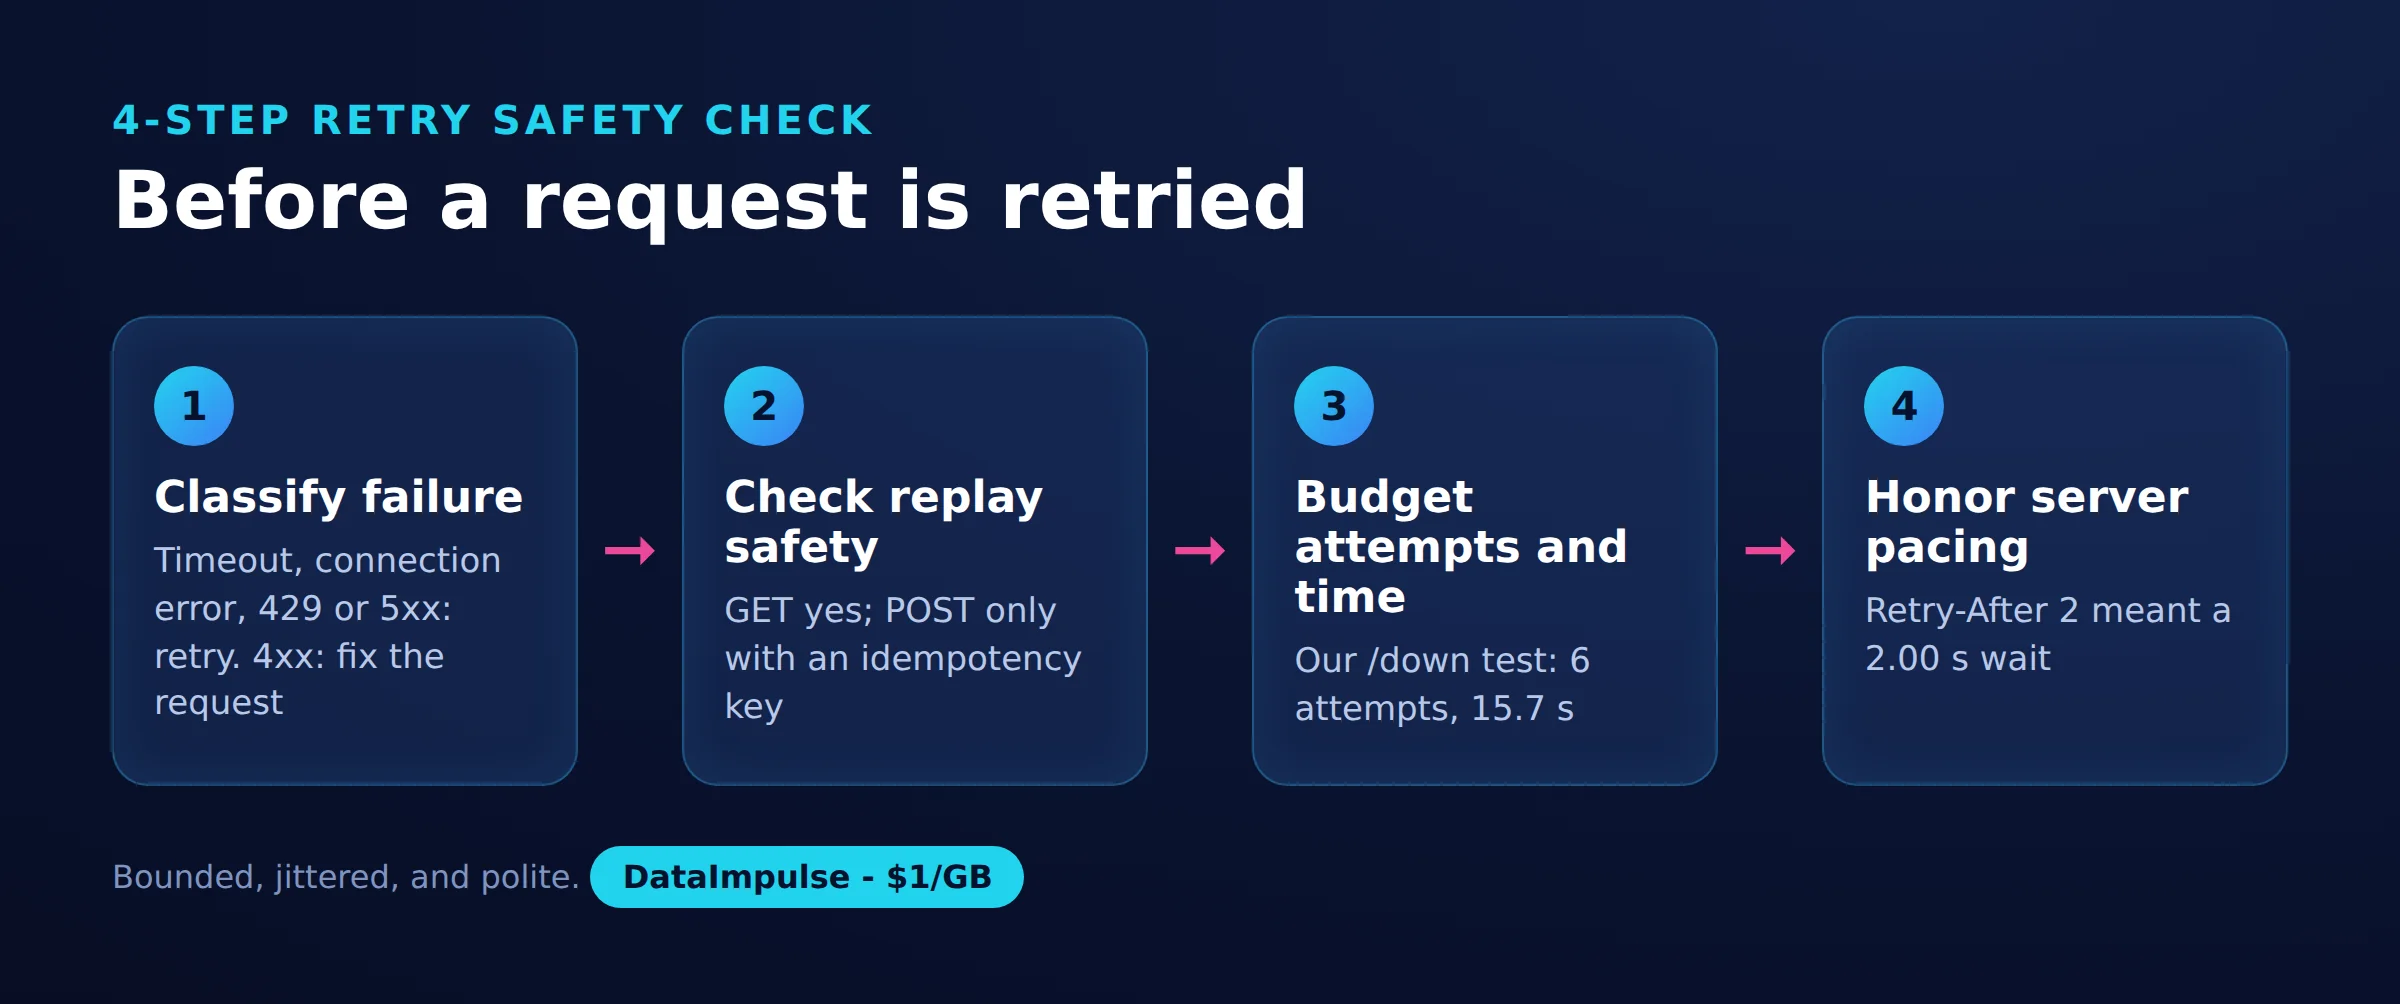
- 1단계: 실패 유형 분류. 연결 실패, 읽기 실패, HTTP 응답을 구분합니다. 후보 상태 코드 목록은 429, 500, 502, 503, 504이며, 엔드포인트의 계약에 맞춰 검토하십시오.
- 2단계: 재실행 안전성 확인. 추가 요청이 쓰기 작업이나 다른 부수 효과를 중복시킬 수 있는지 판단합니다.
- 3단계: 시도 횟수와 시간 예산 설정. 재시도를 활성화하기 전에 최대 호출 횟수, 허용 가능한 대기 시간, 호출자의 마감 시한을 정합니다.
- 4단계: 서버의 처리 속도 조절 존중. Retry-After를 따르고, 필요한 대기 시간이 예산을 초과하면 작업을 중단하거나 미루십시오.
재시도를 만능 해결책으로 사용하지 마십시오. 403 응답과 407 프록시 인증 오류는 별도로 조사해야 합니다. python requests retry 전략은 접근 조건과 관련 데이터 규정을 지켜야 합니다.
지수 백오프와 지터는 어떻게 동작합니까?
지수 백오프는 실패가 반복될수록 대기 시간을 늘리고, 지터는 무작위성을 더합니다. 이번 설정에서 기본 대기 시간은 0, 1, 2, 4, 8초였습니다.
1부터 시작하는 재시도 횟수 k에 대해 urllib3의 첫 번째 백오프는 0이며, 이후 지연 시간은 backoff_factor * 2**(k-1)로 계산됩니다. 여기에 0부터 backoff_jitter까지의 균등 분포 지터가 더해지며, backoff_max의 제한을 받습니다. 이러한 제어 항목은 urllib3 2.0.7 레퍼런스에 설명되어 있습니다.
이번 환경에서는 backoff_jitter를 지원하는 urllib3 2.0.7을 사용했습니다. 호환성을 가정하지 말고 설치된 버전에 맞게 예제를 조정하십시오. 증가 속도는 factor로, 재시도 분산 범위는 지터 범위로 조정할 수 있으며, 사용자 지정 대기 정책은 의도적으로 선택한 재시도 계층에 두는 것이 좋습니다.
관측된 flaky 엔드포인트의 1.20초 결과는 한 번의 무작위 추첨과 로컬 실행 오버헤드를 반영한 값입니다. 사용자 API의 지연 시간을 예측하는 값은 아닙니다.
429와 Retry-After는 어떻게 처리해야 합니까?
작업을 반드시 중단해야 하는 경우가 아니라면, 다시 시도하기 전에 유효한 Retry-After 값을 따르십시오. 이 헤더는 대기 초 단위 값 또는 HTTP-date를 받으며, 자세한 내용은 MDN의 Retry-After 레퍼런스에 나와 있습니다.
헤더 처리를 활성화하면 urllib3는 계산된 백오프보다 양수 Retry-After 지연 값을 우선 사용합니다. 사용할 수 있는 양수 지연 값이 없으면 지수 백오프가 적용되며, 형식이 잘못된 헤더는 명시적인 오류 처리가 필요합니다. urllib3의 sleep 동작을 참고하십시오.
로컬 테스트의 429 응답은 2초를 요청했고, 다음 시도는 2.00초 후에 성공했습니다. 이 스크립트는 전체 마감 시한을 강제하지 않습니다. 서버가 작업에서 허용하는 시간보다 더 긴 대기를 요청하면, 요청된 대기 시간을 줄이지 말고 작업을 중단하거나 일정을 다시 잡으십시오. 이러한 동작은 API 요청 제한 정책과 함께 계획하는 것이 좋습니다.
연결 타임아웃과 읽기 타임아웃은 재시도에 어떤 영향을 줍니까?
타임아웃은 전체 작업이 아니라 특정 대기 단계의 한도를 정합니다. 연결 수립, 응답 읽기, 반복 시도, 백오프가 모두 경과 시간에 포함됩니다.
timeout=(3.05, 10)에서 첫 번째 값은 연결 대기를, 두 번째 값은 읽기 비활성 시간을 제어합니다. 둘 다 실제 시계 기준의 마감 시한은 아니며, Requests에는 기본 타임아웃도 없습니다. Requests 타임아웃 의미를 참고하십시오.
이번 설정에서 5회 재시도 예산은 총 6번의 시도를 허용했습니다. 연결 및 읽기 카운터는 추가 허용량을 더하는 것이 아니라 전체 예산 안에서 각 실패 유형을 제한합니다. Retry 예산 제어에는 재시도를 막는 total=0이 포함되어 있습니다(2026년 10월 기준).
모든 본문 읽기 실패가 재실행된다고 가정하지 마십시오. Requests 어댑터 소스는 preload_content=False를 전달하므로, 이후 본문을 소비하는 중에 발생한 실패는 어댑터의 재시도 주기 밖에서 일어날 수 있습니다. 중단된 본문은 별도로 테스트하고, 엄격한 마감 시한은 작업을 중지할 수 있는 애플리케이션 경계에서 적용하십시오.
POST 요청도 안전하게 재시도할 수 있습니까?
POST 타임아웃만으로는 재실행이 안전하다고 단정할 수 없습니다. 클라이언트가 응답을 받지 못하기 전에 서버가 이미 쓰기 작업을 완료했을 수 있기 때문입니다.
API가 멱등한 동작이나 해당 작업을 포괄하는 중복 제거 메커니즘을 문서로 보장하는 경우에만 재실행하십시오. 그 계약 아래에서 동일한 작업 식별자와 페이로드를 재사용해야 하며, 임의의 멱등성 헤더를 추가한다고 보장이 생기는 것은 아닙니다. 이는 HTTP의 멱등성 사양에 나온 재실행 관련 고려 사항을 따릅니다.
urllib3의 기본 메서드 집합에는 POST가 제외되어 있습니다. 이번 설정의 더 좁은 집합은 상태 코드 및 읽기 재시도에 GET, HEAD, OPTIONS만 허용합니다. 다만 메서드 필터링이 전송 전 연결 재시도까지 일괄적으로 금지하는 것은 아닙니다. Retry 메서드 및 실패 유형을 참고하십시오. 이 예제는 읽기 작업에 집중하십시오.
시도를 어떻게 기록하고 소진된 재시도를 어떻게 진단합니까?
실패 유형, 시도 횟수, 선택된 대기 시간, 경과 시간, 최종 결과를 기록하십시오. 전체 URL 대신 정제된 경로 레이블을 사용하십시오.
이 스크립트들은 문제가 없는 localhost 요청에 대해 진단 로그를 활성화합니다. 적용하기 전에 로그와 예외에서 민감한 URL 구성 요소를 제거하십시오. Tenacity 예제는 예외 메시지에 URL을 포함합니다. 인증 정보, 인증 헤더, 비공개 응답 본문은 절대 기록하지 마십시오.
지속적인 503은 raise_on_status=False 설정 때문에 예외가 아닌 응답으로 남았습니다. 전송 계층 실패는 여전히 예외를 일으킬 수 있으며, Requests는 내부 실패를 ConnectionError, ConnectTimeout, RetryError 같은 유형으로 변환합니다. 또한 정수형 max_retries로는 여기에 나온 명시적 상태 코드 정책을 표현할 수 없습니다. 어댑터 구현을 참고하십시오.
호출이 설정한 Session과 그에 맞는 마운트를 사용하는지 확인하십시오. 사용이 끝나면 Session을 닫고, 네트워크 관련 실패는 프록시 문제 해결 가이드로 조사하십시오. 이미 재시도를 수행하는 클라이언트를 감싸는 두 번째 재시도 루프는 추가하지 마십시오.
urllib3 Retry, Tenacity, backoff는 언제 사용해야 합니까?
재시도를 담당할 계층은 하나만 선택하십시오. HTTP 정책에는 전송 계층 설정을 사용하고, 애플리케이션의 결과에 따라 작업 반복 여부가 정해질 때는 함수 래퍼를 사용하십시오.
| 옵션 | X를 사용하기 좋은 경우 | X를 피해야 하는 경우 |
|---|---|---|
| urllib3 Retry | 전송 계층과 상태 코드 정책이 요구에 맞을 때 urllib3 Retry를 사용합니다. | 애플리케이션 작업 흐름 전체를 재시도할 때는 urllib3 Retry를 피합니다. |
| Tenacity | 사용자 지정 결과, 예외, 코루틴이 재시도를 좌우할 때 Tenacity를 사용합니다. | 예산을 조율하지 않은 채 이미 재시도하는 클라이언트를 감쌀 때는 Tenacity를 피합니다. |
| backoff | 데코레이터 기반 정책이 맞을 때 backoff를 사용합니다. | 설정 없이 HTTP 상태 코드가 자동으로 분류되기를 기대할 때는 backoff를 피합니다. |
Retry는 HTTP 필터링을 한곳에 모읍니다. Tenacity는 재시도, 대기, 중단 정책을 분리하고, 코루틴 재시도를 지원하며, 로깅 콜백을 제공합니다. stop_after_attempt는 첫 호출을 포함한 호출 횟수를 셉니다(2026년 10월 기준). Tenacity 문서와 대기 정책 레퍼런스를 참고하십시오.
테스트를 마친 tenacity_retry.py는 동일한 flaky GET을 다른 타이밍으로 반복합니다. 429에서는 동일하게 동작하지 않으며, Retry-After를 확인하지 않습니다.
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
여기서는 선택한 상태 코드가 예외로 바뀌고, 대기에는 지수 지터가 사용되며, 재시도가 소진되면 마지막 예외가 다시 발생합니다. 범위가 넓은 연결 예외 범주는 엔드포인트별로 검토해야 합니다.
비교를 위해 설명하면, backoff는 on_exception 또는 on_predicate를 대기 생성기와 조합하며, 문서에 명시된 기본 지터는 전체 지터(full jitter)입니다. 상태 코드 필터링에는 사용자가 정의한 조건 함수나 예외 정책이 필요합니다. max_tries는 전체 호출 횟수를 제한합니다(2026년 10월 기준). 공식 backoff 저장소를 참고하십시오. backoff는 측정하지 않았습니다.
간단한 재현 가능 재시도 실행은 무엇을 보여줍니까?
2026년 10월 16일에 진행한 간단한 실행에서는 복구, 서버가 지시한 대기, 재시도 소진을 확인했습니다. 이는 작은 스냅샷이며 벤치마크가 아닙니다.
Andrii는 Linux, Python 3.12, requests 2.31.0, urllib3 2.0.7, tenacity 9.1.4 환경에서 실행했습니다. 소스는 requests_retry.py, tenacity_retry.py, retry_server.py이며 여기에 그대로 실었습니다. 표본은 urllib3로 엔드포인트마다 한 번씩 실행한 결과와 Tenacity로 flaky 엔드포인트를 한 번 실행한 결과이며, 스크립트 사이에 로컬 카운터를 초기화했습니다. 모든 트래픽은 127.0.0.1 안에 머물렀습니다.
| 정책 및 엔드포인트 | 최종 상태 | 시도 횟수 | 경과 시간 |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0.00 s |
| urllib3 /flaky | 200 | 3 | 1.20 s |
| urllib3 /limited | 200 | 2 | 2.00 s |
| urllib3 /down | 503 | 6 | 15.69 s |
| Tenacity /flaky | 200 | 3 | 3.82 s |
Tenacity는 1.36초와 2.45초의 대기를 기록했습니다. 대기 설정이 서로 달라 시간 차이가 생겼으며, 이 관찰 결과로 라이브러리의 순위를 매길 수는 없습니다. 반복 시행, 동시 클라이언트, 원격 연결, 측정된 타임아웃 실패는 없었습니다.
한 터미널에서 retry_server.py를 실행한 다음, 다른 터미널에서 각 클라이언트를 따로 실행하십시오.
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
대역폭은 측정하지 않았습니다. 계획을 세울 때는 시도마다 요청, 응답, 프로토콜 바이트를 합산하여 전송량을 추정하십시오. 같은 크기의 교환 6번은 대략 1번의 6배 비용이 들지만, 실제 오류 응답 본문의 크기는 서로 다릅니다.
앞으로 시드를 고정한 시뮬레이션을 통해 동일한 시도 예산에서 사용자 지정 지터와 라이브러리 정책을 비교하고, 지연 시간, 스케줄링 충돌, 시뮬레이션된 성공 확률을 기록할 수 있습니다. 이는 시뮬레이션 지표이므로 위의 관측 표와는 구분됩니다.
자주 묻는 질문
Python Requests는 자동으로 재시도합니까?
실패한 연결에 대해서는 기본적으로 재시도하지 않습니다. 어댑터를 의도에 맞게 설정한 다음, 통제된 장애 상황에서 동작을 검증하십시오.
Session, HTTPAdapter, urllib3 Retry는 어떻게 함께 동작합니까?
Session은 요청 URL에 맞는 마운트된 어댑터를 선택합니다. 어댑터는 재시도 정책을 urllib3의 전송 호출에 전달합니다.
지수 백오프 지연 시간은 어떻게 계산됩니까?
이번 설정의 factor 0.5는 0, 1, 2, 4, 8초의 기본 대기 시간을 만들었습니다. 지터는 이후 대기 시간에 영향을 주므로, 반복 실행해도 측정된 경과 시간과 같지 않을 수 있습니다.
Python에서 429와 Retry-After는 어떻게 처리해야 합니까?
작업이 감당할 수 있다면 요청된 시간만큼 기다리십시오. 그렇지 않으면 더 일찍 재시도하지 말고 작업을 중단하거나 미루십시오.
타임아웃 후 POST를 재시도해도 안전합니까?
타임아웃이 발생하면 쓰기 작업의 결과가 불확실하게 남습니다. 다시 보내기 전에 API 고유의 재실행 보장을 확인하십시오.
이 스크립트들은 전체 마감 시한을 강제했습니까?
아닙니다. 시도 정책과 호출별 타임아웃으로는 경과 시간의 엄격한 상한을 정할 수 없습니다.
재시도 정책과 함께 프록시가 필요하십니까?
승인된 작업에 프록시 라우팅이 필요하다면 Python Requests용 프록시 옵션과 DataImpulse 레지덴셜 프록시(residential proxy)를 확인해 보십시오. DataImpulse는 프록시를 제공하며, 스크래핑 API, 관리형 언블로커, VPN, 데이터셋은 제공하지 않습니다. 재실행 판단, 처리 속도 조절, 실패 처리는 사용자의 클라이언트에서 직접 관리하십시오.
최종 업데이트: 2026년 10월 16일