
En este artículo
Implemente python requests retry con una Session, un HTTPAdapter y una política Retry de urllib3, y después fije timeouts explícitos en cada llamada. Mantenga en el mismo diseño la seguridad de la repetición, el número de intentos y el ritmo que marca el servidor.
Empiece por los scripts probados que figuran más abajo. Nuestra prueba rápida del 16 de octubre de 2026 muestra qué ocurrió ante fallos locales controlados, incluido un 503 persistente que siguió siendo un fallo tras cada reintento.
Datos clave
- Un Retry de urllib3 montado sobre un HTTPAdapter añade reintentos a todas las llamadas de una requests.Session.
- Un endpoint con respuestas 503, 503, 200 tuvo éxito en el intento 3 tras 1,2 s en nuestra prueba local.
- Un 429 con Retry-After: 2 esperó exactamente 2,0 s antes del reintento.
- Un endpoint que fallaba de forma permanente se detuvo tras 6 intentos y 15,7 s en lugar de entrar en un bucle.
- POST no se reintenta por defecto; añádalo solo para llamadas idempotentes.
- Tenacity ofrece el mismo patrón para cualquier función, con cada espera registrada en el log.
¿Cómo se implementa Python Requests Retry?
Monte un adaptador con reintentos configurados tanto para HTTP como para HTTPS y realice las llamadas a través de esa Session. Este es nuestro requests_retry.py probado; inicie el servidor local que se muestra más adelante antes de ejecutarlo.
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
Requests no reintenta las conexiones fallidas por defecto. Una Session conserva la configuración y reutiliza conexiones; su HTTPAdapter montado transmite la política de reintentos a urllib3. Consulte el uso avanzado de Requests.
Este script de medición imprime la respuesta final, errores incluidos. En el código de una aplicación, llame a raise_for_status() antes de consumir un resultado correcto y gestione los fallos terminales de RequestException en el límite del llamador. La llamada a reset es una preparación local y no tiene timeout explícito; no copie esa omisión en llamadas remotas. Consulte la gestión de errores de Requests.
¿Qué fallos debe gestionar Python Requests Retry?
Reintente los fallos que de forma plausible puedan desaparecer, y solo cuando repetir la operación sea aceptable. Use esta comprobación de seguridad de reintentos en 4 pasos antes de elegir la configuración.
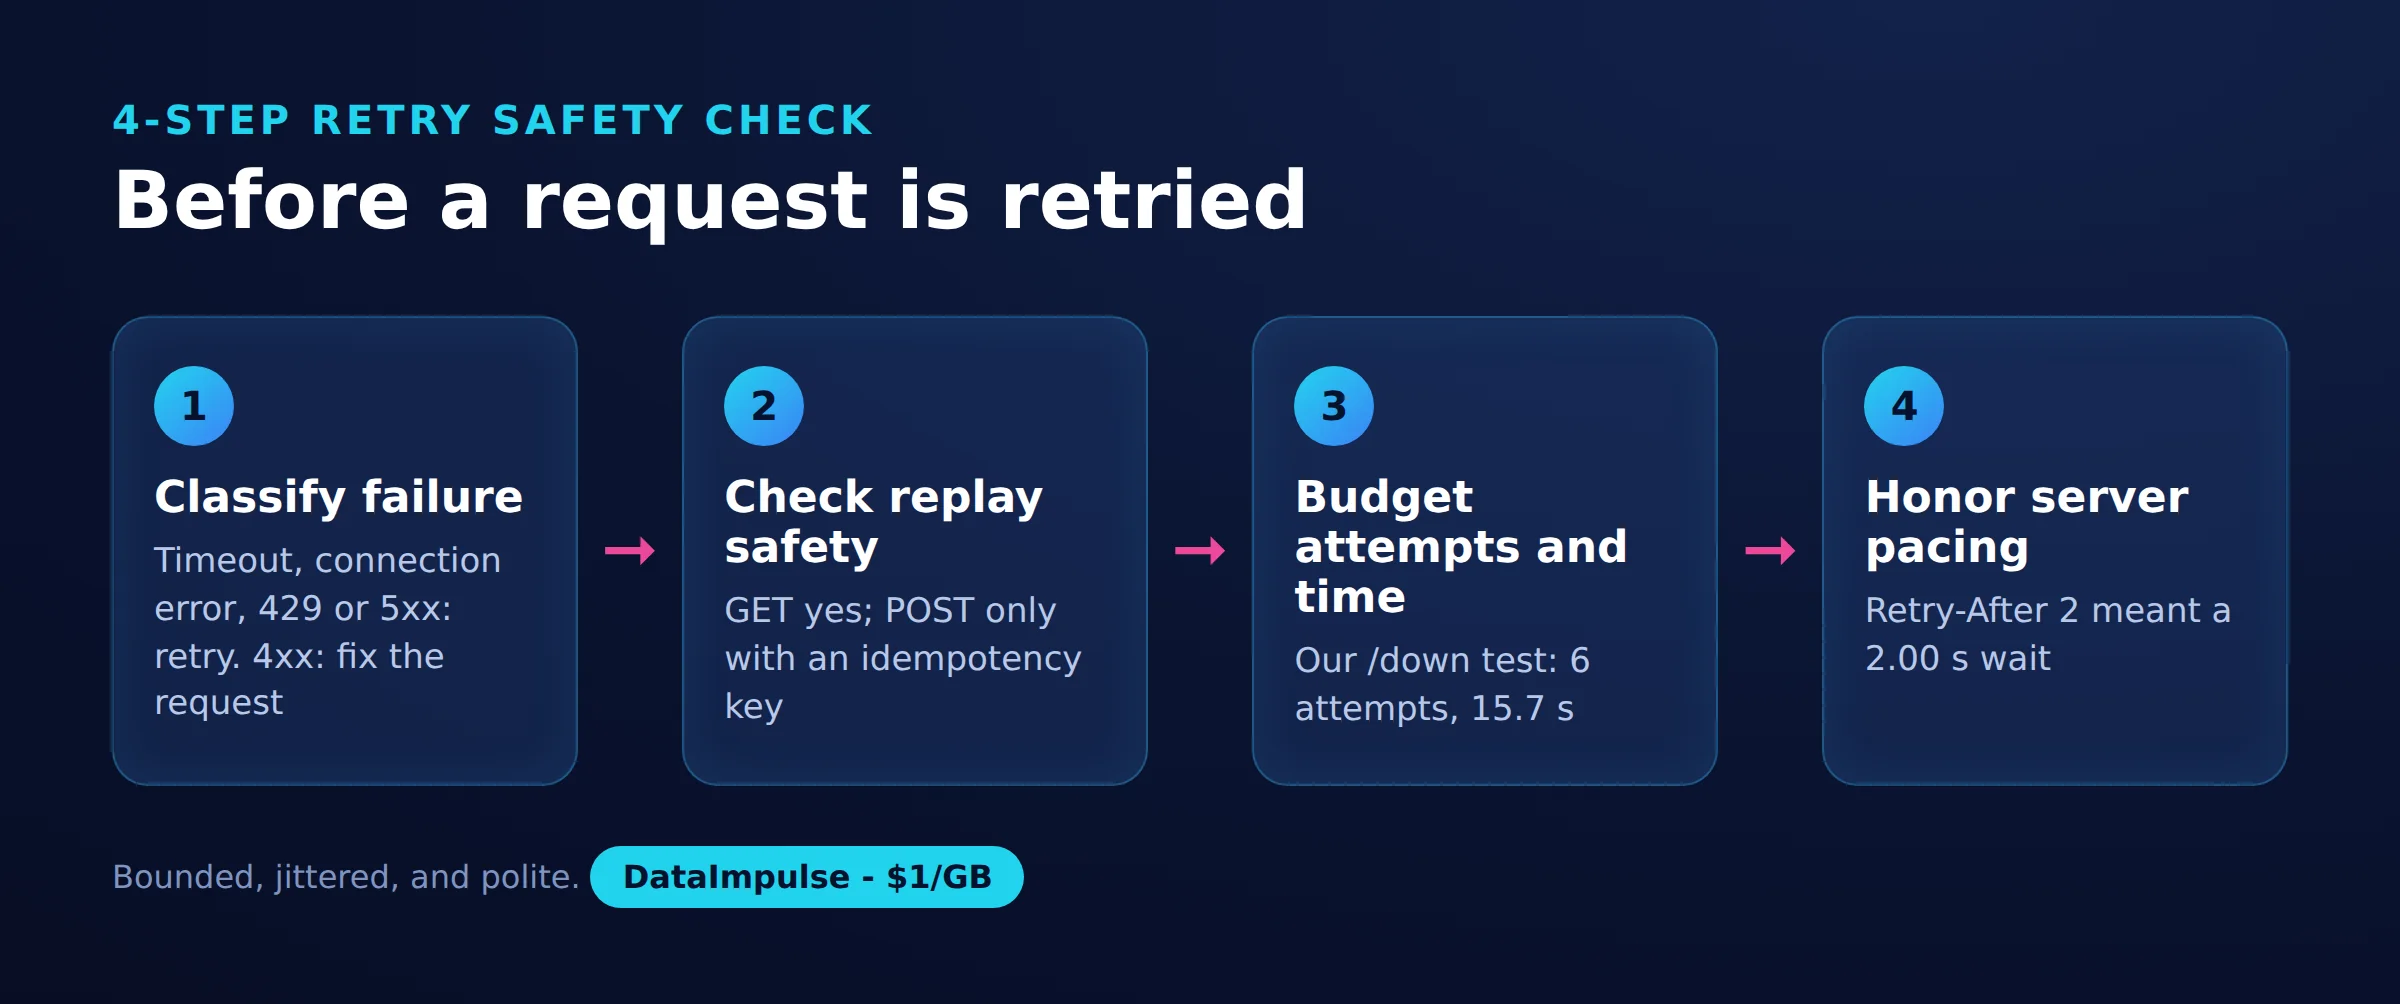
- Paso 1: clasifique el fallo. Distinga los fallos de conexión, los fallos de lectura y las respuestas HTTP. Nuestra lista candidata de estados es 429, 500, 502, 503 y 504; revísela con el contrato del endpoint.
- Paso 2: compruebe la seguridad de la repetición. Decida si otra solicitud podría duplicar una escritura u otro efecto secundario.
- Paso 3: presupueste intentos y tiempo. Defina el máximo de llamadas, la espera aceptable y el plazo del llamador antes de activar los reintentos.
- Paso 4: respete el ritmo del servidor. Respete Retry-After y detenga o aplace el trabajo cuando la espera exigida supere su presupuesto.
No use los reintentos como una reparación universal. Investigue por separado las respuestas 403 y los errores 407 de autenticación del proxy. Una estrategia de python requests retry debe preservar las condiciones de acceso y las normas de datos aplicables.
¿Cómo funcionan el backoff exponencial y el jitter?
El backoff exponencial aumenta la espera tras fallos repetidos; el jitter añade aleatoriedad. En nuestra configuración, las esperas base fueron de 0, 1, 2, 4 y 8 segundos.
Para el reintento número k, empezando en 1, el primer backoff de urllib3 es cero; las esperas posteriores usan backoff_factor * 2**(k-1). Se suma un jitter uniforme de cero hasta backoff_jitter, sujeto a backoff_max. La referencia de urllib3 2.0.7 documenta estos controles.
Nuestro entorno usó urllib3 2.0.7, que acepta backoff_jitter. Adapte el ejemplo a la versión que tenga instalada en lugar de dar por supuesta la compatibilidad. Cambie el factor para ajustar el crecimiento y el rango del jitter para repartir los reintentos; una política de espera personalizada corresponde a una capa de reintentos elegida de forma deliberada.
El resultado observado de 1,20 segundos en el endpoint inestable refleja un solo sorteo aleatorio y la sobrecarga de la ejecución local. No predice la latencia de su API.
¿Cómo se deben gestionar 429 y Retry-After?
Respete un valor válido de Retry-After antes de volver a intentarlo, salvo que la operación deba detenerse. La cabecera admite tanto segundos de espera como una fecha HTTP, como se explica en la referencia de Retry-After de MDN.
Con la gestión de la cabecera activada, urllib3 da prioridad a una espera positiva de Retry-After sobre su backoff calculado. Si no hay una espera positiva utilizable, se aplica el backoff exponencial; las cabeceras mal formadas requieren una gestión de errores explícita. Consulte el comportamiento de sleep en urllib3.
Nuestro 429 local solicitó dos segundos y el siguiente intento tuvo éxito tras 2,00 segundos. El script no aplica ningún plazo global: si un servidor pide más espera de la que su operación permite, deténgase o reprograme en lugar de acortar la espera solicitada. Planifique ese comportamiento junto con su política de límite de tasa de la API.
¿Cómo afectan a los reintentos los timeouts de conexión y de lectura?
Un timeout acota una fase concreta de la espera, no la operación completa. El establecimiento de la conexión, la lectura de la respuesta, los intentos repetidos y el backoff contribuyen al tiempo total transcurrido.
En timeout=(3.05, 10), el primer valor controla la espera de la conexión y el segundo controla la inactividad durante la lectura. Ninguno es un plazo de reloj; además, Requests no tiene timeout por defecto. Consulte la semántica de los timeouts en Requests.
Nuestro presupuesto de cinco reintentos permitió seis intentos. Los contadores de conexión y de lectura restringen sus respectivas categorías de fallo dentro de ese presupuesto global, en lugar de sumar margen adicional. Los controles de presupuesto de Retry incluyen total=0 para evitar reintentos (a octubre de 2026).
No dé por hecho que se repite todo fallo de lectura del cuerpo. El código fuente del adaptador de Requests pasa preload_content=False; los fallos durante el consumo posterior del cuerpo pueden producirse fuera del ciclo de reintentos del adaptador. Pruebe los cuerpos interrumpidos por separado y aplique cualquier plazo estricto en un límite de la aplicación capaz de detener la operación.
¿Se pueden reintentar solicitudes POST de forma segura?
Un timeout en un POST no basta por sí solo para establecer que la repetición es segura. El servidor puede haber completado la escritura antes de que el cliente perdiera su respuesta.
Repita la solicitud solo cuando la API documente un comportamiento idempotente o un mecanismo de deduplicación que cubra la operación. Reutilice la misma identidad de operación y la misma carga bajo ese contrato; añadir una cabecera de idempotencia arbitraria no crea ninguna garantía. Esto sigue las consideraciones sobre repetición de la especificación de idempotencia de HTTP.
El conjunto de métodos por defecto de urllib3 excluye POST. Nuestro conjunto más estricto permite GET, HEAD y OPTIONS para los reintentos por estado y por lectura; el filtrado por método no es una prohibición universal de los reintentos de conexión antes de la transmisión. Consulte los métodos de Retry y las categorías de fallo. Mantenga este ejemplo centrado en lecturas.
¿Cómo se registran los intentos y se diagnostican los reintentos agotados?
Registre la categoría del fallo, el número de intento, la espera elegida, el tiempo transcurrido y el resultado final. Use una etiqueta de ruta depurada en lugar de la URL completa.
Los scripts activan el registro de diagnóstico para solicitudes inofensivas a localhost. Antes de adaptarlos, elimine de los logs y de las excepciones los componentes sensibles de la URL; el ejemplo de Tenacity incluye su URL en el mensaje de una excepción. No registre nunca credenciales, cabeceras de autorización ni cuerpos de respuesta privados.
Nuestro 503 persistente siguió siendo una respuesta porque raise_on_status=False. Los fallos de transporte aún pueden lanzar excepciones; Requests traduce los fallos subyacentes a tipos como ConnectionError, ConnectTimeout y RetryError. Además, un max_retries entero no expresa la política explícita de estados que se muestra aquí. Consulte la implementación del adaptador.
Compruebe que las llamadas usan su Session configurada y el montaje correspondiente. Ciérrela al terminar e investigue los fallos específicos de la red con la guía de solución de problemas de proxies. Evite añadir un segundo bucle de reintentos alrededor de un cliente que ya reintenta.
¿Cuándo usar Retry de urllib3, Tenacity o backoff?
Elija una sola capa que se encargue de los reintentos. Use la configuración del transporte para la política HTTP y un decorador de función cuando los resultados de la aplicación determinen si se repite el trabajo.
| Opción | Use X cuando… | Evite X cuando… |
|---|---|---|
| urllib3 Retry | Use urllib3 Retry cuando encaje la política de transporte y de estados. | Evite urllib3 Retry cuando reintente un flujo de trabajo completo de la aplicación. |
| Tenacity | Use Tenacity cuando resultados personalizados, excepciones o corrutinas determinen los reintentos. | Evite Tenacity cuando envuelva un cliente que ya reintenta sin coordinar los presupuestos. |
| backoff | Use backoff cuando encaje una política basada en decoradores. | Evite backoff cuando espere una clasificación automática de estados HTTP sin configuración. |
Retry centraliza el filtrado HTTP. Tenacity separa las políticas de reintento, espera y parada, admite reintentos de corrutinas y ofrece callbacks de registro. Su stop_after_attempt cuenta las llamadas, incluida la primera (a octubre de 2026). Consulte la documentación de Tenacity y la referencia de políticas de espera.
Nuestro tenacity_retry.py probado repite el mismo GET inestable con tiempos distintos. No es equivalente para 429: no inspecciona Retry-After.
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
Aquí, los estados seleccionados se convierten en excepciones, las esperas usan jitter exponencial y el agotamiento vuelve a lanzar la última excepción. La categoría amplia de excepciones de conexión requiere una revisión específica para cada endpoint.
A modo de comparación, backoff combina on_exception u on_predicate con un generador de esperas; su jitter por defecto documentado es el jitter completo. El filtrado por estado requiere su propio predicado o política de excepciones. Su max_tries limita el total de llamadas (a octubre de 2026). Consulte el repositorio oficial de backoff. No medimos backoff.
¿Qué muestra una prueba rápida y reproducible de reintentos?
Nuestra prueba rápida del 16 de octubre de 2026 demostró recuperación, espera dirigida por el servidor y agotamiento. Es una instantánea pequeña, no un benchmark.
Andrii ejecutó Linux, Python 3.12, requests 2.31.0, urllib3 2.0.7 y tenacity 9.1.4. Fuentes: requests_retry.py, tenacity_retry.py y retry_server.py, reproducidos aquí. La muestra fue una invocación por endpoint con urllib3 y una invocación del endpoint inestable con Tenacity, reiniciando los contadores locales entre scripts. Todo el tráfico permaneció en 127.0.0.1.
| Política y endpoint | Estado final | Intentos | Tiempo transcurrido |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0,00 s |
| urllib3 /flaky | 200 | 3 | 1,20 s |
| urllib3 /limited | 200 | 2 | 2,00 s |
| urllib3 /down | 503 | 6 | 15,69 s |
| Tenacity /flaky | 200 | 3 | 3,82 s |
Tenacity registró esperas de 1,36 y 2,45 segundos. Los distintos ajustes de espera explican la diferencia de tiempos; estas observaciones no permiten clasificar las bibliotecas. No hubo pruebas repetidas, clientes concurrentes, conexiones remotas ni fallos de timeout medidos.
Ejecute retry_server.py en una terminal y después cada cliente por separado en otra:
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
No se midió el ancho de banda. Para planificar, estime los bytes transferidos sumando los bytes de solicitud, respuesta y protocolo en todos los intentos; seis intercambios del mismo tamaño costarían aproximadamente seis veces un intercambio, aunque los cuerpos de error reales difieren.
Una futura simulación con semilla podría comparar un jitter personalizado con las políticas de las bibliotecas bajo presupuestos de intentos idénticos, registrando latencia, colisiones de programación y probabilidad simulada de éxito. Esas serían métricas simuladas, separadas de esta tabla observada.
Preguntas frecuentes
¿Python Requests reintenta automáticamente?
No por defecto en las conexiones fallidas. Configure el adaptador de forma deliberada y verifique después el comportamiento con un fallo controlado.
¿Cómo funcionan juntos Session, HTTPAdapter y Retry de urllib3?
La Session selecciona su adaptador montado para la URL de la solicitud. El adaptador transmite la política de reintentos a las llamadas de transporte de urllib3.
¿Cómo se calculan las esperas del backoff exponencial?
Nuestro factor de 0,5 produjo esperas base de 0, 1, 2, 4 y 8 segundos. El jitter afectó a las esperas posteriores, por lo que las ejecuciones repetidas no tienen por qué coincidir con los tiempos medidos.
¿Cómo debe gestionar Python 429 y Retry-After?
Espere lo solicitado cuando la operación pueda permitírselo. En caso contrario, detenga o aplace la operación en lugar de reintentar antes.
¿Es seguro reintentar un POST tras un timeout?
Un timeout deja incierto el resultado de la escritura. Exija una garantía de repetición específica de la API antes de enviarlo de nuevo.
¿Aplicaron estos scripts un plazo global?
No. Sus políticas de intentos y los timeouts por llamada no establecen un límite estricto de tiempo transcurrido.
¿Necesita un proxy junto con su política de reintentos?
Si su carga de trabajo autorizada necesita enrutamiento mediante proxy, revise las opciones de proxy para Python Requests y los proxies residenciales de DataImpulse. DataImpulse suministra proxies, no una API de scraping, un desbloqueador gestionado, una VPN ni un conjunto de datos. Mantenga en su cliente las decisiones de repetición, el ritmo y la gestión de fallos.
Última actualización: 16 de octubre de 2026.