
本文内容
使用 Session、HTTPAdapter 和 urllib3 Retry 策略来实现 python requests retry,然后为每次调用设置显式超时。请在同一套设计中兼顾重放安全、尝试次数和服务器节奏。
请先看下面经过测试的脚本。我们于 2026 年 10 月 16 日针对可控的本地故障做了一次快速运行,其中包括一个持续返回的 503,它在每次重试后依然是失败结果。
关键要点
- 把 urllib3 Retry 挂载到 HTTPAdapter 上,就能为 requests.Session 中的每次调用加入重试。
- 在我们的本地测试中,返回 503、503、200 的端点在第 3 次尝试成功,耗时 1.2 s。
- 返回 429 且带有 Retry-After: 2 的请求,在重试前恰好等待了 2.0 s。
- 一个始终失败的端点在 6 次尝试、15.7 s 后停止,而不是无限循环。
- POST 默认不会重试;仅在调用具有幂等性时才将其加入。
- Tenacity 能为任意函数提供同样的模式,并记录每一次等待。
如何实现 Python Requests 重试?
为 HTTP 和 HTTPS 同时挂载配置了重试的适配器,然后通过该 Session 发起调用。这是我们测试过的 requests_retry.py;运行前请先启动后文给出的本地服务器。
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
Requests 默认不会重试失败的连接。Session 会保留设置并复用连接池;其挂载的 HTTPAdapter 会把重试策略传给 urllib3。参见 Requests 高级用法。
这个测量脚本会打印最终响应,包括错误。在应用代码中,请在使用成功结果之前调用 raise_for_status(),并在调用方边界处理最终的 RequestException 失败。重置调用只是本地准备工作,没有设置显式超时;请不要在远程调用中照搬这种省略。参见 Requests 错误处理。
Python Requests 重试应该处理哪些失败?
只重试那些有可能自行消失的失败,并且只在重复执行该操作可以接受时才重试。选择设置之前,请先做这个四步重试安全检查。
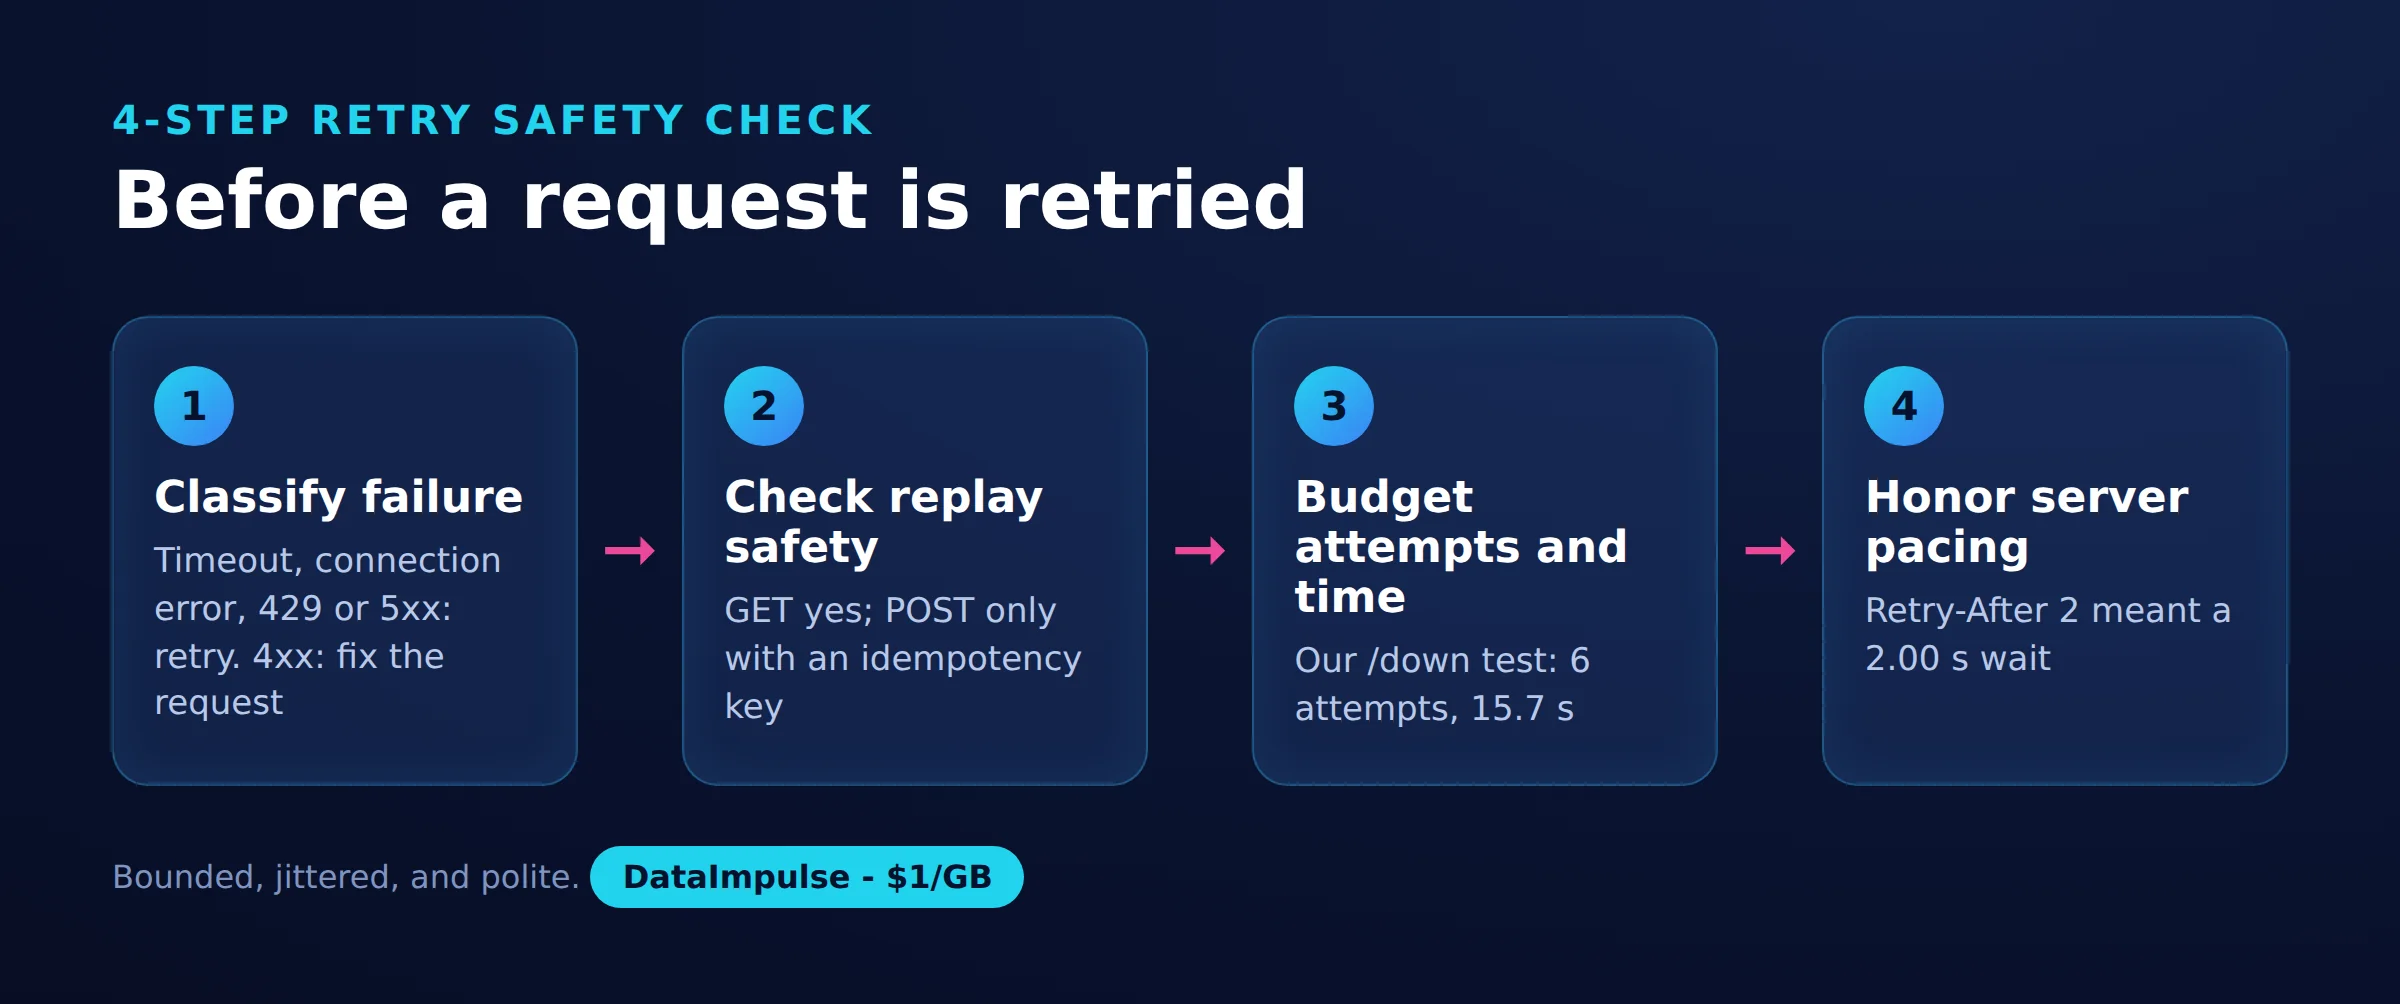
- 第 1 步:对失败分类。区分连接失败、读取失败和 HTTP 响应。我们的候选状态码列表是 429、500、502、503 和 504;请对照端点的约定进行复核。
- 第 2 步:检查重放安全。判断再发一次请求是否可能重复写入或产生其他副作用。
- 第 3 步:为尝试次数和时间设定预算。启用重试之前,先确定最大调用次数、可接受的等待时间和调用方的截止时间。
- 第 4 步:遵从服务器节奏。遵守 Retry-After;当所需等待超出预算时,停止或推迟该工作。
不要把重试当作万能的修复手段。请单独排查 403 响应和 407 代理认证错误。python requests retry 策略应当保持访问条件,并遵守适用的数据规则。
指数退避和抖动是如何工作的?
指数退避会在连续失败后增加延迟;抖动则加入随机性。在我们的配置中,基础休眠时间依次为 0、1、2、4 和 8 秒。
对于第 k 次重试(从 1 开始),urllib3 的第一次退避为零;之后的延迟使用 backoff_factor * 2**(k-1)。再加上从零到 backoff_jitter 的均匀分布抖动,并受 backoff_max 限制。urllib3 2.0.7 参考文档记录了这些控制项。
我们的环境使用 urllib3 2.0.7,它支持 backoff_jitter。请根据您已安装的版本来调整示例,不要想当然地认为兼容。调整系数可以改变增长速度,调整抖动范围可以分散重试;自定义的等待策略应放在经过刻意选择的重试层中。
观察到的 1.20 秒不稳定端点结果只反映了一次随机取值和本地执行开销,并不能预测您的 API 的延迟。
应该如何处理 429 和 Retry-After?
在再次尝试之前,请遵从有效的 Retry-After 值,除非该操作必须停止。该响应头可以是延迟秒数,也可以是 HTTP 日期,详见 MDN 的 Retry-After 参考。
启用响应头处理后,urllib3 会优先采用为正数的 Retry-After 延迟,而不是它自己计算的退避。如果没有可用的正数延迟,则采用指数退避;格式错误的响应头需要显式的错误处理。参见 urllib3 的休眠行为。
我们本地的 429 要求等待两秒,下一次尝试在 2.00 秒后成功。该脚本没有强制执行整体截止时间:如果服务器要求的等待时间超出您的操作所允许的范围,请停止或重新安排,而不是缩短它要求的等待。请将这一行为与您的 API 速率限制策略一并规划。
连接超时和读取超时如何影响重试?
超时限制的是某个特定的等待阶段,而不是整个操作。建立连接、读取响应、重复尝试和退避都会计入耗时。
在 timeout=(3.05, 10) 中,第一个值控制连接等待,第二个值控制读取空闲时间。两者都不是挂钟时间意义上的截止时间;另外,Requests 默认没有超时。参见 Requests 超时语义。
我们的五次重试预算允许共 6 次尝试。连接和读取计数器只是在这一总预算之内限制各自的失败类别,并不会额外增加配额。Retry 预算控制包含用于禁止重试的 total=0(截至 2026 年 10 月)。
不要假定每一次响应体读取失败都会被重放。Requests 适配器源码传入了 preload_content=False;之后在读取响应体时发生的失败,可能出现在适配器的重试周期之外。请单独测试被中断的响应体,并在能够终止该操作的应用边界处强制执行任何严格的截止时间。
可以安全地重试 POST 请求吗?
仅凭 POST 超时,无法确定重放是否安全。客户端丢失响应之前,服务器可能已经完成了写入。
只有当 API 文档明确说明了幂等行为,或有覆盖该操作的去重机制时,才可以重放。请在该约定下复用相同的操作标识和负载;随意添加一个幂等性请求头并不能创造任何保证。这遵循了 HTTP 幂等性规范中关于重放的考量。
urllib3 的默认方法集合不包含 POST。我们更窄的集合只允许 GET、HEAD 和 OPTIONS 参与状态码重试和读取重试;按方法过滤并不等于一概禁止在发送之前的连接重试。参见 Retry 的方法与失败类别。本示例只聚焦于读取操作。
如何记录每次尝试并诊断重试耗尽?
请记录失败类别、尝试序号、选定的等待时间、已耗时间和最终结果。使用经过脱敏的路由标签,而不是完整的 URL。
这些脚本针对无害的 localhost 请求启用了诊断日志。在改用到您的场景之前,请从日志和异常中移除敏感的 URL 组成部分;Tenacity 示例在异常消息中包含了其 URL。切勿记录凭据、授权请求头或私有的响应体。
我们的持续 503 之所以仍以响应形式返回,是因为设置了 raise_on_status=False。传输层失败仍可能抛出异常;Requests 会把底层失败转换为 ConnectionError、ConnectTimeout 和 RetryError 等类型。此外,整数形式的 max_retries 也无法表达此处展示的显式状态码策略。参见适配器实现。
请确认调用使用的是您配置的 Session 及对应的挂载。用完后将其关闭,并参考代理故障排查指南来排查与网络相关的失败。避免在已经带有重试功能的客户端外面再套一层重试循环。
何时使用 urllib3 Retry、Tenacity 或 backoff?
请选择一层来统一负责重试。HTTP 策略使用传输层配置;当由应用层的结果来决定是否重复执行工作时,则使用函数包装器。
| 方案 | 适合使用 X 的情形 | 应避免使用 X 的情形 |
|---|---|---|
| urllib3 Retry | 当传输层和状态码策略能满足需求时,使用 urllib3 Retry。 | 当需要重试整个应用工作流时,避免使用 urllib3 Retry。 |
| Tenacity | 当自定义结果、异常或协程驱动重试时,使用 Tenacity。 | 当包装一个已带重试的客户端且没有协调预算时,避免使用 Tenacity。 |
| backoff | 当基于装饰器的策略合适时,使用 backoff。 | 当期望不经配置就自动对 HTTP 状态码分类时,避免使用 backoff。 |
Retry 集中处理 HTTP 过滤。Tenacity 将重试、等待和停止策略分开,支持协程重试,并提供日志回调。它的 stop_after_attempt 统计的是调用次数,包括第一次调用(截至 2026 年 10 月)。参见 Tenacity 文档和等待策略参考。
我们测试过的 tenacity_retry.py 以不同的时序重复同一个不稳定的 GET。它在 429 上并不等价:它不会检查 Retry-After。
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
在这里,选定的状态码会被转换为异常,等待采用指数抖动,重试耗尽后会重新抛出最后一个异常。范围较宽的连接异常类别需要针对具体端点进行复核。
作为对比,backoff 将 on_exception 或 on_predicate 与一个等待生成器结合使用;其文档中的默认抖动是完全抖动。状态码过滤需要您自己的谓词或异常策略。它的 max_tries 限制总调用次数(截至 2026 年 10 月)。参见 backoff 官方仓库。我们没有测量 backoff。
一次快速的可复现重试运行显示了什么?
我们于 2026 年 10 月 16 日做的快速运行展示了恢复、服务器指示的等待以及重试耗尽。这只是一个小样本快照,不是基准测试。
Andrii 使用的环境是 Linux、Python 3.12、requests 2.31.0、urllib3 2.0.7 和 tenacity 9.1.4。来源:requests_retry.py、tenacity_retry.py 和 retry_server.py,均已在此处复现。样本为:每个端点使用 urllib3 调用一次,以及使用 Tenacity 调用一次不稳定端点,并在各脚本之间重置本地计数器。所有流量都停留在 127.0.0.1。
| 策略与端点 | 最终状态 | 尝试次数 | 耗时 |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0.00 s |
| urllib3 /flaky | 200 | 3 | 1.20 s |
| urllib3 /limited | 200 | 2 | 2.00 s |
| urllib3 /down | 503 | 6 | 15.69 s |
| Tenacity /flaky | 200 | 3 | 3.82 s |
Tenacity 记录的等待时间为 1.36 秒和 2.45 秒。等待设置的不同解释了耗时差异;这些观察结果无法用来给各个库排名。本次没有重复试验、并发客户端、远程连接,也没有测量超时失败。
先在一个终端中运行 retry_server.py,再在另一个终端中分别运行各个客户端:
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
本次没有测量带宽。做规划时,可以把各次尝试中的请求、响应和协议字节相加来估算传输的字节数;六次大小相同的交互大约相当于一次交互的六倍,但实际的错误响应体大小各不相同。
未来可以做一次带随机种子的模拟,在相同的尝试预算下比较自定义抖动与各库的策略,并记录延迟、调度冲突和模拟的成功概率。这些将是模拟指标,与本文观察到的表格是分开的。
常见问题
Python Requests 会自动重试吗?
对于失败的连接,默认不会。请有意识地配置适配器,然后针对可控的故障验证其行为。
Session、HTTPAdapter 和 urllib3 Retry 如何协同工作?
Session 会根据请求的 URL 选择其挂载的适配器。适配器再把重试策略传入 urllib3 的传输调用。
指数退避的延迟是如何计算的?
我们使用的系数 0.5 产生的基础等待时间依次为 0、1、2、4 和 8 秒。抖动会影响后面的等待时间,因此重复运行的结果不一定与测得的耗时一致。
Python 应该如何处理 429 和 Retry-After?
如果操作能承受,就按要求等待。否则请停止或推迟该操作,而不是提前重试。
超时后重试 POST 安全吗?
超时会使写入的结果变得不确定。再次发送之前,需要有针对该 API 的重放保证。
这些脚本强制执行了整体截止时间吗?
没有。它们的尝试策略和单次调用超时并不能确立严格的耗时上限。
重试策略之外还需要代理吗?
如果您经过授权的工作负载需要代理路由,请查看 适用于 Python Requests 的代理选项和 DataImpulse 住宅代理。DataImpulse 提供的是代理,而不是爬取 API、托管式解锁器、VPN 或数据集。请在您的客户端中处理重放决策、节奏控制和失败处理。
最后更新:2026 年 10 月 16 日。