
In diesem Artikel
Setze Python Requests Retry mit einer Session, einem HTTPAdapter und einer urllib3-Retry-Richtlinie um und lege dann bei jedem Aufruf explizite Timeouts fest. Behalte dabei Wiederholungssicherheit, Versuchsanzahl und das Tempo des Servers im selben Design im Blick.
Beginne mit den getesteten Skripten unten. Unser kurzer Testlauf vom 16. Oktober 2026 zeigt, was bei kontrollierten lokalen Fehlern passiert ist, darunter ein dauerhafter 503-Fehler, der nach jedem Retry ein Fehler blieb.
Das Wichtigste auf einen Blick
- Ein urllib3 Retry, der auf einen HTTPAdapter gemountet wird, ergänzt Retries für jeden Aufruf in einer requests.Session.
- Ein Endpunkt mit 503, 503, 200 war in unserem lokalen Test nach 1,2 s bei Versuch 3 erfolgreich.
- Eine 429-Antwort mit Retry-After: 2 wartete genau 2,0 s vor dem Retry.
- Ein dauerhaft fehlschlagender Endpunkt wurde nach 6 Versuchen und 15,7 s beendet, statt endlos zu laufen.
- POST wird standardmäßig nicht wiederholt; füge es nur für idempotente Aufrufe hinzu.
- Tenacity bietet dasselbe Muster für jede Funktion, wobei jede Wartezeit protokolliert wird.
Wie setzt du Python Requests Retry um?
Mounte einen Adapter mit Retry-Konfiguration für HTTP und HTTPS und sende deine Aufrufe dann über diese Session. Das ist unser getestetes requests_retry.py; starte vor der Ausführung den weiter unten gezeigten lokalen Server.
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
Requests wiederholt fehlgeschlagene Verbindungen standardmäßig nicht. Eine Session behält Einstellungen bei und poolt Verbindungen; der gemountete HTTPAdapter reicht die Retry-Richtlinie an urllib3 weiter. Siehe Requests advanced usage.
Dieses Messskript gibt die finale Antwort aus, auch bei Fehlern. Rufe im Anwendungscode raise_for_status() auf, bevor du ein erfolgreiches Ergebnis weiterverarbeitest, und behandle endgültige RequestException-Fehler an der Aufrufergrenze. Der Reset-Aufruf ist lokales Setup und hat kein explizites Timeout; übernimm diese Auslassung nicht in Aufrufe an entfernte Server. Siehe Requests error handling.
Welche Fehler sollte Python Requests Retry behandeln?
Wiederhole Fehler, die plausibel wieder verschwinden könnten, und nur dann, wenn eine Wiederholung der Operation vertretbar ist. Nutze diese Retry-Sicherheitsprüfung in 4 Schritten, bevor du Einstellungen wählst.
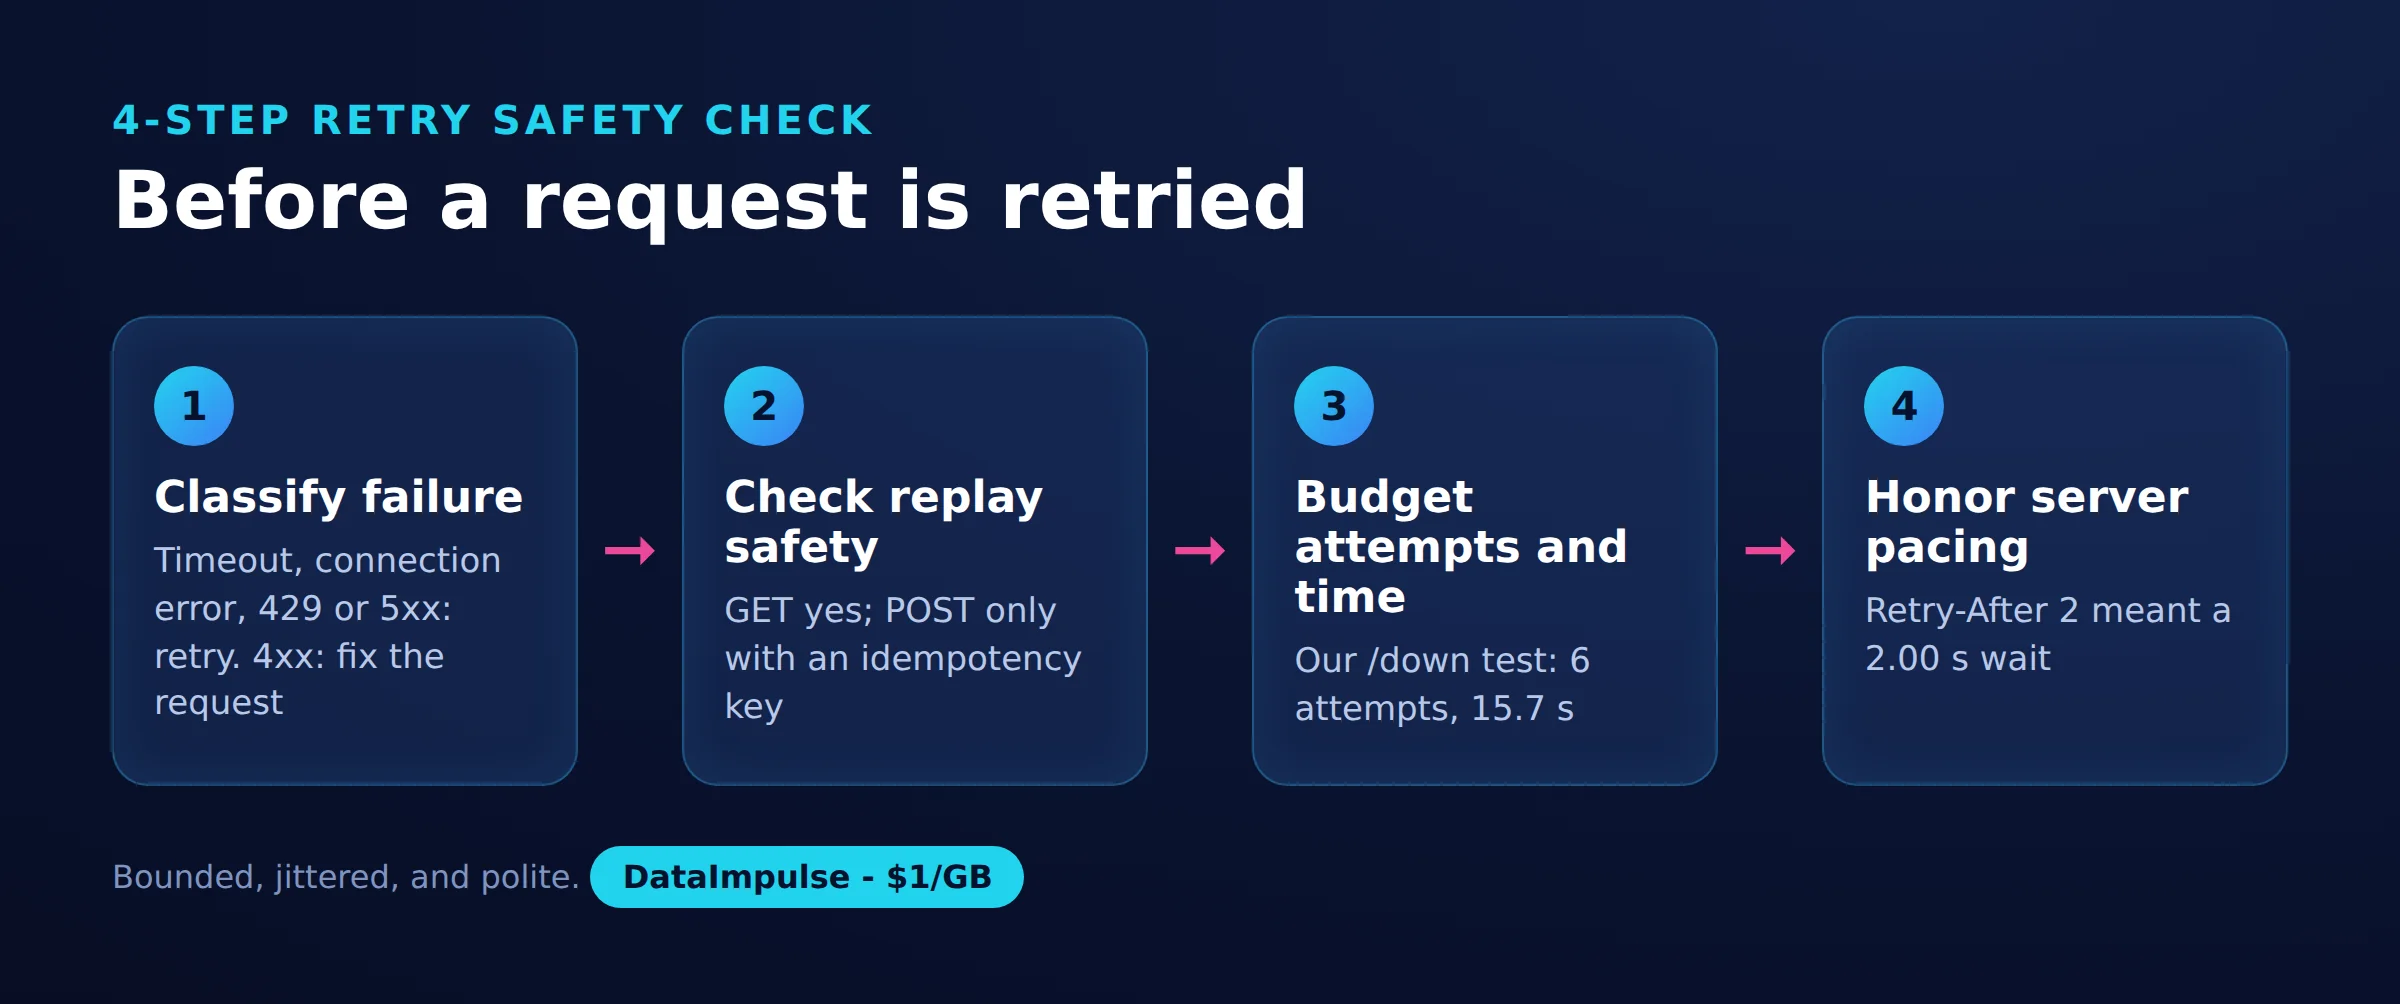
- Schritt 1: Fehler klassifizieren. Trenne Verbindungsfehler, Lesefehler und HTTP-Antworten. Unsere Kandidatenliste für Statuscodes lautet 429, 500, 502, 503 und 504; prüfe sie anhand des Vertrags des Endpunkts.
- Schritt 2: Wiederholungssicherheit prüfen. Entscheide, ob eine weitere Anfrage einen Schreibvorgang oder einen anderen Seiteneffekt duplizieren könnte.
- Schritt 3: Versuche und Zeit budgetieren. Lege die maximale Anzahl an Aufrufen, die akzeptable Wartezeit und die Deadline des Aufrufers fest, bevor du Retries aktivierst.
- Schritt 4: Das Tempo des Servers respektieren. Beachte Retry-After und brich die Arbeit ab oder verschiebe sie, wenn die geforderte Wartezeit dein Budget übersteigt.
Setze Retries nicht als Allheilmittel ein. Untersuche 403-Antworten und 407-Fehler bei der Proxy-Authentifizierung getrennt. Eine Python-Requests-Retry-Strategie sollte die Zugriffsbedingungen und geltende Datenregeln wahren.
Wie funktionieren Exponential Backoff und Jitter?
Exponential Backoff vergrößert die Wartezeit nach wiederholten Fehlern; Jitter fügt Zufall hinzu. In unserer Konfiguration betrugen die Basiswartezeiten 0, 1, 2, 4 und 8 Sekunden.
Für Retry Nummer k, beginnend bei 1, ist das erste Backoff in urllib3 null; die folgenden Wartezeiten verwenden backoff_factor * 2**(k-1). Dazu kommt gleichverteilter Jitter von null bis backoff_jitter, begrenzt durch backoff_max. Die urllib3-2.0.7-Referenz dokumentiert diese Einstellungen.
Unsere Umgebung nutzte urllib3 2.0.7, das backoff_jitter akzeptiert. Gleiche das Beispiel mit deiner installierten Version ab, statt Kompatibilität anzunehmen. Ändere den Faktor, um das Wachstum anzupassen, und den Jitter-Bereich, um Retries zu streuen; eine eigene Wartelogik gehört in eine bewusst gewählte Retry-Ebene.
Das beobachtete Ergebnis von 1,20 Sekunden beim instabilen Endpunkt spiegelt eine einzelne Zufallsziehung und den lokalen Ausführungs-Overhead wider. Es sagt nichts über die Latenz deiner API voraus.
Wie gehst du mit 429 und Retry-After um?
Beachte einen gültigen Retry-After-Wert, bevor du es erneut versuchst, es sei denn, die Operation muss abgebrochen werden. Der Header akzeptiert entweder Sekunden als Verzögerung oder ein HTTP-Datum, wie in der Retry-After-Referenz von MDN erklärt.
Ist die Header-Auswertung aktiviert, verwendet urllib3 eine positive Retry-After-Verzögerung vor dem berechneten Backoff. Gibt es keine verwendbare positive Verzögerung, greift Exponential Backoff; fehlerhafte Header erfordern eine explizite Fehlerbehandlung. Siehe das Sleep-Verhalten von urllib3.
Unser lokaler 429-Fall forderte zwei Sekunden an, und der nächste Versuch war nach 2,00 Sekunden erfolgreich. Das Skript erzwingt keine Gesamt-Deadline: Fordert ein Server mehr Wartezeit, als deine Operation erlaubt, brich ab oder plane neu, statt die geforderte Wartezeit zu verkürzen. Plane dieses Verhalten zusammen mit deiner Richtlinie zum API-Rate-Limiting.
Wie wirken sich Verbindungs- und Lese-Timeouts auf Retries aus?
Ein Timeout begrenzt eine bestimmte Wartephase, nicht die gesamte Operation. Verbindungsaufbau, Lesen der Antwort, wiederholte Versuche und Backoff tragen alle zur verstrichenen Zeit bei.
In timeout=(3.05, 10) steuert der erste Wert das Warten auf die Verbindung und der zweite die Inaktivität beim Lesen. Keiner von beiden ist eine Wall-Clock-Deadline; außerdem hat Requests kein Standard-Timeout. Siehe Requests timeout semantics.
Unser Budget von fünf Retries erlaubte sechs Versuche. Die Zähler für Verbindung und Lesen begrenzen ihre jeweilige Fehlerkategorie innerhalb dieses Gesamtbudgets, statt zusätzliche Kontingente zu schaffen. Die Retry-Budgetsteuerung enthält total=0, um Retries zu verhindern (Stand: Oktober 2026).
Gehe nicht davon aus, dass jeder Fehler beim Lesen des Bodys wiederholt wird. Die Quelle des Requests-Adapters übergibt preload_content=False; Fehler beim späteren Verarbeiten des Bodys können außerhalb des Retry-Zyklus des Adapters auftreten. Teste unterbrochene Bodys separat und erzwinge jede strikte Deadline an einer Anwendungsgrenze, die die Operation stoppen kann.
Kannst du POST-Anfragen sicher wiederholen?
Ein POST-Timeout allein kann nicht belegen, dass eine Wiederholung sicher ist. Der Server kann den Schreibvorgang abgeschlossen haben, bevor der Client die Antwort verloren hat.
Wiederhole nur dann, wenn die API idempotentes Verhalten oder einen Deduplizierungsmechanismus für die Operation dokumentiert. Verwende unter diesem Vertrag dieselbe Operationsidentität und dieselbe Nutzlast; ein beliebiger Idempotenz-Header schafft keine Garantie. Das folgt den Überlegungen zur Wiederholung in der HTTP-Spezifikation zur Idempotenz.
Die Standard-Methodenmenge von urllib3 schließt POST aus. Unsere engere Menge erlaubt GET, HEAD und OPTIONS für Status- und Lese-Retries; die Methodenfilterung ist kein generelles Verbot für Verbindungs-Retries vor der Übertragung. Siehe Retry method and failure categories. Dieses Beispiel konzentriert sich auf Lesezugriffe.
Wie protokollierst du Versuche und diagnostizierst erschöpfte Retries?
Erfasse Fehlerkategorie, Versuchsnummer, gewählte Wartezeit, verstrichene Zeit und das endgültige Ergebnis. Verwende statt einer vollständigen URL ein bereinigtes Routen-Label.
Die Skripte aktivieren Diagnose-Logging für unbedenkliche localhost-Anfragen. Entferne vor der Anpassung sensible URL-Bestandteile aus Logs und Exceptions; das Tenacity-Beispiel enthält seine URL in einer Fehlermeldung. Protokolliere niemals Zugangsdaten, Authorization-Header oder private Antwort-Bodys.
Unser dauerhafter 503-Fehler blieb eine Antwort, weil raise_on_status=False gesetzt ist. Transportfehler können weiterhin Exceptions auslösen; Requests übersetzt zugrunde liegende Fehler in Typen wie ConnectionError, ConnectTimeout und RetryError. Ein ganzzahliges max_retries bildet außerdem die hier gezeigte explizite Status-Richtlinie nicht ab. Siehe die Adapter-Implementierung.
Prüfe, ob die Aufrufe deine konfigurierte Session und den passenden Mount verwenden. Schließe sie nach Gebrauch und untersuche netzwerkspezifische Fehler mit dem Leitfaden zur Proxy-Fehlerbehebung. Füge keine zweite Retry-Schleife um einen Client herum hinzu, der bereits Retries ausführt.
Wann solltest du urllib3 Retry, Tenacity oder backoff verwenden?
Wähle eine einzige Ebene, die für Retries zuständig ist. Nutze die Transportkonfiguration für die HTTP-Richtlinie und einen Funktions-Wrapper, wenn Anwendungsergebnisse darüber entscheiden, ob Arbeit wiederholt wird.
| Option | Einsetzen, wenn … | Vermeiden, wenn … |
|---|---|---|
| urllib3 Retry | Nutze urllib3 Retry, wenn Transport- und Status-Richtlinie passen. | Vermeide urllib3 Retry, wenn ein gesamter Anwendungs-Workflow wiederholt werden soll. |
| Tenacity | Nutze Tenacity, wenn eigene Ergebnisse, Exceptions oder Coroutinen die Retries steuern. | Vermeide Tenacity, wenn es einen Client umschließt, der bereits Retries ausführt, ohne die Budgets abzustimmen. |
| backoff | Nutze backoff, wenn eine Decorator-basierte Richtlinie passt. | Vermeide backoff, wenn du ohne Konfiguration eine automatische Klassifizierung von HTTP-Status erwartest. |
Retry bündelt die HTTP-Filterung zentral. Tenacity trennt Retry-, Warte- und Stopp-Richtlinien, unterstützt Coroutine-Retries und bietet Logging-Callbacks. Sein stop_after_attempt zählt Aufrufe einschließlich des ersten (Stand: Oktober 2026). Siehe die Tenacity-Dokumentation und die Referenz zur Warte-Richtlinie.
Unser getestetes tenacity_retry.py wiederholt denselben instabilen GET mit anderem Timing. Für 429 ist es nicht gleichwertig: Es wertet Retry-After nicht aus.
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
Hier werden ausgewählte Statuscodes zu Exceptions, die Wartezeiten nutzen Exponential Jitter, und bei Erschöpfung wird die letzte Exception erneut ausgelöst. Die breite Kategorie der Verbindungs-Exceptions muss endpunktspezifisch geprüft werden.
Zum Vergleich: backoff kombiniert on_exception oder on_predicate mit einem Wait-Generator; der dokumentierte Standard-Jitter ist Full Jitter. Für die Statusfilterung brauchst du ein eigenes Prädikat oder eine eigene Exception-Richtlinie. Sein max_tries begrenzt die Gesamtzahl der Aufrufe (Stand: Oktober 2026). Siehe das offizielle backoff-Repository. Wir haben backoff nicht gemessen.
Was zeigt ein kurzer reproduzierbarer Retry-Testlauf?
Unser kurzer Testlauf vom 16. Oktober 2026 zeigte Wiederherstellung, servergesteuertes Warten und Erschöpfung. Es ist eine kleine Momentaufnahme, kein Benchmark.
Andrii nutzte Linux, Python 3.12, requests 2.31.0, urllib3 2.0.7 und tenacity 9.1.4. Quellen: requests_retry.py, tenacity_retry.py und retry_server.py, hier wiedergegeben. Die Stichprobe umfasste einen Aufruf pro Endpunkt mit urllib3 und einen Aufruf des instabilen Endpunkts mit Tenacity, wobei die lokalen Zähler zwischen den Skripten zurückgesetzt wurden. Der gesamte Traffic blieb auf 127.0.0.1.
| Richtlinie und Endpunkt | Finaler Status | Versuche | Dauer |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0,00 s |
| urllib3 /flaky | 200 | 3 | 1,20 s |
| urllib3 /limited | 200 | 2 | 2,00 s |
| urllib3 /down | 503 | 6 | 15,69 s |
| Tenacity /flaky | 200 | 3 | 3,82 s |
Tenacity protokollierte Wartezeiten von 1,36 und 2,45 Sekunden. Unterschiedliche Wartezeit-Einstellungen erklären den Zeitunterschied; diese Beobachtungen erlauben kein Ranking der Bibliotheken. Es gab keine wiederholten Durchläufe, keine gleichzeitigen Clients, keine Remote-Verbindungen und keine gemessenen Timeout-Fehler.
Starte retry_server.py in einem Terminal und dann jeden Client einzeln in einem anderen:
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
Die Bandbreite wurde nicht gemessen. Für die Planung schätzt du die übertragenen Bytes, indem du Anfrage-, Antwort- und Protokoll-Bytes über alle Versuche addierst; sechs gleich große Austausche würden grob das Sechsfache eines einzelnen Austauschs kosten, doch die tatsächlichen Fehler-Bodys unterscheiden sich.
Eine künftige Simulation mit festem Seed könnte eigenen Jitter mit Bibliotheks-Richtlinien bei identischen Versuchsbudgets vergleichen und dabei Latenz, Scheduling-Kollisionen und simulierte Erfolgswahrscheinlichkeit erfassen. Das wären simulierte Metriken, getrennt von dieser beobachteten Tabelle.
Häufig gestellte Fragen
Wiederholt Python Requests automatisch?
Standardmäßig nicht bei fehlgeschlagenen Verbindungen. Konfiguriere den Adapter bewusst und überprüfe das Verhalten dann anhand eines kontrollierten Fehlers.
Wie arbeiten Session, HTTPAdapter und urllib3 Retry zusammen?
Die Session wählt für die Anfrage-URL den dafür gemounteten Adapter aus. Der Adapter reicht die Retry-Richtlinie an die Transportaufrufe von urllib3 weiter.
Wie werden die Wartezeiten beim Exponential Backoff berechnet?
Unser Faktor von 0,5 ergab Basiswartezeiten von 0, 1, 2, 4 und 8 Sekunden. Jitter beeinflusste spätere Wartezeiten, daher müssen wiederholte Durchläufe nicht mit den gemessenen Zeiten übereinstimmen.
Wie sollte Python mit 429 und Retry-After umgehen?
Warte wie angefordert, wenn die Operation es sich leisten kann. Andernfalls brich die Operation ab oder verschiebe sie, statt früher zu wiederholen.
Ist es sicher, einen POST nach einem Timeout zu wiederholen?
Ein Timeout lässt das Ergebnis des Schreibvorgangs ungewiss. Verlange eine API-spezifische Garantie für Wiederholungen, bevor du die Anfrage erneut sendest.
Haben diese Skripte eine Gesamt-Deadline erzwungen?
Nein. Ihre Versuchs-Richtlinien und Timeouts pro Aufruf legen keine harte Obergrenze für die verstrichene Zeit fest.
Brauchst du zusätzlich zu deiner Retry-Richtlinie einen Proxy?
Wenn dein autorisierter Workload Proxy-Routing benötigt, wirf einen Blick auf die Proxy-Optionen für Python Requests und auf Residential Proxys von DataImpulse. DataImpulse liefert Proxys, keine Scraping-API, keinen verwalteten Unblocker, kein VPN und keine Datensätze. Behalte Entscheidungen zur Wiederholung, Pacing und Fehlerbehandlung in deinem Client.
Zuletzt aktualisiert: 16. Oktober 2026.