
ในบทความนี้
ใช้ python requests retry ด้วย Session, HTTPAdapter และนโยบาย Retry ของ urllib3 จากนั้นกำหนด timeout ให้ชัดเจนในทุกการเรียก และออกแบบให้ความปลอดภัยของการส่งซ้ำ จำนวนครั้งที่ลอง และจังหวะที่เซิร์ฟเวอร์กำหนดอยู่ด้วยกัน
เริ่มจากสคริปต์ที่ผ่านการทดสอบด้านล่าง การรันอย่างย่อเมื่อ 16 ตุลาคม 2026 แสดงให้เห็นผลลัพธ์จากความล้มเหลวที่ควบคุมได้ในเครื่อง รวมถึง 503 ที่เกิดซ้ำต่อเนื่องและยังคงล้มเหลวหลังลองซ้ำครบทุกครั้ง
ข้อมูลสำคัญ
- การติดตั้ง urllib3 Retry บน HTTPAdapter จะเพิ่มการลองซ้ำให้ทุกการเรียกใน requests.Session
- endpoint ที่ตอบ 503, 503, 200 สำเร็จในความพยายามครั้งที่ 3 หลังผ่านไป 1.2 s ในการทดสอบในเครื่องของเรา
- 429 ที่มี Retry-After: 2 รอพอดี 2.0 s ก่อนลองซ้ำ
- endpoint ที่ล้มเหลวถาวรหยุดหลังพยายาม 6 ครั้งและใช้เวลา 15.7 s แทนที่จะวนไม่สิ้นสุด
- POST จะไม่ถูกลองซ้ำโดยค่าเริ่มต้น ควรเพิ่มเฉพาะการเรียกที่เป็น idempotent
- Tenacity ให้รูปแบบเดียวกันกับฟังก์ชันใดก็ได้ พร้อมบันทึกเวลารอทุกครั้ง
ตั้งค่า Python Requests Retry ได้อย่างไร
ติดตั้ง adapter ที่กำหนดค่า retry สำหรับทั้ง HTTP และ HTTPS แล้วเรียกผ่าน Session นั้น นี่คือ requests_retry.py ที่เราทดสอบแล้ว ให้เริ่มเซิร์ฟเวอร์ในเครื่องที่แสดงไว้ภายหลังก่อนรัน
import logging, time
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

logging.basicConfig(level=logging.WARNING)
logging.getLogger("urllib3.connectionpool").setLevel(logging.DEBUG)  # shows each retry


def make_session(total=5, backoff=0.5):
    retry = Retry(
        total=total,                       # overall cap across all error types
        connect=3, read=2,                 # separate caps for connection and read failures
        status_forcelist=(429, 500, 502, 503, 504),
        allowed_methods=frozenset({"GET", "HEAD", "OPTIONS"}),  # never auto-retry POST
        backoff_factor=backoff,            # sleeps 0, 1, 2, 4 ... seconds (0.5 x 2^n, first retry immediate)
        backoff_jitter=0.3,                # random extra delay so many clients do not retry in sync
        respect_retry_after_header=True,   # wait what a 429/503 Retry-After says
        raise_on_status=False,             # return the last response instead of raising RetryError
    )
    s = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    s.mount("http://", adapter)
    s.mount("https://", adapter)
    return s


if __name__ == "__main__":
    s = make_session()
    base = "http://127.0.0.1:8377"
    s.get(f"{base}/reset")
    for path in ("/ok", "/flaky", "/limited", "/down"):
        t = time.time()
        r = s.get(base + path, timeout=(3.05, 10))   # (connect, read) timeouts
        print(f"{path:9} -> {r.status_code} after {time.time() - t:.2f}s, body {r.text}")
โดยค่าเริ่มต้น Requests จะไม่ลองเชื่อมต่อซ้ำเมื่อการเชื่อมต่อล้มเหลว Session จะเก็บการตั้งค่าและใช้ connection pool ร่วมกัน ส่วน HTTPAdapter ที่ติดตั้งไว้จะส่งต่อนโยบาย retry ให้ urllib3 ดู การใช้งานขั้นสูงของ Requests
สคริปต์วัดผลนี้จะพิมพ์ response สุดท้ายออกมา รวมถึงกรณีที่เป็นข้อผิดพลาด ในโค้ดแอปพลิเคชันจริง ให้เรียก raise_for_status() ก่อนนำผลลัพธ์ที่สำเร็จไปใช้ และจัดการความล้มเหลวสุดท้ายแบบ RequestException ที่ขอบเขตของผู้เรียก การเรียก reset เป็นเพียงการเตรียมระบบในเครื่องและไม่ได้กำหนด timeout อย่าคัดลอกการละเว้นนี้ไปใช้กับการเรียกระยะไกล ดู การจัดการข้อผิดพลาดของ Requests
Python Requests Retry ควรจัดการความล้มเหลวแบบใด
ควรลองซ้ำเฉพาะความล้มเหลวที่มีโอกาสหายไปเองได้ และเฉพาะเมื่อการทำซ้ำนั้นยอมรับได้ ใช้ การตรวจสอบความปลอดภัยของ retry 4 ขั้นตอน นี้ก่อนเลือกค่าตั้งต่าง ๆ
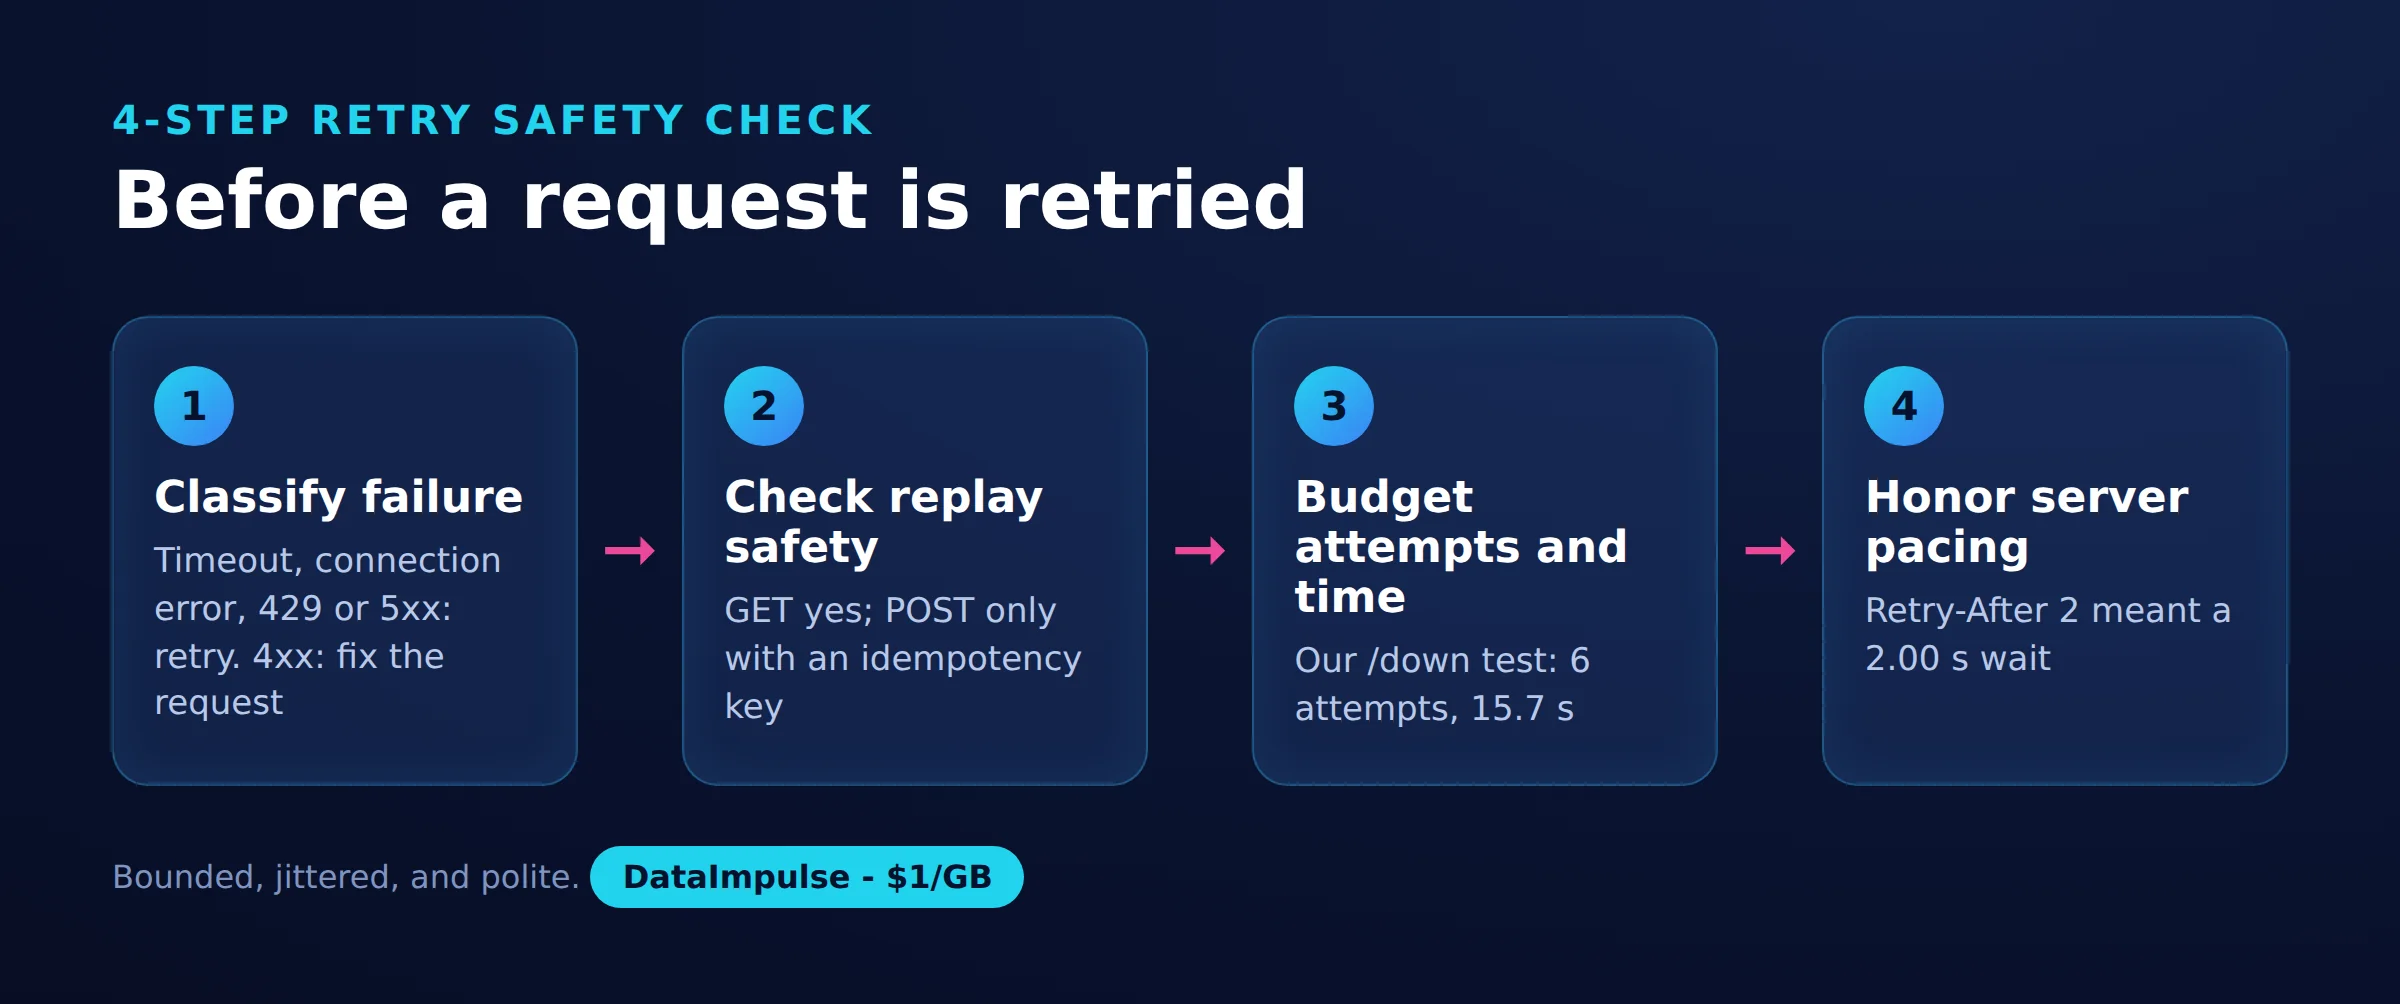
- ขั้นตอนที่ 1: จำแนกความล้มเหลว แยกความล้มเหลวของการเชื่อมต่อ ความล้มเหลวของการอ่าน และ HTTP response ออกจากกัน รายการสถานะที่เราเสนอคือ 429, 500, 502, 503 และ 504 ควรตรวจสอบเทียบกับข้อกำหนดของ endpoint นั้น
- ขั้นตอนที่ 2: ตรวจสอบความปลอดภัยในการส่งซ้ำ พิจารณาว่าคำขอซ้ำอาจทำให้การเขียนข้อมูลหรือผลข้างเคียงอื่นเกิดซ้ำหรือไม่
- ขั้นตอนที่ 3: กำหนดงบจำนวนครั้งและเวลา กำหนดจำนวนการเรียกสูงสุด เวลารอที่ยอมรับได้ และกำหนดเวลาของผู้เรียกก่อนเปิดใช้การลองซ้ำ
- ขั้นตอนที่ 4: เคารพจังหวะของเซิร์ฟเวอร์ ปฏิบัติตาม Retry-After และหยุดหรือเลื่อนงานเมื่อเวลารอที่กำหนดเกินงบของคุณ
อย่าใช้ retry เป็นวิธีแก้ปัญหาทุกอย่าง ควรตรวจสอบ response 403 และ ข้อผิดพลาด 407 การยืนยันตัวตนของ proxy แยกต่างหาก กลยุทธ์ python requests retry ควรรักษาเงื่อนไขการเข้าถึงและกฎเกี่ยวกับข้อมูลที่เกี่ยวข้องไว้
exponential backoff และ jitter ทำงานอย่างไร
exponential backoff จะเพิ่มระยะเวลารอหลังเกิดความล้มเหลวซ้ำ ส่วน jitter จะเพิ่มความสุ่มเข้าไป ในการตั้งค่าของเรา เวลารอพื้นฐานคือ 0, 1, 2, 4 และ 8 วินาที
สำหรับการลองซ้ำครั้งที่ k โดยเริ่มนับจาก 1 backoff ครั้งแรกของ urllib3 เป็นศูนย์ ส่วนครั้งต่อ ๆ ไปใช้ backoff_factor * 2**(k-1) จากนั้นบวก jitter แบบสุ่มสม่ำเสมอตั้งแต่ศูนย์ถึง backoff_jitter โดยมี backoff_max เป็นเพดาน ดูรายละเอียดตัวควบคุมเหล่านี้ได้ใน เอกสารอ้างอิง urllib3 2.0.7
สภาพแวดล้อมของเราใช้ urllib3 2.0.7 ซึ่งรองรับ backoff_jitter ควรตรวจสอบตัวอย่างให้ตรงกับเวอร์ชันที่ติดตั้งจริง แทนที่จะสันนิษฐานว่าเข้ากันได้ ปรับค่า factor เพื่อกำหนดอัตราการเพิ่มของเวลารอ และปรับช่วง jitter เพื่อกระจายการลองซ้ำ นโยบายการรอแบบกำหนดเองควรอยู่ในชั้น retry ที่เลือกไว้อย่างตั้งใจ
ผลลัพธ์ 1.20 วินาทีของ endpoint flaky ที่สังเกตได้มาจากการสุ่มเพียงครั้งเดียวและภาระการทำงานในเครื่อง จึงไม่สามารถใช้คาดการณ์ latency ของ API ของคุณได้
ควรจัดการ 429 และ Retry-After อย่างไร
ควรรอตามค่า Retry-After ที่ถูกต้องก่อนลองใหม่ เว้นแต่การดำเนินการนั้นจำเป็นต้องหยุด header นี้รับได้ทั้งจำนวนวินาทีที่ต้องรอหรือ HTTP-date ตามที่อธิบายใน เอกสารอ้างอิง Retry-After ของ MDN
เมื่อเปิดใช้การจัดการ header urllib3 จะใช้ค่าหน่วงจาก Retry-After ที่เป็นบวกก่อนค่า backoff ที่คำนวณเอง หากไม่มีค่าหน่วงที่ใช้ได้และเป็นบวก จะใช้ exponential backoff ส่วน header ที่รูปแบบผิดต้องมีการจัดการข้อผิดพลาดอย่างชัดเจน ดู พฤติกรรม sleep ของ urllib3
429 ในเครื่องของเราขอให้รอสองวินาที และความพยายามครั้งถัดไปสำเร็จหลังผ่านไป 2.00 วินาที สคริปต์นี้ไม่ได้บังคับกำหนดเวลารวม ดังนั้นหากเซิร์ฟเวอร์ขอให้รอนานกว่าที่การดำเนินการของคุณอนุญาต ให้หยุดหรือกำหนดเวลาใหม่ แทนที่จะลดเวลารอที่เซิร์ฟเวอร์ร้องขอ ควรวางแผนพฤติกรรมนี้ควบคู่ไปกับ นโยบาย API rate limiting ของคุณ
connection timeout และ read timeout ส่งผลต่อการลองซ้ำอย่างไร
timeout จำกัดเฉพาะขั้นตอนการรอขั้นใดขั้นหนึ่ง ไม่ใช่ทั้งการดำเนินการ การสร้างการเชื่อมต่อ การอ่าน response การลองซ้ำ และ backoff ล้วนรวมอยู่ในเวลาที่ผ่านไปทั้งหมด
ใน timeout=(3.05, 10) ค่าแรกควบคุมการรอการเชื่อมต่อ และค่าที่สองควบคุมช่วงที่ไม่มีข้อมูลเข้ามาระหว่างการอ่าน ทั้งสองค่าไม่ใช่กำหนดเวลาตามนาฬิกาจริง และ Requests ก็ไม่มี timeout เริ่มต้นด้วย ดู ความหมายของ timeout ใน Requests
งบการลองซ้ำห้าครั้งของเราอนุญาตให้พยายามได้หกครั้ง ตัวนับ connection และ read จำกัดความล้มเหลวในหมวดของตนภายใต้งบรวมนั้น ไม่ได้เพิ่มโควตาเข้าไปอีก ตัวควบคุมงบของ Retry มี total=0 เพื่อป้องกันการลองซ้ำ (ณ ตุลาคม 2026)
อย่าสันนิษฐานว่าความล้มเหลวในการอ่าน body ทุกกรณีจะถูกส่งซ้ำ ซอร์สโค้ดของ adapter ใน Requests ส่ง preload_content=False ดังนั้นความล้มเหลวระหว่างการอ่าน body ในภายหลังอาจเกิดนอกรอบการลองซ้ำของ adapter ควรทดสอบกรณี body ที่ขาดช่วงแยกต่างหาก และบังคับใช้กำหนดเวลาที่เข้มงวดที่ขอบเขตของแอปพลิเคชันที่สามารถหยุดการดำเนินการได้
ลองส่งคำขอ POST ซ้ำได้อย่างปลอดภัยหรือไม่
timeout ของ POST เพียงอย่างเดียวไม่อาจยืนยันได้ว่าการส่งซ้ำปลอดภัย เซิร์ฟเวอร์อาจเขียนข้อมูลเสร็จแล้วก่อนที่ไคลเอนต์จะไม่ได้รับ response
ควรส่งซ้ำเฉพาะเมื่อ API ระบุไว้ว่ามีพฤติกรรมแบบ idempotent หรือมีกลไกป้องกันการซ้ำที่ครอบคลุมการดำเนินการนั้น ให้ใช้ตัวระบุการดำเนินการและ payload เดิมภายใต้ข้อกำหนดนั้น การเพิ่ม idempotency header แบบตามใจไม่ได้สร้างการรับประกันขึ้นมา แนวทางนี้สอดคล้องกับข้อพิจารณาเรื่องการส่งซ้ำใน ข้อกำหนด idempotency ของ HTTP
ชุด method เริ่มต้นของ urllib3 ไม่รวม POST ชุดที่แคบกว่าของเราอนุญาต GET, HEAD และ OPTIONS สำหรับการลองซ้ำเมื่อเกิดปัญหาด้านสถานะและการอ่าน การกรอง method ไม่ได้ห้ามการลองเชื่อมต่อซ้ำก่อนมีการส่งข้อมูลไปแต่อย่างใด ดู method และประเภทความล้มเหลวของ Retry ตัวอย่างนี้เน้นเฉพาะการอ่านข้อมูล
บันทึกความพยายามและวินิจฉัย retry ที่หมดงบได้อย่างไร
ควรบันทึกประเภทของความล้มเหลว ลำดับความพยายาม เวลารอที่เลือก เวลาที่ผ่านไป และผลลัพธ์สุดท้าย ใช้ป้ายชื่อเส้นทางที่ผ่านการล้างข้อมูลแล้วแทน URL แบบเต็ม
สคริปต์เปิดการบันทึกเพื่อวินิจฉัยสำหรับคำขอ localhost ที่ไม่เป็นอันตราย ก่อนนำไปปรับใช้ ให้ลบส่วนประกอบของ URL ที่ละเอียดอ่อนออกจาก log และ exception ตัวอย่าง Tenacity ใส่ URL ไว้ในข้อความ exception ห้ามบันทึกข้อมูลรับรอง authorization header หรือเนื้อหา response ที่เป็นส่วนตัวโดยเด็ดขาด
503 ที่เกิดซ้ำต่อเนื่องของเรายังคงเป็น response เพราะ raise_on_status=False ส่วนความล้มเหลวด้านการขนส่งข้อมูลยังคงเกิด exception ได้ โดย Requests จะแปลความล้มเหลวพื้นฐานเป็นประเภทต่าง ๆ เช่น ConnectionError, ConnectTimeout และ RetryError นอกจากนี้ max_retries ที่เป็นจำนวนเต็มก็ไม่สามารถกำหนดนโยบายสถานะอย่างชัดเจนแบบที่แสดงไว้ที่นี่ได้ ดู การimplement ของ adapter
ตรวจสอบว่าการเรียกใช้ Session ที่กำหนดค่าไว้และ mount ที่ตรงกัน ปิด Session เมื่อใช้งานเสร็จ และตรวจสอบความล้มเหลวเฉพาะเครือข่ายด้วย คู่มือแก้ไขปัญหา proxy หลีกเลี่ยงการเพิ่มลูป retry ชั้นที่สองครอบไคลเอนต์ที่ลองซ้ำอยู่แล้ว
ควรใช้ urllib3 Retry, Tenacity หรือ backoff เมื่อใด
ควรเลือกชั้นเดียวให้รับผิดชอบการลองซ้ำ ใช้การตั้งค่าที่ชั้นการขนส่งสำหรับนโยบาย HTTP และใช้ตัวห่อฟังก์ชันเมื่อผลลัพธ์ของแอปพลิเคชันเป็นตัวกำหนดว่าจะทำงานซ้ำหรือไม่
| ตัวเลือก | ใช้ X เมื่อ… | หลีกเลี่ยง X เมื่อ… |
|---|---|---|
| urllib3 Retry | ใช้ urllib3 Retry เมื่อนโยบายด้านการขนส่งและสถานะเหมาะสม | หลีกเลี่ยง urllib3 Retry เมื่อต้องลองซ้ำทั้งเวิร์กโฟลว์ของแอปพลิเคชัน |
| Tenacity | ใช้ Tenacity เมื่อผลลัพธ์ exception หรือ coroutine แบบกำหนดเองเป็นตัวขับเคลื่อนการลองซ้ำ | หลีกเลี่ยง Tenacity เมื่อห่อไคลเอนต์ที่ลองซ้ำอยู่แล้วโดยไม่ประสานงบเข้าด้วยกัน |
| backoff | ใช้ backoff เมื่อนโยบายแบบ decorator เหมาะสม | หลีกเลี่ยง backoff เมื่อคาดหวังการจำแนกสถานะ HTTP อัตโนมัติโดยไม่ตั้งค่า |
Retry รวมศูนย์การกรอง HTTP ไว้ที่เดียว ส่วน Tenacity แยกนโยบาย retry, wait และ stop ออกจากกัน รองรับการลองซ้ำของ coroutine และมี callback สำหรับการบันทึก log stop_after_attempt ของ Tenacity นับจำนวนการเรียก รวมครั้งแรกด้วย (ณ ตุลาคม 2026) ดู เอกสาร Tenacity และ เอกสารอ้างอิงนโยบาย wait
tenacity_retry.py ที่เราทดสอบแล้วจะเรียก GET แบบ flaky เดิมซ้ำด้วยจังหวะเวลาที่ต่างออกไป แต่ไม่เทียบเท่ากันในกรณี 429 เพราะไม่ได้ตรวจสอบ Retry-After
import time
import requests
from tenacity import (retry, retry_if_exception_type, stop_after_attempt,
                      wait_exponential_jitter, before_sleep_log)
import logging
logging.basicConfig(level=logging.INFO, format="%(message)s")
log = logging.getLogger("retry")


class RetryableStatus(Exception):
    pass


@retry(
    retry=retry_if_exception_type((requests.ConnectionError, requests.Timeout, RetryableStatus)),
    wait=wait_exponential_jitter(initial=1, max=30, jitter=1),
    stop=stop_after_attempt(5),
    before_sleep=before_sleep_log(log, logging.INFO),
    reraise=True,
)
def get_json(url):
    r = requests.get(url, timeout=(3.05, 10))
    if r.status_code in (429, 500, 502, 503, 504):
        raise RetryableStatus(f"{r.status_code} from {url}")
    r.raise_for_status()
    return r.json()


if __name__ == "__main__":
    requests.get("http://127.0.0.1:8377/reset")
    t = time.time()
    print(get_json("http://127.0.0.1:8377/flaky"), f"{time.time() - t:.2f}s")
ในตัวอย่างนี้ สถานะที่เลือกไว้จะถูกแปลงเป็น exception เวลารอใช้ exponential jitter และเมื่อหมดงบจะ raise exception สุดท้ายซ้ำ หมวด exception การเชื่อมต่อที่กว้างนี้ต้องได้รับการตรวจสอบตามแต่ละ endpoint
เพื่อเปรียบเทียบ backoff ใช้ on_exception หรือ on_predicate ร่วมกับ wait generator โดย jitter เริ่มต้นตามเอกสารคือ full jitter การกรองสถานะต้องใช้ predicate หรือนโยบาย exception ที่คุณกำหนดเอง ส่วน max_tries จำกัดจำนวนการเรียกทั้งหมด (ณ ตุลาคม 2026) ดู ที่เก็บ backoff อย่างเป็นทางการ เรายังไม่ได้วัดผลของ backoff
การรัน retry แบบย่อที่ทำซ้ำได้แสดงอะไรบ้าง
การรันอย่างย่อของเราเมื่อ 16 ตุลาคม 2026 แสดงให้เห็นการฟื้นตัว การรอตามที่เซิร์ฟเวอร์กำหนด และการหมดงบ ทั้งหมดเป็นภาพรวมขนาดเล็ก ไม่ใช่ benchmark
Andrii ใช้ Linux, Python 3.12, requests 2.31.0, urllib3 2.0.7 และ tenacity 9.1.4 ซอร์สโค้ดคือ requests_retry.py, tenacity_retry.py และ retry_server.py ซึ่งนำมาแสดงไว้ที่นี่ ตัวอย่างคือการเรียกหนึ่งครั้งต่อ endpoint ด้วย urllib3 และการเรียก endpoint flaky หนึ่งครั้งด้วย Tenacity โดยรีเซ็ตตัวนับในเครื่องระหว่างสคริปต์ ทราฟฟิกทั้งหมดอยู่ที่ 127.0.0.1
| นโยบายและ endpoint | สถานะสุดท้าย | จำนวนครั้งที่พยายาม | เวลาที่ใช้ |
|---|---|---|---|
| urllib3 /ok | 200 | 1 | 0.00 s |
| urllib3 /flaky | 200 | 3 | 1.20 s |
| urllib3 /limited | 200 | 2 | 2.00 s |
| urllib3 /down | 503 | 6 | 15.69 s |
| Tenacity /flaky | 200 | 3 | 3.82 s |
Tenacity บันทึกเวลารอ 1.36 และ 2.45 วินาที การตั้งค่าเวลารอที่ต่างกันอธิบายความต่างของเวลาได้ ผลสังเกตเหล่านี้จึงไม่สามารถใช้จัดอันดับไลบรารีได้ ไม่มีการทดลองซ้ำ ไคลเอนต์พร้อมกัน การเชื่อมต่อระยะไกล หรือความล้มเหลวจาก timeout ที่วัดผลได้
รัน retry_server.py ในเทอร์มินัลหนึ่ง จากนั้นรันไคลเอนต์แต่ละตัวแยกกันในอีกเทอร์มินัล:
# Local test server: /flaky fails with 503 twice then 200; /limited answers 429 + Retry-After: 2 once then 200.
import http.server, json, threading
hits = {}
class H(http.server.BaseHTTPRequestHandler):
    def do_GET(self):
        n = hits[self.path] = hits.get(self.path, 0) + 1
        if self.path == "/reset":
            hits.clear(); return self.send(200, {"reset": True})
        if self.path == "/flaky" and n <= 2: return self.send(503, {"attempt": n})
        if self.path == "/limited" and n == 1: return self.send(429, {"attempt": n}, {"Retry-After": "2"})
        if self.path == "/down": return self.send(503, {"attempt": n})
        self.send(200, {"ok": True, "attempt": n})
    def send(self, code, body, extra=None):
        self.send_response(code)
        for k, v in (extra or {}).items(): self.send_header(k, v)
        self.send_header("Content-Type", "application/json"); self.end_headers()
        self.wfile.write(json.dumps(body).encode())
    def log_message(self, *a): pass
http.server.ThreadingHTTPServer(("127.0.0.1", 8377), H).serve_forever()
เรายังไม่ได้วัดแบนด์วิดท์ สำหรับการวางแผน ให้ประมาณจำนวนไบต์ที่ส่งโดยรวมไบต์ของคำขอ response และโปรโตคอลในทุกความพยายาม การแลกเปลี่ยนขนาดเท่ากันหกครั้งจะมีต้นทุนประมาณหกเท่าของหนึ่งครั้ง แต่ข้อมูลใน error body จริงจะแตกต่างกัน
ในอนาคตอาจใช้การจำลองแบบมี seed เพื่อเปรียบเทียบ jitter แบบกำหนดเองกับนโยบายของไลบรารีภายใต้งบจำนวนครั้งเดียวกัน โดยบันทึก latency การชนกันของตารางเวลา และความน่าจะเป็นที่จะสำเร็จจากการจำลอง ตัวชี้วัดเหล่านั้นจะเป็นค่าจำลอง แยกจากตารางที่สังเกตได้นี้
คำถามที่พบบ่อย
Python Requests ลองซ้ำโดยอัตโนมัติหรือไม่
ไม่ลองโดยค่าเริ่มต้นเมื่อการเชื่อมต่อล้มเหลว ควรกำหนดค่า adapter อย่างตั้งใจ แล้วตรวจสอบพฤติกรรมกับความล้มเหลวที่ควบคุมได้
Session, HTTPAdapter และ urllib3 Retry ทำงานร่วมกันอย่างไร
Session จะเลือก adapter ที่ติดตั้งไว้สำหรับ URL ของคำขอ จากนั้น adapter จะส่งต่อนโยบาย retry ไปยังการเรียกด้านการขนส่งของ urllib3
คำนวณเวลาหน่วงของ exponential backoff อย่างไร
ค่า factor 0.5 ของเราให้เวลารอพื้นฐาน 0, 1, 2, 4 และ 8 วินาที jitter ส่งผลต่อเวลารอในครั้งหลัง ๆ ดังนั้นการรันซ้ำจึงไม่จำเป็นต้องได้เวลาที่ผ่านไปตรงกับที่วัดไว้
Python ควรจัดการ 429 และ Retry-After อย่างไร
ให้รอตามที่ร้องขอเมื่อการดำเนินการรองรับได้ หากไม่ได้ ให้หยุดหรือเลื่อนการดำเนินการ แทนที่จะลองซ้ำเร็วกว่านั้น
การลองส่ง POST ซ้ำหลัง timeout ปลอดภัยหรือไม่
timeout ทำให้ไม่แน่ชัดว่าการเขียนข้อมูลสำเร็จหรือไม่ ควรมีการรับประกันการส่งซ้ำเฉพาะของ API ก่อนส่งอีกครั้ง
สคริปต์เหล่านี้บังคับใช้กำหนดเวลารวมหรือไม่
ไม่ นโยบายจำนวนครั้งและ timeout ต่อการเรียกไม่ได้กำหนดขีดจำกัดเวลาที่ผ่านไปแบบเด็ดขาด
ต้องใช้ proxy ควบคู่กับนโยบาย retry หรือไม่
หากงานที่ได้รับอนุญาตของคุณต้องใช้การกำหนดเส้นทางผ่าน proxy ลองดู ตัวเลือก proxy สำหรับ Python Requests และ DataImpulse residential proxies DataImpulse ให้บริการ proxy ไม่ใช่ scraping API, managed unblocker, VPN หรือชุดข้อมูล ส่วนการตัดสินใจเรื่องการส่งซ้ำ จังหวะการเรียก และการจัดการความล้มเหลวควรอยู่ในไคลเอนต์ของคุณ
อัปเดตล่าสุด: 16 ตุลาคม 2026