
In this Article
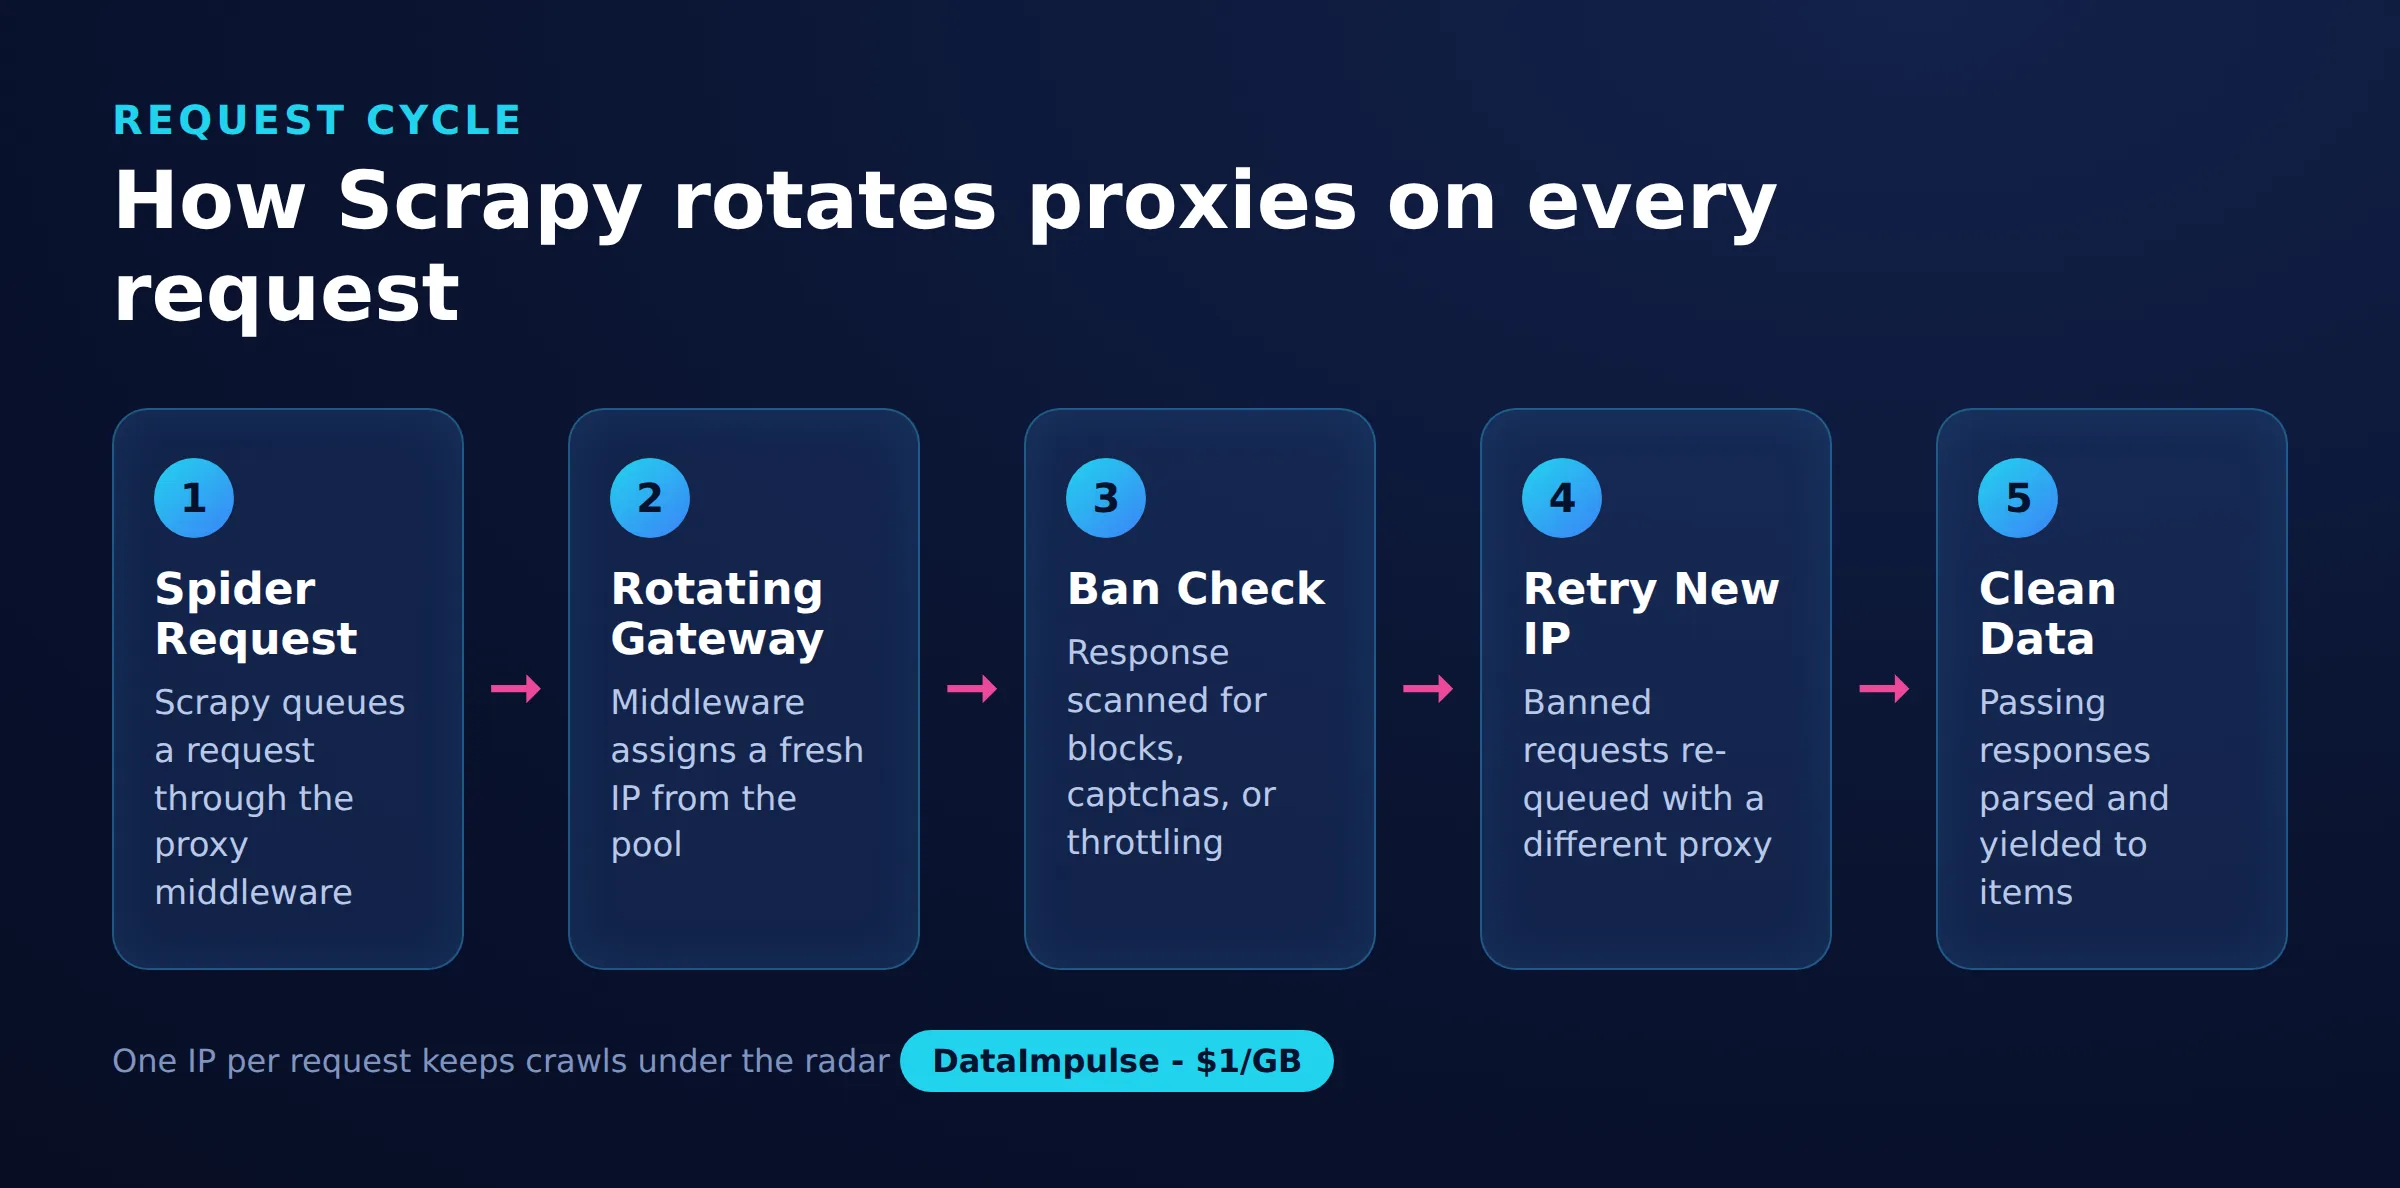
Scrapy 로테이팅 프록시는 Scrapy 스파이더가 순차 요청을 서로 다른 주소에서 보내도록 순환하는 IP 엔드포인트입니다. 이로써 속도 제한과 IP 차단 가능성을 낮춥니다. 이 튜토리얼에서는 scrapy-rotating-proxies 미들웨어와 DataImpulse 로테이팅 레지덴셜 게이트웨이를 사용해 실제 프로젝트에 Scrapy 로테이팅 프록시를 추가한 다음, 설정을 검증하고 문제를 해결하는 방법을 안내합니다.
미들웨어를 설치하고, settings.py를 구성하며, 차단 감지와 재시도를 연결하고, 종료 IP가 실제로 바뀌는지 확인한 뒤, 로테이팅 게이트웨이와 고정 프록시 목록 중에서 선택하게 됩니다. 아래의 모든 코드 블록은 실행할 수 있으며, 현실적인 한계는 끝부분에서 다룹니다.
DataImpulse는 195개국에서 9천만 개 이상의 레지덴셜, 모바일 및 데이터센터 IP 주소를 제공하는 윤리적 프록시 제공업체입니다. GB당 1달러부터 시작하는 종량제 모델과 만료되지 않는 트래픽을 사용하며, 웹 스크래핑, 광고 검증, 가격 모니터링, 시장 조사 및 다중 계정 관리에 활용됩니다.
핵심 정보
- 설정: Scrapy 로테이팅 프록시는 scrapy-rotating-proxies 미들웨어가 프록시 엔드포인트 목록 또는 gw.dataimpulse.com:823 같은 단일 로테이팅 게이트웨이를 사용하도록 지정하는 방식으로 작동하므로, 각 요청이 서로 다른 IP에서 나갈 수 있습니다.
- 가장 적합한 프록시 유형: 실제 소비자 IP를 사용해 탐지를 자연스럽게 통과하는 로테이팅 레지덴셜 프록시입니다.
- 가격: GB당 1달러부터, 종량제이며 트래픽은 만료되지 않고 구독도 필요하지 않습니다.
- 범위: 195개국에서 윤리적으로 확보한 9천만 개 이상의 IP입니다.
- 신뢰성: 성공률 99.51%, G2에서 5점 만점에 4.8점입니다.
- 프로토콜 및 타기팅: 국가 타기팅이 포함된 HTTP, HTTPS 및 SOCKS5입니다.
Scrapy 로테이팅 프록시를 시작하기 전에 무엇이 필요합니까?
작동하는 Scrapy 프로젝트, Python 3.8 이상, scrapy-rotating-proxies 패키지 및 프록시 엔드포인트 풀에 대한 액세스가 필요합니다. 로테이션 로직은 다운로더 미들웨어에 있으므로 스파이더는 변경할 필요가 없습니다.
코드를 작성하기 전에 다음을 준비합니다.
scrapy startproject로 만든 Scrapy 프로젝트.- 스크래핑 작업 흐름에서 문서화되고 GitHub에서 scrapy-rotating-proxies로 호스팅되는 커뮤니티 패키지인 scrapy-rotating-proxies 미들웨어.
- 프록시 자격 증명. 이 가이드에서는 단일 로테이팅 게이트웨이와 HTTP, HTTPS, SOCKS5 지원 및 국가 타기팅을 제공하는 DataImpulse 레지덴셜 프록시(residential proxies)를 사용합니다.
프로젝트 환경에 미들웨어를 설치합니다.
pip install scrapy-rotating-proxies패키지는 각 요청에 프록시를 할당하는 RotatingProxyMiddleware와 응답이 차단처럼 보이는지 판단해 실패한 IP에서 다른 IP로 로테이팅하는 BanDetectionMiddleware라는 두 미들웨어를 추가합니다.
Scrapy에서 로테이팅 프록시를 어떻게 사용합니까?
settings.py에서 프록시 엔드포인트를 선언하고 두 다운로더 미들웨어를 활성화하여 scrapy-rotating-proxies를 추가합니다. 프록시를 제공하는 방법은 인라인 Python 목록과 경로에서 로드하는 텍스트 파일, 두 가지입니다.
인라인 방식은 ROTATING_PROXY_LIST를 사용합니다. 올바른 순서로 실행되도록 아래 우선순위대로 두 미들웨어를 활성화합니다.
# settings.py
ROTATING_PROXY_LIST = [
    'http://user:[email protected]:823',
]

DOWNLOADER_MIDDLEWARES = {
    'rotating_proxies.middlewares.RotatingProxyMiddleware': 610,
    'rotating_proxies.middlewares.BanDetectionMiddleware': 620,
}
자격 증명을 소스 제어에 넣지 않으려면 ROTATING_PROXY_LIST_PATH를 사용하고 줄마다 프록시 하나가 있는 파일을 가리키도록 합니다.
# settings.py
ROTATING_PROXY_LIST_PATH = 'proxies.txt'
# proxies.txt (one endpoint per line)
http://user:[email protected]:823
http://user:[email protected]:824DataImpulse 게이트웨이는 긴 목록을 관리하는 대신 쓸 수 있는 단일 엔드포인트입니다. gw.dataimpulse.com:823은 이미 제공업체 측에서 종료 IP를 로테이팅하므로, 한 줄만 목록에 넣고 두 로테이션 계층을 함께 사용할 수 있습니다. 게이트웨이는 요청마다 새로운 레지덴셜 IP를 선택하고, 응답에 차단 플래그가 지정되면 미들웨어는 같은 게이트웨이로 재시도합니다. 대부분의 크롤링에 가장 간단하면서 신뢰할 수 있는 패턴입니다.
전역 설정 대신 요청마다 프록시를 설정하려면 스파이더에서 요청 메타를 통해 할당합니다. 이는 프록시 인증을 명시적으로 연결하는 방법이기도 하며, DataImpulse의 프록시 인증 가이드에서 다룹니다.
import scrapy

class GatewaySpider(scrapy.Spider):
    name = 'gateway'
    urls = ['https://httpbin.org/ip']

    def start_requests(self):
        proxy = 'http://user:[email protected]:823'
        for url in self.urls:
            yield scrapy.Request(url, meta={'proxy': proxy}, dont_filter=True)
Scrapy에서 로테이팅 프록시가 작동하는지 어떻게 검증합니까?
IP 에코 엔드포인트로 여러 요청을 보내고 보고된 원본 IP가 응답 간에 바뀌는지 확인하여 로테이션을 검증합니다. httpbin.org/ip는 호출자의 종료 IP를 반환하므로 빠르게 확인할 수 있습니다.
에코 엔드포인트를 열 번 호출하고 각 종료 IP를 로그에 기록하는 작은 스파이더를 추가합니다.
import scrapy

class IPCheckSpider(scrapy.Spider):
    name = 'ipcheck'
    start_urls = ['https://httpbin.org/ip'] * 10

    def parse(self, response):
        self.logger.info('Exit IP: %s', response.json()['origin'])
프로젝트 루트에서 실행합니다.
scrapy crawl ipcheck로그에 서로 다른 여러 종료 IP 값이 표시되어야 합니다. 모든 줄에 같은 주소가 표시되면 로테이션이 활성화되지 않은 것입니다. 미들웨어가 활성화되어 있는지, ROTATING_PROXY_LIST가 비어 있지 않은지, 요청이 HTTP 캐시에서 제공되지 않는지 확인합니다. 미들웨어는 프록시 상태도 기록하므로, 풀이 관리되고 있는지 확인하려면 정상 작동하는 프록시, 사용 불가 프록시 및 재활성화된 프록시에 관한 줄을 확인합니다.
Scrapy 로테이팅 프록시에서 차단 및 407 오류를 어떻게 해결합니까?
대부분의 로테이션 문제는 두 질문으로 좁혀집니다. 미들웨어가 차단을 올바르게 감지하는지, 프록시 인증이 설정되었는지입니다. 약한 차단 감지는 차단된 IP가 계속 무의미한 응답을 제공하게 하고, 잘못 구성된 로그인은 HTTP 407을 반환합니다.
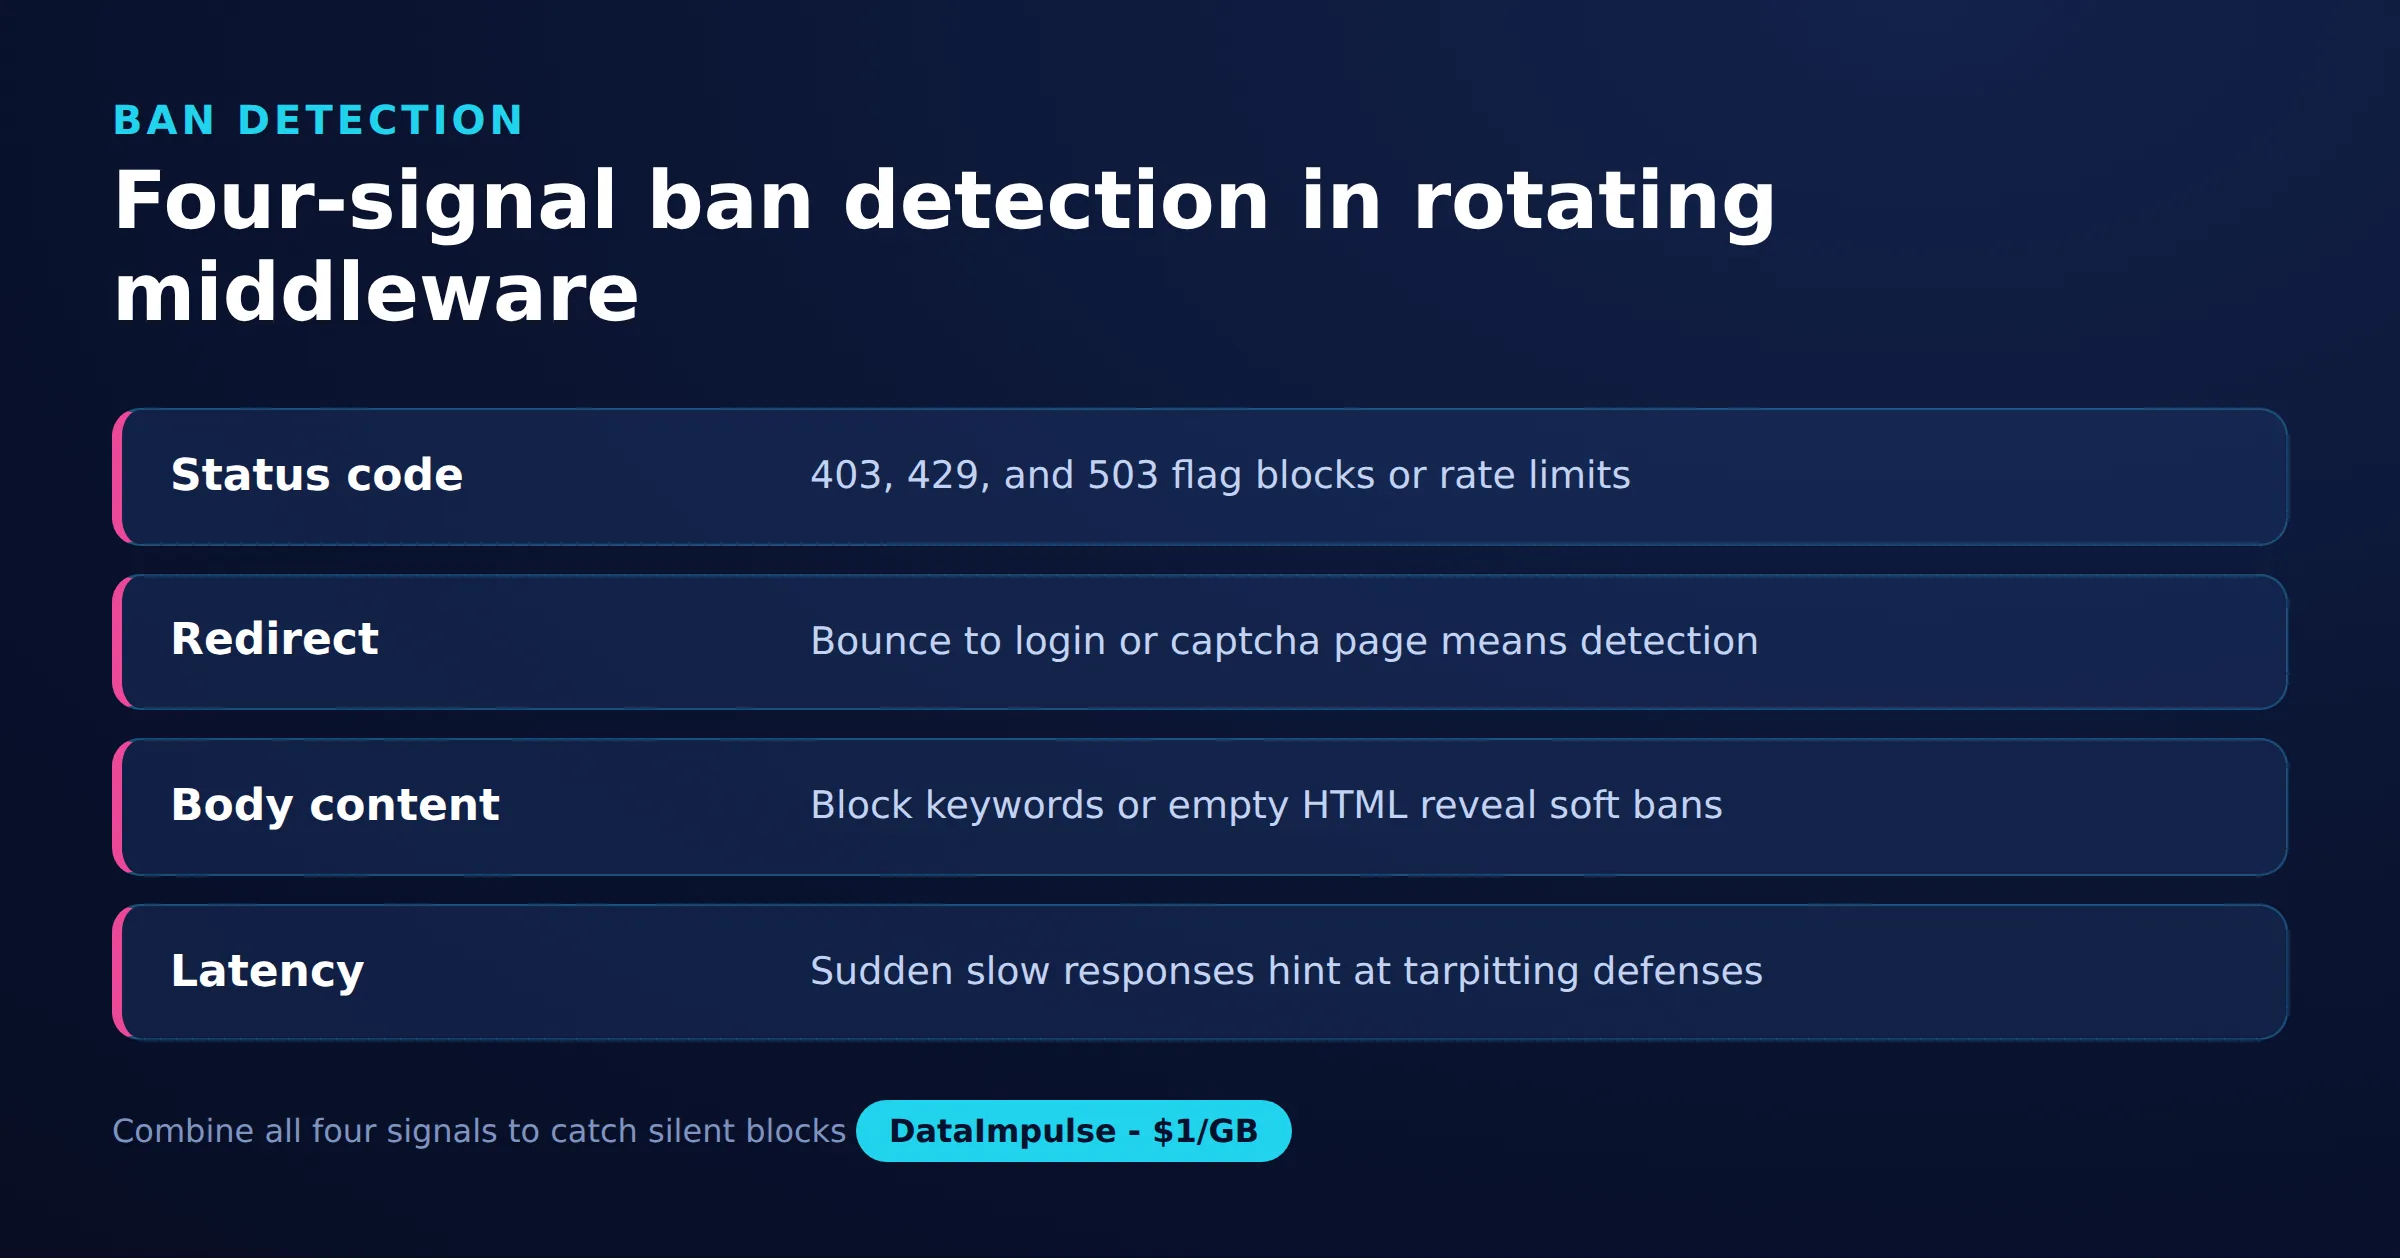
추측이 아닌 의도적인 차단 감지를 위해, 이 가이드에서는 Scrapy용 네 가지 신호 차단 감지 모델을 제안합니다. 독립적인 네 가지 신호로 각 응답을 평가하므로 단일 오탐으로 정상 작동하는 프록시가 제외되지 않습니다.
- 상태 코드: 403, 429, 503은 차단 후보로, 200, 301, 302는 정상으로 처리합니다.
- 리디렉션 대상: 상태가 정상으로 보여도 로그인, 캡차 또는 챌린지 경로로의 302는 약한 차단입니다.
- 본문 핑거프린트: 캡차, 접근 거부 또는 실제 페이지에서는 절대 반환되지 않을 빈 페이로드 같은 표식을 본문에서 검색합니다.
- 지연 시간: 이동 평균보다 훨씬 느린 응답은 완전한 차단 전에 스로틀링을 알리는 경우가 많습니다.
이 정책을 클래스에 인코딩하고 등록하여 BanDetectionMiddleware가 기본값 대신 사용자 로직을 사용하게 합니다.
# ban_policy.py
class DataImpulseBanPolicy:
    NOT_BAN_STATUSES = {200, 301, 302}

    def response_is_ban(self, request, response):
        if response.status in (403, 429, 503):
            return True
        if b'captcha' in response.body.lower():
            return True
        if not response.body:
            return True
        return False

    def exception_is_ban(self, request, exception):
        return True
# settings.py
ROTATING_PROXY_BAN_POLICY = 'myproject.ban_policy.DataImpulseBanPolicy'감지를 재시도 및 백오프와 결합하면 플래그가 지정된 요청이 실패하는 대신 새로운 IP로 이동합니다. Scrapy는 재시도 코드를 처리하고, 미들웨어는 페이지별 프록시 재시도를 처리합니다.
# settings.py
RETRY_ENABLED = True
RETRY_TIMES = 5
RETRY_HTTP_CODES = [403, 407, 429, 500, 502, 503, 504]
ROTATING_PROXY_PAGE_RETRY_TIMES = 5
풀을 소진하지 않도록 스로틀링을 추가합니다. DOWNLOAD_DELAY는 요청 간격을 두고, AUTOTHROTTLE은 서버 지연 시간에 맞춰 지연을 조정합니다.
# settings.py
DOWNLOAD_DELAY = 1.0
CONCURRENT_REQUESTS = 16
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 1.0
AUTOTHROTTLE_MAX_DELAY = 10.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 4.0
요청이 HTTP 407을 반환하면 대상 사이트가 차단한 것이 아니라 프록시가 자격 증명을 거부한 것입니다. 사용자 이름과 비밀번호가 발급된 그대로 프록시 URL에 포함되어 있는지, 특수 문자가 있으면 URL 인코딩되었는지 확인합니다. 전체 진단은 DataImpulse의 HTTP 407 오류 가이드에 있습니다. JavaScript 실행 후에만 콘텐츠를 표시하는 사이트에는 헤드리스 계층도 필요하며, 동적 웹 페이지 스크래핑 방법에서 다룹니다.
어떤 로테이팅 프록시 설정이 Scrapy 프로젝트에 적합합니까?
대부분의 크롤링에는 로테이팅 게이트웨이를 사용하고, 개별 IP를 제어해야 할 때는 고정 프록시 목록을 사용하며, 로테이션 규칙이 특이할 때만 사용자 지정 미들웨어를 사용합니다. 필요한 제어 수준과 유지 관리하려는 구성 작업량 사이에서 결정하면 됩니다.
아래 결정 매트릭스로 구체화합니다.
- 다음 경우 로테이팅 게이트웨이를 사용합니다. 하나의 엔드포인트로 요청별 IP 다양성을 원할 때, 대상이 IP별 속도 제한을 적용할 때, 프록시 파일을 전혀 관리하고 싶지 않을 때입니다.
- 다음 경우 고정 프록시 목록을 사용합니다. 재현 가능한 세션이 필요할 때, 스파이더별로 특정 지역을 고정하고 싶을 때, 정확히 어떤 엔드포인트가 사용되었는지 감사해야 할 때입니다.
- 다음 경우 사용자 지정 미들웨어를 피합니다. scrapy-rotating-proxies가 이미 요구 사항을 충족할 때입니다. 맞춤형 미들웨어는 유지 관리와 자체 차단 감지 버그를 추가합니다.
- 다음 경우 로테이팅 게이트웨이를 피합니다. 다단계 로그인 동안 같은 IP를 유지해야 하는 작업 흐름에서는 스티키 세션이 올바른 도구입니다.
세 가지 접근 방식의 비교는 다음과 같습니다.
| 접근 방식 | 로테이션 제어 | 설정 노력 | 적합한 용도 |
|---|---|---|---|
| 로테이팅 게이트웨이(단일 엔드포인트) | 제공업체가 요청마다 로테이팅 | 가장 낮음, 설정에 한 줄 | 대규모 크롤링, IP 기반 속도 제한 |
| 프록시 목록 파일 | 미들웨어가 엔드포인트를 순환 | 중간, 프록시 파일 유지 관리 | 지역 고정, 감사 가능한 풀 |
| 사용자 지정 미들웨어 | 완전함, 로직을 직접 작성 | 가장 높음, 코드와 테스트 | 비표준 로테이션 규칙 |
DataImpulse는 게이트웨이에서 로테이션을 제공하고 연속성이 필요할 때 스티키 세션도 지원하므로, 많은 팀은 게이트웨이로 시작하고 지역을 고정해야 하는 소수의 스파이더에만 목록 파일을 사용합니다. 레지덴셜 신뢰도보다 비용과 속도가 더 중요하다면, 같은 계정의 데이터센터 프록시(datacenter proxies)와 모바일 프록시(mobile proxies)가 대안입니다.
Scrapy에서 로테이팅 프록시의 한계와 위험은 무엇입니까?
로테이팅 프록시는 IP 기반 차단을 줄이지만 스크레이퍼를 보이지 않게 만들지는 않으며, 제대로 동작하지 않는 스파이더를 고칠 수도 없습니다. 로테이션은 보장 사항이 아니라 하나의 계층입니다.
다음 한계를 염두에 둡니다.
- 로테이션은 핑거프린팅을 무력화하지 않습니다. 사이트는 헤더, TLS 서명 및 동작도 프로파일링하므로, 기본 Scrapy 사용자 에이전트가 있는 새 IP도 플래그가 지정될 수 있습니다.
- 캡차는 계속 나타납니다. 로테이팅 IP는 발생 빈도를 낮추지만 해결하지는 못합니다. 여전히 캡차 전략이나 더 느린 크롤링이 필요합니다.
- 지역 불일치는 잡음을 유발합니다. 한 국가를 타기팅하면서 다른 지역을 예상하는 현지화 페이지를 요청하면, 로테이션이 작동해도 응답이 잘못된 것처럼 보일 수 있습니다.
- 공격적인 동시성은 역효과를 냅니다. 병렬 요청이 너무 많으면 풀이 소진되고 차단률이 높아지므로 AUTOTHROTTLE이 중요합니다.
- 법률 및 약관의 제한이 적용됩니다. 로테이션은 신뢰성 도구이지 허가가 아닙니다. robots 지시문, 속도 제한 및 적용 가능한 법률을 준수합니다.
범위와 관련해 DataImpulse가 무엇인지 분명히 할 필요가 있습니다. 195개국에서 9천만 개 이상의 IP, GB당 1달러부터 시작하는 종량제, 99.51% 성공률을 제공하는 윤리적 옵트인 프록시 네트워크입니다. 파싱된 데이터를 반환하는 관리형 스크래핑 API가 아니며, 고정 ISP 프록시를 판매하지 않고, 무료 웹 프록시도 아닙니다. 크롤링은 여전히 Scrapy가 수행하며 프록시는 요청이 나가는 위치만 바꿉니다.
자주 묻는 질문
Scrapy에서 로테이팅 프록시를 어떻게 사용합니까?
scrapy-rotating-proxies를 설치하고 settings.py의 ROTATING_PROXY_LIST 또는 ROTATING_PROXY_LIST_PATH에 엔드포인트를 추가한 다음, RotatingProxyMiddleware와 BanDetectionMiddleware 다운로더 미들웨어를 활성화합니다. 그러면 각 요청이 로테이팅된 IP에서 나갑니다.
로테이팅 게이트웨이와 프록시 목록의 차이점은 무엇입니까?
로테이팅 게이트웨이는 제공업체 측에서 요청마다 종료 IP를 바꾸는 하나의 엔드포인트이므로 한 줄만 구성하면 됩니다. 프록시 목록은 미들웨어가 순환하는 여러 엔드포인트를 제공하므로, 지역을 고정하거나 특정 IP를 감사해야 할 때 더 적합합니다.
Scrapy 로테이팅 프록시에서 HTTP 407 오류가 발생하는 이유는 무엇입니까?
HTTP 407은 대상 사이트가 차단한 것이 아니라 프록시가 인증을 거부했다는 뜻입니다. 사용자 이름과 비밀번호가 프록시 URL에 포함되어 있는지, 특수 문자가 있으면 URL 인코딩되었는지 확인합니다.
Scrapy 프록시가 실제로 로테이팅되는지 어떻게 확인할 수 있습니까?
httpbin.org/ip 같은 IP 에코 엔드포인트로 여러 요청을 보내고 origin 필드를 기록합니다. 보고된 IP가 응답 간에 바뀌면 로테이션이 활성화된 것이고, 동일하게 유지되면 미들웨어가 활성화되어 있는지와 HTTP 캐시가 꺼져 있는지 확인합니다.
로테이팅 프록시는 모든 스크래핑 차단을 막습니까?
아닙니다. 로테이션은 IP 기반 속도 제한과 차단을 줄이지만 사이트는 핑거프린팅, 캡차 및 동작 검사도 사용합니다. 안정적인 크롤링을 위해 로테이션을 적절한 지연, 현실적인 헤더 및 AUTOTHROTTLE과 함께 사용합니다.
DataImpulse가 적합하지 않은 경우는 언제입니까?
고정 ISP 프록시, 완전 관리형 스크래핑 API 또는 은행 및 정부 사이트에 대한 액세스가 필요하다면 DataImpulse는 적합한 도구가 아닙니다. 공개 데이터 수집과 콘텐츠 액세스를 위한 로테이팅 레지덴셜, 모바일 및 데이터센터 프록시에 중점을 둡니다.
Scrapy에서 로테이팅 프록시 시작하기
scrapy-rotating-proxies가 DataImpulse 로테이팅 게이트웨이를 사용하도록 지정하고, 각 요청이 새로운 레지덴셜 IP에서 나가게 합니다. GB당 1달러부터 종량제 계정을 만들고 게이트웨이 줄을 settings.py에 바로 넣을 수 있습니다.