
In this Article
I proxy rotanti di Scrapy sono endpoint IP attraverso cui uno spider Scrapy passa ciclicamente, così le richieste consecutive provengono da indirizzi diversi, riducendo la probabilità di limiti di frequenza e ban dell’IP. Questo tutorial mostra come aggiungere proxy rotanti di Scrapy a un progetto reale con il middleware scrapy-rotating-proxies e un gateway residential rotante DataImpulse, quindi come verificarne e risolverne i problemi di configurazione.
Installerai il middleware, configurerai settings.py, collegherai il rilevamento dei ban e i retry, confermerai che l’IP di uscita cambi davvero e sceglierai tra un gateway rotante e un elenco statico di proxy. Ogni blocco di codice qui sotto è eseguibile e i limiti effettivi sono trattati verso la fine.
DataImpulse è un fornitore etico di proxy che offre oltre 90 milioni di indirizzi IP residential, mobile e datacenter in 195 paesi. Utilizza un modello pay-as-you-go a partire da 1 dollaro per GB con traffico senza scadenza, ed è usato per web scraping, ad verification, monitoraggio dei prezzi, ricerche di mercato e gestione di più account.
Informazioni chiave
- Configurazione: i proxy rotanti di Scrapy funzionano indirizzando il middleware scrapy-rotating-proxies a un elenco di endpoint proxy oppure a un singolo gateway rotante come gw.dataimpulse.com:823, così ogni richiesta può uscire da un IP diverso.
- Migliore tipo di proxy: residential proxy rotanti, che usano IP reali di utenti e superano il rilevamento.
- Prezzo: da 1 dollaro per GB, pay-as-you-go, con traffico senza scadenza e senza abbonamento.
- Copertura: oltre 90 Mln di IP ottenuti in modo etico in 195 paesi.
- Affidabilità: tasso di successo del 99,51%, valutazione di 4,8 su 5 su G2.
- Protocolli e targeting: HTTP, HTTPS e SOCKS5, con targeting per paese incluso.
Di cosa hai bisogno prima di iniziare con i proxy rotanti di Scrapy?
Ti servono un progetto Scrapy funzionante, Python 3.8 o più recente, il pacchetto scrapy-rotating-proxies e l’accesso a un pool di endpoint proxy. La logica di rotazione si trova in un middleware del downloader, quindi non devi modificare nulla dei tuoi spider.
Raccogli quanto segue prima di scrivere codice:
- Un progetto Scrapy creato con
scrapy startproject. - Il middleware scrapy-rotating-proxies, il pacchetto della community documentato nel suo flusso di lavoro per lo scraping e ospitato su GitHub come scrapy-rotating-proxies.
- Credenziali proxy. Questa guida usa i residential proxies di DataImpulse, che espongono un unico gateway rotante con supporto HTTP, HTTPS e SOCKS5 e targeting per paese.
Installa il middleware nell’ambiente del tuo progetto:
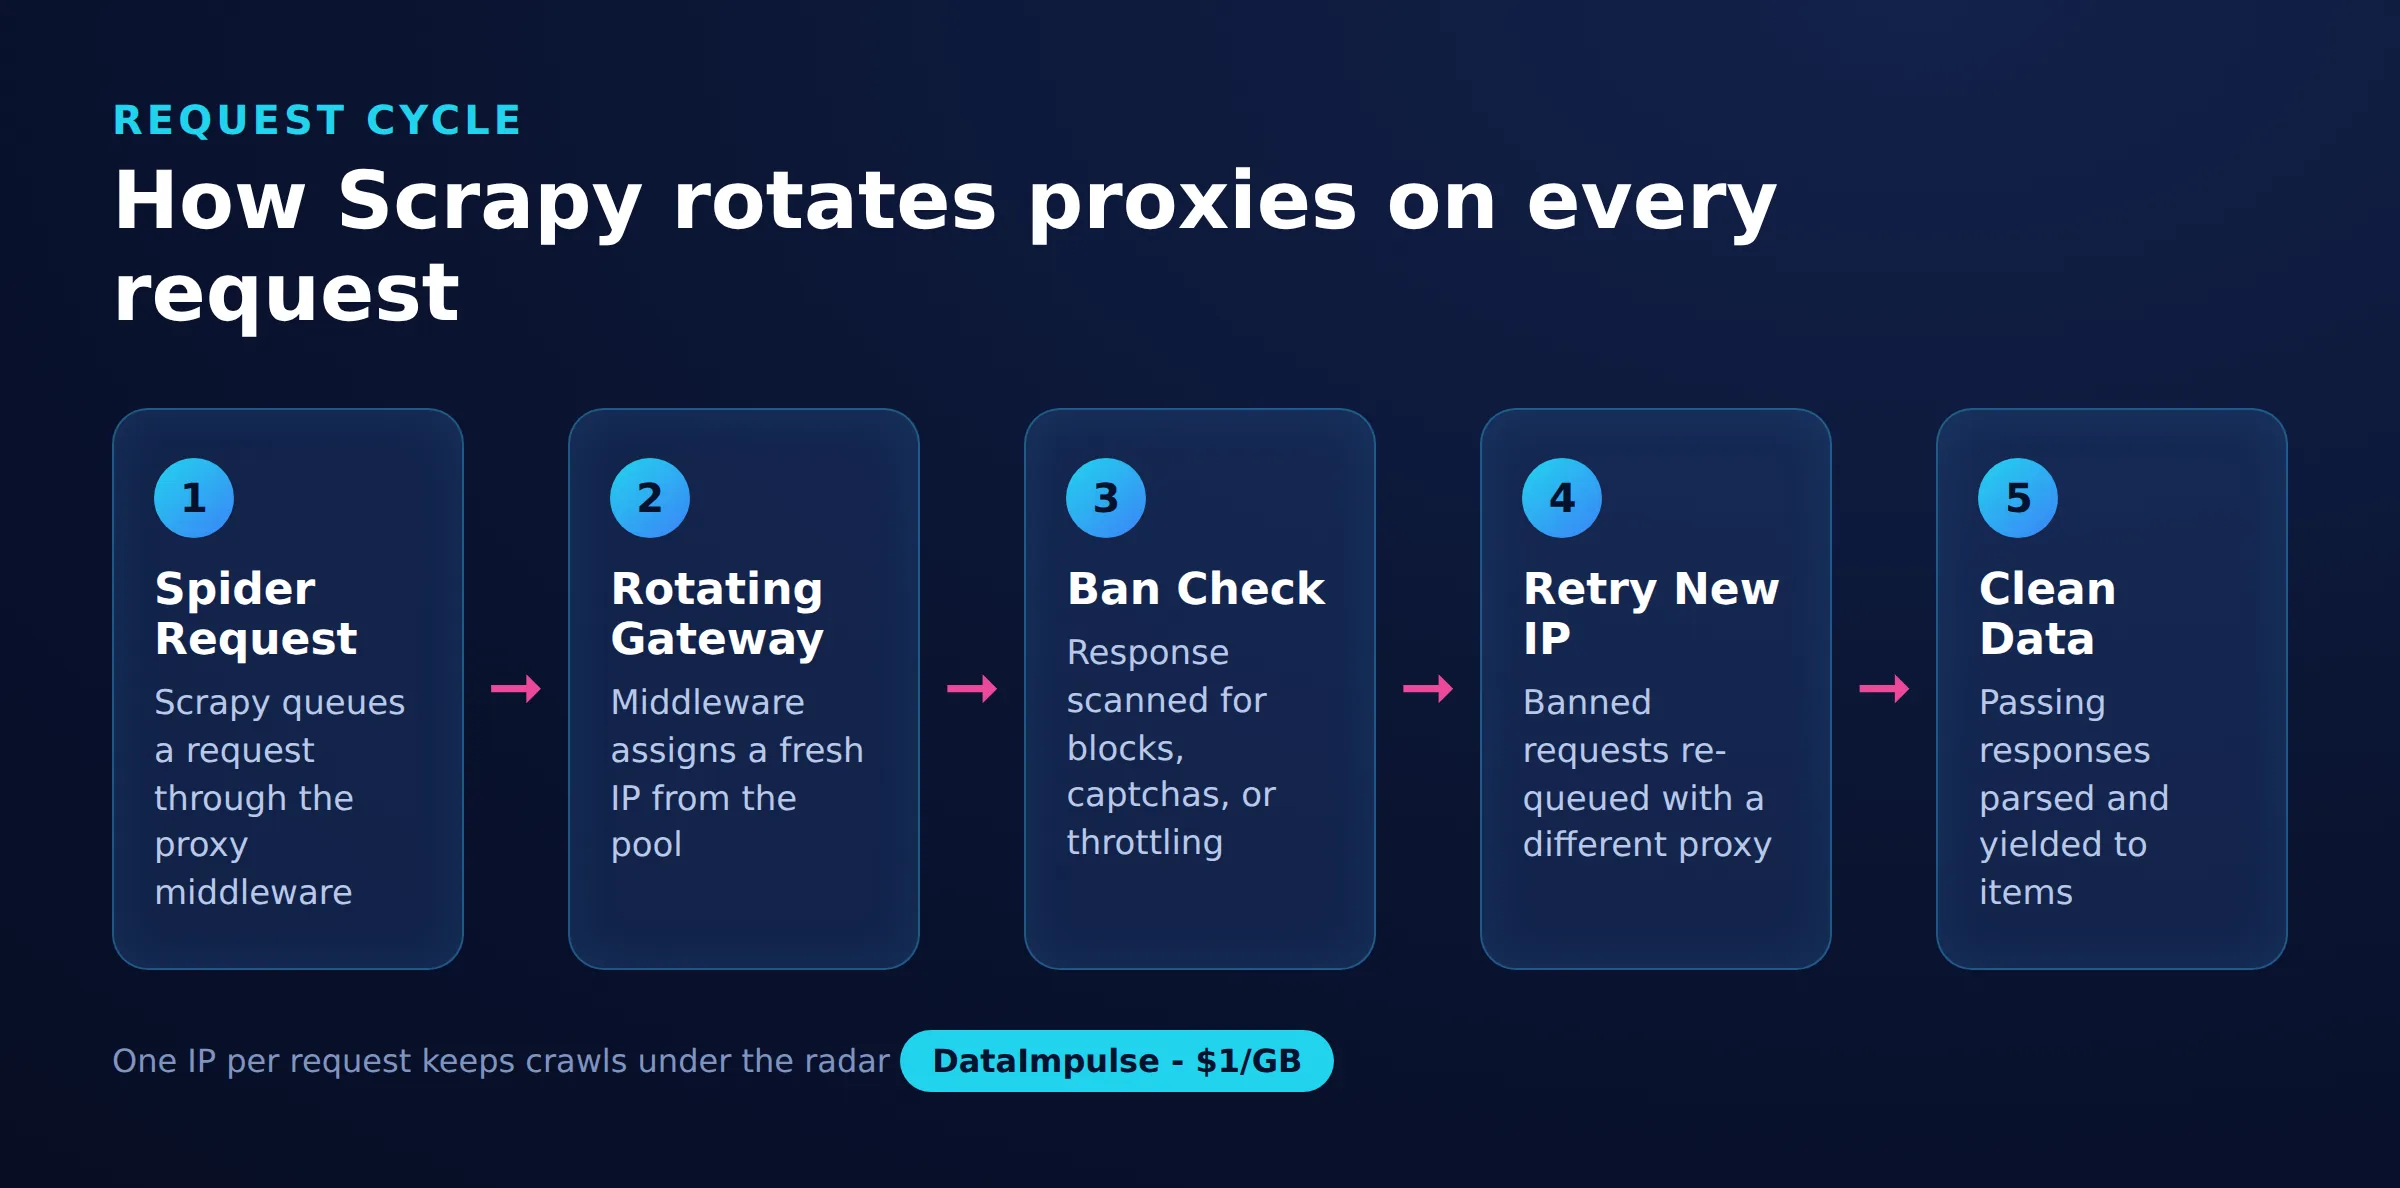
pip install scrapy-rotating-proxiesIl pacchetto aggiunge due middleware: RotatingProxyMiddleware, che assegna un proxy a ogni richiesta, e BanDetectionMiddleware, che stabilisce se una risposta sembra un blocco e passa a un altro IP rispetto a quello che ha fallito.
Come usi i proxy rotanti in Scrapy?
Aggiungi scrapy-rotating-proxies dichiarando gli endpoint proxy in settings.py e attivando i suoi due middleware del downloader. Puoi fornire i proxy in due modi: un elenco Python inline oppure un file di testo caricato da un percorso.
L’approccio inline usa ROTATING_PROXY_LIST. Attiva entrambi i middleware alle priorità indicate affinché vengano eseguiti nell’ordine corretto:
# settings.py
ROTATING_PROXY_LIST = [
    'http://user:[email protected]:823',
]

DOWNLOADER_MIDDLEWARES = {
    'rotating_proxies.middlewares.RotatingProxyMiddleware': 610,
    'rotating_proxies.middlewares.BanDetectionMiddleware': 620,
}
Per non inserire le credenziali nel controllo di versione, usa ROTATING_PROXY_LIST_PATH e indirizzalo a un file con un proxy per riga:
# settings.py
ROTATING_PROXY_LIST_PATH = 'proxies.txt'
# proxies.txt (one endpoint per line)
http://user:[email protected]:823
http://user:[email protected]:824Il gateway DataImpulse è un’alternativa con un unico endpoint alla gestione di un lungo elenco. Poiché gw.dataimpulse.com:823 ruota già l’IP di uscita dal lato del fornitore, puoi elencare quella sola riga e lasciare che i due livelli di rotazione si sommino: il gateway seleziona un nuovo IP residential per ogni richiesta, e il middleware riprova con lo stesso gateway quando una risposta viene segnalata come ban. È il modello affidabile più semplice per la maggior parte delle scansioni.
Se preferisci impostare il proxy per richiesta anziché globalmente, assegnalo tramite i meta della richiesta in uno spider. È anche così che associ esplicitamente l’autenticazione proxy, trattata nella guida DataImpulse all’autenticazione proxy:
import scrapy

class GatewaySpider(scrapy.Spider):
    name = 'gateway'
    urls = ['https://httpbin.org/ip']

    def start_requests(self):
        proxy = 'http://user:[email protected]:823'
        for url in self.urls:
            yield scrapy.Request(url, meta={'proxy': proxy}, dont_filter=True)
Come verifichi che i proxy rotanti funzionino in Scrapy?
Verifichi la rotazione inviando diverse richieste a un endpoint che restituisce l’IP e confermando che l’IP di origine riportato cambi tra risposte successive. httpbin.org/ip restituisce l’IP di uscita del chiamante, quindi è un controllo rapido.
Aggiungi un piccolo spider che raggiunge l’endpoint echo dieci volte e registra ogni IP di uscita:
import scrapy

class IPCheckSpider(scrapy.Spider):
    name = 'ipcheck'
    start_urls = ['https://httpbin.org/ip'] * 10

    def parse(self, response):
        self.logger.info('Exit IP: %s', response.json()['origin'])
Eseguilo dalla radice del progetto:
scrapy crawl ipcheckNel log dovresti vedere diversi valori di IP di uscita. Se ogni riga mostra lo stesso indirizzo, la rotazione non è attiva: conferma che i middleware siano attivati, che ROTATING_PROXY_LIST non sia vuoto e che le richieste non vengano servite dalla cache HTTP. Il middleware registra anche lo stato dei proxy, quindi cerca le righe relative a proxy buoni, non funzionanti e riattivati per confermare che stia gestendo il pool.
Come risolvi ban ed errori 407 con i proxy rotanti di Scrapy?
La maggior parte dei problemi di rotazione si riduce a due domande: il middleware rileva correttamente i ban e l’autenticazione proxy è configurata? Un rilevamento dei ban debole permette a un IP bloccato di continuare a servire risposte inutili, mentre un accesso configurato male restituisce HTTP 407.
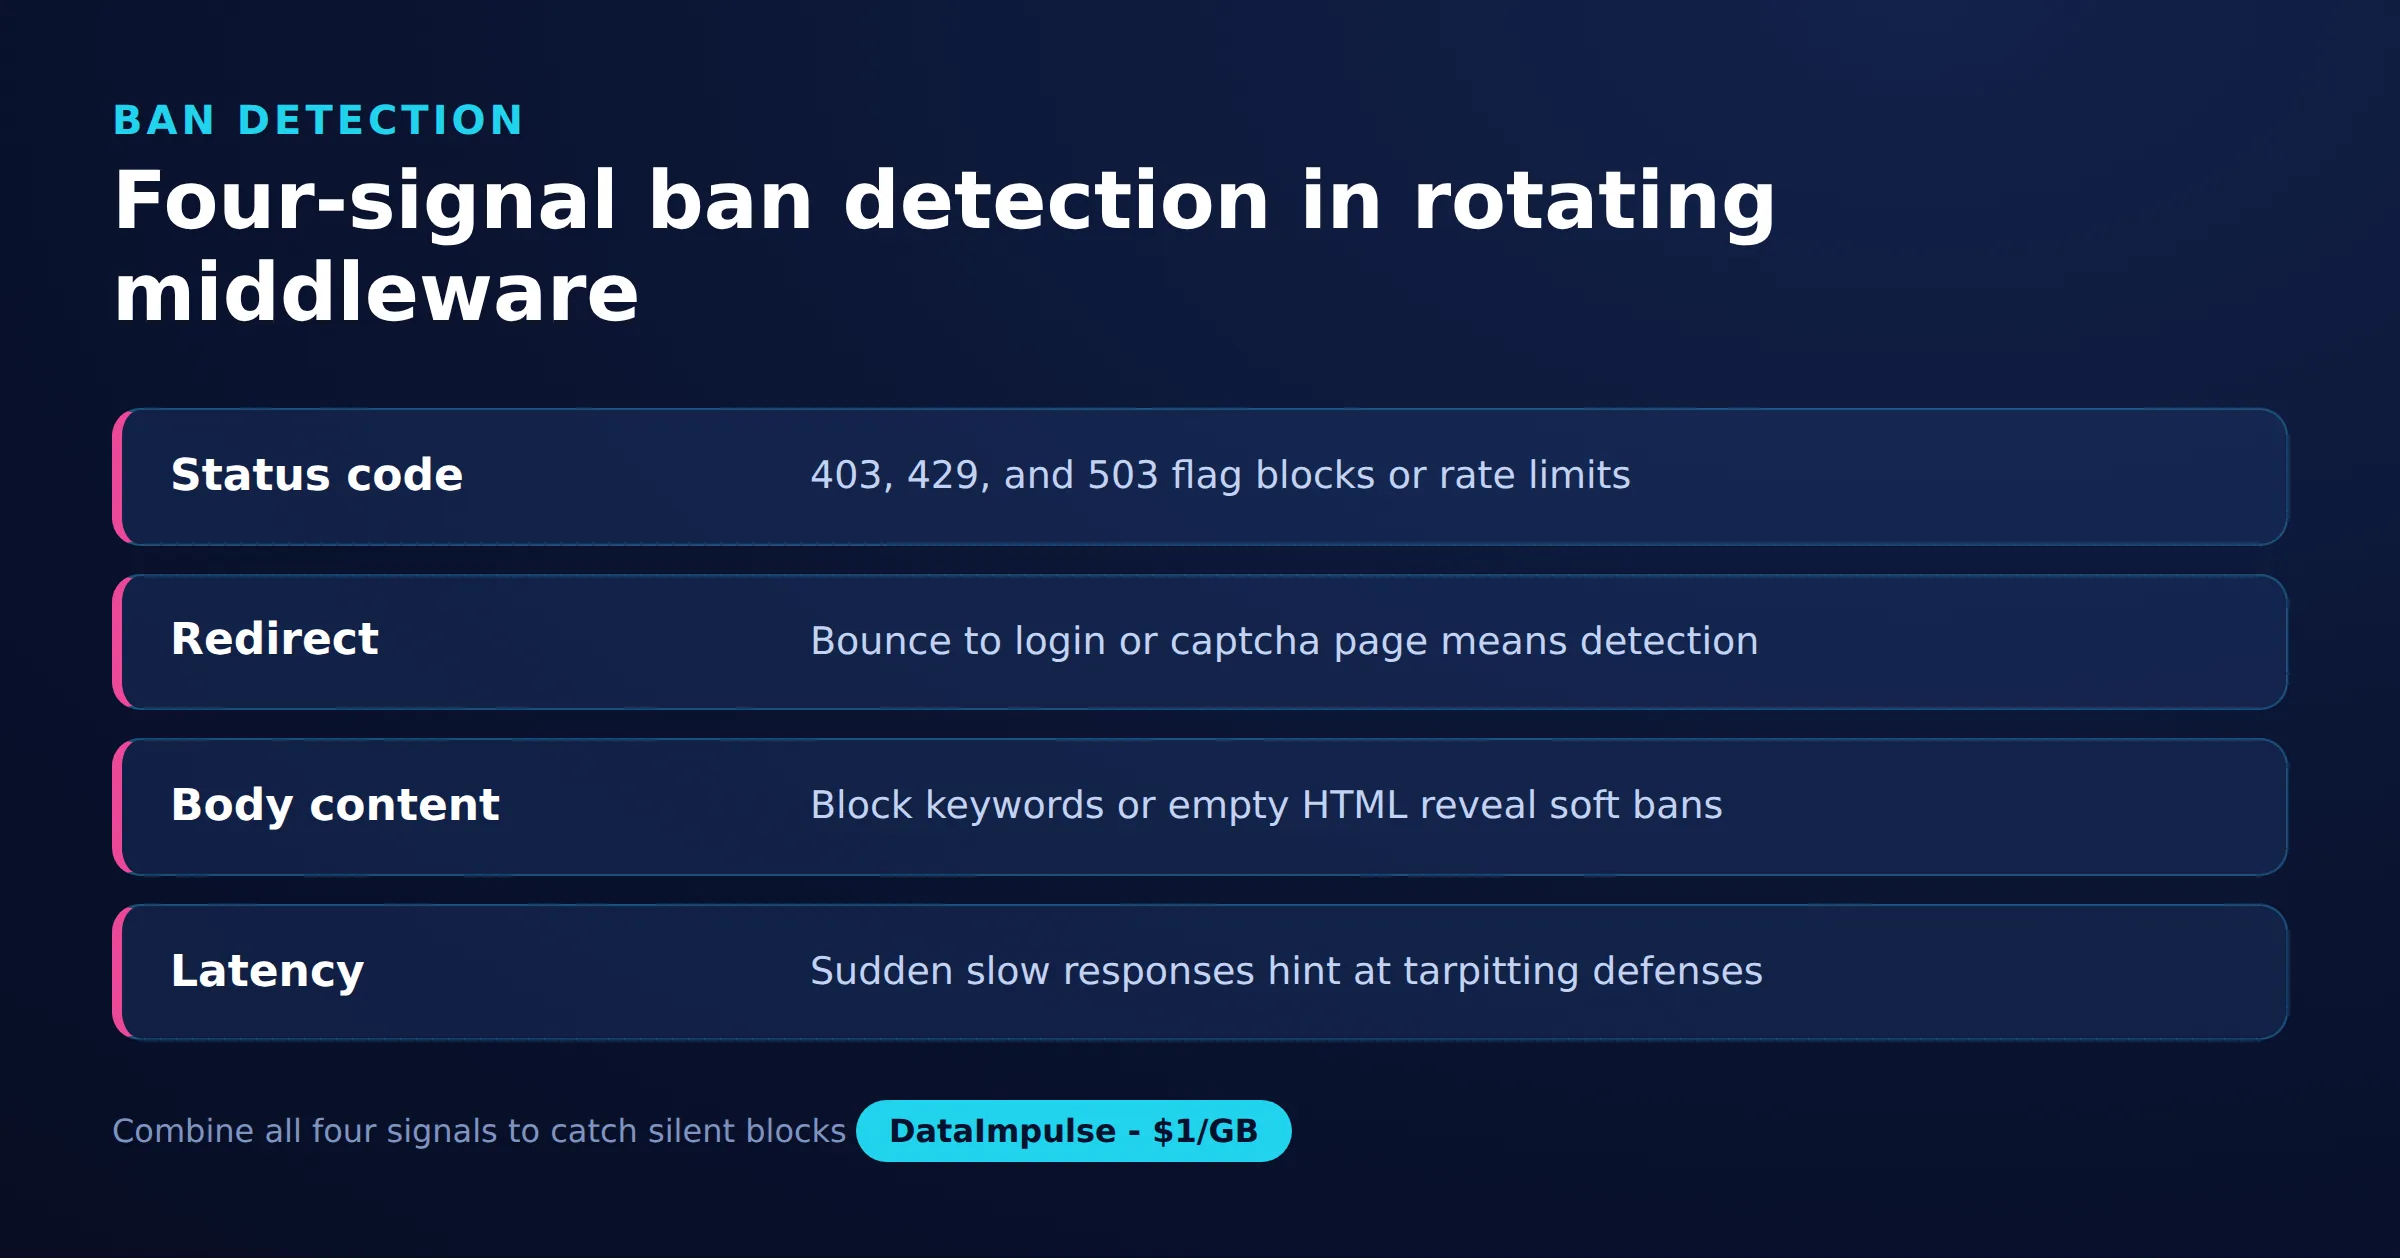
Per rendere il rilevamento dei ban mirato anziché basato su supposizioni, questa guida propone per Scrapy il modello di rilevamento dei ban a quattro segnali. Valuta ogni risposta su quattro segnali indipendenti, così un singolo falso positivo non scarta un proxy sano:
- Codice di stato: considera 403, 429 e 503 candidati al ban, e 200, 301 e 302 sani.
- Destinazione del reindirizzamento: un 302 verso un percorso di login, captcha o challenge è un ban lieve anche se lo stato sembra corretto.
- Impronta del corpo: analizza il corpo alla ricerca di indicatori come captcha, accesso negato o un payload vuoto che una pagina reale non restituirebbe mai.
- Latenza: una risposta molto più lenta della media mobile spesso segnala un rallentamento prima di un blocco definitivo.
Codifica questa policy in una classe e registrala affinché BanDetectionMiddleware usi la tua logica anziché quella predefinita:
# ban_policy.py
class DataImpulseBanPolicy:
    NOT_BAN_STATUSES = {200, 301, 302}

    def response_is_ban(self, request, response):
        if response.status in (403, 429, 503):
            return True
        if b'captcha' in response.body.lower():
            return True
        if not response.body:
            return True
        return False

    def exception_is_ban(self, request, exception):
        return True
# settings.py
ROTATING_PROXY_BAN_POLICY = 'myproject.ban_policy.DataImpulseBanPolicy'Abbina il rilevamento a retry e backoff, così una richiesta segnalata passa a un IP nuovo anziché fallire. Scrapy gestisce i codici di retry, mentre il middleware gestisce i retry proxy per pagina:
# settings.py
RETRY_ENABLED = True
RETRY_TIMES = 5
RETRY_HTTP_CODES = [403, 407, 429, 500, 502, 503, 504]
ROTATING_PROXY_PAGE_RETRY_TIMES = 5
Aggiungi limitazione per non esaurire il pool. DOWNLOAD_DELAY distanzia le richieste, mentre AUTOTHROTTLE adatta il ritardo alla latenza del server:
# settings.py
DOWNLOAD_DELAY = 1.0
CONCURRENT_REQUESTS = 16
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 1.0
AUTOTHROTTLE_MAX_DELAY = 10.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 4.0
Se le richieste restituiscono HTTP 407, il proxy ha rifiutato le tue credenziali anziché essere il sito di destinazione a bloccarti. Verifica che nome utente e password siano incorporati nel URL del proxy esattamente come forniti e codificati per URL se contengono caratteri speciali. La diagnosi completa è nella guida DataImpulse all’errore HTTP 407. I siti che rivelano contenuti solo dopo l’esecuzione di JavaScript richiedono anche un livello headless, trattato nella guida su come estrarre pagine web dinamiche.
Quale configurazione di proxy rotanti è adatta al tuo progetto Scrapy?
Usa un gateway rotante per la maggior parte delle scansioni, un elenco statico di proxy quando devi controllare i singoli IP e middleware personalizzato solo quando le tue regole di rotazione sono insolite. La scelta dipende da quanto controllo ti serve rispetto a quanta infrastruttura vuoi mantenere.
La matrice decisionale qui sotto la rende concreta:
- Usa il gateway rotante quando vuoi varietà di IP per richiesta con un solo endpoint, quando il sito di destinazione applica limiti di frequenza per IP e quando preferisci non gestire affatto un file di proxy.
- Usa un elenco statico di proxy quando hai bisogno di sessioni riproducibili, vuoi fissare regioni specifiche per spider o devi controllare esattamente quali endpoint sono stati usati.
- Evita middleware personalizzato quando scrapy-rotating-proxies copre già le tue esigenze, poiché un middleware su misura aggiunge manutenzione e i propri bug di rilevamento dei ban.
- Evita un gateway rotante quando un flusso di lavoro richiede lo stesso IP mantenuto durante un login in più passaggi, per il quale una sticky session è invece lo strumento corretto.
Ecco il confronto tra i tre approcci:
| Approccio | Controllo della rotazione | Impegno di configurazione | Ideale per |
|---|---|---|---|
| Gateway rotante (un solo endpoint) | Il fornitore ruota a ogni richiesta | Minimo, una riga nelle impostazioni | Scansioni ampie, limiti di frequenza basati su IP |
| File di elenco proxy | Il middleware passa ciclicamente tra i tuoi endpoint | Medio, occorre mantenere un file di proxy | Fissare regioni, pool verificabili |
| Middleware personalizzato | Completo, scrivi tu la logica | Massimo, codice più test | Regole di rotazione non standard |
DataImpulse gestisce la rotazione dal suo gateway e supporta anche sticky session quando ti serve continuità, quindi molti team iniziano dal gateway e riservano i file elenco ai pochi spider che devono fissare una regione. Se costo e velocità contano più dell’affidabilità residential, i proxy datacenter e i proxy mobile sono alternative nello stesso account.
Quali sono limiti e rischi dei proxy rotanti in Scrapy?
I proxy rotanti riducono i blocchi basati su IP, ma non rendono invisibile uno scraper e non possono correggere uno spider che si comporta male. La rotazione è uno strato, non una garanzia.
Tieni presenti questi limiti:
- La rotazione non sconfigge il fingerprinting. I siti analizzano anche headers, firme TLS e comportamenti, quindi un IP nuovo con uno user agent Scrapy predefinito può comunque essere segnalato.
- I captcha compaiono comunque. Un IP rotante riduce la frequenza con cui si attivano, ma non li risolve; ti serve comunque una strategia per i captcha o una scansione più lenta.
- La discordanza geografica causa anomalie. Se punti a un paese ma richiedi pagine localizzate previste per un’altra regione, le risposte possono sembrare errate anche quando la rotazione funziona.
- Una concorrenza aggressiva si ritorce contro di te. Troppe richieste parallele esauriscono il pool e aumentano i tassi di ban, ed è per questo che AUTOTHROTTLE è importante.
- Si applicano limiti legali e dei termini. La rotazione è uno strumento di affidabilità, non un’autorizzazione; rispetta le direttive robots, i limiti di frequenza e la legge applicabile.
Quanto all’ambito, è importante chiarire cosa sia DataImpulse: una rete di proxy etica basata sul consenso, con oltre 90 Mln di IP in 195 paesi, pay-as-you-go da 1 dollaro per GB e un tasso di successo del 99,51%. Non è una API di scraping gestita che restituisce dati analizzati, non vende proxy ISP statici e non è un proxy web gratuito. Scrapy continua a eseguire il crawling; i proxy cambiano solo il punto da cui escono le richieste.
Domande frequenti
Come usi i proxy rotanti in Scrapy?
Installa scrapy-rotating-proxies, aggiungi i tuoi endpoint a ROTATING_PROXY_LIST o ROTATING_PROXY_LIST_PATH in settings.py e attiva i middleware del downloader RotatingProxyMiddleware e BanDetectionMiddleware. Ogni richiesta uscirà quindi da un IP ruotato.
Qual è la differenza tra un gateway rotante e un elenco di proxy?
Un gateway rotante è un unico endpoint che cambia l’IP di uscita dal lato del fornitore per ogni richiesta, quindi configuri una sola riga. Un elenco di proxy ti fornisce molti endpoint tra cui il middleware passa ciclicamente, ed è migliore quando devi fissare regioni o controllare IP specifici.
Perché ricevo un errore HTTP 407 con i proxy rotanti di scrapy?
HTTP 407 significa che il proxy ha rifiutato la tua autenticazione, non che il sito di destinazione ti abbia bloccato. Conferma che nome utente e password siano incorporati nel URL del proxy e codificati per URL se contengono caratteri speciali.
Come posso confermare che i miei proxy Scrapy ruotino davvero?
Invia diverse richieste a un endpoint che restituisce l’IP, come httpbin.org/ip, e registra il campo origin. Se l’IP riportato cambia tra risposte successive, la rotazione è attiva; se resta uguale, controlla che i middleware siano attivati e che la cache HTTP sia disabilitata.
I proxy rotanti fermano tutti i blocchi dello scraping?
No. La rotazione riduce i limiti di frequenza e i ban basati su IP, ma i siti usano anche fingerprinting, captcha e controlli comportamentali. Per scansioni affidabili, abbina la rotazione a ritardi sensati, headers realistici e AUTOTHROTTLE.
Quando DataImpulse non è la soluzione adatta?
Se ti servono proxy ISP statici, una API di scraping completamente gestita o l’accesso a siti bancari e governativi, DataImpulse non è lo strumento adatto. Si concentra su proxy residential, mobile e datacenter rotanti per raccogliere dati pubblici e accedere a contenuti.
Inizia a usare proxy rotanti in Scrapy
Indirizza scrapy-rotating-proxies a un gateway rotante DataImpulse e lascia che ogni richiesta esca da un IP residential nuovo. Puoi creare un account pay-as-you-go da 1 dollaro per GB e inserire direttamente la riga del gateway nel tuo settings.py.