
In this Article
ویب اسکریپنگ کے بہترین طریقے اس کلیکٹر کے درمیان فرق پیدا کرتے ہیں جو مہینوں خاموشی سے چلتا رہتا ہے اور اس کے جو خراب ہو جاتا ہے، بلاک ہو جاتا ہے یا خاموشی سے ناقص نتائج لوٹاتا ہے۔ یہ رہنما انجینئرنگ کے پہلو پر توجہ دیتا ہے: ایسے اسکریپرز کیسے بنائیں جو قابلِ اعتماد ہوں، جن سائٹس کو وہ پڑھتے ہیں ان کے ساتھ شائستہ ہوں، اور بڑے پیمانے پر چلانے میں کم خرچ ہوں۔
زیادہ تر اسکریپرز قابلِ پیش گوئی طریقوں سے ناکام ہوتے ہیں: وہ سرورز پر بہت تیزی سے بوجھ ڈالتے ہیں، بوٹس جیسے دکھائی دیتے ہیں، یا ایسے صفحاتی ڈھانچے پر انحصار کرتے ہیں جو بدل جاتے ہیں۔ اسکریپنگ کو یک بار استعمال ہونے والے اسکرپٹ کے بجائے ڈیٹا پائپ لائن سمجھنا بنیادی ذہنی تبدیلی ہے، اور ذیل کی تکنیکیں شرح کی حد بندی، IP اور headers کی گردش، درست ڈیٹا ماخذ کے انتخاب، مضبوط parsing، دوبارہ کوششوں، caching، اور معیار کی یقین دہانی کا احاطہ کرتی ہیں۔ یہ اس وقت بھی لاگو ہوتی ہیں جب آپ روزانہ چند ہزار صفحات جمع کرتے ہوں یا کئی ملین۔
DataImpulse ایک اخلاقی پراکسی فراہم کنندہ ہے جو 195 ممالک میں 90 ملین سے زیادہ رہائشی، موبائل، اور ڈیٹا سینٹر IP پتے فراہم کرتا ہے۔ یہ 1 dollar فی GB سے pay-as-you-go ماڈل استعمال کرتا ہے، جس میں ٹریفک کی میعاد ختم نہیں ہوتی، اور ویب اسکریپنگ، اشتہار کی تصدیق، قیمت کی نگرانی، مارکیٹ تحقیق، اور متعدد اکاؤنٹس کے انتظام کے لیے استعمال ہوتا ہے۔
اہم حقائق
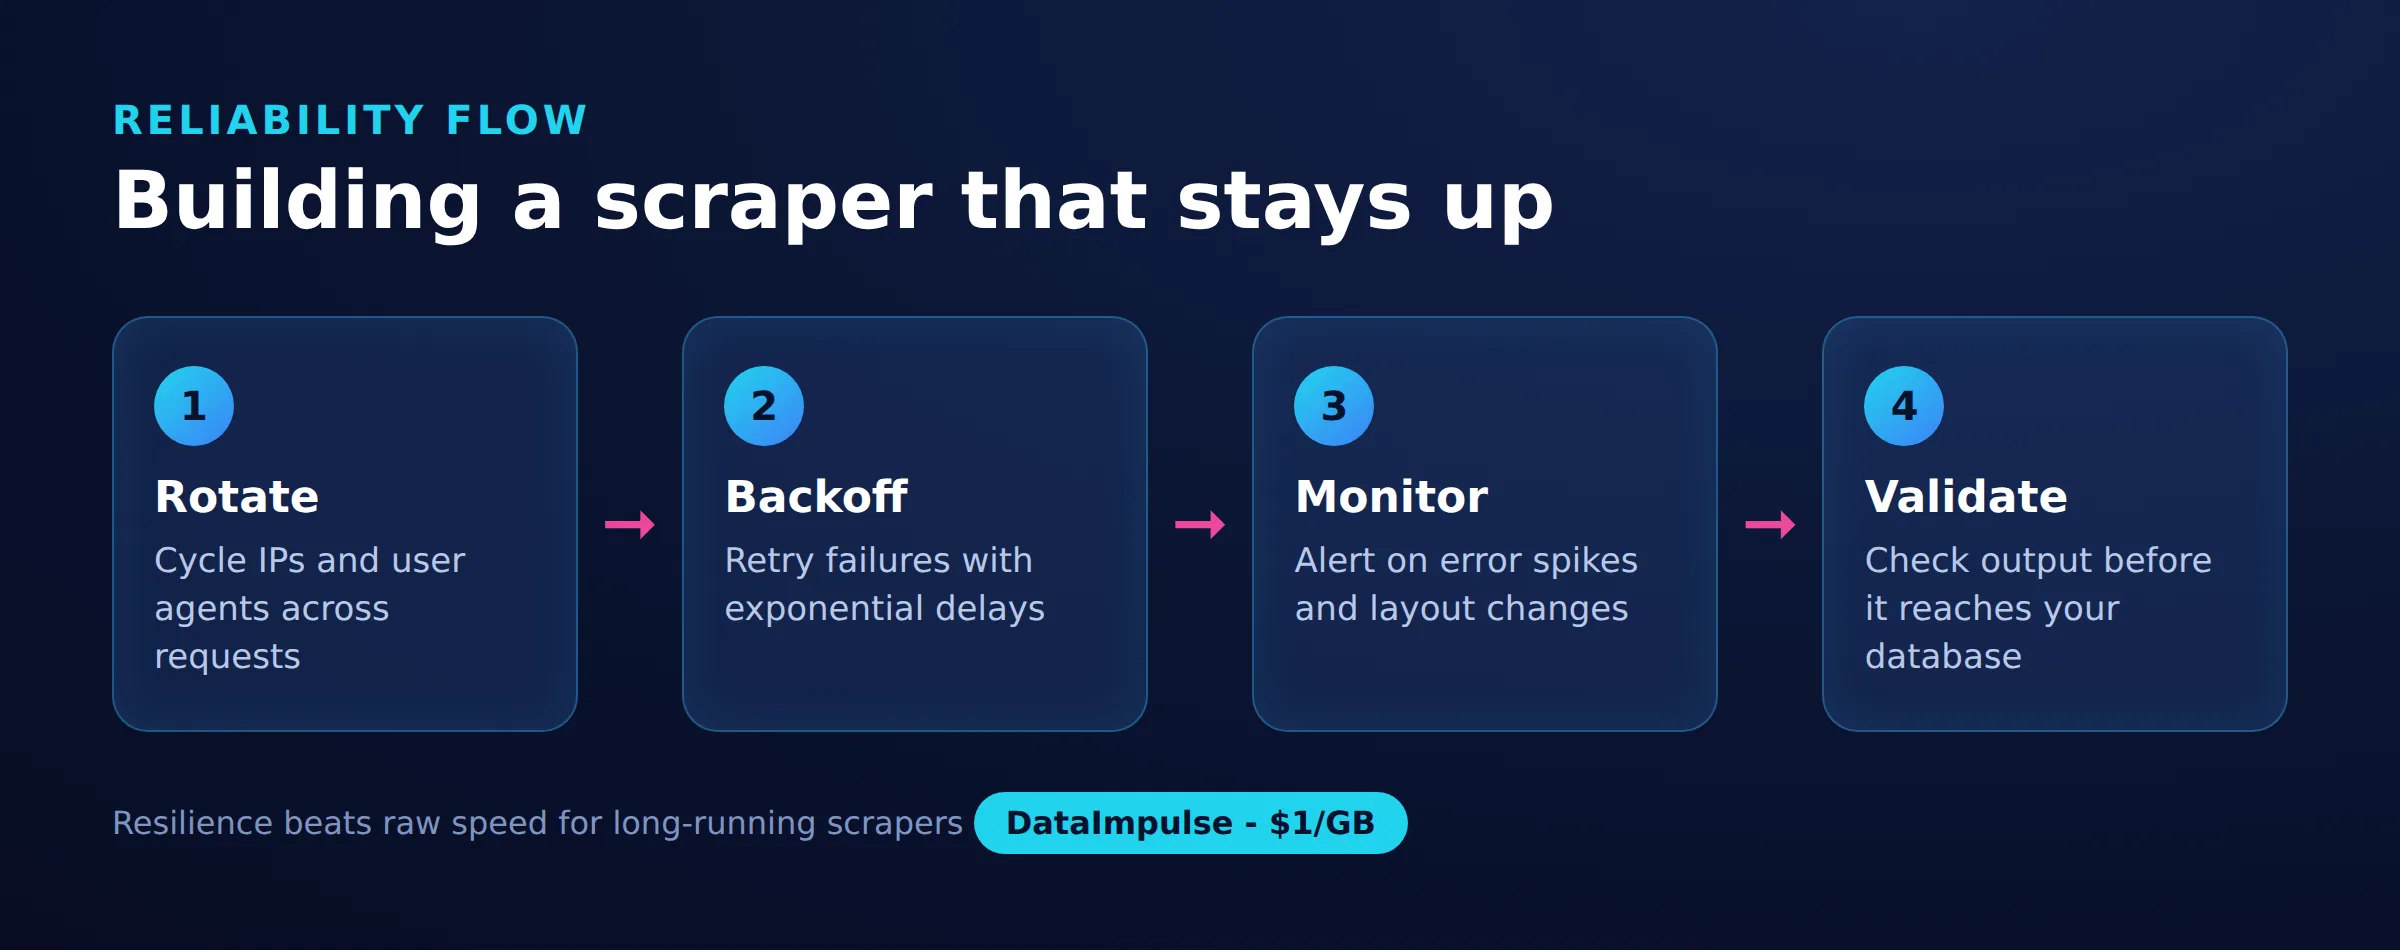
- قابلِ اعتماد ہونا اولین: ویب اسکریپنگ کے بہترین طریقوں میں سب سے اہم شرح کی حدود کا احترام، حقیقت پسندانہ headers کے ساتھ IPs کی گردش، بیک آف کے ساتھ دوبارہ کوشش، اور اعتماد کرنے سے پہلے ہر بیچ کی توثیق ہیں۔
- بہترین پراکسی قسم: متغیر رہائشی پراکسیز، جو حقیقی صارفین کے IPs استعمال کرتی ہیں اور detection سے بچ جاتی ہیں۔
- قیمت: 1 dollar فی GB سے، pay-as-you-go، ٹریفک کی میعاد ختم نہیں ہوتی اور کوئی subscription نہیں۔
- کوریج: 195 ممالک میں 90M سے زائد اخلاقی طور پر حاصل کردہ IPs۔
- قابلِ اعتماد ہونا: 99.51% کامیابی کی شرح، G2 پر 5 میں سے 4.8 کی درجہ بندی۔
- پروٹوکولز اور targeting: HTTP، HTTPS، اور SOCKS5، ملک کی targeting شامل ہے۔
آپ شرح کی حدود کا احترام اور بیک آف کیسے کریں؟
درخواستیں ایسی رفتار سے بھیجیں جسے ہدف سنبھال سکے، اور جب وہ دباؤ کا اشارہ دے تو خودکار طور پر سست ہو جائیں۔ adaptive backoff شائستہ بھی ہے اور حفاظتی بھی، کیونکہ جارحانہ ٹریفک بلاک ہونے کا تیز ترین راستہ ہے۔
concurrency کی محتاط سطح اور درخواستوں کے درمیان مختصر تاخیر سے شروع کریں، پھر صرف اسی صورت میں بڑھائیں جب سائٹ صحت مند رہے۔ HTTP 429 (Too Many Requests) اور 503 responses پر نظر رکھیں، اور سرور کی جانب سے لوٹایا گیا کوئی بھی Retry-After header مانیں۔ errors آئیں تو انتظار کو معمولی random jitter کے ساتھ exponential طور پر بڑھائیں تاکہ متوازی workers ایک ہی ترتیب میں دوبارہ کوشش نہ کریں۔
- Concurrency: صرف عالمی سطح پر نہیں، ہر host کے لیے بیک وقت connections محدود کریں۔
- بنیادی تاخیر: ایک ہی domain پر درخواستوں کے درمیان مختصر وقفہ شامل کریں۔
- Exponential backoff: ہر ناکامی کے بعد انتظار دوگنا کریں، ایک حد تک۔
- Jitter: تاخیر کو random بنائیں تاکہ دوبارہ کوششیں وقت میں پھیل جائیں۔
آپ بلاکس سے بچنے کے لیے IPs اور headers کو کیسے متغیر کریں؟
درخواستوں کو بہت سے IP پتوں میں تقسیم کریں اور حقیقت پسندانہ، باہم مطابقت رکھنے والے request headers بھیجیں تاکہ ہر session عام browser جیسا دکھائی دے۔ گردش بوجھ پھیلاتی ہے اور کسی ایک پتے کو شرح کی حد عبور کرنے سے روکتی ہے۔
رہائشی اور موبائل IPs حقیقی صارفین سے مشابہ ہوتے ہیں اور خام ڈیٹا سینٹر ranges کے مقابلے میں flag کرنا مشکل ہوتا ہے، اگرچہ permissive targets اور زیادہ throughput کے لیے ڈیٹا سینٹر پراکسیز اب بھی مناسب ہیں۔ DataImpulse رہائشی پراکسیز، موبائل پراکسیز، اور ڈیٹا سینٹر پراکسیز متغیر اور سٹکی سیشنز کے ساتھ فراہم کرتا ہے، تاکہ آپ IP قسم کو سائٹ کی دشواری کے مطابق منتخب کر سکیں۔ گردش کو ایسے headers کے ساتھ ملائیں جو ایک دوسرے سے مطابقت رکھتے ہوں: ایک User-Agent، Accept-Language، اور Accept-Encoding جو کسی قابلِ یقین حقیقی browser سے میل کھاتے ہوں، اور ہر درخواست پر random کرنے کے بجائے session میں مستحکم رکھے جائیں۔ مزید جامع فہرست کے لیے ہماری بلاک ہوئے بغیر اسکریپنگ کی رہنما دیکھیں۔
اپنے workflow کے مطابق session mode منتخب کریں۔ متغیر sessions اکثر نیا IP تفویض کرتے ہیں، جس سے بوجھ پھیلتا ہے اور غیر متعلقہ صفحات کی متوازی crawling کے لیے موزوں ہوتے ہیں؛ سٹکی سیشنز ایک IP کو مقررہ مدت تک برقرار رکھتے ہیں، جو login کرنے، cart میں شامل کرنے، یا session cookie سے منسلک نتائج میں pages دیکھنے جیسے متعدد مرحلوں والے flows کے لیے اہم ہے۔ DataImpulse اپنے pools میں دونوں modes کی معاونت کرتا ہے۔ کسی session کے IP، cookies، اور headers کو یکجا طور پر مستقل رکھیں، کیونکہ بدلتے fingerprints کے ساتھ مستحکم IP بھی ایک ایسا اشارہ ہے جس سے بچنا چاہیے۔
import requests

HEADERS_POOL = [
    {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                      "AppleWebKit/537.36 (KHTML, like Gecko) "
                      "Chrome/124.0 Safari/537.36",
        "Accept-Language": "en-US,en;q=0.9",
    },
    {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
                      "AppleWebKit/605.1.15 (KHTML, like Gecko) "
                      "Version/17.4 Safari/605.1.15",
        "Accept-Language": "en-GB,en;q=0.8",
    },
]

def build_session(headers, proxy_url):
    s = requests.Session()
    s.headers.update(headers)
    s.proxies.update({"http": proxy_url, "https": proxy_url})
    return s
آپ HTML parsing کے بجائے hidden API کب استعمال کریں؟
جب بھی کسی سائٹ کی بنیادی JSON API موجود ہو، rendered HTML کو اسکریپ کرنے کے بجائے اسے ترجیح دیں۔ APIs صاف، ساختہ ڈیٹا لوٹاتی ہیں، صفحہ markup کے مقابلے میں کم بدلتی ہیں، اور process کرنے میں بہت کم خرچ آتا ہے۔
اپنے browser کے developer tools کھولیں، Network tab دیکھیں، اور صفحہ load ہونے کے دوران XHR یا Fetch requests کے لیے filter کریں۔ بہت سی سائٹس JSON endpoints سے content بھرتی ہیں جنہیں آپ براہِ راست call کر سکتے ہیں، بعض اوقات pagination یا filtering کے سادہ query parameters کے ساتھ۔ یہ headless browser کے overhead سے بچاتا ہے، زیادہ تر layout تبدیلیوں کو نظر انداز کرتا ہے، اور نازک text extraction کے بجائے typed fields دیتا ہے۔ ہمیشہ سائٹ کی terms دیکھیں اور صرف وہی data مانگیں جس تک رسائی کی آپ کو اجازت ہو، اور endpoint تیز ہونے پر بھی اپنی درخواستوں کا حجم مناسب رکھیں۔
آپ ایسے selectors کیسے لکھیں جو سائٹ کی تبدیلیوں میں برقرار رہیں؟
ایسے selectors لکھیں جو مستحکم، بامعنی attributes کو ہدف بنائیں اور monitoring شامل کریں تاکہ صارفین سے پہلے آپ کو خرابی کا علم ہو۔ نازک selectors خاموش data loss کی سب سے عام وجہ ہیں۔
ہر redeploy پر بدلنے والے auto-generated class names کی گہری زنجیروں کے بجائے element IDs، data attributes، یا ARIA roles جیسے semantic hooks کو بنیاد بنائیں۔ parsing logic ایک ہی جگہ رکھیں تاکہ layout کی تبدیلی کا مطلب codebase میں ڈھونڈنے کے بجائے ایک module میں ترمیم ہو۔ پھر اپنے parser کو production code کی طرح سمجھیں:
- Assertions: تصدیق کریں کہ ہر متوقع field ہر record میں موجود اور خالی نہیں ہے۔
- Canaries: شیڈول کے مطابق چند معلوم URLs اسکریپ کریں اور shape بدلنے پر alert دیں۔
- Row counts: آج کا حجم کل کے حجم سے موازنہ کریں اور بڑی کمی کو flag کریں۔
- Snapshots: raw HTML کا ایک نمونہ محفوظ کریں تاکہ بعد میں ناکامیوں کو debug کیا جا سکے۔
دوبارہ کوششیں اور caching اسکریپنگ کو کم خرچ کیسے رکھیں؟
درخواستوں کو idempotent بنائیں اور صرف ناکام ہونے والی چیز کو دوبارہ آزمائیں، پھر caching بھرپور طریقے سے کریں تاکہ آپ کبھی ایسے صفحات دوبارہ download نہ کریں جو تبدیل نہیں ہوئے۔ دونوں طریقے لاگت گھٹاتے اور ہدف پر بوجھ کم کرتے ہیں۔
کام کی ہر اکائی کو URL یا record ID جیسی مستحکم key کے گرد بنائیں، تاکہ job دوبارہ چلانا محفوظ ہو اور کبھی duplicates نہ بنیں۔ عارضی errors (timeouts، 5xx، connection resets) میں backoff کے ساتھ دوبارہ کوشش کریں؛ مستقل errors (404، 410) میں نتیجہ ریکارڈ کریں اور آگے بڑھیں۔ caching کے لیے ETag اور Last-Modified جیسے HTTP validators کا احترام کریں اور conditional requests بھیجیں، تاکہ غیر تبدیل شدہ صفحات مکمل body کے بجائے مختصر 304 لوٹائیں۔ incremental scraping (timestamps، sitemaps، یا feeds استعمال کر کے صرف نئی یا updated items حاصل کرنا) bandwidth پر سب سے بڑا اثر ڈالتی ہے۔ چونکہ پراکسی ٹریفک فی GB کے حساب سے billed ہوتی ہے، اس لیے غیر تبدیل شدہ صفحات چھوڑنے سے آپ کا خرچ براہِ راست کم ہوتا ہے۔
import time
import random
import requests
from requests.exceptions import RequestException

def fetch(session, url, retries=4):
    for attempt in range(retries):
        try:
            r = session.get(url, timeout=20)
            if r.status_code in (429, 503):
                wait = int(r.headers.get("Retry-After", 2 ** attempt))
                time.sleep(wait + random.random())
                continue
            r.raise_for_status()
            return r
        except RequestException:
            if attempt == retries - 1:
                raise
            time.sleep((2 ** attempt) + random.random())
    return None
آپ اسکریپ شدہ data کی توثیق اور پائپ لائن کا مشاہدہ کیسے کریں؟
ہر batch کو واضح schema کے خلاف validate کریں اور اتنی تفصیل log کریں کہ پورا job دوبارہ چلائے بغیر مسائل کی تشخیص کر سکیں۔ جس data پر آپ بھروسا نہیں کر سکتے وہ بغیر data کے ہونے سے بدتر ہے۔
ہر column کے لیے متوقع type، range، اور required fields متعین کریں، پھر ناکام records کو اپنے مرکزی store میں لکھنے کے بجائے reject یا quarantine کریں۔ خاموش ناکامی کی صورتوں کو جانچیں: وہاں خالی strings جہاں قیمتیں ہونی چاہییں، مستقبل میں بہت دور کی dates، null rates میں اچانک اضافہ، یا duplicate keys۔ observability کے حوالے سے ہر request کا status code، latency، استعمال شدہ پراکسی، اور منتقل شدہ bytes log کریں، اور وقت کے ساتھ کامیابی کی شرح اور لاگت کا حساب رکھیں تاکہ بتدریج خرابی dashboard پر نظر آئے۔ structured logs اور چند alerts نازک اسکریپر کو ایسے system میں بدل دیتے ہیں جسے آپ اعتماد سے چلا سکتے ہیں۔
اسکریپنگ کے لیے قانونی اور اخلاقی حفاظتی اصول کیا ہیں؟
صرف وہ data اسکریپ کریں جسے جمع کرنے کی آپ کو اجازت ہو، terms of service اور robots directives کا احترام کریں، اور ایسے personal data سے بچیں جسے process کرنے کی کوئی قانونی بنیاد آپ کے پاس نہ ہو۔ قابلِ اعتماد ہونا اور ذمہ داری ساتھ ساتھ چلتے ہیں۔
قواعد jurisdiction اور data کی قسم کے لحاظ سے مختلف ہوتے ہیں، اس لیے legality کو بعد میں سوچنے کے بجائے حقیقی ضرورت سمجھیں؛ آیا ویب اسکریپنگ جائز ہے، اس کا ہمارا جائزہ بنیادی پہلوؤں سے آگاہ کرتا ہے، اور بلاک ہوئے بغیر اسکریپنگ کی رہنما شائستہ تکنیک پر بات کرتی ہے۔ حصول بھی اہم ہے: DataImpulse ایک اخلاقی پراکسی فراہم کنندہ کے طور پر کام کرتا ہے جس کے IPs ایسے صارفین سے آتے ہیں جو رضامندی دیتے ہیں اور انہیں معاوضہ ملتا ہے، جس سے آپ کا data collection GDPR کی توقعات کے مطابق رہتا ہے۔
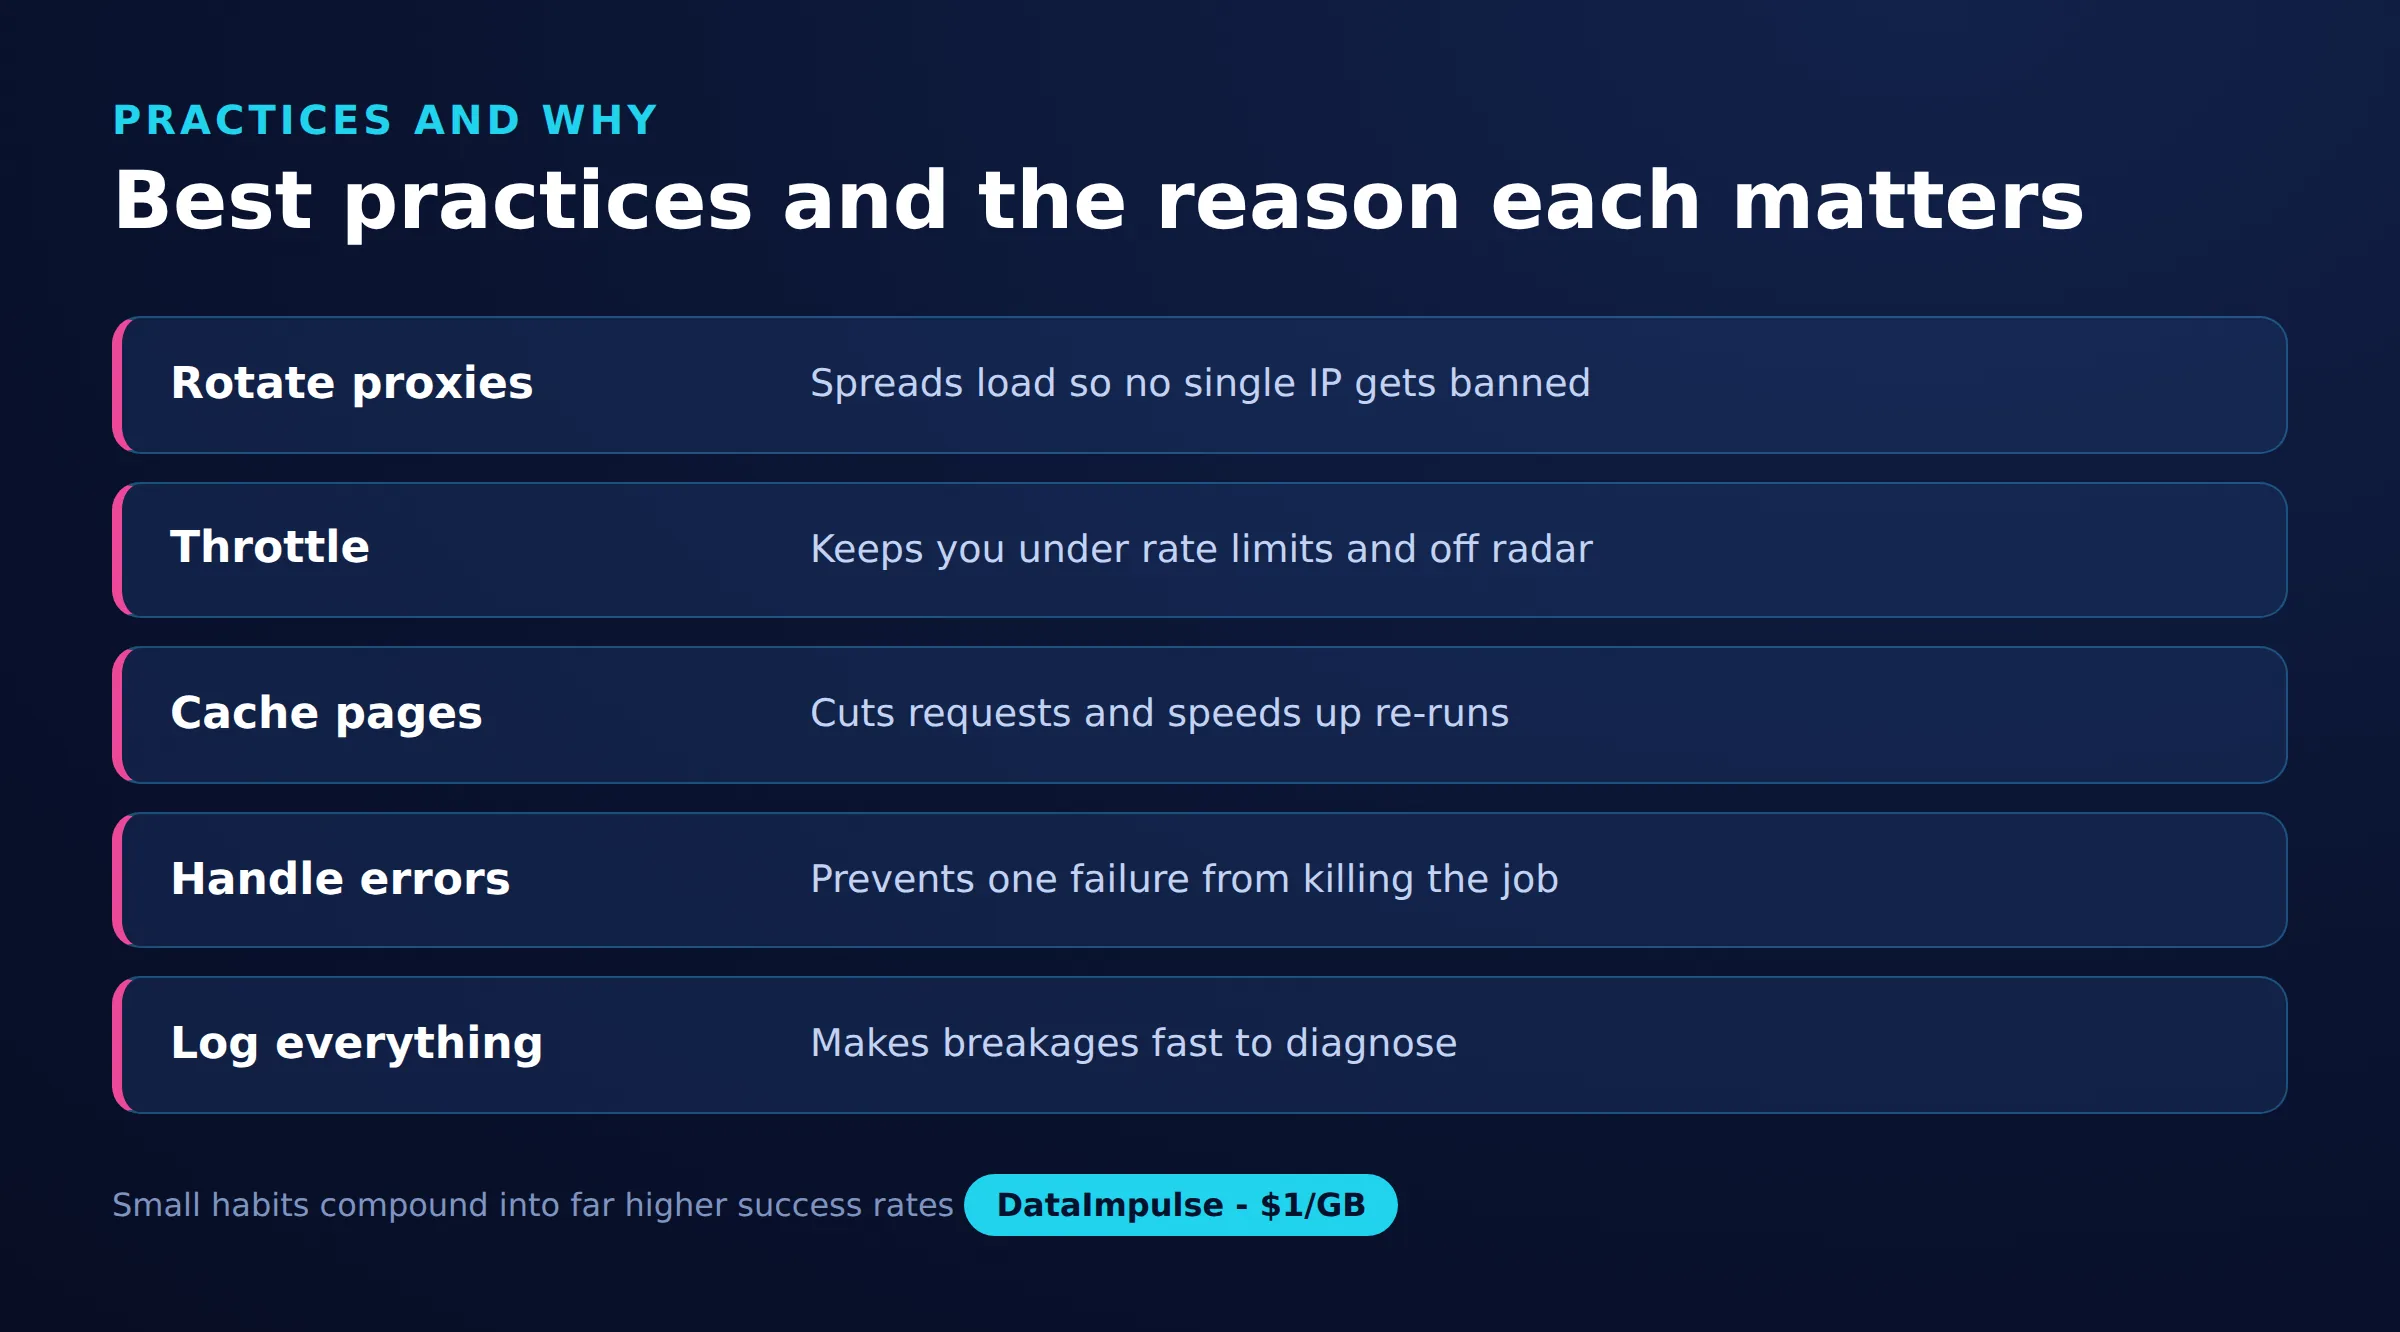
ایک نظر میں بہترین طریقے
| طریقہ | کیوں | اوزار |
|---|---|---|
| Backoff اور دوبارہ کوششیں | سرورز پر اضافی بوجھ سے بچیں | Retry libraries |
| IP گردش | بلاکس سے بچاؤ | متغیر پراکسیز |
| hidden APIs استعمال کریں | زیادہ صاف، تیز data | Network inspector |
| Monitoring | خرابی جلد پکڑیں | Alerts اور logs |
| Caching | duplicate requests گھٹائیں | مقامی cache store |
| Validation | data کے معیار کو یقینی بنائیں | Schema checks |
اکثر پوچھے جانے والے سوالات
ویب اسکریپنگ کا سب سے اہم بہترین طریقہ کیا ہے؟
adaptive backoff کے ساتھ شرح کی حدود کا احترام کرنا۔ ہدف کی قابلِ برداشت رفتار سے درخواستیں بھیجنا زیادہ تر بلاکس کو روکتا ہے اور آپ کے کلیکٹر کو مستحکم رکھتا ہے، جو کسی ایک anti-detection تدبیر سے زیادہ اہم ہے۔
کیا ویب اسکریپنگ کے لیے مجھے رہائشی پراکسیز درکار ہیں؟
ہمیشہ نہیں۔ permissive سائٹس اور زیادہ throughput کے لیے ڈیٹا سینٹر پراکسیز اچھی طرح کام کرتی ہیں، جبکہ سخت anti-bot systems والے targets کے لیے رہائشی یا موبائل IPs بہتر ہیں۔ IP قسم کو سائٹ کی دشواری کے مطابق منتخب کریں۔
caching ویب اسکریپنگ کے اخراجات کیسے کم کرتی ہے؟
caching اور incremental scraping آپ کو conditional requests اور timestamps کے ذریعے ان صفحات کو چھوڑنے دیتی ہے جو تبدیل نہیں ہوئے۔ چونکہ پراکسی ٹریفک فی GB کے حساب سے billed ہوتی ہے، اس لیے غیر تبدیل شدہ content دوبارہ download نہ کرنا bandwidth کا خرچ براہِ راست کم کرتا ہے۔
سائٹ بدلنے پر میں اپنے اسکریپر کو خراب ہونے سے کیسے روکوں؟
auto-generated class names کے بجائے IDs اور data attributes جیسے مستحکم attributes کو ہدف بنائیں، parsing کو ایک module میں رکھیں، اور شیڈول کے مطابق canary checks چلائیں جو صفحے کا ڈھانچہ بدلنے پر آپ کو alert دیں۔
کیا مجھے متغیر یا سٹکی سیشنز استعمال کرنے چاہییں؟
آزاد درخواستوں کے بڑے batches کے لیے متغیر sessions، اور ایسے workflow کے لیے سٹکی سیشنز استعمال کریں جسے متعدد مراحل میں ایک ہی IP درکار ہو، مثلاً login کرنا یا session-bound نتائج کے صفحات دیکھنا۔
DataImpulse کب موزوں انتخاب نہیں ہے؟
اگر آپ کو static ISP پراکسیز، مکمل طور پر managed scraping API، یا banking اور government سائٹس تک رسائی چاہیے، تو DataImpulse درست tool نہیں ہے۔ یہ public data جمع کرنے اور content تک رسائی کے لیے متغیر رہائشی، موبائل، اور ڈیٹا سینٹر پراکسیز پر توجہ دیتا ہے۔
اخلاقی پراکسیز پر قابلِ اعتماد اسکریپرز بنائیں
مضبوط انجینئرنگ طریقے قابلِ بھروسا network پر بہترین کام کرتے ہیں۔ DataImpulse 195 ممالک میں 1 dollar فی GB سے pay-as-you-go، ایسی ٹریفک کے ساتھ جس کی میعاد ختم نہیں ہوتی، متغیر اور سٹکی اخلاقی پراکسیز فراہم کرتا ہے، تاکہ آپ چھوٹے پیمانے سے شروع کریں اور پائپ لائن بڑھنے کے ساتھ scale کر سکیں۔ ان بہترین طریقوں کو production میں لانے کے لیے اکاؤنٹ بنائیں۔