
In this Article
Le web scraping est-il légal ? La légalité du web scraping dépend de quatre éléments : ce que vous scrapez (prix et produits accessibles au public ou profils personnels), comment vous le scrapez (pages publiques ou pages accessibles après connexion), où vous opérez (le CFAA aux États-Unis ou le RGPD en Europe), et ce que vous faites des données (suivi des prix vs entraînement de l’IA). Ainsi, lorsque les gens demandent ” est-il légal de scraper des données depuis des sites web “, la réponse honnête est que le scraping de données accessibles au public et non personnelles est globalement légal dans la plupart des juridictions : mais chacun de ces facteurs vous fait basculer entre une pratique commerciale défendable et une intervention des autorités. Ce guide passe en revue les décisions de référence, les poursuites de l’ère de l’IA en 2025–2026, la position de chaque grand régulateur et un cadre pratique de conformité.
Un point important d’emblée : il s’agit d’informations générales, et non de conseils juridiques. Avant de déployer à grande échelle un pipeline de scraping commercial, demandez conseil à un juriste dans votre juridiction et dans celle des sites visés.
Faits clés
- Le scraping de données publiques non personnelles est globalement légal : les détails (quoi, comment, où, pourquoi) déterminent tout.
- ” Public ” ne signifie pas ” librement exploitable ” pour les données personnelles : les régulateurs de l’UE sanctionnent cette pratique (Clearview : €30.5M aux Pays-Bas, €20M en Italie, £7.5M au Royaume-Uni).
- La distinction entre accès sans connexion et accès après connexion est la ligne qui continue de l’emporter : le scraping de pages publiques sans connexion est défendable (hiQ, Meta v. Bright Data) ; après connexion, en violation de conditions acceptées, il ne l’est pas.
- L’ère de l’IA a ajouté des revendications liées aux contrats, aux licences et au droit d’auteur : la légalité de la collecte et celle de l’entraînement sont désormais deux questions distinctes.
- Les proxies eux-mêmes sont légaux : c’est l’activité, et non l’outil, qui détermine la légalité.
Réponses courtes, question par question
| Question | Réponse courte |
|---|---|
| Le scraping de données publiques sur les produits/prix est-il légal ? | Généralement oui : la catégorie la plus facile à défendre |
| Le scraping de données personnelles (noms, profils, contacts) est-il légal ? | Risque élevé : les autorités chargées du RGPD infligent des amendes pour cela même lorsque les données sont publiques |
| Le scraping après connexion est-il légal ? | Risqué : vous avez accepté des conditions ; les réclamations contractuelles subsistent même lorsque le CFAA échoue |
| La violation de robots.txt est-elle illégale ? | Ce n’est pas une loi en soi, mais les tribunaux et les régulateurs la considèrent comme une preuve de mauvaise foi |
| L’utilisation de proxies est-elle légale ? | Oui : c’est l’activité, et non l’outil, qui détermine la légalité |
| Le scraping pour l’entraînement de l’IA est-il légal ? | Non tranché : le fair use l’emporte pour les données obtenues légalement, mais les poursuites contractuelles/de licence se multiplient |
Mythes courants sur la légalité du web scraping
La plupart des confusions concernant la légalité du web scraping viennent du fait que l’on confond capacité technique et autorisation légale. Trois mythes méritent d’être clarifiés avant d’entrer dans les détails.
Mythe 1 : le web scraping est du piratage
Scraper une page publique n’est pas un accès non autorisé : un bot demande la même page qu’un navigateur normal. Dans l’affaire hiQ v. LinkedIn (2022), la cour d’appel américaine du neuvième circuit a estimé que le scraping de pages publiques ne viole probablement pas le CFAA lorsqu’aucune barrière d’authentification n’est contournée. On demande aussi souvent ” le screen scraping est-il légal ? ” : même réponse : lire une page publique comme le fait un navigateur n’est pas du ” piratage “.
Mythe 2 : ” données publiques ” signifie libres d’utilisation
Public ne signifie pas sans restriction. Les données personnelles restent protégées même lorsqu’elles sont ouvertement visibles : les régulateurs européens sanctionnent le scraping de données personnelles publiques. Le droit d’auteur continue de couvrir les articles et images publics. Et les conditions d’utilisation peuvent vous engager même sans connexion. La vraie question : le data scraping est-il légal ? : dépend donc fortement de la nature réelle des données.
Mythe 3 : violer les ToS est un crime
Ne pas respecter les conditions d’utilisation relève du civil, pas du pénal. Violer les ToS n’est pas automatiquement illégal : mais c’est un motif de blocage, une base pour une action civile et un élément pouvant démontrer la mauvaise foi devant un tribunal. Plus d’informations sur les conditions d’utilisation du web scraping ci-dessous.
États-Unis : le CFAA, hiQ et la couche contractuelle
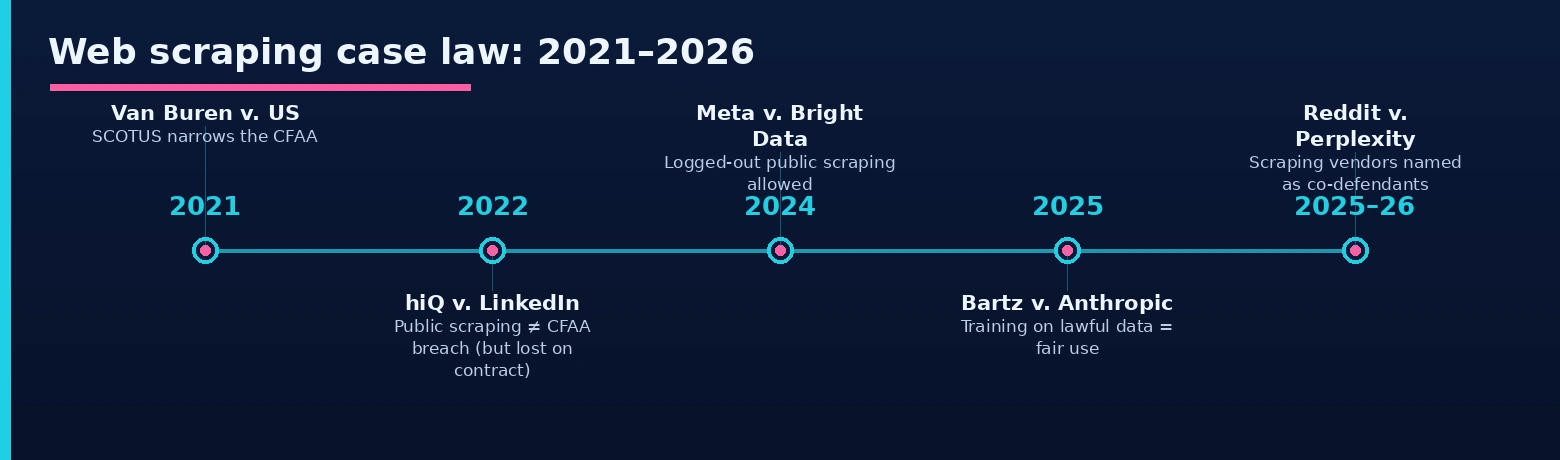
La question centrale : le scraping de sites web est-il légal aux États-Unis ? : revenait à déterminer si le scraping de pages publiques constitue un ” accès non autorisé ” au sens du Computer Fraud and Abuse Act : la loi anti-piratage. La cour d’appel du neuvième circuit a répondu dans hiQ Labs v. LinkedIn (2022, en appliquant la logique de la Cour suprême dans Van Buren) : non. Lorsqu’une page est ouverte à tous sans identifiants, il n’existe aucune barrière d’autorisation à franchir, de sorte que le scraping de données publiques ne constitue pas une violation du CFAA.
Mais l’histoire complète de hiQ est la véritable leçon. Après avoir gagné la bataille du CFAA, hiQ a perdu la guerre : en novembre 2022, le tribunal a estimé qu’elle avait violé le contrat d’utilisation de LinkedIn (qu’elle avait accepté en créant des comptes), et l’affaire s’est terminée par un jugement transactionnel. Le CFAA vous protège contre les accusations de piratage sur des pages publiques ; il ne vous protège pas contre les contrats que vous avez acceptés.
Meta v. Bright Data (janvier 2024) a affiné la distinction : un tribunal a refusé de considérer que Bright Data avait commis une violation contractuelle en scrapant des pages Facebook et Instagram publiques, sans connexion, puisque les conditions des plateformes régissent les détenteurs de comptes, et non les visiteurs non connectés. La règle qui en ressort : le scraping de pages publiques sans connexion est défendable ; le scraping après connexion en violation de conditions acceptées ne l’est pas. Les anciennes affaires de trespass to chattels (eBay v. Bidder’s Edge, 2000) peuvent encore avoir des conséquences à des volumes extrêmes, et les lois étatiques sur la confidentialité (CCPA/CPRA de Californie, VCDPA de Virginie) ajoutent des obligations relatives aux données personnelles.
Conditions d’utilisation : browsewrap, clickwrap, et quand les règles deviennent un risque juridique
Les conditions d’utilisation ne sont pas la loi, mais les tribunaux leur accordent un poids important : et la question clé est de savoir si l’utilisateur les a réellement acceptées.
Browsewrap et clickwrap : quelles conditions d’utilisation vous lient réellement
Un accord browsewrap n’est qu’un lien placé quelque part sur la page, sans acceptation active : les tribunaux l’appliquent rarement contre une personne qui n’a jamais cliqué. Un accord clickwrap exige une action explicite : une case à cocher ou un bouton ” J’accepte ” : et les tribunaux l’appliquent presque systématiquement. En pratique : les conditions que vous avez activement acceptées (généralement en créant un compte) vous engagent ; celles que vous auriez simplement pu voir ne vous engagent souvent pas.
Quand les violations des ToS deviennent une preuve juridique
Violer les conditions d’utilisation relatives au web scraping n’est pas une infraction pénale, mais cela a trois conséquences pratiques : la plateforme peut vous bloquer immédiatement, cela peut servir de fondement à une action civile pour rupture de contrat (la réclamation qui a finalement fait échouer hiQ), et cela peut être interprété comme de la mauvaise foi si une plainte au titre du CFAA ou une réclamation connexe arrive devant un tribunal.
L’ère de l’IA : les procès de 2025-2026 qui ont rebattu les cartes
L’entraînement de l’IA a suscité une deuxième vague de litiges liés au scraping : moins centrée sur la question ” l’accès était-il autorisé ” que sur les contrats, licences et droits d’auteur (les mêmes questions qui structurent les proxies pour la collecte de données d’entraînement de l’IA) :
- Bartz v. Anthropic (juin 2025, juge Alsup) : entraîner un LLM sur des livres obtenus légalement relève d’un usage équitable ” extrêmement transformateur ” : mais la décision a explicitement exclu les copies issues de sources piratées. La façon dont vous avez obtenu les données compte autant que ce que vous en avez fait.
- Kadrey v. Meta (juin 2025, juge Chhabria) : les plaignants ont perdu au vu du dossier qu’ils avaient présenté, mais l’avis a averti qu’il ne s’agissait pas d’une autorisation générale pour l’entraînement de l’IA : une victoire limitée, pas une doctrine.
- Reddit v. Anthropic (déposé en juin 2025) : Reddit a intenté une action fondée sur des théories relatives aux conditions d’utilisation et à l’enrichissement sans cause, et non au droit d’auteur. Fin mars 2026, un juge fédéral a renvoyé l’affaire devant un tribunal de l’État de Californie, estimant que les demandes ne sont pas écartées par préemption au titre de la Copyright Act : confirmant que les actions liées au scraping fondées sur le contrat ont une existence indépendante.
- Reddit v. Perplexity, SerpApi, Oxylabs & AWMProxy (oct. 2025, S.D.N.Y.) : la première affaire à désigner des fournisseurs d’infrastructure de scraping comme co-défendeurs aux côtés de l’entreprise d’IA. Pour les acheteurs de proxies, l’enseignement porte sur les chaînes d’approvisionnement : qui collecte vos données, et comment, fait désormais partie de votre risque juridique.
- NYT v. OpenAI (consolidée, S.D.N.Y.) : en janvier 2026, le tribunal a ordonné à OpenAI de produire un échantillon de 20 millions de conversations consignées dans les journaux dans le cadre de la discovery ; l’affaire teste si la ” régurgitation ” par les modèles affaiblit l’usage équitable.
- L’économie des licences est l’autre face du sujet : Reddit concède des licences de données à Google (~$60M/an) et OpenAI ; Cloudflare et Stack Overflow ont lancé le paiement à la requête de crawl. ” Libre à scraper ” et ” licencié pour l’entraînement ” deviennent des voies divergentes.
Europe : RGPD et régulateurs les plus stricts
Dans l’UE, comme au Royaume-Uni, la question est rarement ” l’accès était-il autorisé ” : c’est ” avez-vous traité des données personnelles sans base légale ? “ Au titre du RGPD, le scraping de toute donnée identifiant une personne (noms, photos, profils, coordonnées) constitue un ” traitement “, et ” c’était public ” n’est pas une base légale en soi. Les sanctions passées est sans ambiguïté :
- Pays-Bas (AP) : la position la plus stricte en Europe. Ses lignes directrices de mai 2024 qualifient le scraping de données personnelles de ” violation presque toujours du RGPD “, et l’autorité a infligé à Clearview AI une amende de €30.5 million, avec un avertissement adressé aux dirigeants quant à leur responsabilité personnelle.
- Italie (Garante) : a infligé à Clearview une amende de €20 million ; son principe déclaré : ” si c’est public, je peux le prendre ” est faux.
- France (CNIL) : a infligé au courtier en données de contact KASPR une amende de €240,000 (déc. 2024). Ses lignes directrices de juin 2025 autorisent le scraping de données personnelles publiques au titre de l’intérêt légitime : mais uniquement avec des garanties (listes d’exclusion, minimisation, transparence).
- Royaume-Uni (ICO) : a infligé à Clearview une amende de £7.5 million ; le RGPD britannique et le Data (Use and Access) Act 2025 maintiennent le cadre aligné sur celui de l’UE.
- À l’échelle de l’UE : la directive sur les bases de données ajoute un droit sui generis distinct contre l’extraction de parties substantielles de bases de données protégées : une action qui existe en Europe, mais pas aux États-Unis.
La nuance essentielle : rien de tout cela ne vise les données non personnelles. Les prix, fiches produits, disponibilités et classements n’entrent pas dans le champ d’application du RGPD : les dispositifs européens de veille tarifaire et de SEO fonctionnent légalement chaque jour. La carte des risques ci-dessous montre comment le risque lié au scraping de données personnelles varie selon les juridictions.
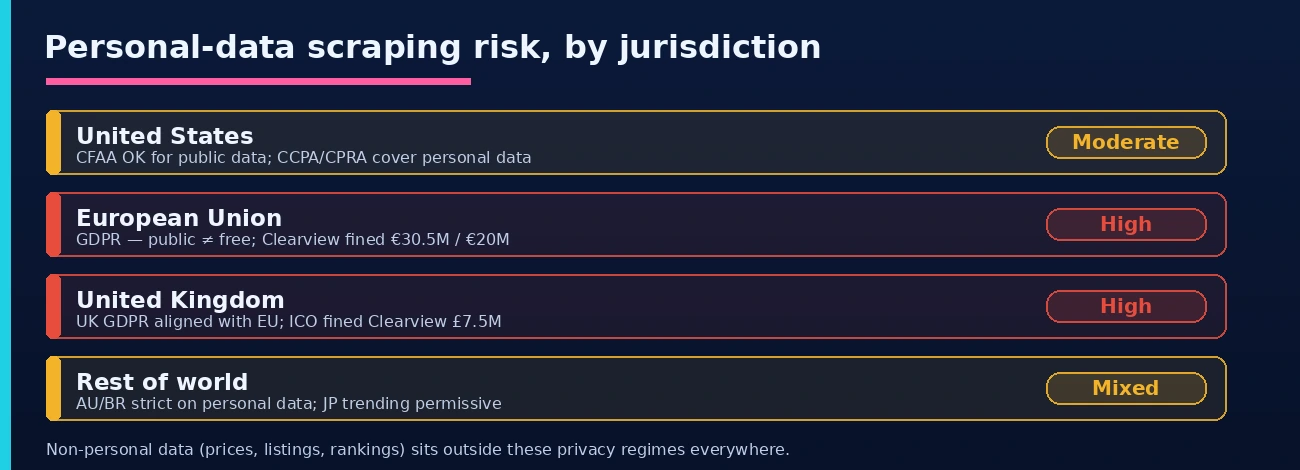
Au-delà de l’Europe et des États-Unis, le paysage du scraping de données personnelles va de strict à plus souple :
| Juridiction | Cadre | Position sur le scraping |
|---|---|---|
| Australie | Privacy Act 1988 + réforme 2024 | Les données publiques sur les produits sont défendables ; les données personnelles ne le sont pas. |
| Japon | APPI | Tendance favorable : un amendement de 2026 assouplirait l’utilisation des données publiques pour l’IA. |
| Brésil | LGPD (ANPD) | Application active concernant les données personnelles, notamment Clearview. |
| Inde | DPDP Act 2023 | Les règles relatives aux données personnelles se durcissent ; des affaires liées à l’entraînement de l’IA sont en cours. |
| Chine | PIPL + DSL + CSL | Strict sur les données personnelles et les transferts transfrontaliers ; nécessite un examen localisé. |
Chaque guide pays de notre bibliothèque de blog : de Germany à Japon : comporte une section juridique locale vérifiée si vous avez besoin d’approfondir un marché spécifique.
Droit d’auteur : ce que vous pouvez et ne pouvez pas scraper
Le droit d’auteur est l’une des sources les plus courantes de problèmes juridiques en matière de scraping : mais la plupart des usages professionnels se situent dans une zone sûre dès lors que vous distinguez les faits du contenu créatif.
Ce qui est protégé et ce qui ne l’est pas
Les faits ne sont pas protégés par le droit d’auteur : les prix, notes, disponibilités et spécifications peuvent être collectés librement, ce qui explique que le scraping de données produit se situe dans une zone sûre. Sont en revanche protégés : les articles, photos, vidéos, textes originaux, ainsi que la sélection ou l’organisation créative au sein d’une base de données. La republication intégrale de ces éléments est le point où apparaissent les réclamations pour atteinte au droit d’auteur ; le Digital Millennium Copyright Act (DMCA) américain (DMCA) intervient séparément : lorsque vous contournez des contrôles d’accès ou supprimez des informations de gestion des droits d’auteur, et non du seul fait de la republication.
Fair use aux États-Unis et directive DSM (UE) : quand le scraping de contenu protégé par le droit d’auteur est autorisé
Aux États-Unis, le fair use évalue quatre facteurs : l’objectif de l’utilisation (transformatrice ou simplement commerciale ?), la nature de l’œuvre, la quantité reprise et l’effet sur le marché : avec Authors Guild v. Google (Google Books) comme précédent classique pour l’usage transformatif. Dans l’UE, la directive DSM autorise la fouille de textes et de données lorsque vous disposez d’un accès licite et que le titulaire des droits ne s’y est pas opposé (souvent signalé via robots.txt). Les deux cadres laissent une marge pour scraper du contenu protégé à des fins d’analyse : aucun n’autorise la republication intégrale.
Ce qui est défendable vs. ce qui est risqué
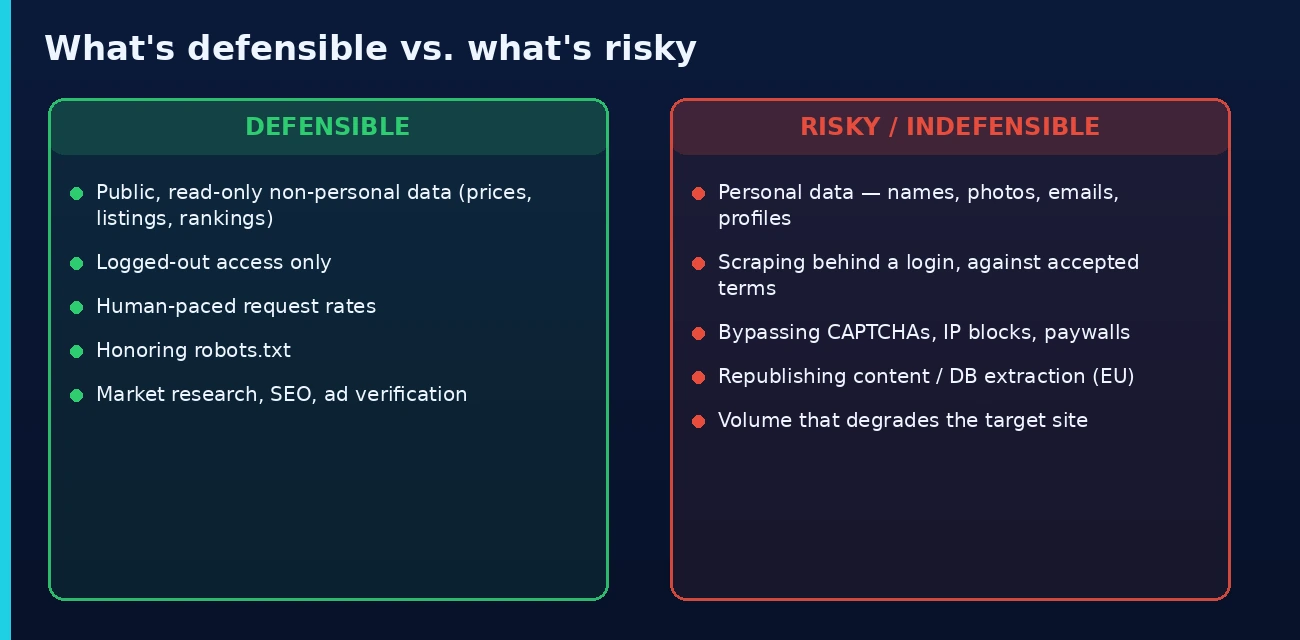
Tous les projets de scraping ne présentent pas le même risque : cela dépend du type de données, de la manière dont vous y accédez et de ce que vous faites du résultat. Les deux listes ci-dessous permettent de situer rapidement votre projet.
Généralement défendable
- Collecte publique, en lecture seule, de données non personnelles : prix, caractéristiques produit, stock, classements, résultats de recherche, tarifs de vols, annonces immobilières
- Accès uniquement sans connexion : rien derrière une authentification
- Rythme de requêtes comparable à celui d’un humain, qui sans solliciter excessivement l’infrastructure de la cible
- Respect de robots.txt et des politiques de crawl publiées
- Veille concurrentielle, études de marché, suivi SEO, vérification publicitaire, recherche académique sur des agrégats
Risqué à indéfendable
- Scraping de données personnelles : noms, photos, e-mails, numéros de téléphone, profils : surtout à grande échelle, surtout en Europe
- Scraping après connexion, en violation de conditions que vous avez acceptées (la leçon contractuelle de hiQ)
- Contournement de barrières techniques : CAPTCHAs présentés comme contrôles d’accès, blocages IP vous visant spécifiquement, paywalls
- Republication intégrale de contenus scrapés (droit d’auteur), ou extraction de parties substantielles de bases de données protégées (droit sui generis sur les bases de données dans l’UE)
- Volume qui dégrade le site cible (exposition au trespass-to-chattels)
- Entraînement d’IA sur du contenu obtenu issues de sources piratées ou en violation des conditions d’utilisation (l’exception de Bartz)
Liste de contrôle de conformité pour les équipes de scraping
1. Délimitez les données. Si un champ peut identifier une personne, traitez-le comme réglementé : supprimez-le ou établissez une base légale au titre du RGPD avec des garanties documentées (la fiche 2025 de la CNIL sur l’intérêt légitime est le meilleur modèle).
2. Restez déconnecté. Pages publiques uniquement. Dès que vous vous authentifiez, vous avez accepté un contrat : et les réclamations contractuelles sont celles qui l’emportent.
3. Respectez les signaux du site. robots.txt, limites de débit, crawl-delay. Ils ne sont pas toujours juridiquement contraignants, mais c’est la première chose qu’un tribunal ou un régulateur examinera.
4. Concevez avec retenue. Cadence à rythme humain, mise en cache pour éviter de récupérer à nouveau les mêmes données, aucun martèlement du site. C’est le volume qui transforme un litige de scraping en réclamation pour intrusion.
5. Surveillez la chaîne d’approvisionnement. Reddit v. Perplexity a nommé les fournisseurs de scraping, pas seulement l’acheteur d’IA. Sachez comment vos fournisseurs de données collectent les données.
6. Séparez la collecte de l’utilisation. Une collecte légale n’autorise pas tous les usages : republication, extraction de base de données et entraînement d’IA nécessitent chacun leur propre analyse.
7. Consultez un conseiller juridique avant de passer à l’échelle. Un pipeline acceptable à 1,000 requêtes/jour peut nécessiter un examen à 10 millions de requêtes/jour.
8. Choisissez une infrastructure proxy issue de sources éthiques. L’important n’est pas l’outil, mais son mode d’approvisionnement : les proxies sont légaux, mais le web scraping éthique s’étend aussi à la manière dont les IP sont obtenues. Des proxies résidentiels issus de sources éthiques et fondés sur le consentement permettent de rendre votre couche de collecte défendable si quelqu’un interroge votre chaîne d’approvisionnement.
FAQ
Le web scraping est-il légal ?
Le scraping de données publiquement accessibles et non personnelles est globalement légal dans la plupart des juridictions : l’arrêt du neuvième circuit hiQ v. LinkedIn (2022) a confirmé que le scraping de pages publiques ne constitue pas un ” accès non autorisé ” au sens du CFAA américain. Le risque se situe dans les détails : données personnelles (amendes au titre du RGPD allant jusqu’à €30.5M dans les affaires Clearview), scraping derrière des connexions en violation de conditions acceptées (ce qui a finalement fait perdre hiQ), contournement de barrières techniques et republication de contenus protégés par le droit d’auteur. Les données publiques de produits, de prix et de SERP collectées de manière respectueuse constituent le cas le plus défendable.
Le web scraping est-il légal aux États-Unis ?
En général, oui pour les données publiques : hiQ v. LinkedIn a établi que le scraping de pages publiques ne viole pas le CFAA, et Meta v. Bright Data (2024) a refusé de bloquer le scraping, sans connexion, de pages publiques Facebook/Instagram. Mais les réclamations contractuelles subsistent : hiQ a perdu pour violation des conditions de LinkedIn qu’il avait acceptées : et des volumes extrêmes exposent à des actions pour intrusion. Les lois étatiques sur la confidentialité (CCPA/CPRA) encadrent en plus les données personnelles.
Le web scraping est-il légal au regard du RGPD en Europe ?
Les données non personnelles (prix, annonces, classements) sont entièrement hors du champ du GDPR. Les données personnelles sont le domaine où l’Europe est stricte : l’AP néerlandaise qualifie le scraping de données personnelles de ” presque toujours une violation ” et a infligé à Clearview une amende de €30.5M ; le Garante italien lui a infligé €20M ; la CNIL française a infligé à KASPR une amende de €240K : toutes pour le scraping de données personnelles publiques. Les lignes directrices 2025 de la CNIL autorisent le scraping fondé sur l’intérêt légitime de données personnelles publiques uniquement avec des garanties documentées.
Puis-je scraper légalement Amazon, Google ou d’autres grandes plateformes ?
Collecter des données publiques de produits et de recherche sans connexion, à des cadences respectueuses, relève de la même catégorie défendable qu’ailleurs : c’est ainsi que fonctionnent les secteurs de l’intelligence tarifaire et du SEO. Les risques dépendent de chaque plateforme : ne vous connectez pas (conditions), ne collectez pas de données personnelles (avis avec l’identité des auteurs), ne surchargez pas les endpoints et connaissez la politique d’application de chaque plateforme. Nos guides par plateforme (Amazon, Google Maps, LinkedIn, Reddit) couvrent les cas et règles spécifiques.
Le scraping de données pour l’entraînement de l’IA est-il légal ?
La question n’est pas tranchée et se divise en deux volets. Collecte : les mêmes règles que pour tout scraping. Entraînement : Bartz v. Anthropic (2025) a jugé que l’entraînement sur des livres obtenus légalement relevait d’un usage équitable transformateur, mais a exclu les sources piratées ; NYT v. OpenAI teste si la ” régurgitation ” en sortie fait échouer l’usage équitable ; les poursuites de Reddit fondées sur le contrat contre Anthropic et Perplexity (avec ses fournisseurs de scraping) ont survécu aux premières étapes procédurales. Les données sous licence et les chaînes d’approvisionnement propres deviennent la zone de sécurité.
Les proxies sont-ils légaux à utiliser ?
Oui : les proxies sont une infrastructure réseau standard, légale pratiquement partout. C’est l’activité menée via le proxy qui est réglementée : un scraping légal reste légal via un proxy, une collecte illégale reste illégale. Choisissez des fournisseurs disposant de pools résidentiels sourcés de manière éthique et fondés sur le consentement ; depuis que Reddit v. Perplexity a désigné des fournisseurs de scraping comme défendeurs, la provenance de votre infrastructure de collecte fait partie de votre dossier de conformité.
Le non-respect de robots.txt rend-il le scraping illégal ?
robots.txt n’est pas une loi, et l’ignorer n’est pas automatiquement illégal. Mais les tribunaux et les régulateurs le considèrent comme un indicateur de bonne ou de mauvaise foi, plusieurs décisions le citent lorsqu’elles évaluent les réclamations pour intrusion et violation contractuelle, et les garanties attendues par la CNIL supposent que vous respectiez les opt-outs. En pratique : respecter robots.txt coûte peu et renforce nettement votre défendabilité.
Que s’est-il passé dans hiQ v. LinkedIn, en un paragraphe ?
hiQ scrapait des profils LinkedIn publics pour des analyses RH ; LinkedIn a envoyé une mise en demeure ; hiQ a intenté une action et a remporté la question principale : le neuvième circuit a jugé (2022) que le scraping de pages publiques n’est pas une violation du CFAA. Puis LinkedIn a gagné la guerre : le tribunal a estimé que hiQ avait violé le User Agreement qu’il avait accepté, et l’affaire s’est terminée par un jugement de consentement. La double leçon : le scraping public n’est pas du piratage, mais les contrats que vous acceptez sont opposables.
Résumé
Alors, le web scraping est-il légal ? Le scraping de données publiques et non personnelles est largement légal et défendable : les trois principaux risques sont les données personnelles (le RGPD et ses équivalents dans le monde), l’accès contraire aux conditions acceptées (les réclamations contractuelles qui ont prévalu sur hiQ et qui alimentent désormais les actions en justice de l’ère de l’IA), et le droit d’auteur sur les contenus créatifs. Restez déconnecté, collectez des données non personnelles, respectez robots.txt et séparez la collecte de l’utilisation. En 2026, la chaîne d’approvisionnement fait aussi partie de la conformité : la provenance de vos données : et de vos proxies : fait désormais partie du cadre juridique. Pour l’aspect infrastructure, consultez meilleurs proxies pour le web scraping. Ceci reste une information générale, et non un avis juridique : demandez un avis juridique pour votre cas spécifique.
Dernière mise à jour : 24 juin 2026.