
اس مضمون میں
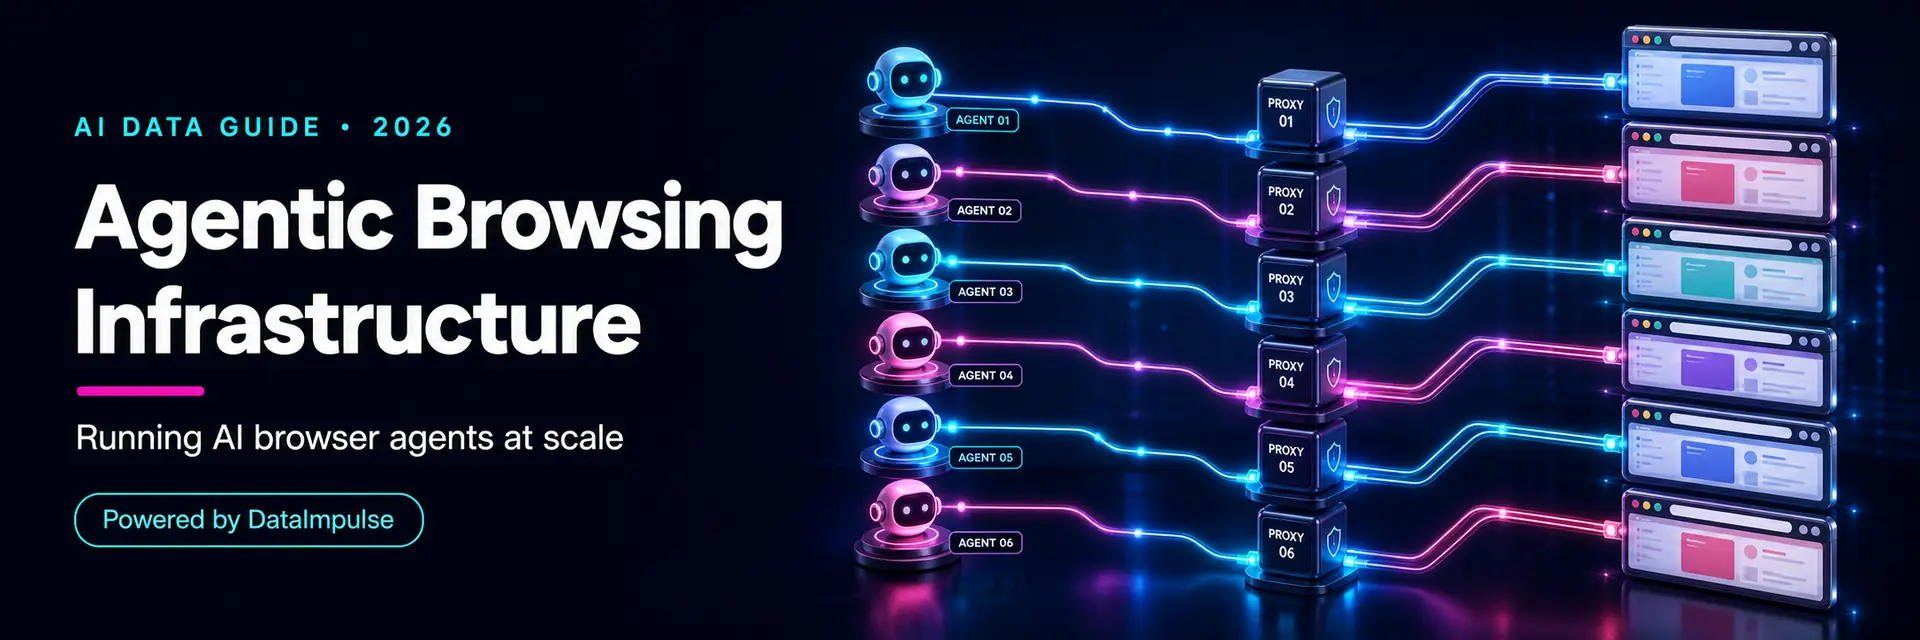
ایجنٹک براؤزنگ انفراسٹرکچر وہ اسٹیک ہے جو AI ایجنٹس کو بڑے پیمانے پر ویب براؤز کرنے اور اس پر کارروائی کرنے کے قابل بناتا ہے۔ بات صرف اسسٹنٹ کے ایک صفحہ کھولنے کی نہیں، بلکہ ایسے ایجنٹوں کے بیڑے کی ہے جو لائیو ویب پر قابل اعتماد طریقے سے راستہ ڈھونڈتے، پڑھتے اور کام مکمل کرتے ہیں۔ جیسے جیسے AI جواب دینے سے آگے بڑھ کر کام انجام دینے لگتا ہے، سوال “ایک ایجنٹ براؤزر استعمال کر سکتا ہے” سے بدل کر “ایک نظام بہت سے براؤزر ایجنٹس کو بلاک ہوئے بغیر کیسے چلاتا ہے” بن جاتا ہے۔ یہ گائیڈ ایجنٹک براؤزنگ انفراسٹرکچر کی تعریف کرتی ہے، اس کی تہوں کو واضح کرتی ہے، اور بتاتی ہے کہ رسائی کی تہہ، یعنی ہر ایجنٹ کی الگ شناخت کے ساتھ پراکسیز، بنیادی کیوں ہیں۔
میں Andrii Byzov ہوں، ایک AI-Native Fractional CMO جو ایجنٹ اور ویب ڈیٹا سسٹمز بناتا ہے۔ آگے ایک سادہ تعریف، عام براؤزنگ سے فرق، اجزا، بیڑے کی سطح پر بلاکنگ کا مسئلہ، اور یہ کہ پراکسیز کہاں کام آتی ہیں۔ یہ AI کے لیے ویب ڈیٹا انفراسٹرکچر کا حصہ ہے۔
اہم حقائق
- ایجنٹک براؤزنگ انفراسٹرکچر = بڑے پیمانے پر AI براؤزر ایجنٹس چلانے کا اسٹیک، جس میں آرکیسٹریشن، براؤزر آٹومیشن، رسائی، اور سیشن مینجمنٹ شامل ہیں۔
- یہ ایک براؤزر کا نہیں، پورے بیڑے کا مسئلہ ہے۔ بہت سے ایجنٹس، بہت سے کام، بہت سی مارکیٹس، سب ایک ہی وقت میں۔
- بلاکنگ اصل رکاوٹ ہے۔ ایک IP سے بار بار صفحات لانے اور کارروائی کرنے والے ایجنٹس جلد ہی rate-limited اور flagged ہو جاتے ہیں۔
- ہر ایجنٹ کی شناخت اہم ہے۔ ہر ایجنٹ کو ایک الگ حقیقی صارف جیسا دکھنا چاہیے، نہ کہ ایک IP جیسا جو ہزاروں درخواستیں بھیج رہا ہو۔
- ہر سیشن کی شناخت کے ساتھ رہائشی پراکسیز رسائی کی تہہ ہیں، جو بیڑے کو قابل رسائی اور ایک دوسرے سے ممتاز رکھتی ہیں۔
ایجنٹک براؤزنگ انفراسٹرکچر کیا ہے؟
یہ ان تمام چیزوں کا مجموعہ ہے جو ایسے AI ایجنٹس چلانے کے لیے درکار ہوتی ہیں جو ویب کو قابل اعتماد انداز میں اور بڑے پیمانے پر براؤز کرتے اور اس پر کارروائی کرتے ہیں۔ ایک AI براؤزر ایک پروڈکٹ ہے؛ ایجنٹک براؤزنگ انفراسٹرکچر وہ بنیاد ہے جو کسی ٹیم کو تحقیق، نگرانی، خریداری، ٹیسٹنگ، اور آٹومیشن کے لیے بہت سے ایجنٹس چلانے دیتی ہے، اس طرح کہ ہر ایجنٹ بلاکس، جغرافیائی دیواروں، یا شناختی نظاموں میں نہ اٹک جائے۔ یہ ایجنٹ کی منطق، یعنی وہ ماڈل جو فیصلہ کرتا ہے کہ کیا کرنا ہے، کے نیچے اور خام ویب کے اوپر موجود ہوتی ہے، اور “ایک ایجنٹ یہ صفحہ کھول سکتا ہے” کو “ایجنٹس کا ایک بیڑا مختلف مارکیٹس میں یہ کام ہزاروں بار کر سکتا ہے” میں بدل دیتی ہے۔
یہ عام براؤزنگ سے کیسے مختلف ہے
- پیمانہ۔ ایک شخص باری باری براؤز کرتا ہے؛ ایجنٹس کا بیڑا مسلسل متوازی طور پر براؤز کرتا ہے۔
- شناختی دباؤ۔ سائٹس ایک انسان کو عموماً برداشت کر لیتی ہیں؛ لیکن وہ ایک ہی ذریعے سے آنے والے بہت سے خودکار سیشنز کے خلاف فعال دفاع کرتی ہیں۔
- شناخت۔ ہر ایجنٹ کو ایک الگ صارف جیسا نظر آنا چاہیے؛ مشترک IPs پورے بیڑے کو ایک ہی bot جیسا بنا دیتے ہیں۔
- جغرافیہ۔ ایجنٹس کو اکثر مخصوص مارکیٹس سے کام کرنا ہوتا ہے، اس لیے مقام بھی انفراسٹرکچر کا حصہ ہے۔
اجزا
آرکیسٹریشن۔ متعدد ایجنٹس، دوبارہ کوششوں، اور task queues کی شیڈولنگ اور ہم آہنگی۔
براؤزر آٹومیشن۔ headless براؤزرز یا آٹومیشن فریم ورکس جنہیں ایجنٹس نیویگیشن اور کارروائی کے لیے استعمال کرتے ہیں (دیکھیں AI براؤزر ایجنٹس چلانا)۔
رسائی کی تہہ۔ بلاک ہوئے بغیر درست مقام سے صفحات تک پہنچنا، یعنی پراکسیز۔ بڑے پیمانے پر عموماً یہی بنیادی حد بن جاتی ہے۔
سیشن اور شناخت۔ ہر ایجنٹ کو ایک الگ، مستقل صارف کے طور پر برقرار رکھنا، اس کے اپنے IP سیشن کے ساتھ، تاکہ رویہ مربوط بھی رہے اور دوسروں سے جدا بھی۔
بیڑے کی سطح پر بلاکنگ کا مسئلہ
سادہ ایجنٹ بیڑوں کو عموماً ماڈل نہیں توڑتا، بلکہ بلاک ہونا توڑتا ہے۔ ایک IP range سے دس یا ہزار ایجنٹس چلائیں تو target sites کو ایک ہی source سے خودکار ٹریفک کا سیلاب دکھائی دیتا ہے: rate limits، CAPTCHAs، bot walls، اور bans تیزی سے آ جاتے ہیں۔ اس سے دو ضروریات پیدا ہوتی ہیں: منفرد شناخت، تاکہ ہر ایجنٹ اپنے صارف جیسا نظر آئے، اور جغرافیائی طور پر درست رسائی، تاکہ ایجنٹس انہی مارکیٹس سے کام کریں جن کی انہیں ضرورت ہے۔ یہ حل ہو جائیں تو IP-level bottleneck کم ہو جاتا ہے؛ اگرچہ fingerprinting، CAPTCHAs، auth، اور rate limits پھر بھی انفرادی کاموں کو روک سکتے ہیں۔ انہیں نظر انداز کریں تو بیڑا سب سے پہلے بلاکس کے اندر بیٹھ جاتا ہے۔
# Give each agent in the fleet its own proxy session so it looks like a
# distinct real user (the ;sid keeps an agent on the same exit IP for the
# session; the exit can change if that residential peer drops).
def proxy_for_agent(agent_id, country="us"):
return (f"http://LOGIN__cr.{country};sid.agent{agent_id}:"
f"[email protected]:823")
# e.g. launch each browser-automation worker with its own session
for agent_id in range(10):
proxy = proxy_for_agent(agent_id)
# browser.launch(proxy=proxy) -> each agent = a separate apparent user
پراکسیز کہاں کام آتی ہیں
رسائی اور شناخت کی تہیں وہ جگہ ہیں جہاں پراکسیز کام کرتی ہیں، اور بیڑے کی سطح پر یہ بنیادی حیثیت رکھتی ہیں۔ Residential proxies ہر ایجنٹ کو ایک حقیقی صارف IP کے ذریعے route کرتی ہیں، اور ہر سیشن کی شناخت (ایک sid) ہر ایجنٹ کو سیشن کے دوران اس کے اپنے exit IP پر برقرار رکھتی ہے۔ اس طرح وہ کسی swarm کا حصہ لگنے کے بجائے ایک الگ، مستقل صارف کے طور پر نظر آتا ہے (اگر وہ residential peer drop ہو جائے تو exit تبدیل ہو سکتا ہے)۔ زیادہ concurrency کے ساتھ rotating residential pools کئی ایجنٹس کو درست مارکیٹس سے متوازی طور پر چلنے دیتے ہیں۔ DataImpulse residential 195+ مقامات پر $1/GB سے (mobile $2/GB سے)، بیڑوں کے لیے high concurrency کے ساتھ دستیاب ہے۔ پراکسیز رسائی اور شناخت سنبھالتی ہیں؛ آپ کی آرکیسٹریشن ایجنٹس کو سنبھالتی ہے۔ یہ ہر دفاع کو ناکام نہیں بناتیں، کیونکہ سائٹس اب بھی CAPTCHAs اور behavioral detection استعمال کرتی ہیں، لیکن یہ IP-level bottleneck ختم کر دیتی ہیں جو سب سے پہلے بیڑوں کو روک دیتا ہے۔
کیا بڑے پیمانے پر ایجنٹک براؤزنگ چلانا قانونی ہے؟
براؤزر ایجنٹس چلانا کسی بھی خودکار ویب رسائی جیسے ہی قواعد کے تابع ہے، اور بڑے پیمانے پر استعمال قانونی، پرائیویسی، معاہداتی، اور anti-circumvention خطرات بڑھا سکتا ہے، چاہے رسائی کا طریقہ بظاہر ایک جیسا ہو۔ اسے قابل دفاع رکھیں: ہر سائٹ کی شرائط کا احترام کریں اور robots.txt کو پالیسی سگنل سمجھیں، لاگ اِنز، paywalls، یا access controls کو بائی پاس نہ کریں، درخواستیں بے تحاشا بھیجنے کے بجائے مناسب رفتار سے چلائیں، اور عوامی، غیر ذاتی ڈیٹا تک محدود رہیں۔ اجازت یافتہ آٹومیشن کے لیے پراکسیز کا استعمال عموماً قانونی ہوتا ہے، لیکن bans، access controls، یا contractual limits سے بچنے کے لیے ان کا استعمال قانونی اور اکاؤنٹ رسک پیدا کرتا ہے۔ قانونی راستہ عوامی کاموں کی حقیقی آٹومیشن ہے، circumvention نہیں۔ دیکھیں کیا ویب اسکریپنگ قانونی ہے۔ یہ عمومی معلومات ہیں، قانونی مشورہ نہیں۔
اکثر پوچھے جانے والے سوالات
ایجنٹک براؤزنگ انفراسٹرکچر کیا ہے؟
یہ وہ اسٹیک ہے جو AI ایجنٹس کو بڑے پیمانے پر ویب براؤز کرنے اور اس پر کارروائی کرنے کے قابل بناتا ہے: آرکیسٹریشن، براؤزر آٹومیشن، رسائی کی تہہ (پراکسیز)، اور سیشن/شناخت مینجمنٹ۔ یہ ایجنٹ کی فیصلہ سازی والی منطق کے نیچے اور خام ویب کے اوپر موجود ہوتا ہے، اور “ایک ایجنٹ صفحہ کھول سکتا ہے” کو “ایجنٹس کا ایک بیڑا مختلف مارکیٹس میں قابل اعتماد طریقے سے یہ کام کر سکتا ہے” میں بدل دیتا ہے۔
یہ ایک واحد AI براؤزر سے کیسے مختلف ہے؟
ایک واحد AI براؤزر ایک پروڈکٹ ہے جسے ایک شخص استعمال کرتا ہے؛ ایجنٹک براؤزنگ انفراسٹرکچر بہت سے ایجنٹس کو متوازی طور پر چلاتا ہے۔ اس سے بیڑے سے متعلق مسائل پیدا ہوتے ہیں: شناختی دباؤ، ہر ایجنٹ کی الگ شناخت، اور جغرافیہ۔ ایک واحد براؤزر کو عموماً ان کا سامنا نہیں ہوتا۔ مشکل حصہ ایک براؤزر چلانا نہیں، بلکہ پورے بیڑے کو قابل رسائی اور الگ الگ رکھنا ہے۔
ایجنٹ بیڑے بلاک کیوں ہو جاتے ہیں؟
کیونکہ ایک IP range سے آنے والے بہت سے خودکار سیشنز ایک ہی bot جیسے دکھائی دیتے ہیں۔ سائٹس ایک انسان کو برداشت کر لیتی ہیں، مگر اسی source سے آنے والی خودکار ٹریفک کے سیلاب کے خلاف rate limits، CAPTCHAs، اور bans کے ذریعے فعال دفاع کرتی ہیں۔ ہر ایجنٹ کی جدا شناخت اور جغرافیائی طور پر درست رسائی کے بغیر، بیڑا ان defenses کو جلد trigger کر دیتا ہے۔
ایجنٹک براؤزنگ میں پراکسیز کہاں کام آتی ہیں؟
یہ رسائی اور شناخت کی تہہ ہیں۔ Residential proxies ہر ایجنٹ کو ایک حقیقی consumer IP کے ذریعے route کرتی ہیں، اور ہر سیشن کی شناخت ہر ایجنٹ کو اس کے اپنے exit IP پر رکھتی ہے تاکہ وہ ایک الگ صارف کے طور پر نظر آئے۔ high concurrency کے ساتھ rotating pools بہت سے ایجنٹس کو درست مارکیٹس سے متوازی طور پر چلنے دیتے ہیں، اور وہ IP-level bottleneck ختم کرتے ہیں جو بیڑوں کو سب سے پہلے روک دیتا ہے۔
کیا براؤزر ایجنٹس کو scale پر چلانا قانونی ہے؟
یہ انہی قواعد کے تابع ہے جو کسی بھی خودکار ویب رسائی پر لاگو ہوتے ہیں۔ site terms اور robots.txt کا احترام کریں، logins یا access controls کو bypass نہ کریں، requests کو مناسب رفتار پر رکھیں، اور public، non-personal data تک محدود رہیں۔ اجازت یافتہ آٹومیشن کے لیے پراکسیز استعمال کرنا عموماً قانونی ہے؛ bans یا access controls سے بچنے کے لیے ان کا استعمال قانونی اور اکاؤنٹ رسک پیدا کرتا ہے۔ یہ قانونی مشورہ نہیں۔
نتیجہ
ایجنٹک براؤزنگ انفراسٹرکچر ہی “ایک ایسا ایجنٹ جو براؤزر استعمال کر سکتا ہے” کو ایک ایسے بیڑے میں بدلتا ہے جو واقعی کام کرتا ہے، اور اس کی بنیادی حد ذہانت نہیں بلکہ رسائی ہے۔ متوازی طور پر کام کرنے والے بہت سے ایجنٹس اس وقت تک بلاک ہوتے رہتے ہیں جب تک ہر ایک درست مارکیٹ سے ایک الگ صارف جیسا نظر نہ آئے، اور یہی پراکسی اور شناخت کی تہہ کا کام ہے۔ اپنی آرکیسٹریشن اور ایجنٹ لاجک بنائیں؛ ہر سیشن کی شناخت اور زیادہ concurrency کے ساتھ residential-proxy access layer کرائے پر لیں۔ اجزا دریافت کریں: AI براؤزر ایجنٹس چلانا، OpenAI Operator کے لیے پراکسی، اور AI کے لیے ویب ڈیٹا انفراسٹرکچر۔
آخری اپ ڈیٹ: June 28, 2026.