
W tym artykule
Curl impersonate oznacza użycie curl-impersonate do naśladowania zachowania przeglądarki na poziomie TLS i HTTP/2 podczas wysyłania żądań HTTP. Dokumentacja oryginalnego projektu opisuje zmiany w warstwie transportowej, które stoją za tym podejściem. Sama zmiana nagłówka User-Agent ich nie odtwarza.
Zacznij od sprawdzenia odcisku (fingerprint), a potem przeanalizuj faktyczną treść odpowiedzi. Nasz szybki test z 16 października 2026 pokazał użyteczne różnice między zwykłymi klientami a żądaniami z impersonacją, a jednocześnie strony produktów nadal zwracały wyzwania. To mała próbka, a nie benchmark ani obietnica dostępu.
Najważniejsze fakty
- Python requests i systemowy curl pokazały w naszym teście ten sam odcisk OpenSSL JA3.
- curl_cffi z impersonate=”chrome” oraz curl_chrome136 dokładnie odpowiadały odciskom JA4 i HTTP/2 prawdziwego Chromium 145.
- Przez ten sam residential proxy i z tym samym User-Agent zwykły curl został przekierowany na stronę blokady Walmart, a curl_chrome136 dostał pełną stronę.
- JA3 zmienia się między wersjami Chrome, ponieważ Chrome losowo zmienia kolejność rozszerzeń TLS. JA4 jest bardziej stabilnym sygnałem.
- Impersonacja naprawia odciski TLS i HTTP/2, ale nie wyzwania JavaScript ani behawioralne.
- curl-impersonate v2.2.3 zawiera gotowe pliki binarne, takie jak curl_chrome136 i curl_firefox147.
Czym jest curl impersonate i co dokładnie naśladuje?
curl-impersonate to zmodyfikowana wersja curl, która odtwarza zachowanie połączenia typowe dla przeglądarki. Obejmuje uzgadnianie TLS i ustawienia HTTP/2, a nie pełne środowisko wykonawcze przeglądarki.
Oryginalny projekt znajduje się pod kontem lwthiker, a testowany przez nas plik binarny pochodził z forka lexiforest. Dokumentacja projektu forka wskazuje, że opiera się on na spatchowanym BoringSSL. Zapisuj razem repozytorium, wydanie i wybrany profil, bo sama znajoma nazwa pliku wykonywalnego nie wystarcza jako dowód pochodzenia.
Potraktuj impersonację jako wybór tego, jak połączenie się przedstawia. Nagłówki opisują żądanie HTTP, a ustawienia transportowe opisują inną część klienta. Żadne z nich nie dowodzi, że żądanie wysłał człowiek. Dopasowanie wybranych odcisków nie oznacza pełnej równoważności z przeglądarką.
W przypadku curl impersonate najpierw ustal, czy potrzebne dane są już w odpowiedzi HTTP. Nasza udana odpowiedź wyszukiwania zawierała osadzony JSON z produktami, a inne testowane strony nadal pokazywały wyzwania. Szerszy przewodnik o odciskach TLS dodaje kontekstu, ale decyzje implementacyjne powinny wynikać z analizy odpowiedzi.
Jak zainstalować curl impersonate i wysłać pierwsze żądanie?
Wybierz wydanie i artefakt dla swojej platformy, a potem uruchom jego wrapper przeglądarki na endpoincie z odciskiem. Nasza testowa konfiguracja na Linuksie używała lexiforest v2.2.3 i wrappera curl_chrome136.
Krok 1: Otwórz oficjalne wydanie v2.2.3, wybierz artefakt dla Linuksa zgodny z Twoją architekturą i rozpakuj go. Wymagania dotyczące środowiska uruchomieniowego i certyfikatów CA znajdziesz w dokumentacji instalacji.
Krok 2: Trzymaj wrapper i pliki pomocnicze razem. Nasze środowisko to Linux z Ubuntu OpenSSL 3.0.13. Plik z impersonacją przedstawiał się jako curl 8.22.0-IMPERSONATE z BoringSSL. To rozróżnienie ma znaczenie przy porównywaniu z systemowym curl.
Krok 3: W rozpakowanym katalogu uruchom dokładnie to polecenie sprawdzające odcisk, którego użyliśmy w naszej próbce:
# Linux x86_64, prebuilt binaries (v2.2.3 of the maintained lexiforest fork)
curl -sLO https://github.com/lexiforest/curl-impersonate/releases/download/v2.2.3/curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
tar xzf curl-impersonate-v2.2.3.x86_64-linux-gnu.tar.gz
./curl_chrome136 -s https://tls.peet.ws/api/all            # see the fingerprint the server gets

# Through a proxy: curl-impersonate takes the usual curl flags
./curl_chrome136 -s -x "http://USER:[email protected]:823" \
  -o page.html -w "%{http_code} %{size_download}
" "https://www.walmart.com/search?q=air+fryer"
Zapisz zwrócone JA4, wersję HTTP i odcisk HTTP/2, zanim zaczniesz testować endpoint aplikacji. W ten sposób powstaje punkt odniesienia dla warstwy transportowej, bez traktowania odpowiedzi sklepu jako testu odcisku.
Na Windows lub macOS użyj artefaktów dla danej platformy i dróg instalacji opisanych przez fork. Jego strona z bindingami kieruje do integracji dla Pythona, JavaScript/TypeScript, PHP i Rusta. Każdy pakiet Nixpkgs lub wrapper Node sprawdź pod kątem faktycznego upstreamu i wydania. Nasze dowody instalacji dotyczą wyłącznie Linuksa.
Jak udawać Chrome w Pythonie za pomocą curl_cffi?
Użyj curl_cffi z parametrem impersonate i przypnij wersję pakietu, aby wyniki były powtarzalne. Nasza implementacja w Pythonie używała curl_cffi 0.15 z impersonate=”chrome”.
Oficjalny quick start opisuje instalację przez pip, profile przeglądarek i interfejs podobny do requests. Zainstaluj wersję 0.15 w izolowanym środowisku, aby odtworzyć nasz wybór pakietu. Ogólny alias chrome wskazuje aktualny cel Chrome w bibliotece, więc po aktualizacji jego znaczenie może się zmienić.
Zanim uruchomisz ten przetestowany fragment, zdefiniuj url jako publiczny adres wyszukiwania https://www.walmart.com/search?q=air+fryer, a PROXY jako własny adres proxy, wczytany prywatnie ze zmiennych środowiskowych. Fragment zależy od tych dwóch zmiennych:
import os
from curl_cffi import requests

PROXY = os.environ.get("PROXY_URL")  # e.g. http://USER__cr.us:[email protected]:823
PROXIES = {"http": PROXY, "https": PROXY} if PROXY else None

# 1. What fingerprint does the server see?
fp = requests.get("https://tls.peet.ws/api/all", impersonate="chrome", timeout=30).json()
print("JA4:", fp["tls"]["ja4"], "| HTTP:", fp["http_version"])

# 2. Same request a browser would make, through a proxy, with a session that keeps cookies
with requests.Session(impersonate="chrome", proxies=PROXIES, timeout=90) as s:
    try:
        r = s.get("https://www.walmart.com/search?q=air+fryer")
    except requests.exceptions.RequestException as exc:   # slow exits happen; retry with a new IP
        raise SystemExit(f"request failed: {exc.__class__.__name__}")
    blocked = "Robot or human" in r.text or "/blocked" in r.url
    print(r.status_code, len(r.content) // 1024, "KB,", "challenge" if blocked else "content",
          "| __NEXT_DATA__ present:", "__NEXT_DATA__" in r.text)
Zanim wyodrębnisz rekordy, sprawdź status odpowiedzi i kod HTML. W naszej udanej odpowiedzi wyszukiwania z CLI źródłem danych był osadzony JSON produktów w __NEXT_DATA__. Znajdź ten element script za pomocą parsera HTML, zdekoduj jego JSON i zweryfikuj oczekiwane pola, zanim uznasz stronę za użyteczną.
Quick start opisuje Session jako sposób na zachowanie cookies i ponowne użycie połączeń. W przepływie z wieloma żądaniami utrzymuj spójność sesji, profilu i docelowej lokalizacji wyjścia. Nie łącz profilu z dowolnymi nagłówkami wersji przeglądarki skopiowanymi z niepowiązanego komputera.
Uwierzytelnianie w proxy i uwierzytelnianie w usłudze docelowej to dwie osobne sprawy. Używaj wyłącznie danych dostępowych wydanych dla Twojej własnej, autoryzowanej usługi. Ten przykład z publiczną stroną nie wymaga logowania w miejscu docelowym. Nasz przewodnik o przekładaniu curl na Pythona omawia przenoszenie struktury żądania.
Czym różnią się odciski JA3 i JA4?
JA3 zachowuje kolejność w wybranych polach ClientHello, a JA4 normalizuje wybrane listy przed haszowaniem. Dzięki temu JA4 jest użyteczny, gdy kolejność rozszerzeń się zmienia, ale nie jest pełną tożsamością klienta.
Specyfikacja JA3 od Salesforce opisuje odcisk zbudowany z wersji TLS, szyfrów, rozszerzeń, obsługiwanych grup i formatów punktów. Specyfikacja JA4 od FoxIO sortuje szyfry i rozszerzenia, ale zachowuje kolejność algorytmów podpisu. Nie opisuj JA4 jako ignorującego każdą różnicę w kolejności.
W naszej próbce curl_cffi chrome i Playwright Chromium 145.0.7632.6 miały wspólny JA4 t13d1516h2_8daaf6152771_d8a2da3f94cd oraz odcisk HTTP/2 52d84b11737d980aef856699f885ca86. Ich wartości JA3 się różniły. Wrapper curl_chrome136 dawał te same wartości JA4 i HTTP/2.
Są to dopasowania zaobserwowane przez serwer na endpoincie pomiarowym, a nie dowód, że każdy bajt uzgadniania lub zachowanie aplikacji były zgodne. Testuj przez docelową trasę sieciową i porównuj obie warstwy transportowe. W systemach, które sam prowadzisz, analizuj dowody po stronie serwera. Dokumentacja odcisków Cloudflare wyjaśnia, jak używać tych sygnałów w analizie ruchu i regułach.
Jak skonfigurować proxy HTTP, HTTPS i SOCKS?
Ustaw proxy niezależnie od profilu przeglądarki. Schemat adresu docelowego i schemat proxy opisują różne połączenia, więc cel HTTPS może korzystać z proxy HTTP.
W kodzie Pythona klucz https w słowniku wybiera cele HTTPS, a wartość wskazuje endpoint proxy. Quick start curl_cffi zawiera przykłady proxy HTTP i SOCKS. Nasza zmierzona trasa używała proxy HTTP z uwierzytelnianiem.
Dokumentacja curl o proxy HTTP wyjaśnia tunelowanie CONNECT dla celów HTTPS. Bez przechwytywania TLS tunel przenosi zaszyfrowaną wymianę klienta, zachowując jego nagłówki kierowane do celu i uzgadnianie TLS. Proxy HTTPS dodatkowo szyfruje połączenie klienta z proxy. Obsługiwane schematy i ustawienia uwierzytelniania znajdziesz w oficjalnej dokumentacji opcji proxy.
Trzymaj sekrety proxy poza wspólnymi skryptami i danymi diagnostycznymi. Najpierw niezależnie sprawdź endpoint, protokół, port i uwierzytelnianie, a dopiero potem porównuj odpowiedzi aplikacji. Błąd połączenia z proxy to inny dowód niż pomyślnie pobrana strona z wyzwaniem.
W przypadku sekwencji ze stanem w trakcie diagnozy lepiej użyć stabilnego wyjścia. Rotację rozważ dla niezależnych, autoryzowanych żądań dopiero po ustaleniu działającego punktu odniesienia. Jednoczesna zmiana IP i profilu transportowego utrudnia wyjaśnienie wyniku.
Nasz przewodnik po konfiguracji proxy w curl omawia ustawienia, a wybór proxy dla curl pomaga ocenić wymagania wobec trasy. Ani wybór trasy, ani impersonacja nie gwarantują akceptacji.
Dlaczego curl nadal jest blokowany, gdy przeglądarka działa?
Przeglądarka i klient HTTP mogą się różnić na kilku warstwach, nawet gdy żądają tego samego adresu URL. Zanim zmienisz narzędzia, użyj 4-warstwowego modelu diagnozy żądań, aby wyodrębnić różnicę.
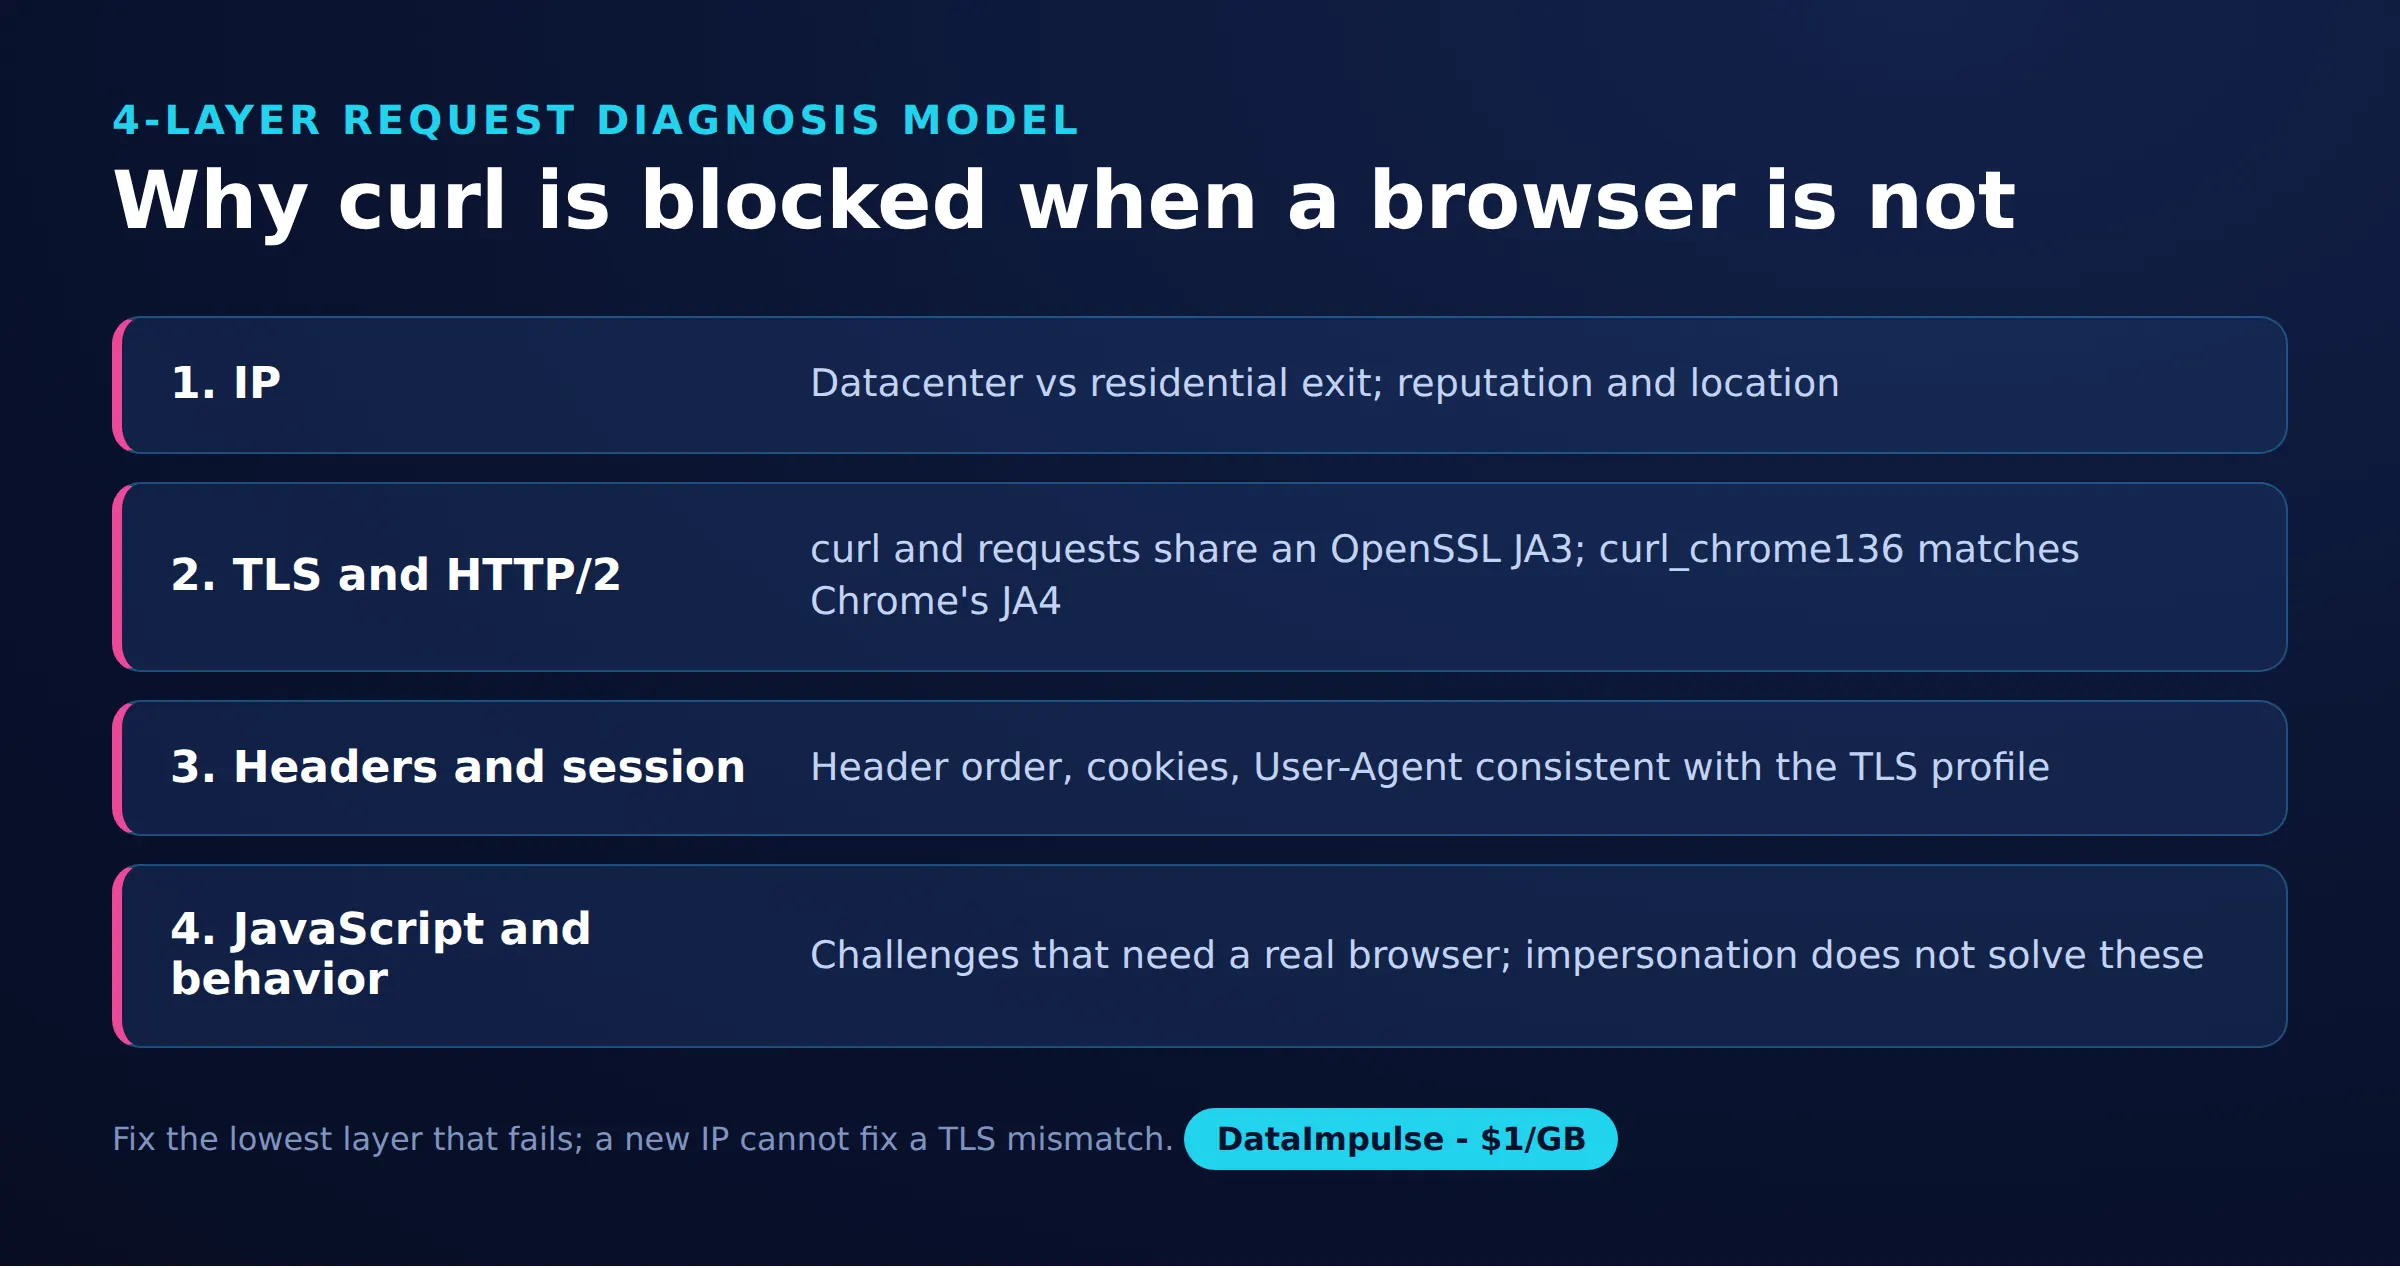
- Warstwa 1: IP i trasa. Utrzymaj stałego klienta, porównując dostęp bezpośredni i przez proxy. Zapisz kraj, stabilność wyjścia oraz to, czy błąd występuje przed nadejściem odpowiedzi HTTP.
- Warstwa 2: TLS i HTTP/2. Utrzymaj stałą trasę, porównując zwykłe żądania i te z impersonacją. Sprawdź odciski zaobserwowane przez endpoint zamiast ufać ciągowi User-Agent.
- Warstwa 3: nagłówki i sesja. Porównaj przekierowania, cookies, żądany adres URL i oczekiwany format odpowiedzi. Sprawdź treść: poprawny status HTTP może towarzyszyć nieudanej odpowiedzi aplikacji.
- Warstwa 4: JavaScript i zachowanie. Ustal, czy dane pojawiają się dopiero po wykonaniu strony lub interakcji. Wyzwania na naszych stronach produktów pozostały nierozwiązane mimo impersonacji transportu.
Przy każdym porównaniu zapisuj status, cel przekierowania, typ treści, rozmiar odpowiedzi i znacznik zawartości. Dokumentacja curl o skryptowaniu HTTP wyjaśnia analizę odpowiedzi, przekierowania, cookies i szczegółową diagnostykę. Przed zachowaniem logów usuń z nich sekrety.
Nie traktuj każdej odmowy jako problemu z odciskiem. Błędny adres URL, brak stanu sesji lub reguła aplikacji mogą przetrwać zmianę transportu. We własnej usłudze zestawiaj obserwacje klienta z logami serwera. W przypadku usług zewnętrznych przestań wielokrotnie ponawiać żądania po wyzwaniach i ponownie oceń dozwoloną drogę dostępu.
Kiedy wybrać curl-impersonate zamiast Playwright lub Selenium?
Wybierz impersonację transportu, gdy odpowiedź HTTP zawiera wszystko, czego potrzebuje zadanie. Wybierz automatyzację przeglądarki, gdy kluczowe jest renderowanie lub interakcja, i zmierz jej koszt operacyjny w swoim obciążeniu.
| Klient | Używaj X, gdy… | Unikaj X, gdy… |
|---|---|---|
| Standardowy curl | Używaj standardowego curl, gdy wystarcza zwykły HTTP. | Unikaj standardowego curl, gdy ma znaczenie potwierdzona niezgodność odcisku. |
| curl-impersonate | Używaj curl-impersonate, gdy transport podobny do przeglądarki pasuje do zadania. | Unikaj curl-impersonate, gdy wymagane jest wykonanie JavaScript. |
| Playwright/Selenium | Używaj Playwright/Selenium, gdy kluczowe jest renderowanie lub interakcja. | Unikaj Playwright/Selenium, gdy prosty HTTP spełnia wymagania. |
Dokumentacja sieciowa Playwright opisuje obserwowanie żądań przeglądarki, a przegląd Selenium opisuje automatyzację przeglądarki. Przeglądarka wprowadza cykl życia strony i ładowanie zasobów. Nasz test nie mierzył ani CPU, ani opóźnienia, więc nie wykazuje przewagi w szybkości ani skalowaniu.
APIRequestContext w Playwright wysyła żądania API i może współdzielić cookies z kontekstem przeglądarki. Nie jest równoważny nawigowaniu po stronie w przeglądarce. Nie zakładaj, że współdzielenie cookies oznacza identyczne zachowanie transportu.
Automatyzacja przeglądarki także ma ograniczenia. Dokumentacja obsługiwanych środowisk Cloudflare wyłącza zautomatyzowane przeglądarki z obsługi rozwiązywania wyzwań produkcyjnych (stan na październik 2026). Zmiana narzędzia nie jest uniwersalnym rozwiązaniem problemu z wyzwaniami.
Co pokazał nasz mały test na publicznych stronach?
Nasz szybki test z 16 października 2026 pobrał treść wyszukiwania dzięki impersonacji, podczas gdy zwykłe żądania dostawały wyzwania. Błędy na stronach produktów pokazały granicę uogólniania tego sukcesu.
Metoda i próbka: Andrii porównał osiem konfiguracji klient/profil na endpoincie inspekcji TLS: requests 2.x, systemowy curl, cztery profile curl_cffi, Playwright Chromium i curl_chrome136. Próbka aplikacyjna obejmowała cztery kombinacje klienta Pythona i trasy oraz dwa wyniki wyszukiwania z CLI, a także eksploracyjne kontrole stron produktów. Są to zapisane obserwacje, a nie wskaźniki powodzenia z powtarzanych prób.
Endpoint z odciskiem to https://tls.peet.ws/api/all. Profile Pythona to chrome, chrome131, safari i firefox. Zwykłe requests i systemowy curl miały wspólny JA3 0149f47eabf9a20d0893e2a44e5a6323, przy czym requests używał HTTP/1.1, a systemowy curl h2. Już to pokazuje, dlaczego jeden hasz TLS nie opisuje całego połączenia.
| Klient Pythona | Trasa | Status | Zapisany rozmiar | Klasyfikacja treści |
|---|---|---|---|---|
| requests | Bezpośrednio | 200 | 15 KB | Wyzwanie PerimeterX |
| requests | Residential | 200 | 15 KB | Wyzwanie PerimeterX |
| curl_cffi chrome | Bezpośrednio | 200 | 1321 KB | Treść |
| curl_cffi chrome | Residential | 200 | 1392 KB | Treść |
Porównanie w CLI użyło tego samego residential proxy DataImpulse z USA i User-Agent Chrome. Zwykły curl dostał przekierowanie 307 na stronę blokady z napisem “Robot or human?”. Żądanie curl_chrome136 zwróciło 200, około 176 KB przesłanych w postaci skompresowanej oraz HTML zawierający JSON produktów w __NEXT_DATA__.
Strony produktów Walmart nadal blokowały curl_cffi wyzwaniem. Strona produktu Sephora zwróciła przez dostęp residential wyzwanie JavaScript/behawioralne Akamai. Te błędy nie pozwalają rozciągnąć wyniku ze strony wyszukiwania na ogólne twierdzenie o którejkolwiek z tych witryn.
Szacunek ruchu: Przy reklamowanej cenie początkowej residential 1 USD za GB 176 KB odpowiada około 0,000176 USD w jednostkach dziesiętnych. To ilustracyjny ruch odpowiedzi, a nie szacunek faktury: bajty żądań, ponowienia, zasady rozliczeń i inne transfery mogą zmienić sumę. Dla rozmiarów z Pythona nie ustalono tu równoważności z transferem skompresowanym, więc nie porównuj ich bezpośrednio z wartością z CLI.
Ta próbka nie zawiera rozkładu czasów, liczby powtórzonych żądań ani kontrolowanej izolacji każdej różnicy w nagłówkach. Uzasadnia badanie transportu, ale nie przypisywanie wszystkich różnic w odpowiedziach samemu TLS.
Aby powtórzyć tę próbkę, zapisz razem dokładne wersje pakietów, wybrany wrapper, trasę, klasyfikację odpowiedzi i jednostki pomiaru. Trzymaj osobne pola dla przesłanych bajtów i rozmiaru zdekodowanej treści. Powtórz porównania w kontrolowanych warunkach, zanim użyjesz ich do planowania wydajności, a zmianę szablonu strony lub odpowiedzi z wyzwaniem traktuj jako powód do ponownej weryfikacji parsera.
Jakie zgody i alternatywy warto sprawdzić?
Zanim zamienisz żądanie diagnostyczne w stałą automatyzację, upewnij się, że planowane zbieranie danych jest dozwolone. Publiczna dostępność nie jest wystarczającym dowodem zgody na każde zastosowanie.
Przejrzyj regulamin witryny, instrukcje robots, opublikowane zasady dostępu i obowiązujące zobowiązania. Zbieraj tylko to, co potrzebne, przestrzegaj podanych limitów i unikaj wielokrotnych ponowień wobec wyzwań. Nie używaj ponownie cudzych danych logowania i nie próbuj obchodzić CAPTCHA.
Zanim zaczniesz utrzymywać kruchą integrację ze stroną, sprawdź, czy istnieje oficjalne API, eksport, feed lub licencjonowany zbiór danych. Porównaj zakres pól, aktualność, wymagania uwierzytelniania i dozwolone ponowne wykorzystanie. Gdy dostęp jest niejasny, poszukaj zatwierdzonej drogi, zamiast zakładać, że udana odpowiedź rozstrzyga sprawę.
Najczęstsze pytania
Czym jest curl-impersonate?
To zmodyfikowana wersja curl, która ma odtwarzać uzgadnianie sieciowe podobne do przeglądarkowego. Używaj jej do badania różnic w transporcie, a faktycznie zwróconą treść weryfikuj osobno.
Dlaczego curl może zawieść, gdy przeglądarka działa?
Oba żądania mogą się różnić trasą, transportem, stanem sesji lub wykonaniem strony. W naszym teście HTTP 200 czasem zawierał wyzwanie, więc sam status był mylącym wskaźnikiem sukcesu.
Jak curl_cffi udaje Chrome?
Jego parametr impersonate wybiera profil transportowy przeglądarki. Nasze przetestowane wywołanie w Pythonie wybrało chrome. Dokumentując odtworzenie testu, zachowaj wersję pakietu razem z tym aliasem.
Czy curl-impersonate działa z proxy?
Nasze żądanie curl_chrome136 zadziałało przez uwierzytelnione residential proxy HTTP. Traktuj łączność z proxy i akceptację przez aplikację jako osobne kontrole, ponieważ działająca trasa nadal może zwrócić wyzwanie.
Kiedy zamiast tego użyć Playwright?
Wybierz przepływ z przeglądarką, gdy wymagany wynik zależy od wykonania strony lub interakcji. Najpierw upewnij się, że potrzebnych danych nie ma w początkowej odpowiedzi, i nie traktuj automatyzacji przeglądarki jako gwarantowanego dostępu.
Czy zgodność JA4 dowodzi, że żądanie pochodzi z przeglądarki?
Nie. Nasi klienci z impersonacją mieli wspólne wybrane odciski z Chromium, ale ta obserwacja nic nie mówi o pełnym zachowaniu przeglądarki ani o autoryzacji.
Przetestuj warstwę sieciową na jasnym punkcie odniesienia
Jeśli diagnoza wskazuje na trasę wyjścia, oceń residential proxy DataImpulse z tym samym klientem, profilem i kontrolami treści. DataImpulse dostarcza proxy, a nie API do scrapingu, zarządzanego odblokowywania, VPN ani danych. Zacznij od małej skali i zwiększaj ją dopiero po potwierdzeniu zarówno zgody, jak i użytecznych odpowiedzi.
Ostatnia aktualizacja: 16 października 2026.