
In this Article
Wenn du dynamische Webseiten scrapen willst, musst du mit Inhalten umgehen, die im HTML deiner ersten Anfrage nicht vorhanden sind. Moderne Websites erstellen Produktübersichten, Preise, Kommentare und Feeds mit JavaScript im Browser. Ein einfacher HTTP-Abruf liefert daher nur eine leere Hülle statt der benötigten Daten.
Dieser Leitfaden führt dich durch den gesamten Workflow in Python. Zunächst erkennst du dynamische Inhalte, indem du die Rohantwort mit dem gerenderten DOM vergleichst. Anschließend ordnet er die Extraktionsmethoden von günstig bis aufwendig ein: die versteckte JSON API finden, Playwright oder Selenium steuern, Infinite Scroll und Mehr-laden-Buttons behandeln, Proxy-Bandbreite senken, Wiederholungen hinzufügen, parallel scrapen sowie sauberes JSON und CSV exportieren.
DataImpulse ist ein ethischer Proxy-Anbieter mit mehr als 90 Mio. Residential-, Mobile- und Datacenter-IP-Adressen in 195 Ländern. Das nutzungsbasierte Modell beginnt bei 1 Dollar pro GB, der Traffic läuft nicht ab und wird für Web Scraping, Ad Verification, Preisüberwachung, Marktforschung und die Verwaltung mehrerer Konten eingesetzt.
Wichtige Fakten
- Dynamisches Scraping: Von JavaScript erzeugte Inhalte fehlen im Roh-HTML. Deshalb rufst du entweder die zugrunde liegende JSON API auf, die die Seite abruft, oder renderst die Seite in einem Headless-Browser.
- Bester Proxy-Typ: rotierende Residential Proxys, die echte IPs von Endnutzern verwenden und die Erkennung umgehen.
- Preis: ab 1 Dollar pro GB, nutzungsbasiert, mit nicht ablaufendem Traffic und ohne Abonnement.
- Abdeckung: 90 Mio.+ ethisch beschaffte IPs in 195 Ländern.
- Zuverlässigkeit: 99,51 % Erfolgsquote, mit 4,8 von 5 auf G2 bewertet.
- Protokolle und Targeting: HTTP, HTTPS und SOCKS5, einschließlich Länder-Targeting.
Was macht eine Webseite dynamisch?
Eine Seite ist dynamisch, wenn die relevanten Inhalte durch JavaScript im Browser erzeugt werden, statt in der ersten HTML-Antwort geliefert zu werden. Der Server sendet ein schlankes Grundgerüst, und clientseitiger Code ruft anschließend Daten ab und fügt sie nach dem Öffnen der Seite in das DOM ein.
Am schnellsten prüfst du dies manuell, indem du zwei Ansichten derselben Seite vergleichst. Klicke mit der rechten Maustaste und wähle Quelltext anzeigen, um das vom Server gelieferte Roh-HTML zu sehen. Öffne dann die Entwicklertools und prüfe das Elemente-Panel, das das aktuelle DOM nach der Ausführung der Skripte zeigt. Wenn der gewünschte Preis oder Eintrag im Elemente-Panel erscheint, aber in Quelltext anzeigen fehlt, ist der Inhalt dynamisch und eine einzelne Anfrage erfasst ihn nicht.
- Statische Inhalte sind in Quelltext anzeigen vorhanden und lassen sich direkt aus einer HTTP-Antwort parsen.
- Dynamische Inhalte erscheinen nur im gerenderten DOM und werden über Hintergrundanfragen geladen.
Du kannst diese Diagnose im Code automatisieren. Zähle zunächst die Zielelemente im Roh-HTML, das ein normaler HTTP-Client herunterlädt:
import requests
from bs4 import BeautifulSoup

url = "https://example.com/products"
headers = {"User-Agent": "Mozilla/5.0"}

resp = requests.get(url, headers=headers, timeout=30)
soup = BeautifulSoup(resp.text, "html.parser")

raw_cards = soup.select("div.product-card")
print("Cards in raw HTML:", len(raw_cards))

# If this prints 0 but the page clearly shows products in a browser,
# the content is injected by JavaScript and the page is dynamic.
Rendere anschließend dieselbe URL in einem Headless-Browser und zähle erneut. Der Unterschied zwischen den beiden Zahlen ist der Beleg:
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True)
    page = browser.new_page()
    page.goto("https://example.com/products", wait_until="networkidle")
    rendered_cards = page.query_selector_all("div.product-card")
    print("Cards after JavaScript runs:", len(rendered_cards))
    browser.close()

# Raw HTML 0, rendered DOM 48 means the page builds its content dynamically.
Bevor du einen vollständigen Scraper schreibst, solltest du außerdem prüfen, ob das Ziel automatisierten Zugriff erlaubt. Unser Leitfaden dazu, wie du prüfst, ob eine Website Scraping erlaubt erläutert das Lesen von robots-Regeln und Nutzungsbedingungen.
Welche Methode solltest du zum Scrapen dynamischer Seiten verwenden?
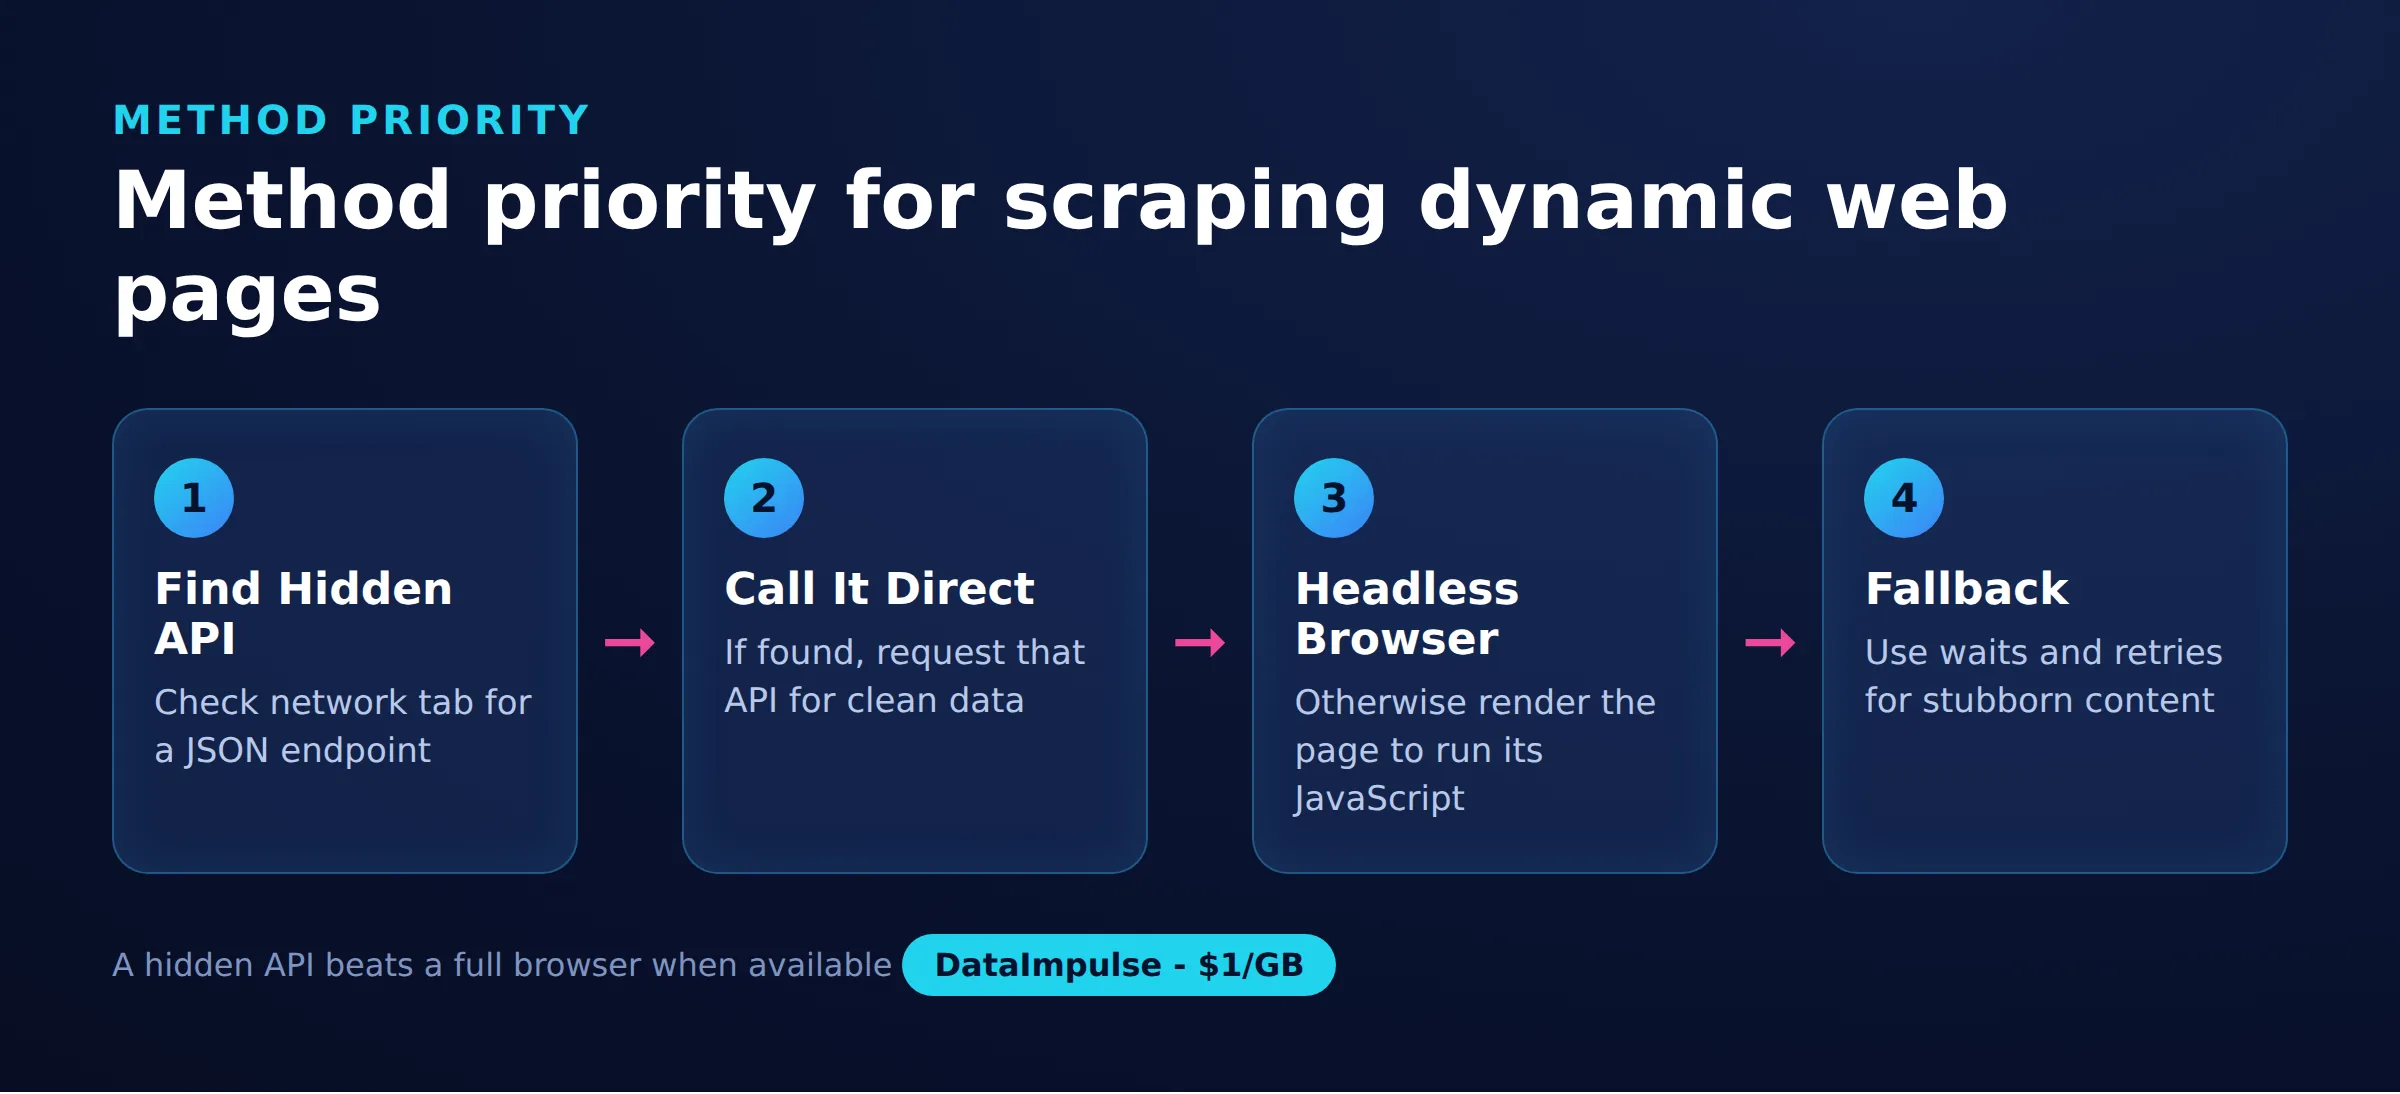
Wähle die leichteste Methode, die die Daten zuverlässig zurückgibt: Rufe eine versteckte JSON API auf, wenn es eine gibt, und nutze nur dann einen Headless-Browser, wenn es keine gibt. Jede Option wägt Geschwindigkeit und Kosten gegen den Umfang ab, in dem sie die Seite nachbilden kann.
Die folgende Tabelle vergleicht die vier gängigen Ansätze, damit du vor dem Schreiben von Code wählen kannst. In der Praxis kombinieren die meisten Projekte zwei davon: eine versteckte API für die Hauptmenge und einen Browser für Seiten, die sich dagegen sträuben.
| Method | Geschwindigkeit | Kosten | Am besten für | Wichtigste Einschränkung |
|---|---|---|---|---|
| Hidden JSON API | Am schnellsten | Am niedrigsten | Daten hinter einem sauberen XHR-Aufruf | Endpoint kann sich ändern oder Tokens benötigen |
| Playwright | Mittel | Höher | Vollständiges Rendering, moderne Async-Steuerung | Verbraucht CPU, Arbeitsspeicher und Bandbreite |
| Selenium | Moderate | Higher | Bestehende Stacks, breite Sprachunterstützung | Langsamere Einrichtung, ausführlichere Wartevorgänge |
| requests-html | Langsam | Niedrig | Leichtes JavaScript auf einfachen Seiten | Weitgehend nicht mehr gepflegt, anfälliges Rendering |
Kosten spielen eine Rolle, weil ein über einen volumenbasiert abgerechneten Proxy geleiteter Headless-Browser weit mehr Bytes herunterlädt als ein einzelner API-Aufruf. Wenn du im großen Maßstab scrapest, beeinflusst die gewählte Methode die Rechnung ebenso stark wie der Code. Zur umfassenderen Praxis von Taktung und Headers siehe unsere Best Practices für Web Scraping.
Wie findest du die versteckte API hinter einer dynamischen Seite?
Suche nach der Hintergrundanfrage, mit der die Seite ihre Daten abruft, denn dieser Endpoint liefert in der Regel sauberes JSON, das du direkt aufrufen kannst. Das ist der schnellste und zuverlässigste Ansatz und vermeidet den Einsatz eines Browsers vollständig.
Öffne die Entwicklertools, wechsle zum Netzwerk-Tab, filtere nach Fetch/XHR und lade die Seite neu. Achte beim Erscheinen der Inhalte auf Anfragen, die JSON mit den gewünschten Werten zurückgeben. Prüfe die Anfrage-URL, die Methode, Abfrageparameter sowie alle gesendeten Headers oder Tokens. Klicke dann mit der rechten Maustaste und kopiere sie als cURL, um die vollständige Form zu sehen. Sobald du diesen Aufruf mit einem HTTP-Client reproduzieren kannst, überspringst du das Rendering vollständig und rufst strukturierte Daten zu einem Bruchteil der Kosten ab.
Hier ist ein minimales Beispiel, das einen JSON-Endpoint über einen Proxy aufruft und die Felder direkt liest:
import requests

proxy = "http://USERNAME:[email protected]:823"
proxies = {"http": proxy, "https": proxy}

headers = {
    "User-Agent": "Mozilla/5.0",
    "Accept": "application/json",
    "Referer": "https://example.com/products",
}
params = {"category": "laptops", "page": 1}

r = requests.get(
    "https://example.com/api/v2/products",
    headers=headers,
    params=params,
    proxies=proxies,
    timeout=30,
)
r.raise_for_status()
data = r.json()

for item in data["items"]:
    print(item["name"], item["price"])
Wenn der Endpoint paginiert ist, erhöhe den Seitenparameter oder folge dem nächsten Cursor, den die Antwort zurückgibt. Benötigt eine Anfrage ein Token, ermittle, wo die Seite es zuerst ausstellt, und verwende es innerhalb derselben Session erneut. Wenn du den Aufruf über DataImpulse leitest, sieht der Endpoint eine Residential IP statt deiner Serveradresse. Das ist relevant, wenn die API die Rate nach Herkunft begrenzt. Wenn du bei der Authentifizierung am Proxy selbst nicht weiterkommst, erklärt unser Hinweis zur Proxy-Authentifizierung erläutert das Anmeldedatenformat.
Wie scrapest du dynamische Seiten mit Playwright?
Wenn keine saubere API zum Aufrufen vorhanden ist, steuerst du einen Headless-Browser wie Playwright, damit das JavaScript genau wie für einen Nutzer ausgeführt wird. Anschließend liest du das fertige DOM aus. Playwright ist der moderne Standard, weil es zuverlässiges automatisches Warten, erstklassige Async-Unterstützung und eine einfache Proxy-Option bietet.
Installiere es und lade zuerst eine Browser-Binärdatei herunter:
pip install playwright
playwright install chromium
Die zentrale Regel lautet, auf das konkrete benötigte Element zu warten, statt mit festen Pausen zu raten. Das folgende Beispiel startet Chromium, leitet ihn über einen Proxy in Wörterbuchform, wartet auf die Produktübersicht und extrahiert die gerenderten Werte:
from playwright.sync_api import sync_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

with sync_playwright() as p:
    browser = p.chromium.launch(headless=True, proxy=PROXY)
    context = browser.new_context(user_agent="Mozilla/5.0")
    page = context.new_page()
    page.goto("https://example.com/products", wait_until="domcontentloaded")

    page.wait_for_selector("div.product-card", timeout=15000)

    cards = page.query_selector_all("div.product-card")
    for card in cards:
        name = card.query_selector(".title").inner_text()
        price = card.query_selector(".price").inner_text()
        print(name, price)

    browser.close()
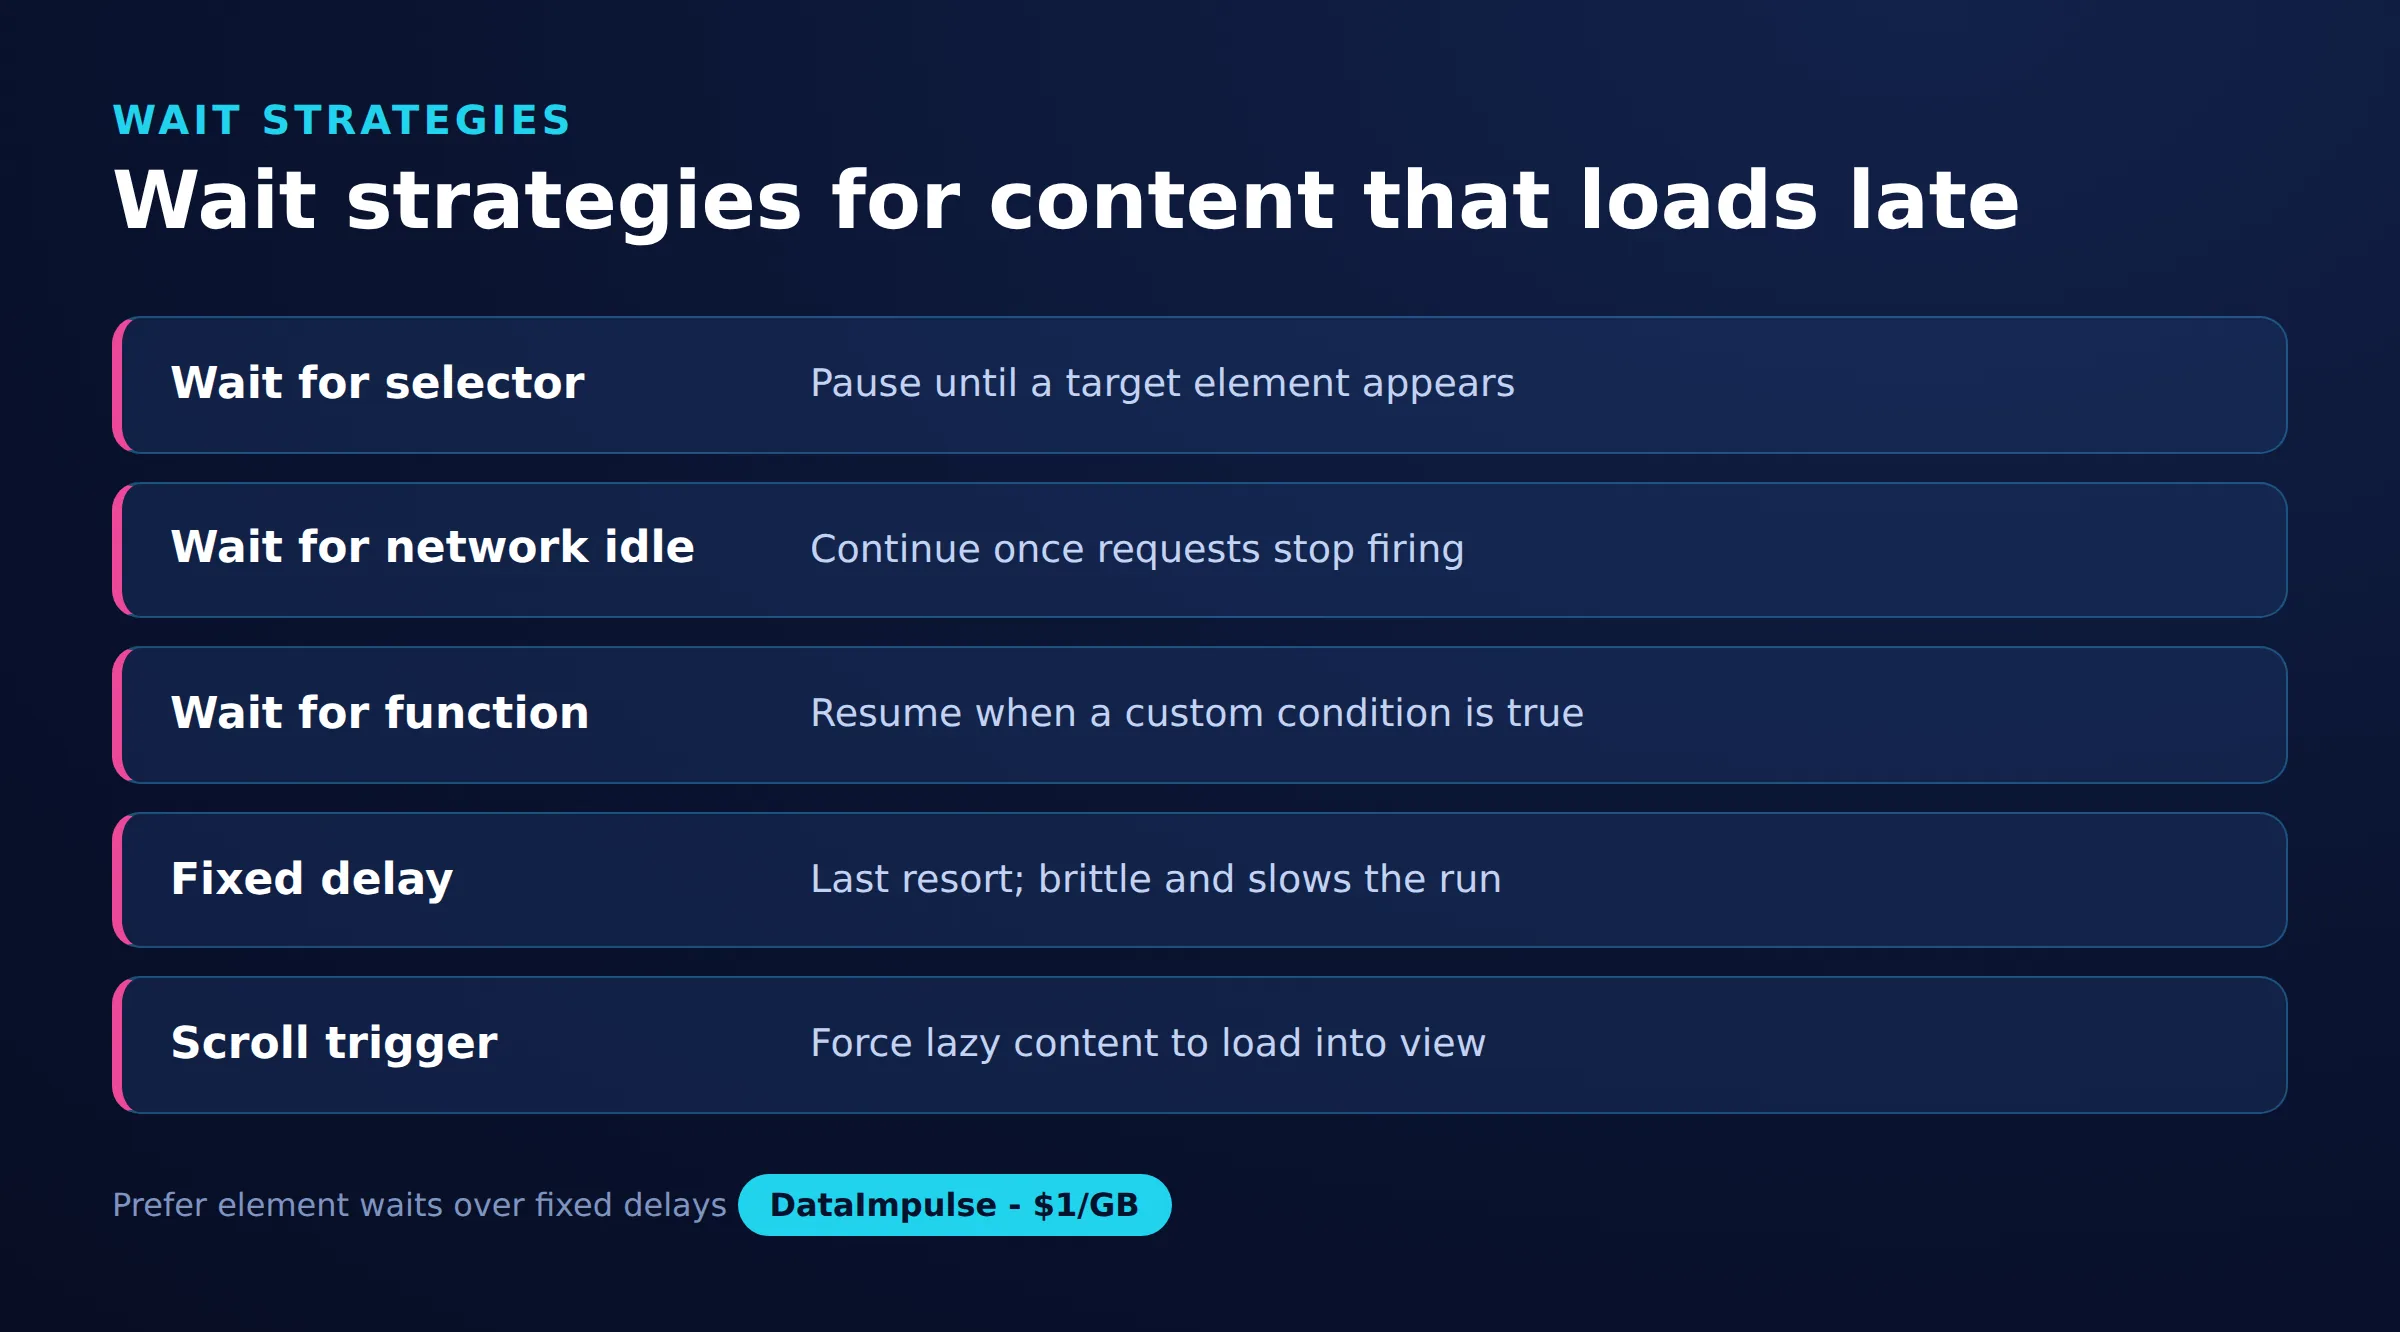
Beim Warten entscheidet sich, ob die meisten dynamischen Scraper funktionieren oder scheitern. Daher hilft es, die vier Strategien und ihren jeweiligen Einsatz zu kennen. Warte lieber auf einen konkreten Selektor oder eine Bedingung als auf networkidle, das bei Seiten mit dauerhaft offenen Verbindungen hängen kann:
# Wait for a specific element (most reliable)
page.wait_for_selector("div.product-card", timeout=15000)

# Wait for the initial DOM to be built, before every script finishes
page.goto(url, wait_until="domcontentloaded")

# Wait until there are no network connections for 500 ms
page.goto(url, wait_until="networkidle")

# Wait for a custom condition, such as a minimum item count
page.wait_for_function(
    "document.querySelectorAll('div.product-card').length > 20"
)
Wenn dein Ziel stark auf im Browser ausgeführte Skripte angewiesen ist, behandelt unser ergänzender Artikel über Web Scraping mit JavaScript ausführlicher das clientseitige Rendering, das diese Seiten schwierig macht.
Wie gehst du mit Infinite Scroll und Mehr-laden-Buttons um?
Löse dieselben Ereignisse aus, mit denen die Seite weitere Inhalte lädt, und warte dann, bis jede neue Gruppe gerendert wurde, bevor du sie liest. Infinite Scroll und Mehr-laden-Buttons rufen Daten nur bei Nutzeraktionen ab. Ein einzelnes Laden der Seite erfasst daher nur den ersten Bildschirm.
Bevor du den Browser einsetzt, prüfe erneut den Netzwerk-Tab. Infinite Scroll wird fast immer von einem paginierten XHR-Aufruf gespeist, und das Durchlaufen dieses Endpoints mit dem obigen requests-Ansatz ist deutlich günstiger als Scrollen. Wenn du scrollen musst, tue es in einer kontrollierten Schleife, die stoppt, sobald keine neuen Elemente erscheinen:
def scroll_until_stable(page, item_selector, max_rounds=30):
    seen = 0
    for _ in range(max_rounds):
        page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
        page.wait_for_timeout(1500)
        count = len(page.query_selector_all(item_selector))
        if count == seen:
            break            # no new items loaded, stop
        seen = count
    return seen
Seiten, die statt Scrollen einen expliziten Button verwenden, benötigen eine Klickschleife. Lies vor jedem Klick die Anzahl der Elemente, klicke den Button und warte, bis die Zahl steigt. So läufst du dem Rendering nie voraus:
def click_load_more(page, button_selector, item_selector, max_clicks=50):
    for _ in range(max_clicks):
        button = page.query_selector(button_selector)
        if button is None or not button.is_visible():
            break
        before = len(page.query_selector_all(item_selector))
        button.click()
        page.wait_for_function(
            "([sel, n]) => document.querySelectorAll(sel).length > n",
            arg=[item_selector, before],
        )
    return len(page.query_selector_all(item_selector))
Dedupliziere beim Sammeln, denn das erneute Lesen derselben Nodes in jedem Durchlauf kommt häufig vor. Führe eine Menge eindeutiger IDs oder URLs und füge nur Datensätze hinzu, die du noch nicht gesehen hast.
Kannst du Selenium statt Playwright verwenden?
Ja, Selenium steuert auf dieselbe Weise einen echten Browser und ist eine solide Wahl, wenn dein Team es bereits nutzt oder seine breite Sprachunterstützung benötigt. Das Muster entspricht Playwright: Lade die Seite, warte mit WebDriverWait auf eine Bedingung und lies dann Elemente aus dem gerenderten DOM.
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

options = Options()
options.add_argument("--headless=new")
options.add_argument("--proxy-server=http://gw.dataimpulse.com:823")

driver = webdriver.Chrome(options=options)
driver.get("https://example.com/products")

WebDriverWait(driver, 15).until(
    EC.presence_of_element_located((By.CSS_SELECTOR, "div.product-card"))
)

for card in driver.find_elements(By.CSS_SELECTOR, "div.product-card"):
    name = card.find_element(By.CSS_SELECTOR, ".title").text
    price = card.find_element(By.CSS_SELECTOR, ".price").text
    print(name, price)

driver.quit()
Ein Hinweis: Das einfache Flag –proxy-server akzeptiert keinen Benutzernamen und kein Passwort, daher braucht ein authentifizierter Proxy eine Hilfslösung. Die Bibliothek Selenium Wire fügt Anmeldedaten sauber ein, und unsere Anleitung zur Einrichtung von Selenium-Wire-Proxy zeigt die genaue Konfiguration. Selenium ist aufwendiger einzurichten als Playwright und seine Wartevorgänge sind ausführlicher. Neue Projekte beginnen daher oft mit Playwright, sofern es keinen Grund gibt, bei Selenium zu bleiben.
Wie reduzierst du Proxy-Bandbreite beim Rendern von Seiten?
Blockiere Ressourcen, die du nicht brauchst, damit der Browser keine Bilder, Fonts und Medien mehr herunterlädt, die du nie parst. Ein Headless-Browser ruft standardmäßig jedes Asset ab, und jedes dieser Bytes kostet Geld, wenn es über einen pro Gigabyte abgerechneten Proxy geleitet wird.
Mit Playwright kannst du Anfragen abfangen und solche abbrechen, die für deine Extraktion irrelevant sind. Das Blockieren von Bildern, Medien und Fonts kann den Proxy-Traffic deutlich reduzieren, während das tatsächlich gelesene JSON und HTML unverändert bleibt:
BLOCK = {"image", "media", "font"}

def block_heavy(route):
    if route.request.resource_type in BLOCK:
        route.abort()
    else:
        route.continue_()

context = browser.new_context()
context.route("**/*", block_heavy)
page = context.new_page()
page.goto("https://example.com/products", wait_until="domcontentloaded")
Du kannst denselben Handler erweitern, um Analytics- und Werbedomains zu überspringen, die Last, aber keine Daten hinzufügen. Da DataImpulse-Traffic nutzungsbasiert ab 1 Dollar pro GB abgerechnet wird und nicht abläuft, senkt das Kürzen verschwendeter Bytes direkt die Kosten jedes Scrapes. Die Wiederverwendung eines Browser-Kontexts für zusammenhängende Seiten vermeidet zudem wiederholte Startkosten. Die günstigste Anfrage bleibt die, die du durch den Rückgriff auf eine versteckte API vermeidest.
Wie fügst du Fehlerbehandlung und Wiederholungen hinzu?
Umschließe jede Navigation mit einer Wiederholungsschleife mit exponentiellem Backoff, damit ein einzelnes langsames Laden oder eine vorübergehende Blockierung nicht den gesamten Durchlauf beendet. Dynamische Seiten schlagen zeitweise fehl, und ein Scraper, der beim ersten Timeout aufgibt, verliert im großen Maßstab einen großen Anteil der Datensätze.
Fange den von Playwright ausgelösten Timeout ab, warte ein zunehmend längeres Intervall und wiederhole den Vorgang eine begrenzte Anzahl von Malen, bevor du den Fehler protokollierst und fortfährst:
import time
from playwright.sync_api import TimeoutError as PlaywrightTimeout

def fetch_with_retries(page, url, selector, retries=3, backoff=2):
    for attempt in range(1, retries + 1):
        try:
            page.goto(url, wait_until="domcontentloaded", timeout=30000)
            page.wait_for_selector(selector, timeout=15000)
            return page.query_selector_all(selector)
        except PlaywrightTimeout:
            wait = backoff ** attempt
            print(f"Attempt {attempt} timed out, retrying in {wait}s")
            time.sleep(wait)
    raise RuntimeError(f"Failed to load {url} after {retries} attempts")
Kombiniere Wiederholungen mit Proxy-Rotation, damit jeder Versuch über eine neue IP gesendet wird. Wenn ein Ausgang rate-limitiert ist, erreicht die nächste Anfrage eine andere Adresse und ist oft erfolgreich. Ein rotierender Pool aus Residential Proxys oder Mobile Proxys weist jeder Anfrage automatisch eine neue IP zu, wodurch viele harte Blockierungen zu einer einfachen Wiederholung werden. Speziell zur Behandlung von Fehlern auf Proxy-Ebene behandelt unser Hinweis zu HTTP-Fehler 407 die häufigste Authentifizierungsantwort.
Wie scrapest du viele dynamische Seiten gleichzeitig?
Nutze die Async API von Playwright mit einem asyncio-Semaphor, damit mehrere Seiten gleichzeitig rendern, ohne deinen Rechner oder das Ziel zu überlasten. Gleichzeitigkeit bringt dynamischem Scraping seinen Durchsatz zurück, da jede Browserseite die meiste Zeit auf das Netzwerk wartet.
Das Semaphor begrenzt, wie viele Seiten parallel laufen. Teile einen Browser und Kontext über die Tasks, öffne eine Seite pro URL und sammle die Ergebnisse:
import asyncio
from playwright.async_api import async_playwright

PROXY = {
    "server": "http://gw.dataimpulse.com:823",
    "username": "USERNAME",
    "password": "PASSWORD",
}

async def scrape_one(context, url, sem):
    async with sem:
        page = await context.new_page()
        try:
            await page.goto(url, wait_until="domcontentloaded")
            await page.wait_for_selector("div.product-card", timeout=15000)
            cards = await page.query_selector_all("div.product-card")
            return [await c.inner_text() for c in cards]
        finally:
            await page.close()

async def main(urls):
    sem = asyncio.Semaphore(5)   # at most 5 pages at once
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, proxy=PROXY)
        context = await browser.new_context()
        tasks = [scrape_one(context, u, sem) for u in urls]
        results = await asyncio.gather(*tasks)
        await browser.close()
    return results

urls = ["https://example.com/products?page=%d" % i for i in range(1, 21)]
data = asyncio.run(main(urls))
Halte das Gleichzeitigkeit-Limit moderat. Zu viele parallele Seiten erschöpfen den Arbeitsspeicher und lösen Rate Limits aus, was mehr Wiederholungen kostet, als die Parallelität einspart. Beginne bei etwa fünf und erhöhe es nur, solange die Erfolgsquoten hoch bleiben.
Wie exportierst du gescrapte Daten in JSON und CSV?
Sammle die Ergebnisse jeder Seite in einer Liste von Dictionaries und schreibe diese Liste dann für verschachtelte Daten in JSON oder für flache, tabellenkalkulationsfreundliche Tabellen in CSV. Wenn du Extraktion und Export trennst, lässt sich der Scraper leichter testen und erneut ausführen.
import json
import csv

records = [
    {"name": "Laptop A", "price": "999"},
    {"name": "Laptop B", "price": "1299"},
]

# Export to JSON
with open("products.json", "w", encoding="utf-8") as f:
    json.dump(records, f, ensure_ascii=False, indent=2)

# Export to CSV
with open("products.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price"])
    writer.writeheader()
    writer.writerows(records)
Wähle JSON, wenn Datensätze verschachtelte Listen oder Objekte enthalten, und CSV, wenn jeder Datensatz dieselben flachen Felder hat und Analysten ihn in einer Tabellenkalkulation öffnen. Normalisiere deine Felder vor dem Schreiben, damit jeder Datensatz dieselben Schlüssel hat. Dann bleibt der Exportschritt trivial, unabhängig davon, wie die dynamische Seite gerendert wurde. Von hier aus speist dasselbe JSON ohne weiteres Parsen einen Datenbankimport oder einen Analytics-Job.
Häufig gestellte Fragen
Wie erkenne ich vor dem Schreiben eines Scrapers, ob eine Seite dynamisch ist?
Vergleiche Quelltext anzeigen mit dem Elemente-Panel in den Entwicklertools oder zähle ein Zielelement im Roh-HTML und im gerenderten DOM. Wenn die Daten erst nach der Ausführung von JavaScript erscheinen, ist die Seite dynamisch und benötigt einen API-Aufruf oder einen Headless-Browser.
Ist es besser, die versteckte API aufzurufen oder einen Headless-Browser zu verwenden?
Rufe die versteckte API auf, wenn du sie finden kannst, denn sie liefert sauberes JSON zu einem Bruchteil der Kosten und Zeit des Renderings. Verwende einen Headless-Browser nur, wenn keine reproduzierbare API existiert oder die Daten von komplexen clientseitigen Skripten abhängen.
Sollte ich für dynamisches Scraping Playwright oder Selenium verwenden?
Playwright ist dank zuverlässigem automatischem Warten und integrierter Async-Unterstützung der moderne Standard, daher beginnen neue Projekte üblicherweise damit. Selenium passt gut, wenn dein Stack es bereits nutzt oder du seine breitere Sprachunterstützung benötigst.
Wie reduziere ich Proxy-Bandbreite bei der Nutzung eines Headless-Browsers?
Fange Anfragen ab und brich Bilder, Fonts, Medien und Analytics ab, die du nicht parst. Das kann den Traffic deutlich reduzieren, da Proxy-Kosten pro Gigabyte berechnet werden, und beschleunigt außerdem jedes Laden einer Seite.
Wie scrape ich Inhalte, die per Infinite Scroll geladen werden?
Prüfe zuerst im Netzwerk-Tab den paginierten XHR-Aufruf hinter dem Scrollen und durchlaufe diesen Endpoint direkt. Wenn du scrollen musst, tue es in einer kontrollierten Schleife und warte, bis jede neue Gruppe gerendert ist, bevor du sie liest.
Wann ist DataImpulse nicht die richtige Wahl?
Wenn du statische ISP-Proxys, eine vollständig verwaltete Scraping API oder Zugriff auf Banking- und Regierungswebsites benötigst, ist DataImpulse nicht das richtige Werkzeug. Der Fokus liegt auf rotierenden Residential-, Mobile- und Datacenter-Proxys zum Sammeln öffentlicher Daten und zum Zugriff auf Inhalte.
Scrape dynamische Seiten mit zuverlässigen Proxys
Wenn dein Scraper Residential-, Mobile- oder Datacenter-IP-Adressen benötigt, die sich wie echte Besucher verhalten, kannst du mit nutzungsbasiertem Traffic ab 1 Dollar pro GB beginnen. Erstelle ein DataImpulse-Konto und leite dein dynamisches Scraping über rotierende oder Sticky Sessions.