
In this Article
Ist Web Scraping legal? Die Rechtmäßigkeit des Web Scraping hängt von vier Dingen ab: was Sie scrapen (öffentliche Produktpreise vs. persönliche Profile), wie Sie es scrapen (öffentliche Seiten vs. hinter einem Login), wo Sie betreiben (die CFAA-Logik der USA vs. Europas GDPR) und was Sie mit den Daten machen (Preisüberwachung vs. AI-Schulung). Wenn Leute also fragen: „Ist es legal, Daten von Websites zu extrahieren?”, lautet die ehrliche Antwort, dass das Scrapen öffentlich verfügbarer, nicht personenbezogener Daten in den meisten Rechtsordnungen weitgehend legal ist – aber jeder dieser Faktoren bewegt Sie zwischen vertretbarer Geschäftspraxis und behördlichen Maßnahmen. In diesem Leitfaden werden die bahnbrechenden Fälle, die Klagen aus der AI-Ära 2025-2026, die Positionen aller wichtigen Regulierungsbehörden und ein praktischer Compliance-Rahmen erläutert.
Eines vorweg: Dies sind allgemeine Informationen, keine Rechtsberatung. Bevor Sie eine kommerzielle Scraping-Pipeline skalieren, holen Sie sich Rechtsberatung in Ihrer Gerichtsbarkeit und der Ihrer Ziele ein.
Wichtige Fakten
- Das Löschen öffentlicher, nicht personenbezogener Daten ist im Großen und Ganzen legal – die Details (was, wie, wo, warum) entscheiden alles.
- „Öffentlich” bedeutet nicht „kostenlose Nutzung” für personenbezogene Daten – EU-Regulierungsbehörden verhängen dafür Geld (Clearview: 30,5 Mio. € in den Niederlanden, 20 Mio. € in Italien, 7,5 Mio. £ im Vereinigten Königreich).
- Abgemeldet vs. Angemeldet ist die Linie, die immer wieder gewinnt – öffentliches Abmelden-Scraping ist vertretbar (hiQ, Meta v. Bright Data); Eine Anmeldung gegen akzeptierte AGBs erfolgt nicht.
- In der AI-Ära kamen Vertrags-, Lizenz- und Urheberrechtsansprüche hinzu – die Rechtmäßigkeit von collection und von training sind nun getrennte Fragen.
- Proxys selbst sind legal – die Aktivität, nicht das Tool, bestimmt die Legalität.
Die kurze Antwort per Frage
| Frage | Kurze Antwort |
|---|---|
| Ist das Scrapen öffentlicher Produkt-/Preisdaten legal? | Im Allgemeinen ja – die am besten vertretbare Kategorie überhaupt |
| Ist das Scrapen personenbezogener Daten (Namen, Profile, Kontakte) legal? | Hohes Risiko – GDPR Aufsichtsbehörden sind dafür in Ordnung, selbst wenn die Daten öffentlich sind |
| Ist Scraping hinter einem Login legal? | Risky – Sie haben die Bedingungen akzeptiert; Vertragsansprüche bleiben auch bei Scheitern von CFAA bestehen |
| Ist ein Verstoß gegen robots.txt illegal? | An sich kein Gesetz, aber Gerichte und Aufsichtsbehörden betrachten es als Beweis für Bösgläubigkeit |
| Ist die Verwendung von Proxys legal? | Yes – die Aktivität, nicht das Werkzeug, bestimmt die Rechtmäßigkeit |
| Ist Scraping für die AI-Schulung legal? | Unsettled – Fair-Use gewinnt für rechtmäßig erlangte Daten, aber Vertrags-/Lizenzklagen nehmen zu |
Häufige Mythen über die Legalität von Web Scraping
Die meiste Verwirrung über die Rechtmäßigkeit von Web Scraping entsteht durch die Vermischung technischer Fähigkeiten mit gesetzlicher Erlaubnis. Drei Mythen sind es wert, vor den Details aufgeklärt zu werden.
Mythos 1: Web Scraping ist Hacking
Das Scrapen einer öffentlichen Seite ist kein unbefugter Zugriff – ein Bot fordert dieselbe Seite an wie ein normaler Browser. Der hiQ v. LinkedIn (2022) des US Ninth Circuit stellte fest, dass das Scraping öffentlicher Seiten wahrscheinlich nicht gegen den CFAA verstößt, wenn kein Authentifizierungsgate umgangen wird. Die Leute fragen auch: „Ist Screen Scraping legal?” – gleiche Antwort: Das Lesen einer öffentlichen Seite auf die Art und Weise, wie ein Browser es tut, ist kein „Hacking”.
Mythos 2: „Öffentliche Daten” bedeuten freie Nutzung
Öffentlich bedeutet nicht uneingeschränkt. Persönliche Daten bleiben auch dann geschützt, wenn sie offen sichtbar sind – die europäischen Regulierungsbehörden verhängen ein Bußgeld für die Abschaffung öffentlicher personenbezogener Daten. Das Urheberrecht gilt weiterhin für öffentliche Artikel und Bilder. Und die Nutzungsbedingungen können Sie auch ohne Login binden. Die eigentliche Frage ist also: Ist Data Scraping legal? – hängt stark davon ab, was die Daten tatsächlich sind.
Mythos 3: Ein Verstoß gegen ToS ist ein Verbrechen
Ein Verstoß gegen die Nutzungsbedingungen ist eine zivilrechtliche und keine strafrechtliche Angelegenheit. Ein Verstoß gegen ToS ist nicht automatisch illegal – aber er ist ein Grund für die Sperrung, eine Grundlage für eine Zivilklage und ein Beweis für Bösgläubigkeit vor Gericht. Weitere Informationen zu den Nutzungsbedingungen für Web Scraping finden Sie weiter unten.
Vereinigte Staaten: CFAA, hiQ und Vertragsschicht
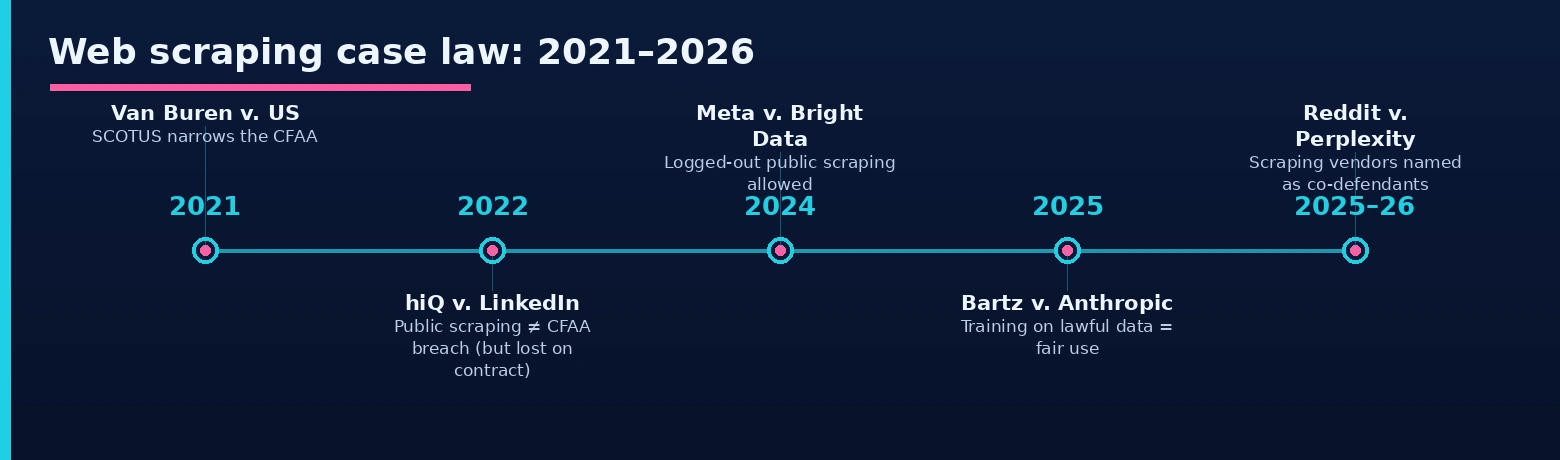
Die grundlegende Frage: Ist Website-Scraping in den USA legal? – kam darauf an, ob das Scrapen öffentlicher Seiten „unberechtigter Zugriff” im Sinne des Computer Fraud and Abuse Act – dem Anti-Hacking-Gesetz – ist. Der Neunte Bezirk antwortete in hiQ Labs v. LinkedIn (2022, unter Anwendung der Van Buren-Logik des Obersten Gerichtshofs): no. Wenn eine Seite für jeden ohne Anmeldeinformationen geöffnet ist, gibt es kein Autorisierungstor, das durchbrochen werden könnte, sodass das Scraping öffentlicher Daten kein CFAA-Verstoß darstellt.
Aber die ganze Geschichte von hiQ ist die wahre Lektion. Nachdem hiQ die CFAA-Schlacht gewonnen hatte, verlor es den Krieg: Im November 2022 stellte das Gericht fest, dass gegen LinkedIns User Agreement verstoßen hatte (was es durch die Erstellung von Konten akzeptiert hatte), und der Fall endete mit einem Zustimmungsurteil. Der CFAA schützt Sie vor Hacking-Ansprüchen auf öffentlichen Seiten; Es schützt Sie nicht vor Verträgen, denen Sie zugestimmt haben.
Meta v. Bright Data (Januar 2024) verschärfte die Linie: Ein Gericht lehnte es ab, Bright Data wegen des Scrapings von öffentlichen, abgemeldeten Facebook- und Instagram-Seiten strafbar zu machen, da die Nutzungsbedingungen der Plattformen für Kontoinhaber und nicht für abgemeldete Besucher gelten. Die daraus resultierende Regel – logged-out Public Scraping – ist vertretbar; Angemeldetes Scraping gegen akzeptierte Bedingungen ist nicht möglich. Ältere Fälle von Hausfriedensbruch (eBay v. Bidder’s Edge, 2000) sind immer noch sehr umfangreich, und die Datenschutzgesetze der einzelnen Bundesstaaten (CCPA/CPRA in Kalifornien, VCDPA in Virginia) fügen darüber hinaus noch Verpflichtungen zum Schutz personenbezogener Daten hinzu.
Nutzungsbedingungen: Browsewrap, Clickwrap und Wenn Regeln zum rechtlichen Risiko werden
Nutzungsbedingungen sind kein Gesetz, aber die Gerichte legen großen Wert darauf – und die entscheidende Frage ist, ob der Benutzer sie tatsächlich akzeptiert hat.
Browsewrap vs. Clickwrap: Welcher ToS bindet Sie tatsächlich?
Bei einer browsewrap-Vereinbarung handelt es sich lediglich um einen Link, der irgendwo auf der Seite steht und nicht aktiv akzeptiert wird – Gerichte setzen ihn selten gegen jemanden durch, der nie darauf geklickt hat. Eine clickwrap-Vereinbarung erfordert eine explizite Aktion – ein Kontrollkästchen oder eine Schaltfläche „Ich stimme zu” – und wird fast jedes Mal von Gerichten durchgesetzt. Die praktische Linie: Bedingungen, die Sie aktiv akzeptiert haben (normalerweise durch die Erstellung eines Kontos), sind für Sie verbindlich. Begriffe, die Sie einfach hätten sehen können, tun dies oft nicht.
Wenn ToS-Verstöße zu rechtlichen Beweisen werden
Ein Verstoß gegen die Web-Scraping-Nutzungsbedingungen stellt keine Straftat dar, hat aber drei praktische Konsequenzen: Die Plattform kann Sie sofort sperren, es ist die Grundlage für eine zivilrechtliche Vertragsverletzungsklage (die Klage, die letztendlich hiQ zum Scheitern brachte) und es gilt als böse Absicht, wenn eine CFAA- oder damit verbundene Klage vor Gericht gelangt.
Die AI-Ära: Klagen 2025-2026, die die Karte veränderten
Die AI-Schulung löste eine zweite Welle von Scraping-Rechtsstreitigkeiten aus – weniger über „War der Zugriff autorisiert” und mehr über -Verträge, Lizenzierung und Urheberrecht (dieselben Fragen, die proxies für die AI-Trainingsdatenerfassung prägen):
- Bartz v. Anthropic (Juni 2025, Richter Alsup): Die Schulung eines LLM zu rechtmäßig erworbenen Büchern durch ist eine „überaus transformative” faire Verwendung – aber das Urteil grenzt Raubkopien der Quellen ausdrücklich aus. Wie Sie die Daten erhalten haben, ist genauso wichtig wie das, was Sie damit gemacht haben.
- Kadrey v. Meta (Juni 2025, Richter Chhabria): Die Kläger von verloren mit ihrer Akte, aber das Gutachten warnte davor, dass dies keine umfassende Genehmigung für die AI-Schulung sei – ein knapper Sieg, keine Doktrin.
- Reddit v. Anthropic (eingereicht im Juni 2025): Reddit verklagt wegen Nutzungsbedingungen und ungerechtfertigter Bereicherung-Theorien, nicht wegen Urheberrecht. Ende März 2026 verwies ein Bundesrichter den Fall an das kalifornische Staatsgericht mit der Begründung, dass die Ansprüche nicht durch das Copyright Act ausgeschlossen seien – und bestätigte damit, dass vertragsbasierte Scraping-Ansprüche eine eigenständige Gültigkeit haben.
- Reddit gegen Perplexity, SerpApi, Oxylabs & AWMProxy (Okt. 2025, S.D.N.Y.): ist der erste Fall, in dem Scraping-Infrastrukturanbieter als Mitangeklagte neben dem Unternehmen AI genannt werden. Für Proxy-Käufer geht es im Kern um Lieferketten: Wer Ihre Daten erhebt und wie, ist nun Teil Ihrer rechtlichen Risiken.
- NYT v. OpenAI (konsolidiert, S.D.N.Y.): im Januar 2026 ordnete das Gericht OpenAI an, eine 20-Millionen-Gesprächsprotokollprobe zur Ermittlung vorzulegen; Der Fall testet, ob das Modell „Aufstoßen” den fairen Gebrauch untergräbt.
- Die Lizenzökonomie ist die Kehrseite: Reddit lizenziert Daten an Google (~60 Mio. USD/Jahr) und OpenAI; Cloudflare und Stack Overflow haben Pay-per-Crawl eingeführt. „Free to scrape” und „licensed to train” sind unterschiedliche Begriffe.
Europa: GDPR und die strengsten Regulierungsbehörden
In der EU (und im Vereinigten Königreich) lautet die Frage selten: „War der Zugriff autorisiert?” – es lautet : „Haben Sie personenbezogene Daten ohne Rechtsgrundlage verarbeitet?” Das Vollstreckungsprotokoll ist eindeutig:
- Niederlande (AP) – die härteste Linie in Europa. In seinen Leitlinien vom Mai 2024 wird das Scraping personenbezogener Daten als „fast immer ein Verstoß gegen das GDPR” bezeichnet und gegen Clearview AI eine Geldstrafe von 30,5 Millionen Euro verhängt, wobei die Direktoren vor persönlicher Haftung gewarnt wurden.
- Italien (Garante) – Geldstrafe gegen Clearview 20 Millionen Euro; Sein erklärtes Prinzip: „Wenn es öffentlich ist, kann ich es nehmen” ist false.
- Frankreich (CNIL) – gegen den Kontaktdatenvermittler KASPR wurde eine Geldstrafe von 240.000 € verhängt (Dezember 2024). Die Leitlinien vom Juni 2025 erlauben das Auslesen öffentlicher personenbezogener Daten im Rahmen berechtigter Interessen – jedoch nur mit Sicherheitsvorkehrungen (Ausschlusslisten, Minimierung, Transparenz).
- UK (ICO) – Geldstrafe gegen Clearview £7,5 Millionen; Das britische GDPR und das Data (Use and Access) Act 2025 sorgen dafür, dass der Rahmen an den der EU angepasst wird.
- EU-weit: Der Database Directive fügt ein separates sui generis Recht gegen die Extraktion wesentlicher Teile geschützter Datenbanken hinzu – ein Anspruch, der in Europa, aber nicht in den USA besteht.
Die entscheidende Nuance: nichts davon zielt auf nicht-personenbezogene Daten ab. Preise, Produktlisten, Verfügbarkeit und Rankings liegen außerhalb des Geltungsbereichs von GDPR – europäische Preisinformationen und SEO-Pipelines laufen jeden Tag legal. Die unten stehende Risikokarte zeigt, wie das Risiko des Scrapings personenbezogener Daten je nach Gerichtsbarkeit variiert.
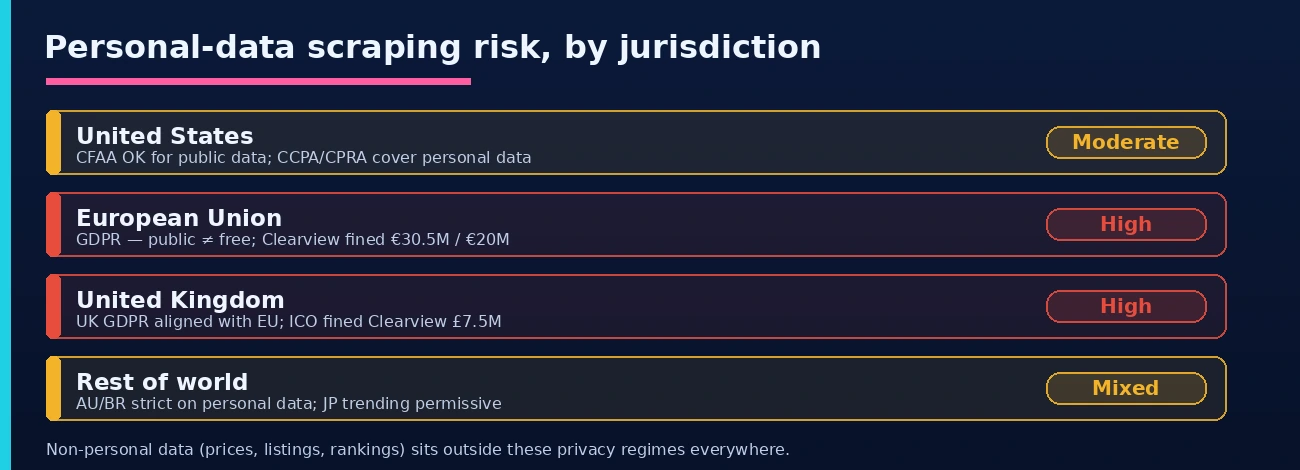
Über Europa und die USA hinaus reicht das Bild beim Scraping personenbezogener Daten von streng bis milder:
| Zuständigkeit | Rahmen | Kratzhaltung |
|---|---|---|
| Australien | Privacy Act 1988 + Reform 2024 | Öffentliche Produktdaten sind vertretbar; Personenbezogene Daten sind es nicht. |
| Japan | APPI | Tendenz günstig – eine Änderung von 2026 würde die Nutzung öffentlicher Daten erleichtern. |
| Brasilien | LGPD (ANPD) | Aktive Durchsetzung personenbezogener Daten, einschließlich Clearview. |
| Indien | DPDP Act 2023 | Verschärfung der Vorschriften zum Schutz personenbezogener Daten; AI-Schulungsfälle im Gange. |
| China | PIPL + DSL + CSL | Strenger Umgang mit personenbezogenen Daten und grenzüberschreitender Übermittlung; Lokalisierungsüberprüfung erforderlich. |
Jeder Länderführer in unserer blog-Bibliothek – von Germany bis Japan – enthält einen faktengeprüften Abschnitt über lokales Recht, wenn Sie mehr über einen bestimmten Markt erfahren möchten.
Urheberrecht: Was Sie kratzen dürfen und was nicht
Das Urheberrecht ist eine der häufigsten Ursachen für rechtliche Probleme beim Scraping – aber die meisten geschäftlichen Anwendungsfälle liegen in einer sicheren Zone, wenn man Fakten von kreativen Inhalten trennt.
Was ist geschützt und was nicht
Fakten sind nicht urheberrechtlich geschützt – Preise, Bewertungen, Verfügbarkeit und Spezifikationen können kostenlos gesammelt werden, weshalb das Scrapen von Produktdaten eine sichere Zone darstellt. Was ist schützt: Artikel, Fotos, Videos, Originaltext und die kreative Auswahl oder Anordnung in einer Datenbank. Bei der Neuveröffentlichung dieser Inhalte im großen Stil entstehen Ansprüche wegen Urheberrechtsverletzung. Das US Digital Millennium Copyright Act (DMCA) kommt separat zum Einsatz – wenn Sie Zugriffskontrollen umgehen oder Urheberrechtsverwaltungsinformationen entfernen, nicht nur bei der Neuveröffentlichung.
Fair Use (USA) und DSM Directive (EU): Das Scrapen urheberrechtlich geschützter Inhalte ist zulässig
In den USA berücksichtigt fair use vier Faktoren: den Zweck der Nutzung (transformativ oder lediglich kommerziell?), die Art der Arbeit, wie viel Sie einnehmen und die Wirkung auf den Markt – wobei Authors Guild v. Google (Google Books) der klassische Präzedenzfall für transformative Nutzung ist. In der EU ermöglicht DSM Directive Text- und Data-Mining, wenn Sie rechtmäßigen Zugriff haben und der Rechteinhaber sich nicht abgemeldet hat (oft über robots.txt signalisiert). Beide lassen Spielraum, um urheberrechtlich geschützte Inhalte zur Analyse herauszusuchen – keines von beiden gewährt eine umfassende Wiederveröffentlichung.
Was ist vertretbar und was ist riskant?
Nicht jeder Scrape birgt das gleiche Risiko – es hängt vom Datentyp ab, wie Sie darauf zugreifen und was Sie mit dem Ergebnis machen. In den beiden folgenden Listen können Sie Ihr Projekt schnell platzieren.
Im Allgemeinen vertretbar
- Öffentliche, schreibgeschützte Sammlung nicht persönlicher -Daten: Preise, Produktspezifikationen, Lagerbestände, Rankings, Suchergebnisse, Flugpreise, Immobilieneinträge
- Nur abgemeldeter Zugriff – nichts hinter der Authentifizierung
- Individuelle Anforderungsraten, die die Infrastruktur des Ziels nicht belasten
- Berücksichtigung von robots.txt und veröffentlichten Crawling-Richtlinien
- Wettbewerbsinformationen, Marktforschung, SEO-Überwachung, Anzeigenverifizierung, akademische Forschung zu Aggregaten
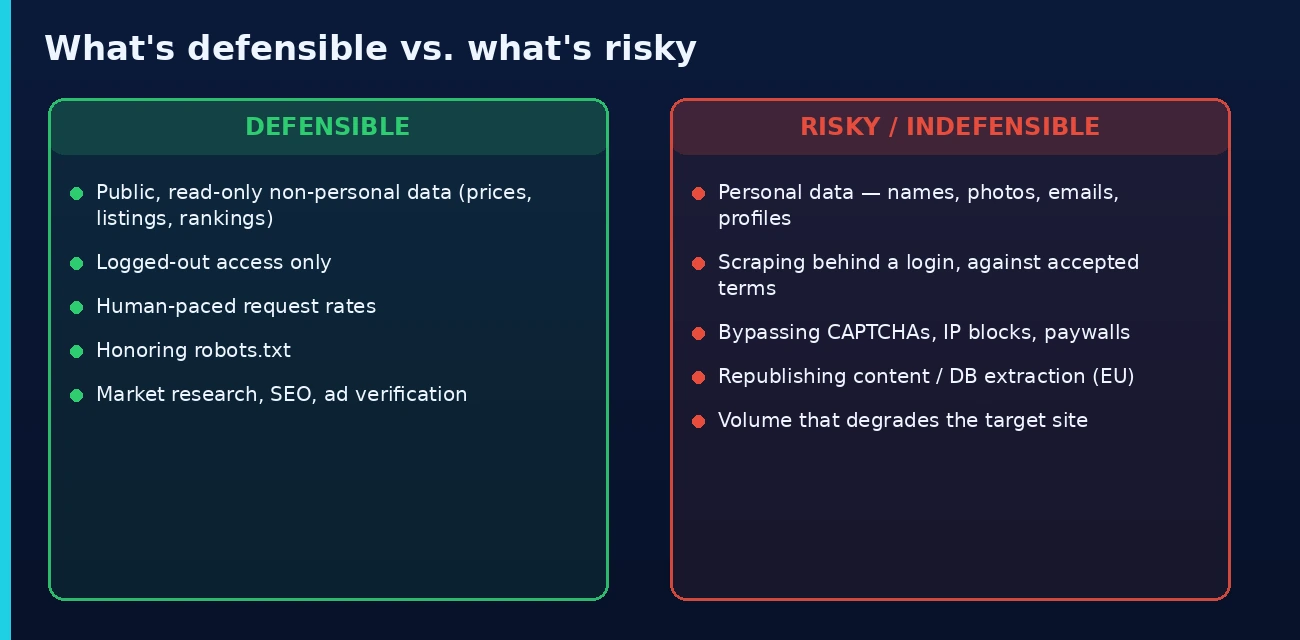
Riskant bis unhaltbar
- Scraping persönlicher Daten – Namen, Fotos, E-Mails, Telefonnummern, Profile – insbesondere in großem Umfang, insbesondere in Europa
- Sich hinter einem Login verstecken, gegen Bedingungen, die Sie akzeptiert haben (die Lektion zum HiQ-Vertrag)
- Umgehen technischer Barrieren: CAPTCHAs dargestellt als Zugangskontrollen, IP-Sperren speziell für Sie, Paywalls
- Neuveröffentlichung gelöschter Inhalte im Großhandel (Urheberrecht) oder Extraktion wesentlicher Teile geschützter Datenbanken (EU-Datenbankrecht)
- Volumen, das den Zielstandort beeinträchtigt (Gefährdung durch Hausfriedensbruch)
- Schulung von AI zu Inhalten, die Sie aus Raubkopien oder Quellen erhalten haben, die gegen die Nutzungsbedingungen verstoßen (Ausgliederung von Bartz)
Eine Compliance-Checkliste für Scraping-Teams
1. Begrenzen Sie die Daten. Wenn ein Feld eine Person identifizieren kann, behandeln Sie es als reguliert: Entweder lassen Sie es fallen oder schaffen Sie eine rechtmäßige GDPR-Grundlage mit dokumentierten Sicherheitsmaßnahmen (das CNIL-Blatt über berechtigte Interessen von 2025 ist die beste Vorlage).
2. Bleiben Sie abgemeldet. Nur öffentliche Seiten. In dem Moment, in dem Sie sich authentifizieren, haben Sie einen Vertrag angenommen – und Vertragsansprüche sind diejenigen, die gewinnen.
3. Respektieren Sie die Signale der Website. robots.txt, Ratenbegrenzungen, Crawling-Verzögerung. Nicht immer rechtsverbindlich, aber das Erste, was ein Gericht oder eine Aufsichtsbehörde prüft.
4. Ingenieur für Zurückhaltung. Taktfrequenz im menschlichen Tempo, Zwischenspeicherung, um ein erneutes Abrufen zu vermeiden, kein Hämmern. Die Lautstärke ist es, die aus einem Kratzstreit eine Klage wegen Hausfriedensbruchs macht.
5. Achten Sie auf die Lieferkette. Reddit vs. Perplexity nannte die Scraping-Anbieter, nicht nur den AI-Käufer. Erfahren Sie, wie Ihre Datenanbieter Daten sammeln.
6. Getrennte Sammlung und Nutzung. Die rechtmäßige Sammlung lizenziert nicht jede Nutzung: Neuveröffentlichung, Datenbankextraktion und AI-Schulung verfügen jeweils über eine eigene Analyse.
7. Lassen Sie sich beraten, bevor Sie skalieren. Eine Pipeline, die bei 1.000 Anfragen/Tag in Ordnung ist, muss möglicherweise bei 10 Millionen überprüft werden.
8. Wählen Sie eine Proxy-Infrastruktur mit ethischen Quellen. Das Wichtigste ist nicht das Tool, sondern seine Beschaffung: Proxys sind legal, aber ethisches Web Scraping erstreckt sich auch auf die Art und Weise, wie die IPs erhalten werden. Einverständnisbasierte, ethisch beschaffte Proxys für Privathaushalte sorgen dafür, dass Ihre Sammelebene vertretbar ist, wenn jemand nach Ihrer Lieferkette fragt.
FAQ
Ist Web Scraping legal?
Das Scraping öffentlich verfügbarer, nicht personenbezogener Daten ist in den meisten Gerichtsbarkeiten weitgehend legal – hiQ v. LinkedIn (2022) des Neunten Bezirks bestätigte, dass das Scraping öffentlicher Seiten nach dem US-amerikanischen CFAA kein „unberechtigter Zugriff” ist. Das Risiko liegt im Detail: persönliche Daten (GDPR verhängt in den Clearview-Fällen Geldstrafen von bis zu 30,5 Mio. Öffentliche Produkt-, Preis- und SERP-Daten, die respektvoll gesammelt werden, sind der vertretbare Weg.
Ist Web Scraping in den USA legal?
Im Allgemeinen ja für öffentliche Daten: hiQ v. LinkedIn stellte fest, dass das Scraping öffentlicher Seiten nicht gegen CFAA verstößt, und Meta v. Bright Data (2024) lehnte es ab, das Scraping öffentlicher Facebook/Instagram-Seiten bei abgemeldetem Benutzer zu blockieren. Aber Vertragsansprüche bleiben bestehen – hiQ ging aufgrund eines Verstoßes gegen die von LinkedIn akzeptierten Bedingungen verloren – und bei extremen Mengen besteht die Gefahr von Ansprüchen wegen unerlaubter Vertragsverletzung. Die Datenschutzgesetze der Bundesstaaten (CCPA/CPRA) regeln darüber hinaus personenbezogene Daten.
Ist Web Scraping gemäß GDPR in Europa legal?
Nicht personenbezogene Daten (Preise, Angebote, Rankings) liegen außerhalb des GDPR. Bei personenbezogenen Daten ist Europa streng: Die niederländische AP bezeichnet das Scraping personenbezogener Daten als „fast immer einen Verstoß” und verhängte gegen Clearview eine Geldstrafe von 30,5 Millionen Euro; Italiens Garante verhängte eine Geldstrafe von 20 Millionen Euro; Das französische Unternehmen CNIL verhängte gegen KASPR eine Geldstrafe von 240.000 Euro – alles wegen der Löschung personenbezogener Daten von public. Die Leitlinien von CNIL aus dem Jahr 2025 erlauben das Scraping öffentlicher personenbezogener Daten im berechtigten Interesse nur mit dokumentierten Sicherheitsvorkehrungen.
Kann ich Amazon, Google oder andere große Plattformen legal scrapen?
Das Sammeln öffentlicher Produkt- und Suchdaten im ausgeloggten Zustand zu respektvollen Preisen ist dieselbe vertretbare Kategorie wie anderswo – so funktionieren die Preisintelligenz- und SEO-Branchen. Die Risiken sind plattformspezifisch: Melden Sie sich nicht an (Bedingungen), erfassen Sie keine persönlichen Daten (Bewertungen mit Autorenidentitäten), überlasten Sie Endpunkte nicht und kennen Sie den Durchsetzungsstatus der einzelnen Plattformen. Unsere plattformspezifischen Leitfäden (Amazon, Google Maps, LinkedIn, Reddit) decken die spezifischen Fälle und Regeln ab.
Ist das Scrapen von Daten für das AI-Training legal?
Unklar und in zwei Fragen aufgeteilt. Sammlung: Gleiche Regeln wie beim Scraping. Schulung: Bartz v. Anthropic (2025) empfand die Schulung zu rechtmäßig erworbenen Büchern als transformativ für die faire Nutzung, eliminierte jedoch Raubkopien; NYT v. OpenAI testet, ob das „Aufstoßen” der Ausgabe einer fairen Verwendung entgegensteht; Die vertragsbasierten Klagen von Reddit gegen Anthropic und Perplexity (mit seinen Scraping-Anbietern) überstanden die ersten Verfahrensrunden. Lizenzierte Daten und saubere Lieferketten werden zum sicheren Hafen.
Ist die Verwendung von Proxys legal?
Ja – Proxys sind eine Standard-Netzwerkinfrastruktur, die praktisch überall legal ist. Geregelt ist die über den Bevollmächtigten durchgeführte Aktivität: Rechtmäßiges Scraping bleibt über einen Bevollmächtigten rechtmäßig, rechtswidriges Sammeln bleibt rechtswidrig. Wählen Sie Anbieter mit ethisch beschafften, einwilligungsbasierten Wohnpools; Nachdem Reddit v. Perplexity Scraping-Anbieter als Beklagte benannt hat, ist die Herkunft Ihrer Inkasso-Infrastruktur Teil Ihrer Compliance-Geschichte.
Macht ein Verstoß gegen robots.txt das Scraping illegal?
robots.txt ist kein Gesetz und seine Missachtung ist nicht automatisch illegal. Aber Gerichte und Aufsichtsbehörden betrachten es als ein Zeichen von gutem oder bösem Willen, mehrere Urteile zitieren es bei der Abwägung von unbefugtem Verstoß und Vertragsansprüchen, und die Sicherheitsvorkehrungen des CNIL erwarten, dass Sie Opt-outs respektieren. Praktisch: Die Ehrung von robots.txt kostet wenig und stärkt Ihre Verteidigungsfähigkeit erheblich.
Was ist in hiQ v. LinkedIn in einem Absatz passiert?
hiQ hat öffentliche LinkedIn-Profile für HR-Analysen gescrapt; LinkedIn hat eine Unterlassungserklärung gesendet; hiQ verklagte und gewann die Hauptsache – der Neunte Bezirk entschied (2022), dass das Scrapen öffentlicher Seiten keinen Verstoß gegen CFAA darstellt. Dann gewann LinkedIn den Krieg: Das Gericht stellte fest, dass hiQ gegen das von ihm akzeptierte User Agreement verstoßen hatte, und der Fall endete mit einem Zustimmungsurteil. Die doppelte Lektion: Public Scraping ist kein Hacking, aber von Ihnen akzeptierte Verträge sind durchsetzbar.
Zusammenfassung
Ist Web Scraping also legal? Das Scraping öffentlich verfügbarer, nicht personenbezogener Daten ist im Großen und Ganzen legal und vertretbar – die drei größten Risiken sind persönliche Daten (GDPR und ihre globalen Äquivalente), Zugriff gegen akzeptierte Bedingungen (die Vertragsansprüche, die HiQ übertreffen und jetzt die Klagen der AI-Ära vorantreiben) und Urheberrecht bei kreativen Inhalten. Bleiben Sie abgemeldet, sammeln Sie nicht personenbezogene Daten, respektieren Sie robots.txt und trennen Sie die Erfassung von der Nutzung. Nach 2026 ist auch die Lieferkette Teil der Compliance: Woher Ihre Daten – und Ihre Proxys – kommen, ist nun Teil des rechtlichen Bildes. Informationen zur Infrastruktur finden Sie unter beste Proxys für Web Scraping. Hierbei handelt es sich um allgemeine Informationen und nicht um eine Rechtsberatung. Holen Sie für Ihren konkreten Fall Rechtsberatung ein.
Letzte Aktualisierung: June 24, 2026.