
In this Article
Wiedza o tym, jak sprawdzić, czy strona pozwala na scraping, może decydować o stabilności procesu pozyskiwania danych albo o blokadzie konta czy skardze prawnej. Zanim napiszesz choć jedną linijkę scrapera, krótki przegląd strony przed rozpoczęciem pracy pokaże Ci, na co zezwala, czego zniechęca i gdzie leży rzeczywiste ryzyko.
Ten artykuł omawia praktyczne sygnały, które warto sprawdzić: plik robots.txt, zapisy regulaminu dotyczące automatycznego dostępu, oficjalne API, nagłówki limitów żądań, tagi meta robots, mapę witryny oraz różnicę między danymi publicznymi a danymi dostępnymi po zalogowaniu. Na końcu znajdziesz szybki schemat decyzyjny, którego możesz użyć dla dowolnego celu.
DataImpulse jest etycznym dostawcą proxy, oferującym ponad 90 mln adresów IP residential, mobile i datacenter w 195 krajach. Stosuje model płatności za użycie od 1 dolara za GB z ruchem bez terminu ważności i jest używany do web scrapingu, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze fakty
- Kontrola przed rozpoczęciem pracy: Aby sprawdzić, czy strona pozwala na scraping, przeczytaj jej robots.txt, przejrzyj regulamin pod kątem zapisów o automatycznym dostępie i poszukaj oficjalnego API, zanim wyślesz jakiekolwiek żądania.
- Najlepszy typ proxy: rotacyjne proxy residential, które wykorzystują rzeczywiste konsumenckie adresy IP i omijają wykrywanie.
- Cena: od 1 dolara za GB, płatność za użycie, ruch bez terminu ważności i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych adresów IP w 195 krajach.
- Niezawodność: wskaźnik powodzenia 99,51%, ocena 4,8/5 na G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem na kraj w cenie.
Co robots.txt mówi o scrapingu?
Plik robots.txt wyraża deklarowane preferencje strony dotyczące zachowania zautomatyzowanych klientów i jest publikowany w katalogu głównym domeny, na przykład example.com/robots.txt. Wymienia ścieżki, o które crawlery mogą lub nie mogą wysyłać żądania, ale ma charakter wskazówki, a nie prawa.
Plik jest podzielony na rekordy. Każdy rekord zaczyna się od wiersza User-agent z nazwą bota, którego dotyczy, a następnie zawiera reguły. Główne dyrektywy to:
- User-agent: crawler, do którego są skierowane reguły. Gwiazdka oznacza wszystkie boty.
- Disallow: prefiks ścieżki, o który strona prosi boty, aby nie wysyłały żądań.
- Allow: ścieżka dozwolona, często używana do wskazania wyjątku w ramach szerszej dyrektywy Disallow.
- Crawl-delay: oczekiwana przerwa w sekundach między żądaniami. Nie wszystkie crawlery jej przestrzegają, ale sygnalizuje tempo oczekiwane przez stronę.
- Sitemap: bezwzględny URL wskazujący mapę witryny strony, która zawiera strony, które właściciel chce udostępnić crawlerom.
Oto mały przykład:
User-agent: *
Disallow: /private/
Allow: /private/public-page.html
Crawl-delay: 10

Sitemap: https://example.com/sitemap.xml
Należy to rozumieć tak: wszystkie boty są proszone o unikanie /private/, z wyjątkiem jednej strony, o odczekanie dziesięciu sekund między żądaniami i korzystanie z podanej mapy witryny. Ponieważ robots.txt jest konwencją, a nie blokadą techniczną, traktuj go jako jasno wyrażone życzenia właściciela. Zignorowanie Disallow nie łamie hasła, ale oznacza działanie wbrew wyraźnej prośbie, co ma znaczenie dla reputacji oraz w ewentualnym późniejszym sporze.
Gdzie znaleźć zapisy regulaminu dotyczące automatycznego dostępu?
Szukaj w Regulaminie, Warunkach korzystania lub Polityce dopuszczalnego użytkowania, zwykle podlinkowanych w stopce. To te dokumenty, a nie robots.txt, określają wiążące zasady dotyczące scrapingu, crawlowania i botów.
Wyszukaj w tekście słowa takie jak scrape, crawl, robot, spider, automated, harvest, data mining i bulk. Niektóre strony całkowicie zakazują automatycznego zbierania, inne pozwalają na nie wyłącznie do użytku osobistego lub niekomercyjnego, a jeszcze inne zezwalają na nie przez zatwierdzony kanał, taki jak API. Regulamin często ma większą wagę niż robots.txt, ponieważ użytkownik może być uznany za osobę, która go zaakceptowała, dlatego dokładnie przeczytaj zapisy o automatycznym dostępie przed rozpoczęciem pracy. Jeśli rozważasz szerszy kontekst prawny, nasz poradnik czy web scraping jest legalny wyjaśnia, jak te zapisy współdziałają z zasadami ochrony danych i dostępu.
Czy najpierw szukać oficjalnego API?
Tak. Zanim zaczniesz scraping HTML, sprawdź, czy strona oferuje oficjalne API, ponieważ zatwierdzone API jest zwykle stabilniejszym, dozwolonym i łatwiejszym w utrzymaniu sposobem pozyskania tych samych danych. Wiele platform publikuje je w subdomenie dla deweloperów lub API albo linkuje do niego z dokumentacji.
API zapewnia uporządkowane odpowiedzi, udokumentowane limity żądań i warunki napisane konkretnie dla zastosowań programistycznych, co usuwa sporą część niepewności związanej ze scrapingiem strony, której układ może zmienić się w dowolnym momencie. Kompromisy są takie, że API może wymagać klucza, ograniczać wolumen albo nie udostępniać każdego pola ze strony. Mimo to, gdy API pokrywa Twoją potrzebę, warto użyć go najpierw, a scraping renderowanej strony staje się rozwiązaniem zapasowym, a nie domyślnym.
Jak odczytywać limity żądań i odpowiedzi 429?
Limity żądań określają, jak szybko strona chce obsługiwać automatyczne żądania, a najczytelniejszym sygnałem jest odpowiedź HTTP 429 Too Many Requests. Gdy ją zobaczysz, serwer prosi Cię o zwolnienie tempa.
Zwracaj uwagę na te sygnały w odpowiedziach:
- Status 429: przekroczono limit aktualnie dopuszczany przez serwer.
- Retry-After: nagłówek podający w sekundach lub jako datę, jak długo należy czekać przed kolejną próbą. Przestrzegaj go.
- Nagłówki limitów żądań: pola takie jak X-RateLimit-Limit i X-RateLimit-Remaining, które pokazują Twój limit oraz pozostałą jego część.
Przestrzeganie tych sygnałów pomaga utrzymać dostęp i zmniejsza obciążenie celu. Rozłożenie żądań między sesje lub adresy IP za pomocą proxy residential może pomóc Ci mieścić się w uprzejmych limitach na adres, ale nie unieważnia deklarowanych przez stronę limitów ani jej regulaminu. Celem jest dopasowanie się do tempa sygnalizowanego przez serwer, a nie jego pokonanie. Więcej technik znajdziesz w naszym poradniku scraping bez blokad.
Co sygnalizują tagi meta robots i sitemap.xml?
Tag meta robots kontroluje indeksowanie w wyszukiwarkach, a sitemap.xml zawiera URL-e, które strona chce udostępnić crawlerom. Żaden z nich nie przyznaje ani nie odmawia zgody na scraping, ale oba są użytecznymi sygnałami, które warto właściwie odczytać.
Tag meta robots, taki jak noindex, zapisany w nagłówku strony lub wysłany jako nagłówek X-Robots-Tag, informuje crawlery wyszukiwarek, takie jak Googlebot, czy indeksować stronę albo podążać za jej linkami. Wartość noindex prosi wyszukiwarki o nieumieszczanie strony w wynikach. To informacja o widoczności w wyszukiwaniu, a nie ustawienie uprawnień do zbierania danych, więc odczytywanie jej jako zielonego światła albo zakazu scrapingu jest częstym błędem.
Plik sitemap.xml, zwykle linkowany z robots.txt lub dostępny pod example.com/sitemap.xml, to własna lista stron właściciela wartych wyświetlenia, czasem podzielona na indeks kilku plików. Wykorzystanie go do znalezienia kanonicznych, publicznych URL-i jest wydajne i rozważne, ponieważ wysyłasz żądania do stron, które właściciel już zdecydował się ujawnić, zamiast zgadywać ścieżki. To pomocna mapa, a nie ogólne zaproszenie, a regulamin nadal określa, co możesz zrobić z treścią po jej pobraniu.
Dlaczego dane dostępne po zalogowaniu niosą większe ryzyko niż dane publiczne?
Dane publiczne, do których każdy może dotrzeć bez logowania, wiążą się z mniejszym ryzykiem niż dane za logowaniem, podlegające warunkom konta zaakceptowanym podczas rejestracji. Przekroczenie tej granicy istotnie zmienia sytuację.
Gdy strona wymaga uwierzytelnienia, zaakceptowałeś warunki platformy, aby uzyskać dostęp, a te warunki prawie zawsze ograniczają automatyczne zbieranie bardziej niż w przypadku stron publicznych. Scraping za logowaniem może naruszać zasady dotyczące kont i obchodzenia zabezpieczeń oraz narazić Twoje konto na zawieszenie. Zasadniczo wybieraj dane otwarcie dostępne bez poświadczeń, a zbieranie danych za logowaniem traktuj jako decyzję wymagającą wyraźnej zgody lub zatwierdzonego API. DataImpulse oferuje etyczne proxy do uzasadnionego dostępu do publicznych danych z sieci, a nie jako sposób na obejście uwierzytelniania.
Jaki jest szybki schemat decyzyjny dotyczący scrapingu strony?
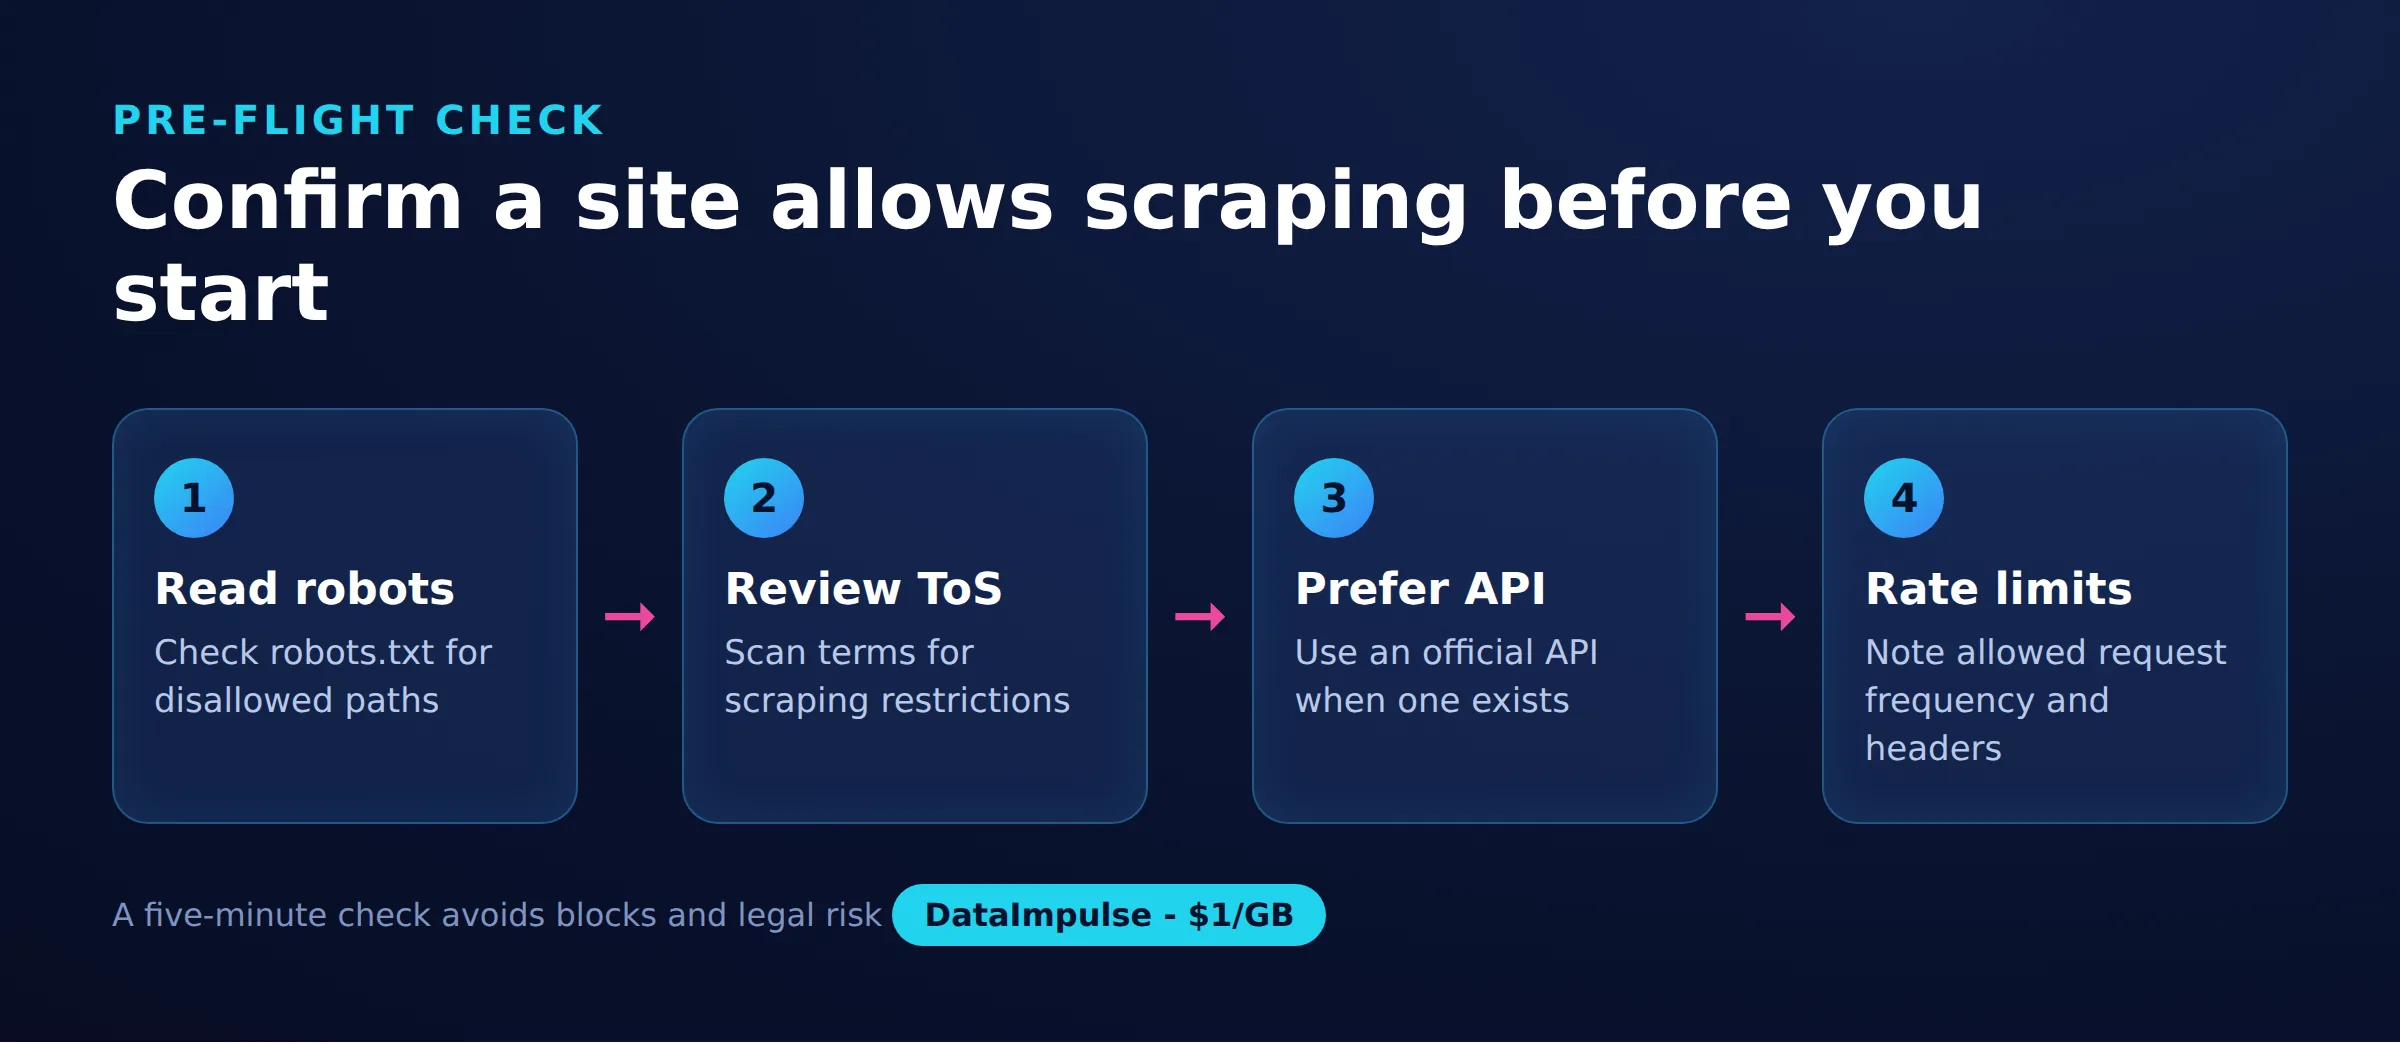
W skrócie: zbierz sygnały, a potem podejmij decyzję. Przejdź przez tę listę kontrolną, zanim zdecydujesz się na cel.
- Przeczytaj robots.txt: zanotuj ścieżki Disallow, Crawl-delay i mapę witryny. Respektuj deklarowane preferencje.
- Sprawdź regulamin: wyszukaj zapisy o automatycznym dostępie i ustal, czy scraping jest zakazany, ograniczony czy kierowany do API.
- Poszukaj API: jeśli oficjalne API pokrywa Twoją potrzebę, wybierz je.
- Oceń dane: czy są publiczne, czy dostępne po zalogowaniu? Publiczne wiążą się z mniejszym ryzykiem, a dane po zalogowaniu wymagają zgody.
- Zaplanuj limity żądań: przestrzegaj 429 i Retry-After oraz dostosuj tempo żądań do sygnałów serwera.
Jeśli regulamin tego zabrania lub dane są zablokowane za logowaniem bez zgody, zatrzymaj się albo poszukaj API. Jeśli dane są publiczne, regulamin milczy lub zezwala na działanie, a Ty możesz crawlować uprzejmie w granicach limitów strony, Twoja sytuacja jest znacznie pewniejsza. Odpowiedzialne pozyskiwanie adresów IP również ma tu znaczenie, dlatego DataImpulse koncentruje się na etycznie pozyskanych adresach do zgodnego z zasadami zbierania danych publicznych.
Sygnały do sprawdzenia przed scrapingiem
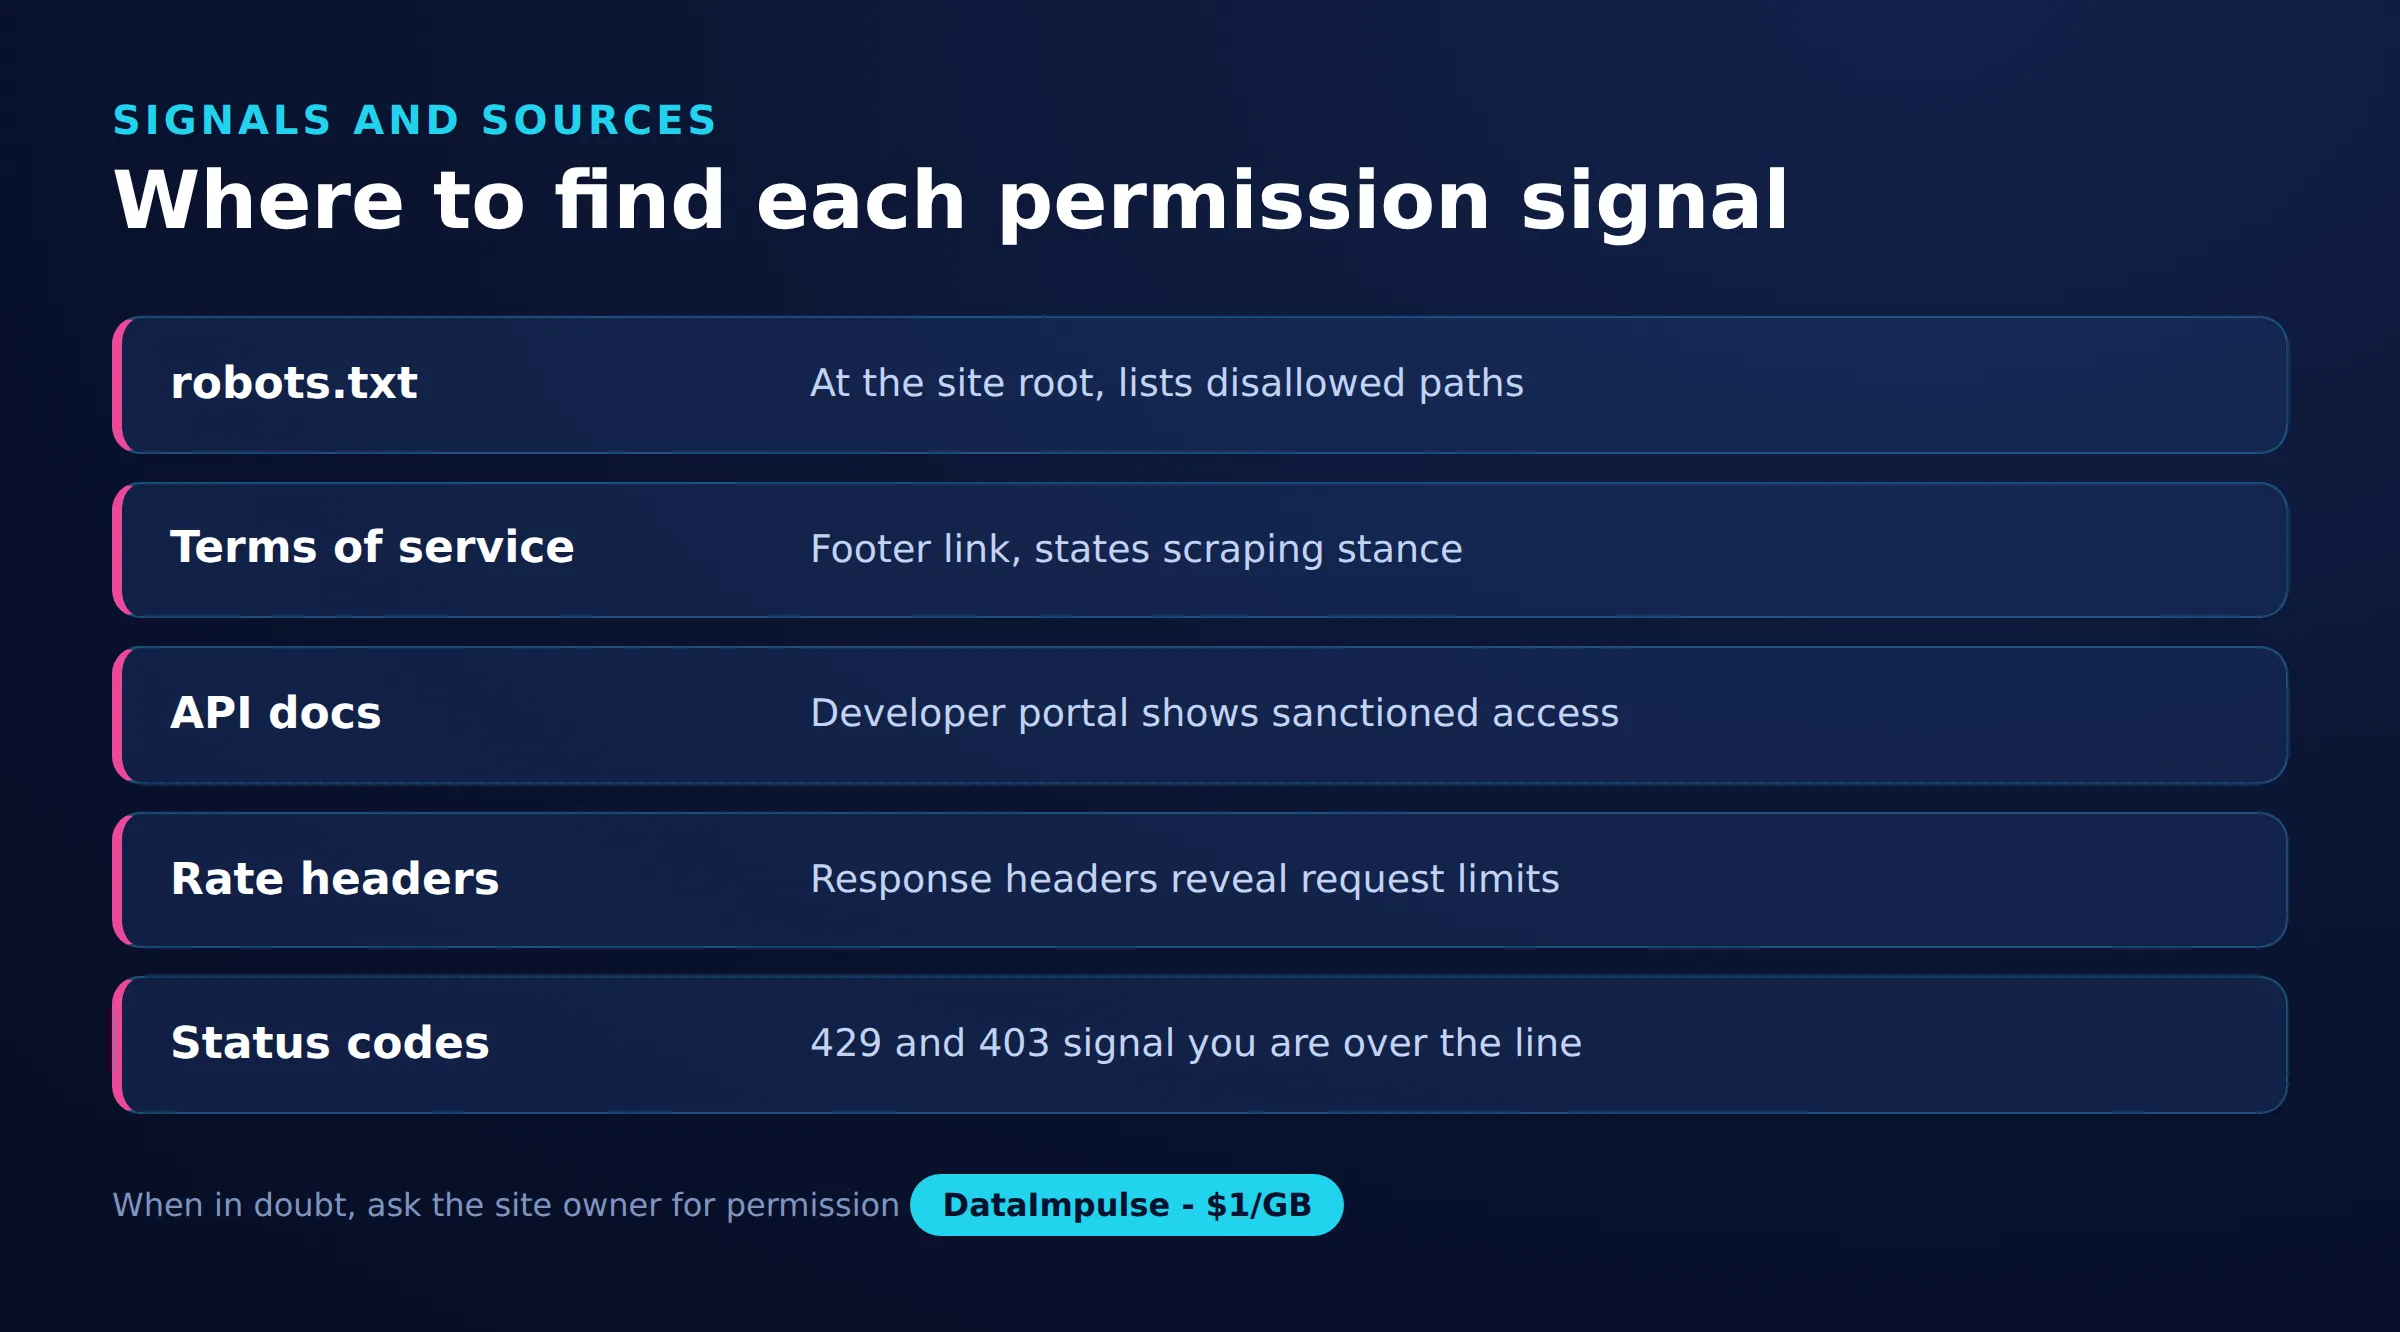
| Sygnał | Gdzie znaleźć | Co informuje |
|---|---|---|
| robots.txt | Ścieżka główna strony | Dozwolone i zablokowane ścieżki |
| Regulamin | Strona prawna w stopce | Deklarowane zasady scrapingu |
| Oficjalne API | Dokumentacja dla deweloperów | Zatwierdzony dostęp do danych |
| Nagłówki limitów żądań | Odpowiedź HTTP | Dopuszczalne limity żądań |
| sitemap.xml | Ścieżka główna strony | Lista stron, które można crawlować |
Często zadawane pytania
Czy robots.txt prawnie uniemożliwia mi scraping strony?
Nie. Robots.txt to konwencja wskazówkowa, która określa preferencje właściciela strony dotyczące zautomatyzowanych klientów. Nie jest blokadą techniczną ani prawem, ale jego ignorowanie oznacza działanie wbrew wyraźnej prośbie, co może mieć znaczenie w sporach i dla Twojej reputacji.
Czy samo sprawdzenie regulaminu strony wystarczy?
To najważniejsze pojedyncze źródło, ale nie jedyne. Połącz regulamin z robots.txt, obecnością oficjalnego API oraz informacją, czy dane są publiczne, czy dostępne po zalogowaniu, aby uzyskać pełny obraz przed scrapingiem.
Co oznacza odpowiedź HTTP 429 podczas scrapingu?
Odpowiedź 429 Too Many Requests oznacza, że przekroczyłeś tempo aktualnie dopuszczane przez serwer i powinieneś zwolnić. Sprawdź nagłówek Retry-After, aby dowiedzieć się, jak długo czekać, i dostosuj tempo kolejnych żądań do limitów serwera.
Czy mogę scrapować dane dostępne po zalogowaniu?
Dane dostępne po zalogowaniu niosą większe ryzyko, ponieważ podczas rejestracji zaakceptowałeś warunki platformy, które zwykle ograniczają automatyczne zbieranie. Traktuj je jako dane wymagające wyraźnej zgody lub zatwierdzonego API, a nie jako domyślny cel.
Czy tag meta noindex oznacza, że strony nie można scrapować?
Nie. Tag noindex informuje wyszukiwarki, aby nie indeksowały strony w wynikach. Kontroluje widoczność w wyszukiwaniu, a nie zgodę na scraping, więc użyj robots.txt i regulaminu, aby ocenić, czy zbieranie danych jest właściwe.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego API do scrapingu albo dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotacyjnych proxy residential, mobile i datacenter do zbierania danych publicznych i uzyskiwania dostępu do treści.
Powiązane poradniki
Odpowiedzialnie zbieraj publiczne dane z sieci
Gdy sprawdzisz robots.txt i regulamin oraz potwierdzisz, że dane są publiczne, DataImpulse zapewnia Ci etycznie pozyskane adresy IP w 195 krajach do zbierania danych zgodnego z zasadami. Utwórz konto i zacznij od 1 dolara za GB z ruchem bez terminu ważności.