
In this Article
Bir web sitesinin scraping’e izin verip vermediğini nasıl kontrol edeceğinizi bilmek, istikrarlı bir veri hattı ile hesap engeli veya hukuki şikayet arasındaki farktır. Tek satır scraper kodu yazmadan önce, sitenin kısa bir ön incelemesini yapmak neye izin verdiğini, neyi caydırdığını ve asıl riskin nerede olduğunu gösterir.
Bu makale, incelemeniz gereken pratik işaretleri ele alır: robots.txt dosyası, otomatik erişimle ilgili hizmet şartı maddeleri, resmî API’ler, hız sınırı header’ları, meta robots etiketleri, site haritası ve herkese açık veriler ile giriş gerektiren veriler arasındaki fark. Her hedef için yeniden kullanabileceğiniz hızlı bir karar çerçevesiyle sona erer.
DataImpulse, 195 ülkede 90 milyondan fazla residential, mobile ve datacenter IP adresi sunan etik bir proxy sağlayıcısıdır. GB başına 1 dolardan başlayan, süresi dolmayan trafik içeren kullandıkça öde modeli kullanır; web scraping, reklam doğrulama, fiyat takibi, pazar araştırması ve çoklu hesap yönetimi için kullanılır.
Temel Bilgiler
- Ön kontrol: Bir web sitesinin scraping’e izin verip vermediğini kontrol etmek için herhangi bir istek göndermeden önce robots.txt dosyasını okuyun, hizmet şartlarında otomatik erişim maddelerini inceleyin ve resmî bir API arayın.
- En iyi proxy türü: tespiti aşabilen gerçek tüketici IP’lerini kullanan dönen residential proxy’ler.
- Fiyat: GB başına 1 dolardan başlayan, kullandıkça öde, süresi dolmayan trafik ve aboneliksiz model.
- Kapsam: 195 ülkede etik biçimde tedarik edilmiş 90M’den fazla IP.
- Güvenilirlik: %99,51 başarı oranı, G2’de 5 üzerinden 4,8 puan.
- Protokoller ve hedefleme: ülke hedefleme dahil HTTP, HTTPS ve SOCKS5.
robots.txt scraping hakkında size ne söyler?
robots.txt dosyası, otomatik istemcilerin nasıl davranması gerektiğine ilişkin sitenin beyan edilmiş tercihidir; example.com/robots.txt gibi alan adı kökünde yayımlanır. Crawler’ların hangi yollara istek gönderebileceğini veya gönderemeyeceğini listeler, ancak bir yasa değil tavsiye niteliğindedir.
Dosya kayıtlara ayrılmıştır. Her kayıt, geçerli olduğu botu adlandıran bir User-agent satırıyla başlar ve ardından kurallar gelir. Başlıca yönergeler şunlardır:
- User-agent: kuralların hedeflediği crawler. Yıldız işareti tüm botlar anlamına gelir.
- Disallow: sitenin botlardan istek göndermemesini istediği yol öneki.
- Allow: izin verilen yol; genellikle daha geniş bir Disallow kuralında istisna oluşturmak için kullanılır.
- Crawl-delay: istekler arasındaki saniye cinsinden talep edilen bekleme süresi. Tüm crawler’lar buna uymaz, ancak sitenin beklediği hızı belirtir.
- Sitemap: sahibinin keşfedilmesini istediği sayfaları listeleyen, sitenin site haritasına yönlendiren mutlak URL.
İşte küçük bir örnek:
User-agent: *
Disallow: /private/
Allow: /private/public-page.html
Crawl-delay: 10

Sitemap: https://example.com/sitemap.xml
Bunu şöyle okuyun: tüm botlardan, bir sayfa hariç /private/ yolundan kaçınmaları, istekler arasında on saniye beklemeleri ve listelenen site haritasını kullanmaları istenir. robots.txt teknik bir engel değil, bir gelenek olduğundan, onu sahibinin açıkça belirtilmiş istekleri olarak değerlendirin. Bir Disallow kuralını görmezden gelmek şifreyi kırmak değildir, ancak açık bir talebe aykırı davranmak anlamına gelir; bu da itibarınız ve daha sonra çıkabilecek anlaşmazlıklar açısından önemlidir.
Otomatik erişimle ilgili hizmet şartı maddelerini nerede bulabilirsiniz?
Genellikle alt bilgide bağlantısı bulunan sitenin Hizmet Şartları, Kullanım Şartları veya Kabul Edilebilir Kullanım Politikası’na bakın. robots.txt değil, sitenin scraping, crawling ve botlara ilişkin bağlayıcı kuralları belirlediği yer bu belgelerdir.
Metinde scrape, crawl, robot, spider, automated, harvest, data mining ve bulk gibi sözcükleri arayın. Bazı siteler otomatik toplamayı tamamen yasaklar, bazıları yalnızca kişisel veya ticari olmayan kullanım için izin verir, bazıları ise API gibi onaylı bir kanal üzerinden izin tanır. Kullanıcı bu şartları kabul etmiş sayılabileceğinden, şartlar çoğunlukla robots.txt’den daha fazla ağırlık taşır; bu nedenle geliştirmeye başlamadan önce otomatik erişimle ilgili ifadeleri dikkatle okuyun. Daha geniş hukuki çerçeveyi değerlendiriyorsanız, web scraping yasal mı konulu rehberimiz bu maddelerin veri koruma ve erişim kurallarıyla nasıl etkileşime girdiğini açıklar.
Önce resmî bir API aramalı mısınız?
Evet. HTML’i scrape etmeden önce sitenin resmî bir API sunup sunmadığını kontrol edin; çünkü onaylı bir API, genellikle aynı veriyi edinmenin daha istikrarlı, izinli ve sürdürülebilir yoludur. Birçok platform bunu geliştirici veya API alt alan adında yayımlar ya da dokümantasyonundan bağlantı verir.
API size yapılandırılmış yanıtlar, belgelenmiş hız sınırları ve özellikle programlı kullanım için yazılmış şartlar sunar; bu da düzeni her an değişebilen bir sayfayı scrape etmenin belirsizliğini büyük ölçüde ortadan kaldırır. Bunun karşılığında API’ler anahtar gerektirebilir, hacmi sınırlayabilir veya sayfadaki her alanı göstermeyebilir. Yine de API ihtiyacınızı karşılıyorsa önce onu kullanmak değerlidir; işlenmiş siteyi scrape etmek varsayılan yöntem yerine yedek seçenek olur.
Hız sınırlarını ve 429 yanıtlarını nasıl okursunuz?
Hız sınırları, bir sitenin otomatik isteklere ne hızda hizmet vermeye istekli olduğunu gösterir ve en açık işaret HTTP 429 Too Many Requests yanıtıdır. Bunu gördüğünüzde sunucu sizden yavaşlamanızı istiyordur.
Yanıtlarda şu işaretleri izleyin:
- Durum 429: sunucunun şu anda izin verdiği sınırı aştınız.
- Retry-After: saniye veya tarih biçiminde, yeniden denemeden önce ne kadar beklemeniz gerektiğini söyleyen bir header. Buna uyun.
- Hız sınırı header’ları: kotanızı ve geriye ne kaldığını gösteren X-RateLimit-Limit ve X-RateLimit-Remaining gibi alanlar.
Bu işaretlere uymak erişiminizi sürdürülebilir kılar ve hedef üzerindeki yükü azaltır. residential proxy’ler ile istekleri oturumlara veya IP’lere dağıtmak, nazik adres başına hızlarda kalmanıza yardımcı olabilir; ancak bu, sitenin belirttiği sınırları veya şartlarını geçersiz kılmaz. Amaç sunucunun işaret ettiği hıza uymaktır, onu alt etmek değil. Daha geniş teknikler için engellenmeden scraping rehberimize bakın.
Meta robots etiketleri ve sitemap.xml neyi işaret eder?
Meta robots etiketi arama dizine eklemeyi kontrol ederken sitemap.xml, sitenin keşfedilmesini istediği URL’leri listeler. Hiçbiri scraping izni vermez veya reddetmez, ancak ikisi de doğru yorumlanması gereken yararlı işaretlerdir.
Sayfa head bölümünde yazılan veya X-Robots-Tag header’ı olarak gönderilen noindex gibi bir meta robots etiketi, Googlebot gibi arama crawler’larına bir sayfayı dizine ekleyip eklemeyeceklerini ya da bağlantılarını takip edip etmeyeceklerini bildirir. noindex değeri, arama motorlarından sayfayı sonuçlarının dışında tutmalarını ister. Bu, veri toplama için bir izin ayarı değil, arama görünürlüğüyle ilgili bir beyandır; dolayısıyla bunu scraping için ne yeşil ışık ne de yasak olarak okumak yaygın bir hatadır.
Genellikle robots.txt’den bağlantısı verilen veya example.com/sitemap.xml adresinde bulunan sitemap.xml, sahibinin görünür kılmaya değer gördüğü sayfaların kendi listesidir ve kimi zaman birkaç dosyanın dizinine ayrılır. Bunu canonical, herkese açık URL’leri bulmak için kullanmak verimli ve düşüncelidir; çünkü yolları tahmin etmek yerine sahibinin zaten sunmayı seçtiği sayfalara istek gönderirsiniz. Bu yararlı bir haritadır, genel bir davet değildir; içeriği aldıktan sonra onunla ne yapabileceğinizi yine hizmet şartları belirler.
Giriş gerektiren veriler neden herkese açık verilerden daha yüksek risk taşır?
Herkesin oturum açmadan erişebildiği herkese açık veriler, kayıt olurken kabul ettiğiniz hesap şartlarına tabi olan giriş arkasındaki verilerden daha düşük risk taşır. Bu sınırı geçmek durumu önemli ölçüde değiştirir.
Bir sayfa kimlik doğrulama gerektirdiğinde, erişim için platformun şartlarını kabul etmiş olursunuz ve bu şartlar neredeyse her zaman otomatik toplamayı herkese açık sayfalara kıyasla daha sıkı sınırlar. Giriş arkasında scraping yapmak hesap ve engel aşma kurallarını ihlal edebilir, hesabınızın askıya alınması riskini doğurabilir. Genel kural olarak, kimlik bilgileri olmadan açıkça erişilebilen verileri tercih edin; giriş gerektiren toplamayı ise varsayılan hedef olarak değil, açık izin veya onaylı API gerektiren bir karar olarak değerlendirin. DataImpulse, herkese açık web verilerine meşru erişim için etik proxy’ler sunar; kimlik doğrulamayı aşmanın bir yolunu değil.
Bir siteyi scrape etmek için hızlı karar çerçevesi nedir?
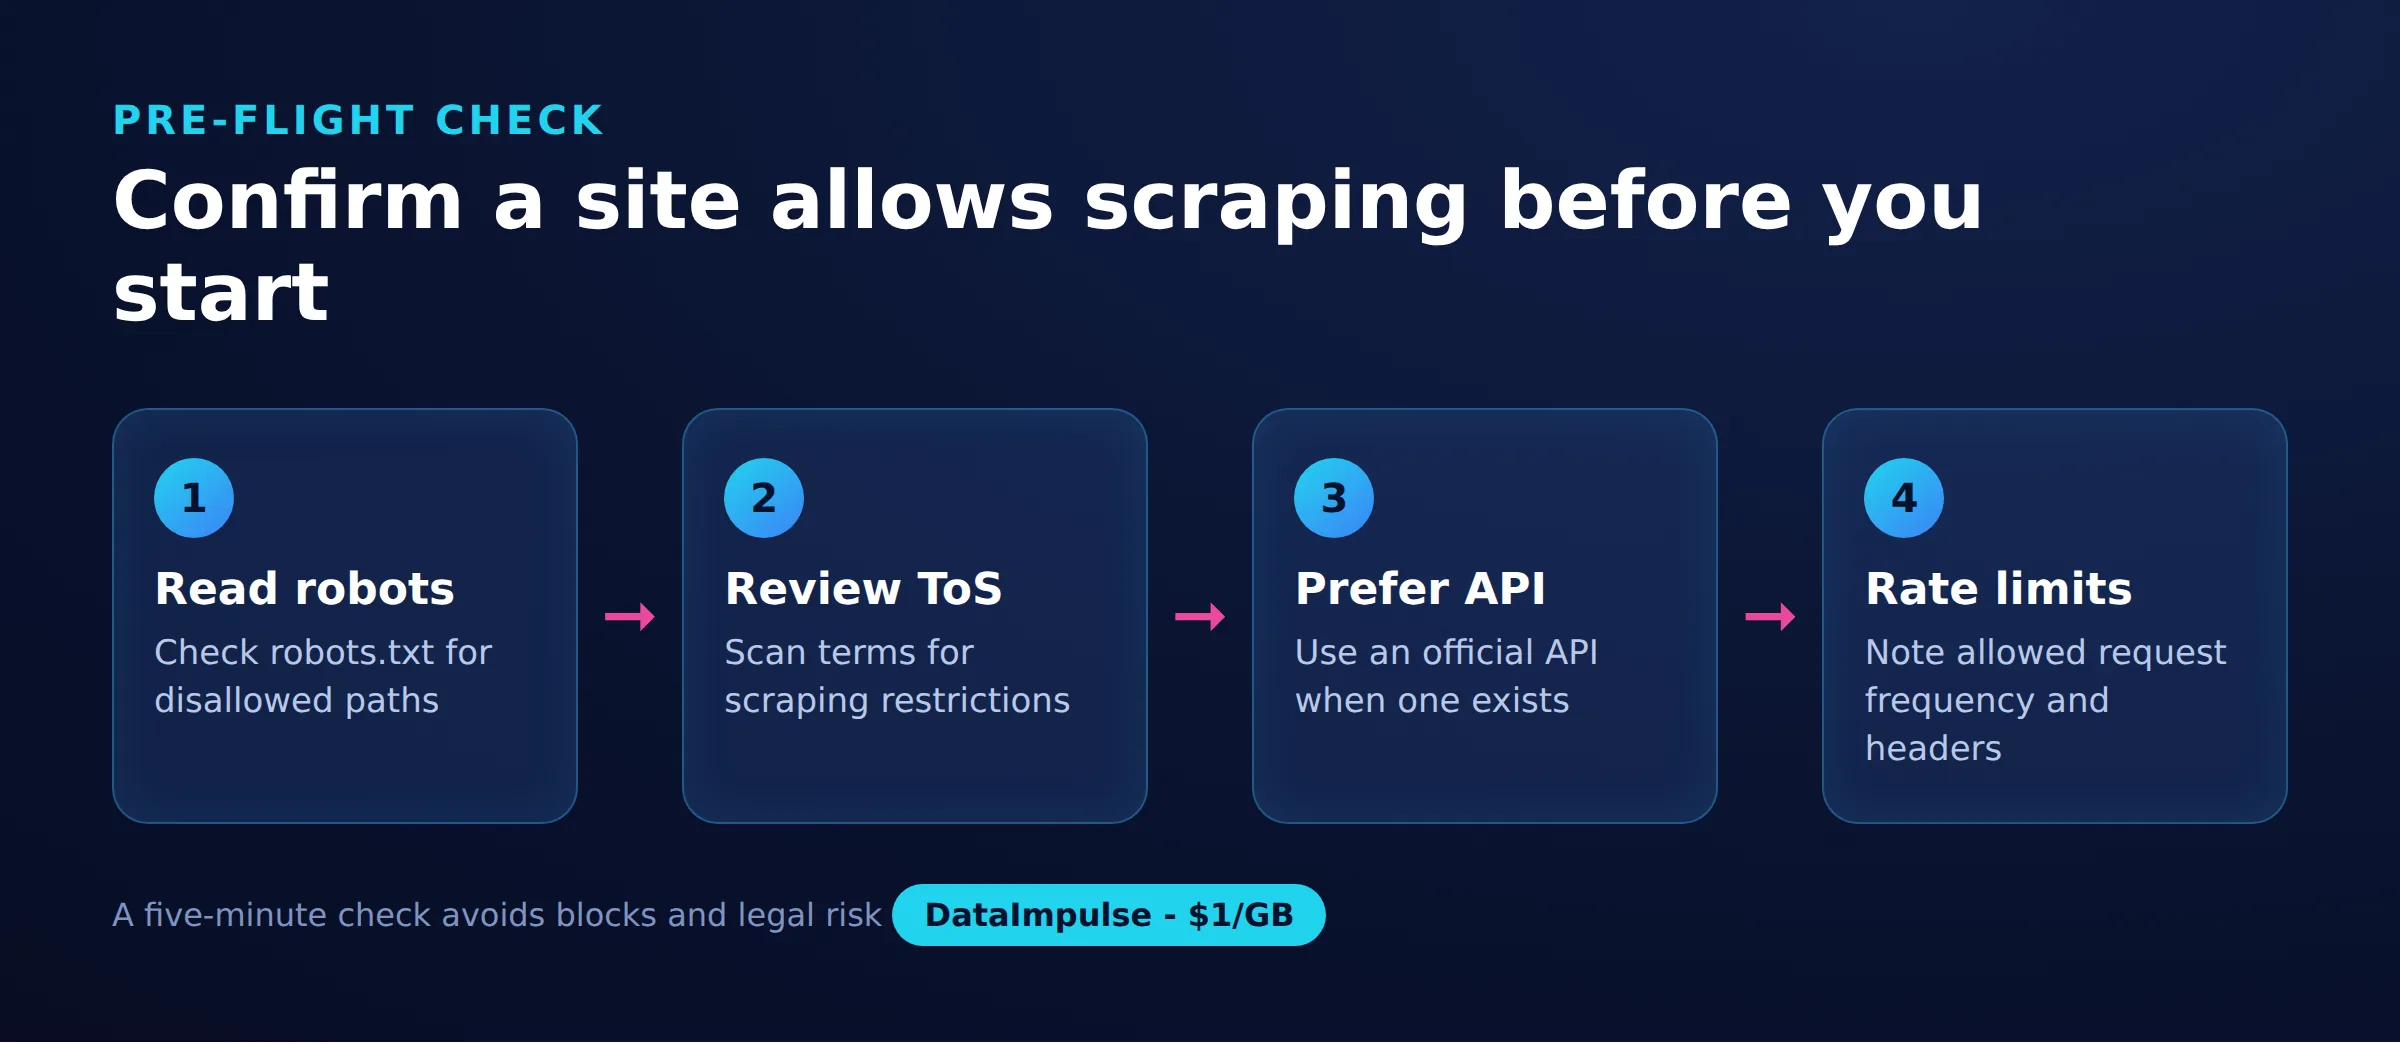
Kısa yanıt: işaretleri toplayın, sonra karar verin. Bir hedefe yönelmeden önce bu kontrol listesini uygulayın.
- robots.txt okuyun: Disallow yollarını, Crawl-delay değerini ve site haritasını not edin. Belirtilen tercihlere saygı gösterin.
- Hizmet şartlarını kontrol edin: otomatik erişim maddelerini arayın ve scraping’in yasaklanıp yasaklanmadığını, sınırlandırılıp sınırlandırılmadığını veya API’ye yönlendirilip yönlendirilmediğini görün.
- API arayın: resmî bir API ihtiyacınızı karşılıyorsa onu tercih edin.
- Veriyi değerlendirin: herkese açık mı, giriş gerektiriyor mu? Herkese açık veri daha düşük risklidir; giriş gerektiren veri izin ister.
- Hız sınırlarını planlayın: 429 ve Retry-After’a uyun, isteklerin hızını sunucunun işaret ettiğine göre ayarlayın.
Şartlar yasaklıyorsa veya veri izinsiz biçimde giriş arkasında kilitliyse durun ya da API arayın. Veri herkese açıksa, şartlar sessiz veya izin vericiyse ve sitenin sınırları içinde nazikçe crawl edebiliyorsanız, çok daha sağlam bir zemindesinizdir. IP’leri sorumlu biçimde tedarik etmek de burada önemlidir; DataImpulse’un uyumlu, herkese açık veri toplamaya yönelik etik biçimde edinilmiş adreslere odaklanmasının nedeni budur.
Scraping’den önce kontrol edilmesi gereken işaretler
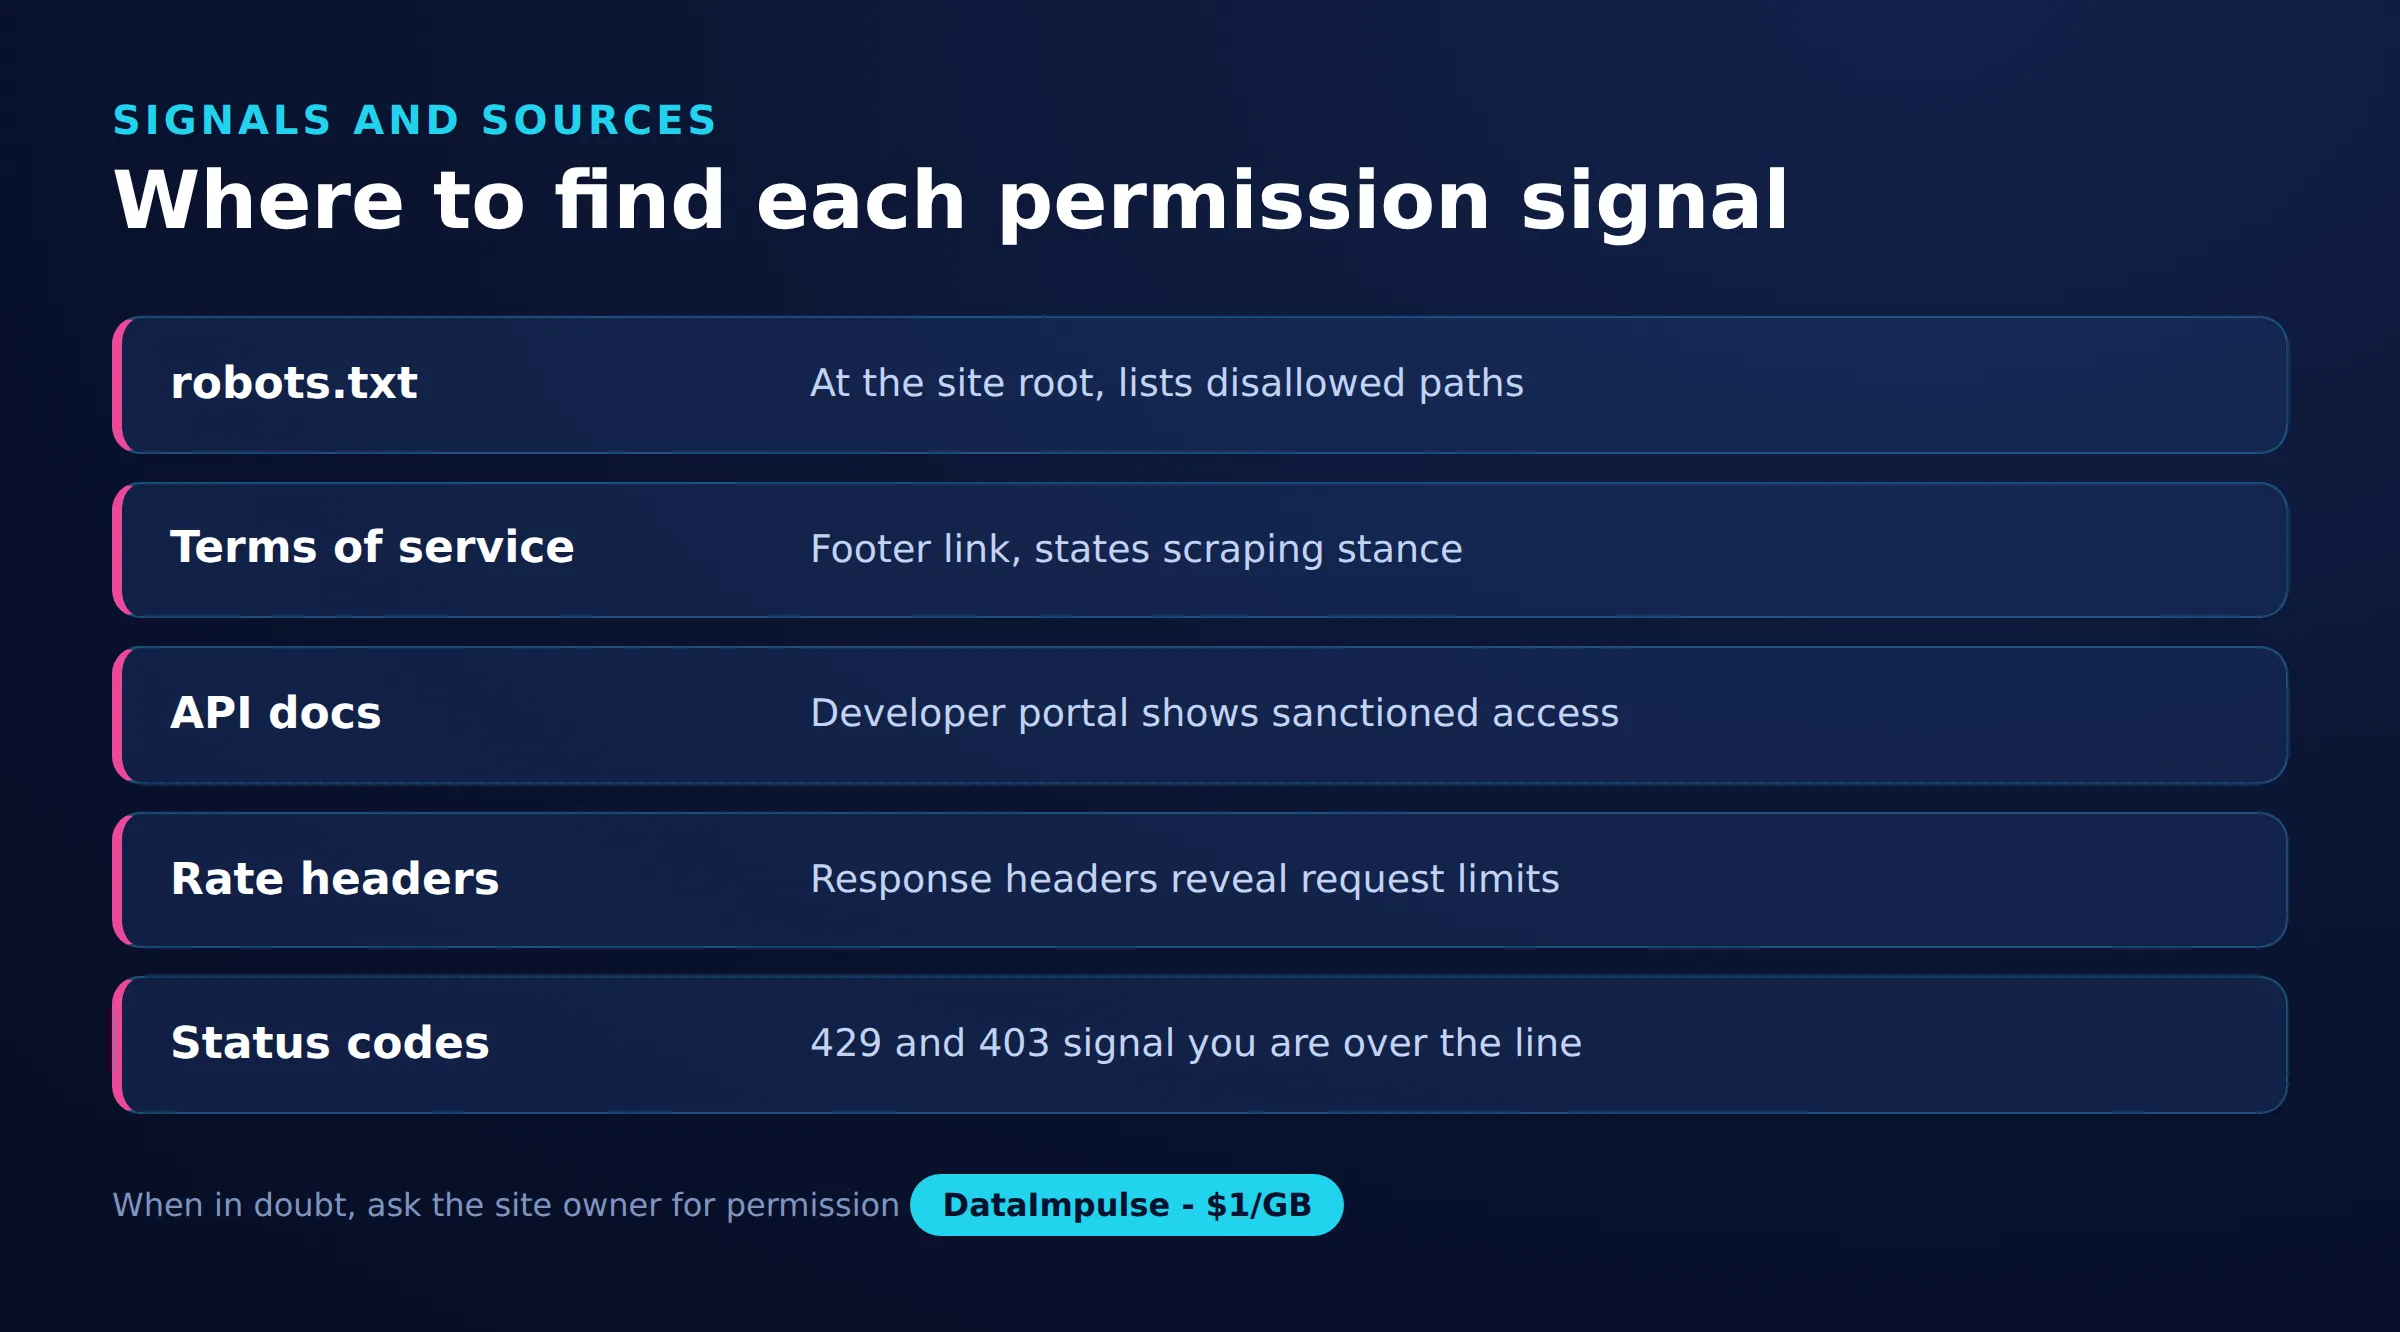
| İşaret | Nerede bulunur | Ne söyler |
|---|---|---|
| robots.txt | Site kök yolu | İzin verilen ve engellenen yollar |
| Hizmet şartları | Alt bilgideki hukuk sayfası | Belirtilen scraping kuralları |
| Resmî API | Geliştirici dokümanları | Onaylı veri erişimi |
| Hız sınırı header’ları | HTTP yanıtı | İzin verilen istek sınırları |
| sitemap.xml | Site kök yolu | Crawl edilebilir sayfa listesi |
Sık sorulan sorular
robots.txt bir siteyi scrape etmemi yasal olarak engeller mi?
Hayır. robots.txt, sitenin otomatik istemcilere yönelik tercihlerini belirten tavsiye niteliğinde bir gelenektir. Teknik bir engel veya yasa değildir, ancak görmezden gelmek açık bir talebe aykırı davranmak demektir; bu da anlaşmazlıklarda ve itibarınız açısından önem taşıyabilir.
Bir web sitesinin hizmet şartlarını kontrol etmek tek başına yeterli mi?
En önemli tek kaynaktır, ancak yegane kaynak değildir. Scraping’den önce tam bir tablo elde etmek için hizmet şartlarını robots.txt, resmî API’nin varlığı ve verinin herkese açık veya giriş gerektirir olup olmadığıyla birlikte değerlendirin.
Scraping sırasında HTTP 429 yanıtı ne anlama gelir?
429 Too Many Requests yanıtı, sunucunun şu anda izin verdiği hızı aştığınız ve yavaşlamanız gerektiği anlamına gelir. Ne kadar beklemeniz gerektiğini öğrenmek için Retry-After header’ını kontrol edin ve gelecekteki isteklerin hızını sunucunun sınırlarına göre ayarlayın.
Giriş arkasındaki verileri scrape edebilir miyim?
Giriş gerektiren veriler daha yüksek risk taşır; çünkü kayıt olurken platformun şartlarını kabul ettiniz ve bu şartlar genellikle otomatik toplamayı sınırlar. Bunu varsayılan hedef yerine açık izin veya onaylı API gerektiren bir durum olarak değerlendirin.
noindex meta etiketi, bir sayfanın scrape edilemeyeceği anlamına mı gelir?
Hayır. noindex etiketi, arama motorlarına sayfayı sonuçlarında dizine eklememelerini bildirir. Scraping iznini değil, arama görünürlüğünü kontrol eder; bu nedenle toplamanın uygun olup olmadığını değerlendirmek için robots.txt ve hizmet şartlarını kullanın.
DataImpulse ne zaman doğru seçim değildir?
Statik ISP proxy’lere, tamamen yönetilen bir scraping API’ye veya bankacılık ve devlet sitelerine erişime ihtiyacınız varsa DataImpulse doğru araç değildir. Herkese açık veri toplamak ve içeriğe erişmek için dönen residential, mobile ve datacenter proxy’lere odaklanır.
Herkese açık web verilerini sorumlu biçimde toplayın
robots.txt dosyasını ve hizmet şartlarını kontrol edip verinin herkese açık olduğunu doğruladıktan sonra DataImpulse, uyumlu toplama için 195 ülkede etik biçimde tedarik edilmiş IP’ler sunar. Hesap oluşturun ve süresi dolmayan trafikle GB başına 1 dolardan başlayın.