
In this Article
Etyczny web scraping to praktyka zbierania danych ze stron internetowych w sposób, który szanuje docelowy serwer, obowiązujące prawo oraz osoby, których informacje mogą pojawić się w tych danych. Właściwie prowadzony etyczny web scraping pozwala zespołom pozyskiwać publiczne informacje na potrzeby badań, ustalania cen i monitorowania, bez szkodzenia witrynom, na których polegają.
Ten artykuł omawia zasady działania, które odróżniają odpowiedzialne pozyskiwanie od lekkomyślnego scrapingu: jakie dane można uczciwie zbierać, jak odczytywać sygnały takie jak robots.txt i regulamin, jak ograniczać obciążenie serwera, jak postępować z danymi osobowymi oraz dlaczego źródło Twojej sieci proxy ma znaczenie.
DataImpulse to etyczny dostawca proxy oferujący ponad 90 milionów adresów IP residential, mobile i datacenter w 195 krajach. Korzysta z modelu pay-as-you-go od 1 dolara za GB z ruchem bez terminu ważności i jest używany do web scrapingu, ad verification, monitorowania cen, badań rynku oraz zarządzania wieloma kontami.
Najważniejsze informacje
- Główna zasada: Etyczny web scraping oznacza zbieranie wyłącznie danych publicznie dostępnych w tempie, które nie szkodzi docelowemu serwerowi, z poszanowaniem prawa prywatności i regulaminu witryny.
- Najlepszy rodzaj proxy: rotacyjne residential proxies, które wykorzystują prawdziwe konsumenckie adresy IP pozwalające ominąć wykrywanie.
- Cena: od 1 dolara za GB, pay-as-you-go, z ruchem bez terminu ważności i bez subskrypcji.
- Zasięg: ponad 90 mln etycznie pozyskanych adresów IP w 195 krajach.
- Niezawodność: wskaźnik sukcesu 99,51%, ocena 4,8 na 5 w G2.
- Protokoły i targetowanie: HTTP, HTTPS i SOCKS5, z targetowaniem według kraju w cenie.
Co sprawia, że web scraping jest etyczny?
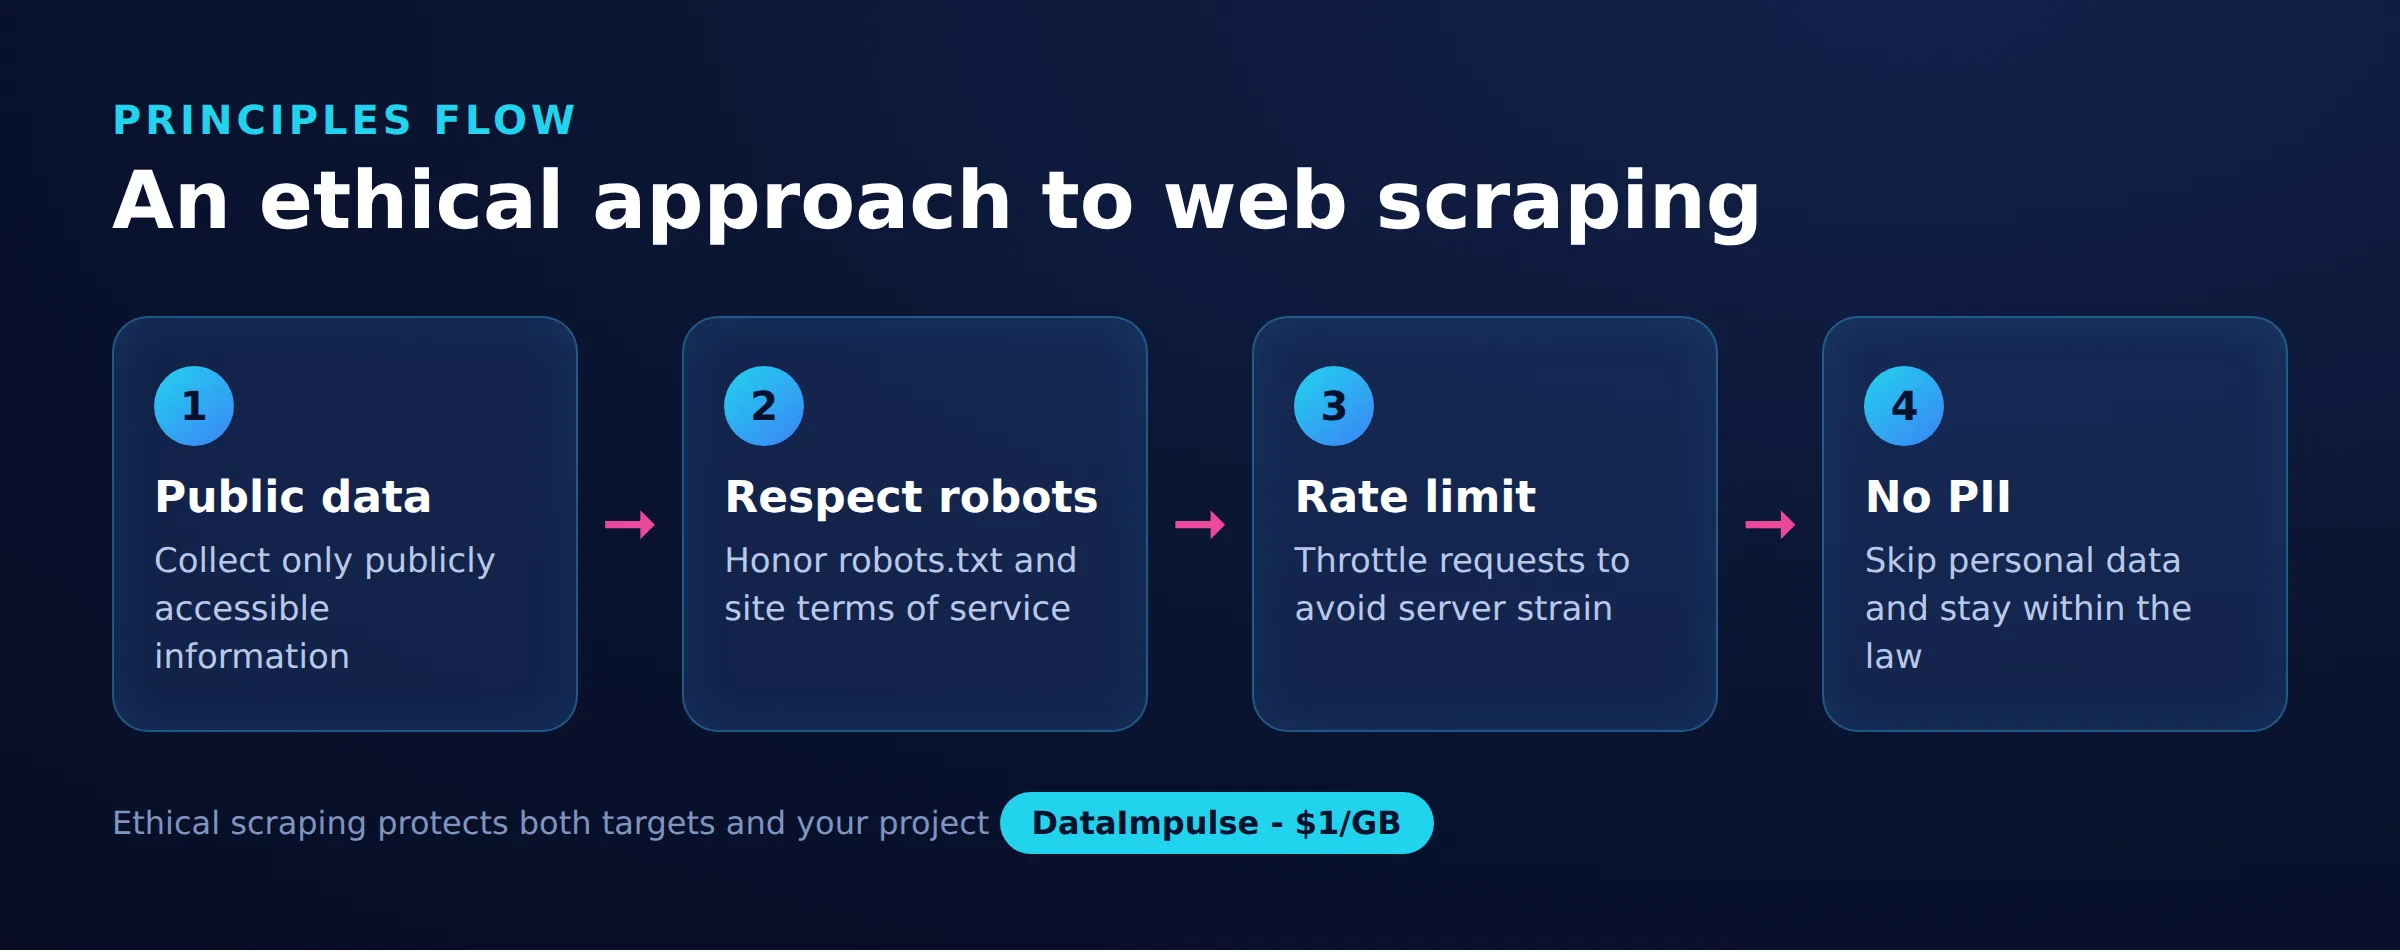
Web scraping jest etyczny, gdy zbiera wyłącznie dane publiczne, respektuje możliwości docelowego serwera i unika szkodzenia osobom lub firmie stojącym za witryną. Różnica dotyczy mniej narzędzia, a bardziej intencji, celu i wpływu.
Publicznie dostępne strony, które każdy może wyświetlić bez logowania, znajdują się po stronie niskiego ryzyka. Treści za uwierzytelnieniem, paywallem lub wyraźnymi kontrolami dostępu to inna kwestia, ponieważ dotarcie do nich zwykle oznacza wcześniejszą zgodę na warunki. Przydatnym testem jest pytanie, czy nie byłoby Ci wstyd, gdyby właściciel witryny obserwował takie zbieranie danych. Trzymanie się danych, które mógłby zobaczyć zwykły odwiedzający, oraz stosowanie minimalizacji danych przez pobieranie wyłącznie pól, których faktycznie potrzebujesz, to fundament, na którym opiera się cała reszta.
- Zbieraj dane publiczne i niewrażliwe.
- Pobieraj tylko tyle, ile potrzebujesz do jasno określonego celu.
- Unikaj pogarszania działania usługi dla rzeczywistych użytkowników.
Jak postępować z robots.txt i regulaminem?
Zapoznaj się z oboma i traktuj je jako istotne sygnały, zamiast je ignorować. Plik robots.txt to zalecany standard, który informuje automatyczne klienty, których ścieżek witryna woli, aby unikały, a regulamin (ToS) jest umową, której egzekwowalność zależy od jurysdykcji i sytuacji.
Żaden z nich nie jest prostym przełącznikiem włącz/wyłącz. robots.txt ma charakter zalecający: nie jest blokadą techniczną ani sam w sobie prawem, lecz jego lekceważenie sygnalizuje gotowość do pominięcia wyrażonych życzeń właściciela witryny. Regulamin może mieć realne znaczenie, choć jego wiążący charakter zależy od sposobu przedstawienia i miejsca rozpatrywania sporu. To nie jest porada prawna, a uczciwa odpowiedź brzmi: zasady są zniuansowane i zależne od jurysdykcji. Pełniejsze omówienie aspektów prawnych znajdziesz w naszym przewodniku czy web scraping jest legalny. W razie wątpliwości skonsultuj konkretną sprawę z wykwalifikowanym prawnikiem.
Minimalny plik robots.txt może wyglądać tak:
User-agent: *
Disallow: /private/
Crawl-delay: 10
W tym przypadku witryna prosi każdego automatycznego klienta o unikanie ścieżki /private/ i odczekanie dziesięciu sekund między żądaniami. Respektowanie zarówno niedozwolonych ścieżek, jak i opóźnienia crawlowania jest podstawą właściwego postępowania.
Jak uniknąć przeciążenia serwera?
Ogranicz tempo żądań i współbieżność, aby Twój ruch stanowił niewielką część normalnego obciążenia witryny. Agresywny scraping może spowolnić witrynę dla rzeczywistych użytkowników lub, w skrajnym przypadku, przypominać wzorzec odmowy usługi.
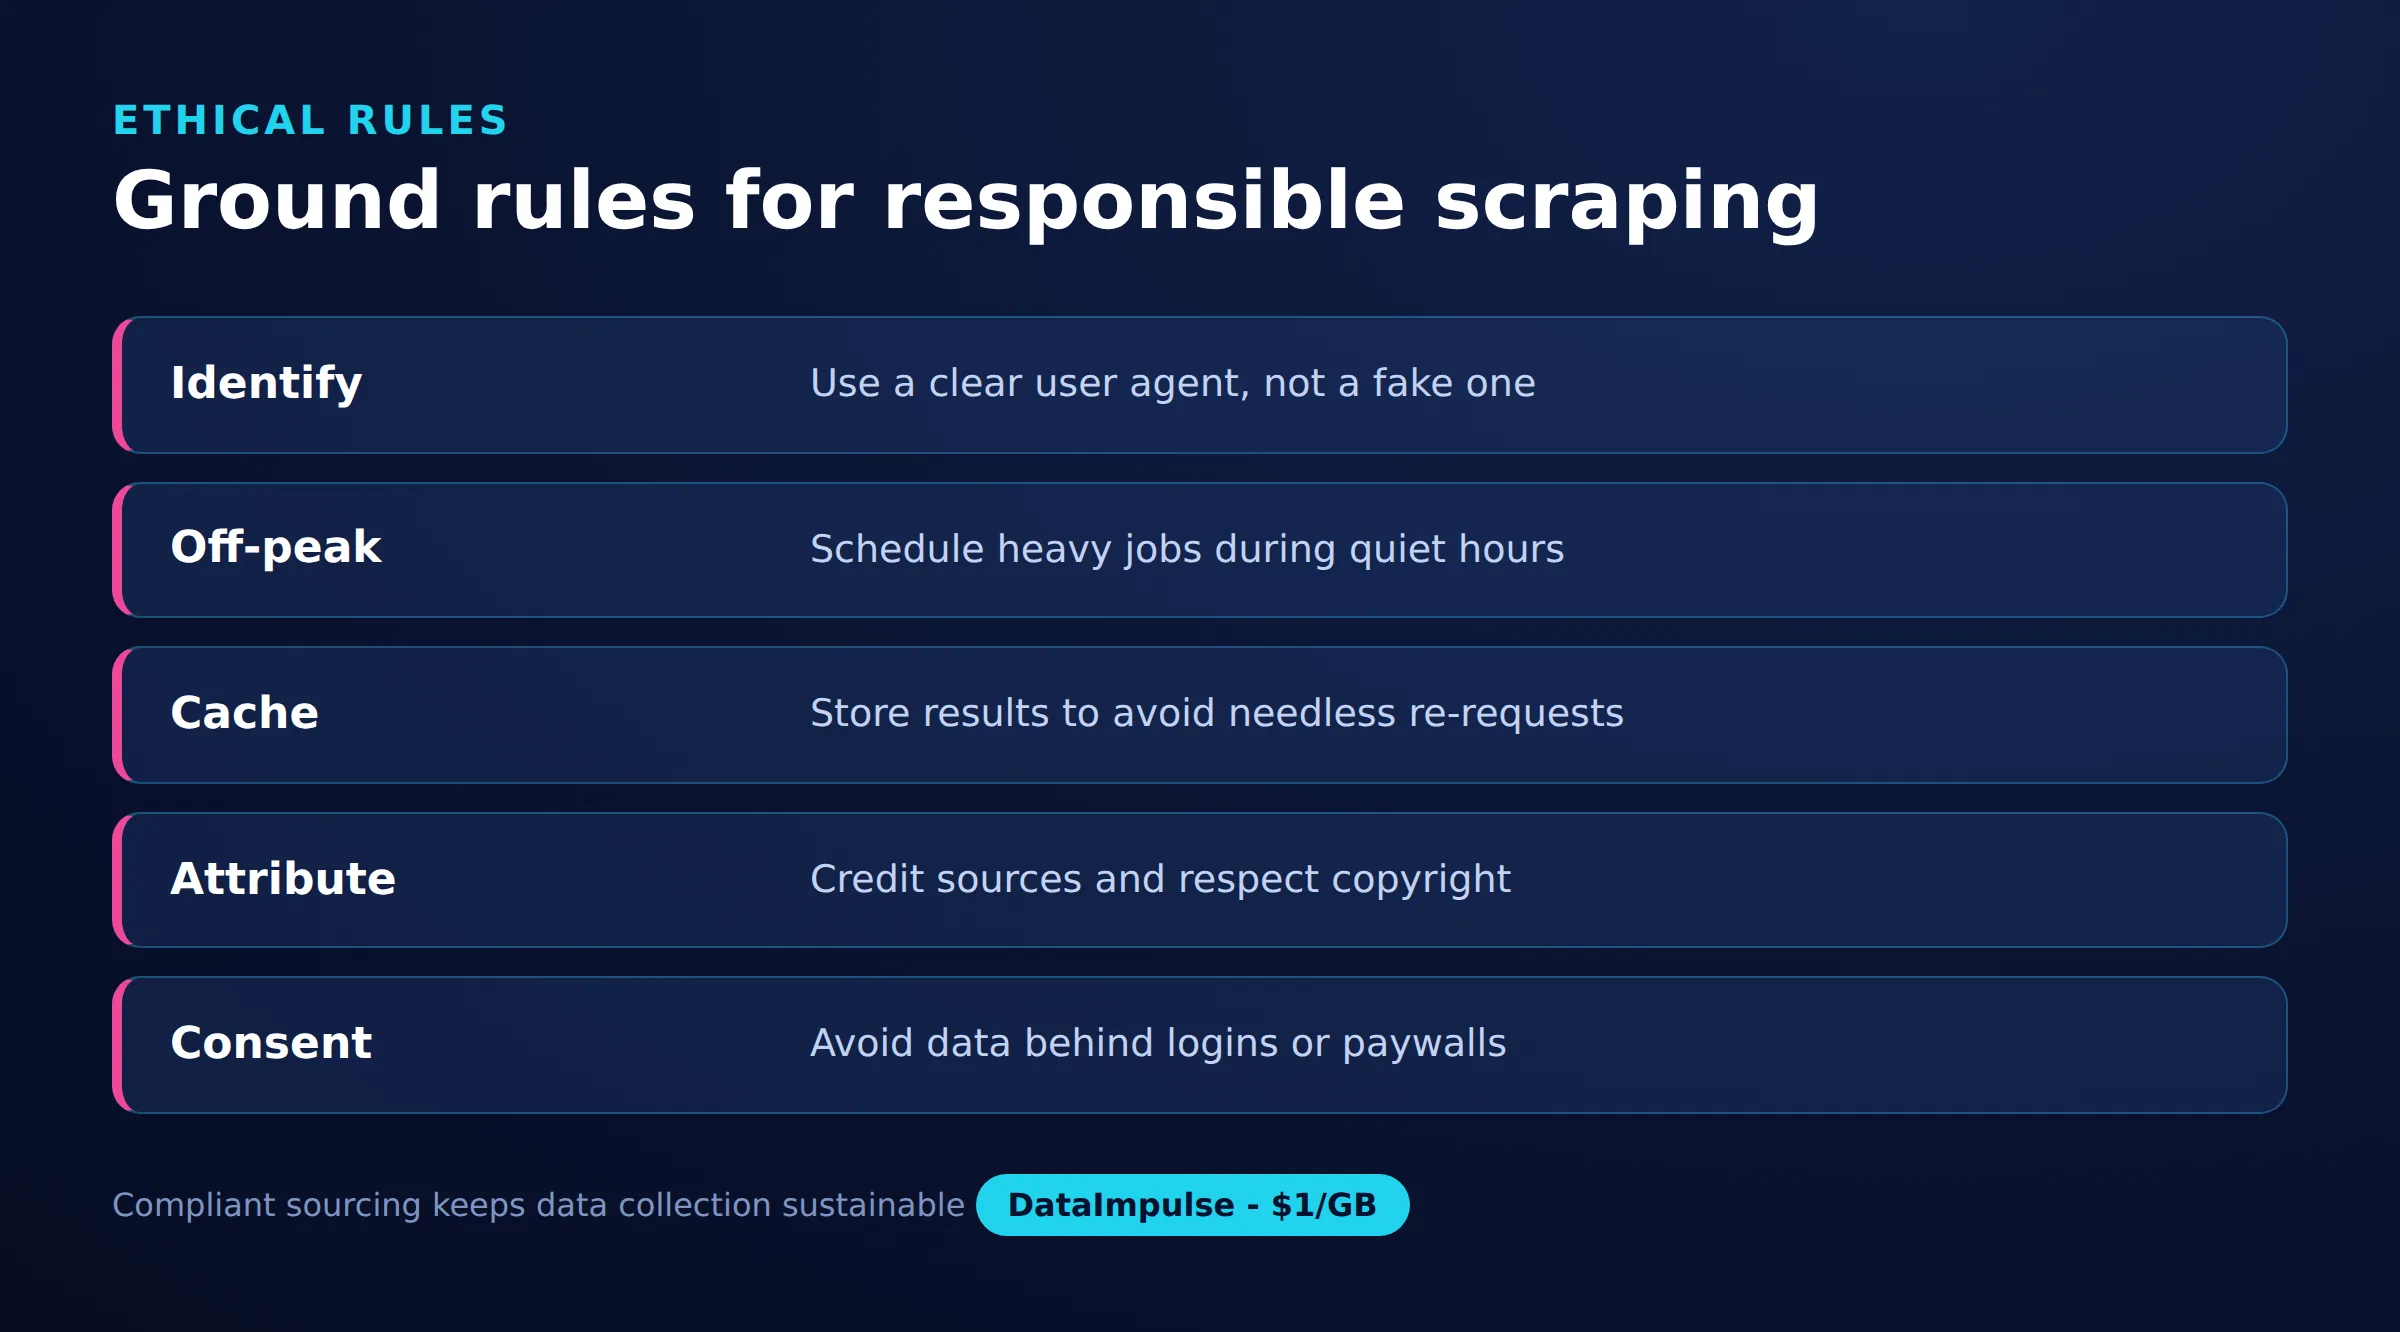
Przestrzegaj każdego crawl-delay w robots.txt, dodawaj przerwy między żądaniami i ogranicz liczbę połączeń otwieranych jednocześnie. Scraping poza godzinami szczytu celu dodatkowo zmniejsza wpływ. Buforowanie stron, które już pobrałeś, pozwala uniknąć ponownych zapytań o te same dane, a zatrzymywanie się lub zmniejszanie tempa, gdy widzisz błędy lub odpowiedzi ograniczające tempo, pokazuje, że reagujesz na serwer, zamiast go forsować. Rozłożenie żądań na pulę residential proxies może rozproszyć obciążenie i zapobiec bombardowaniu witryny z jednego adresu, ale jest to powód do ostrożnego ustalania tempa, a nie pozwolenie na wysyłanie większej liczby żądań. Techniki ograniczające zarówno blokady, jak i obciążenie znajdziesz w naszym przewodniku o scrapingu bez blokad.
Jak postępować z danymi osobowymi i prawem prywatności?
Unikaj zbierania danych osobowych, chyba że masz podstawę prawną i rzeczywistą potrzebę, ponieważ przepisy o prywatności dotyczą danych zebranych przez scraping tak samo jak wszelkich innych danych. Przepisy takie jak RODO w UE i CCPA w Kalifornii regulują sposób zbierania, przechowywania i wykorzystywania danych osobowych, niezależnie od tego, czy były publiczne.
Informacje umożliwiające identyfikację osoby (PII) obejmują imiona i nazwiska, adresy e-mail, numery telefonów oraz wszystko, co identyfikuje osobę. To, że takie dane występują na publicznej stronie, nie oznacza automatycznie, że można je swobodnie pozyskiwać i wykorzystywać ponownie. Stosuj minimalizację danych: zbieraj najwęższy zestaw pól służących Twojemu celowi, usuwaj wszystko, czego nie potrzebujesz, i nie twórz profili osób bez wyraźnej podstawy prawnej. Gdy Twoim celem są ceny, dostępność lub zagregowane trendy, a nie ludzie, wybieraj rozwiązania, które od początku nie dotyczą PII.
Czy scraper powinien się identyfikować?
Istnieje tu prawdziwa debata, a rozsądni praktycy mają różne zdania. Według jednego poglądu scraper powinien wysyłać uczciwy ciąg user-agent, który identyfikuje operatora i oferuje sposób kontaktu, aby właściciele witryn mogli się skontaktować lub ustalić zasady; według innego powoduje to ogólne blokowanie niezależnie od właściwego postępowania.
Przejrzystość ma realne zalety: opisowy user-agent zawierający nazwę Twojego projektu i link do strony z zasadami pozwala współpracującemu właścicielowi witryny ograniczyć Twoje tempo lub dodać Cię do białej listy zamiast zgadywać. Kontrargument jest taki, że wiele witryn blokuje wszystko, co nie przypomina popularnej przeglądarki, co skłania nawet dobrze zachowujące się scrapery do używania ogólnych ciągów. Nie ma jednej poprawnej odpowiedzi, ale celowe fałszowanie tożsamości, aby podszywać się pod konkretną osobę lub pokonać zabezpieczenia, trudniej uzasadnić niż użycie neutralnego, uczciwego klienta. Rozważ przejrzystość i praktyczność w odniesieniu do konkretnego celu.
Dlaczego źródło Twoich proxy ma znaczenie?
Ponieważ etyka zbierania danych obejmuje również infrastrukturę, przez którą kierujesz ruch. Sieć proxy zbudowana z urządzeń, których właściciele nigdy nie zgodzili się na udział, przenosi ukryty koszt na niczego niepodejrzewające osoby, co podważa twierdzenie, że Twój scraping jest odpowiedzialny.
Etycznie pozyskane proxy pochodzą od użytkowników, którzy wyraźnie wyrażają zgodę na udostępnianie swojego połączenia i otrzymują za to wynagrodzenie, przy jasnym ujawnieniu, na czym to polega. DataImpulse działa według tego modelu: jego 90M+ adresów IP residential, mobile i datacenter w 195 krajach pochodzi od użytkowników, którzy wyrażają zgodę i otrzymują wynagrodzenie, działalność jest zgodna z RODO, a umowa o przetwarzaniu danych jest dostępna. Więcej o tym podejściu przeczytasz na stronie etyczne proxy. Wybór dostawcy na tej podstawie, a nie najtańszej sieci o nieznanym pochodzeniu, zapewnia zgodność całego procesu z powyższymi zasadami. DataImpulse oferuje również mobile proxies i datacenter proxies dla zespołów potrzebujących różnych typów IP.
Jak wygląda lista kontrolna etycznego web scrapingu?
Krótka lista kontrolna pozwala od początku zachować uczciwość projektu. Jeden punkt zasługuje na osobną uwagę: licencjonowanie i prawa autorskie. Fakty i surowe dane często nie są chronione, ale twórcza forma ich wyrażenia, taka jak tekst artykułu i fotografie, może być objęta prawem autorskim lub prawami do bazy danych, dlatego sprawdź licencję, zanim ponownie opublikujesz lub odsprzedasz zebrane treści.
- Tylko dane publiczne: zbieraj dane dostępne bez logowania lub omijania paywalla.
- Odczytuj sygnały: sprawdzaj robots.txt i regulamin oraz respektuj niedozwolone ścieżki i opóźnienia crawlowania.
- Ograniczaj tempo: ustalaj tempo żądań, ograniczaj współbieżność, buforuj wyniki i zmniejszaj tempo przy błędach.
- Minimalizuj PII: unikaj danych osobowych, chyba że masz podstawę prawną, i zbieraj tylko to, czego potrzebujesz zgodnie z RODO i CCPA.
- Bądź przejrzysty tam, gdzie to praktyczne: używaj uczciwego klienta i nie podszywaj się pod konkretną osobę ani nie pokonuj zabezpieczeń.
- Szanuj licencjonowanie: przed ponownym wykorzystaniem lub opublikowaniem treści sprawdzaj prawa autorskie i prawa do baz danych.
- Pozyskuj infrastrukturę etycznie: kieruj ruch przez sieci proxy oparte na zgodzie i wynagradzaniu użytkowników.
- Zasięgnij porady w razie wątpliwości: w sprawach o wysokiej stawce lub niejednoznacznych skonsultuj się z prawnikiem.
Etyczne zasady scrapingu w praktyce
| Zasada | W praktyce |
|---|---|
| Tylko dane publiczne | Pomiń treści wymagające logowania |
| Szanuj robots.txt | Stosuj się do dyrektyw crawlowania |
| Ograniczanie tempa | Dodawaj opóźnienia między żądaniami |
| Bez danych osobowych | Unikaj zbierania PII |
| Atrybucja i licencjonowanie | Respektuj warunki i przypisuj autorstwo |
| Etyczne pozyskiwanie proxy | Używaj sieci IP opartych na zgodzie |
Najczęściej zadawane pytania
Czy web scraping to to samo co etyczny web scraping?
Nie. Web scraping to technika wyodrębniania danych ze stron internetowych, natomiast etyczny web scraping to scraping prowadzony z poszanowaniem ograniczeń dotyczących danych publicznych, obciążenia serwera, prawa prywatności i licencjonowania treści. Narzędzie jest takie samo, różni się dyscyplina jego użycia.
Czy ignorowanie robots.txt czyni scraping nielegalnym?
Nie automatycznie. Plik robots.txt jest standardem zalecającym, a nie prawem, więc jego ignorowanie samo w sobie nie jest przestępstwem, ale może wspierać inne roszczenia i sygnalizuje lekceważenie życzeń właściciela witryny. Legalność zależy od jurysdykcji i konkretnych faktów, dlatego w swojej sprawie skonsultuj się z prawnikiem.
Czy mogę scrapować dane osobowe, jeśli są publicznie widoczne?
Publiczna widoczność nie znosi obowiązków dotyczących prywatności. Przepisy takie jak RODO i CCPA mogą nadal mieć zastosowanie do danych osobowych, nawet gdy pojawiają się na otwartej stronie, dlatego potrzebujesz podstawy prawnej i powinieneś minimalizować zakres zbieranych danych.
Czym są etycznie pozyskane proxy?
Etycznie pozyskane proxy pochodzą od użytkowników, którzy wyraźnie wyrażają zgodę na udostępnianie swojego połączenia i otrzymują za to wynagrodzenie, przy jasnym ujawnieniu. DataImpulse pozyskuje swoje IP w ten sposób, działa zgodnie z RODO i udostępnia umowę o przetwarzaniu danych.
Jak zapobiec przeciążaniu witryny przez mój scraper?
Ogranicz tempo żądań i liczbę jednoczesnych połączeń, przestrzegaj każdego crawl-delay, buforuj strony, które już pobrałeś, i zmniejszaj tempo, gdy widzisz błędy lub limity tempa. Celem jest utrzymanie niewielkiego udziału w normalnym ruchu witryny.
Kiedy DataImpulse nie jest właściwym wyborem?
Jeśli potrzebujesz statycznych proxy ISP, w pełni zarządzanego API do scrapingu lub dostępu do stron bankowych i rządowych, DataImpulse nie jest właściwym narzędziem. Koncentruje się na rotacyjnych proxy residential, mobile i datacenter do zbierania danych publicznych i dostępu do treści.
Scrapuj odpowiedzialnie z etycznie pozyskanymi proxy
Jeśli chcesz infrastruktury zgodnej z powyższymi zasadami, DataImpulse oferuje etycznie pozyskane proxy residential, mobile i datacenter w modelu pay-as-you-go od jednego dolara za GB. Utwórz konto, aby odpowiedzialnie rozpocząć zbieranie danych publicznych.