
In this Article
Etik web scraping, hedef sunucuya, geçerli hukuka ve bu verilerde bilgileri yer alabilecek kişilere saygı göstererek web sitelerinden veri toplama uygulamasıdır. İyi yapıldığında etik web scraping, ekiplerin araştırma, fiyatlandırma ve izleme için açık bilgileri, yararlandıkları sitelere zarar vermeden toplamasını sağlar.
Bu makale, sorumlu veri toplamayı pervasız scraping’den ayıran çalışma ilkelerini ele alır: hangi verilerin toplanmasının makul olduğu, robots.txt ve hizmet şartları gibi işaretlerin nasıl okunacağı, sunucu yükünün nasıl sınırlandırılacağı, kişisel verilerin nasıl ele alınacağı ve proxy ağınızın kaynağının neden önemli olduğu.
DataImpulse, 195 ülkede 90 milyondan fazla residential, mobile ve datacenter IP adresi sunan etik bir proxy sağlayıcısıdır. GB başına 1 dolardan başlayan, süresi dolmayan trafikli kullandıkça öde modeli kullanır; web scraping, reklam doğrulama, fiyat izleme, pazar araştırması ve çoklu hesap yönetimi için kullanılır.
Temel Bilgiler
- Temel ilke: Etik web scraping, gizlilik hukukuna ve site şartlarına saygı duyarken, yalnızca herkesçe erişilebilir verileri hedef sunucuya zarar vermeyecek bir hızda toplamak demektir.
- En iyi proxy türü: tespiti aşan gerçek tüketici IP’lerini kullanan dönen residential proxy’ler.
- Fiyat: GB başına 1 dolardan başlayan, kullandıkça ödemeli, süresi dolmayan trafikli ve abonelik gerektirmeyen seçenek.
- Kapsama: 195 ülkede etik biçimde tedarik edilmiş 90M’den fazla IP.
- Güvenilirlik: %99,51 başarı oranı, G2’de 5 üzerinden 4,8 puan.
- Protokoller ve hedefleme: ülke hedefleme dahil HTTP, HTTPS ve SOCKS5.
Web scraping’i etik yapan nedir?
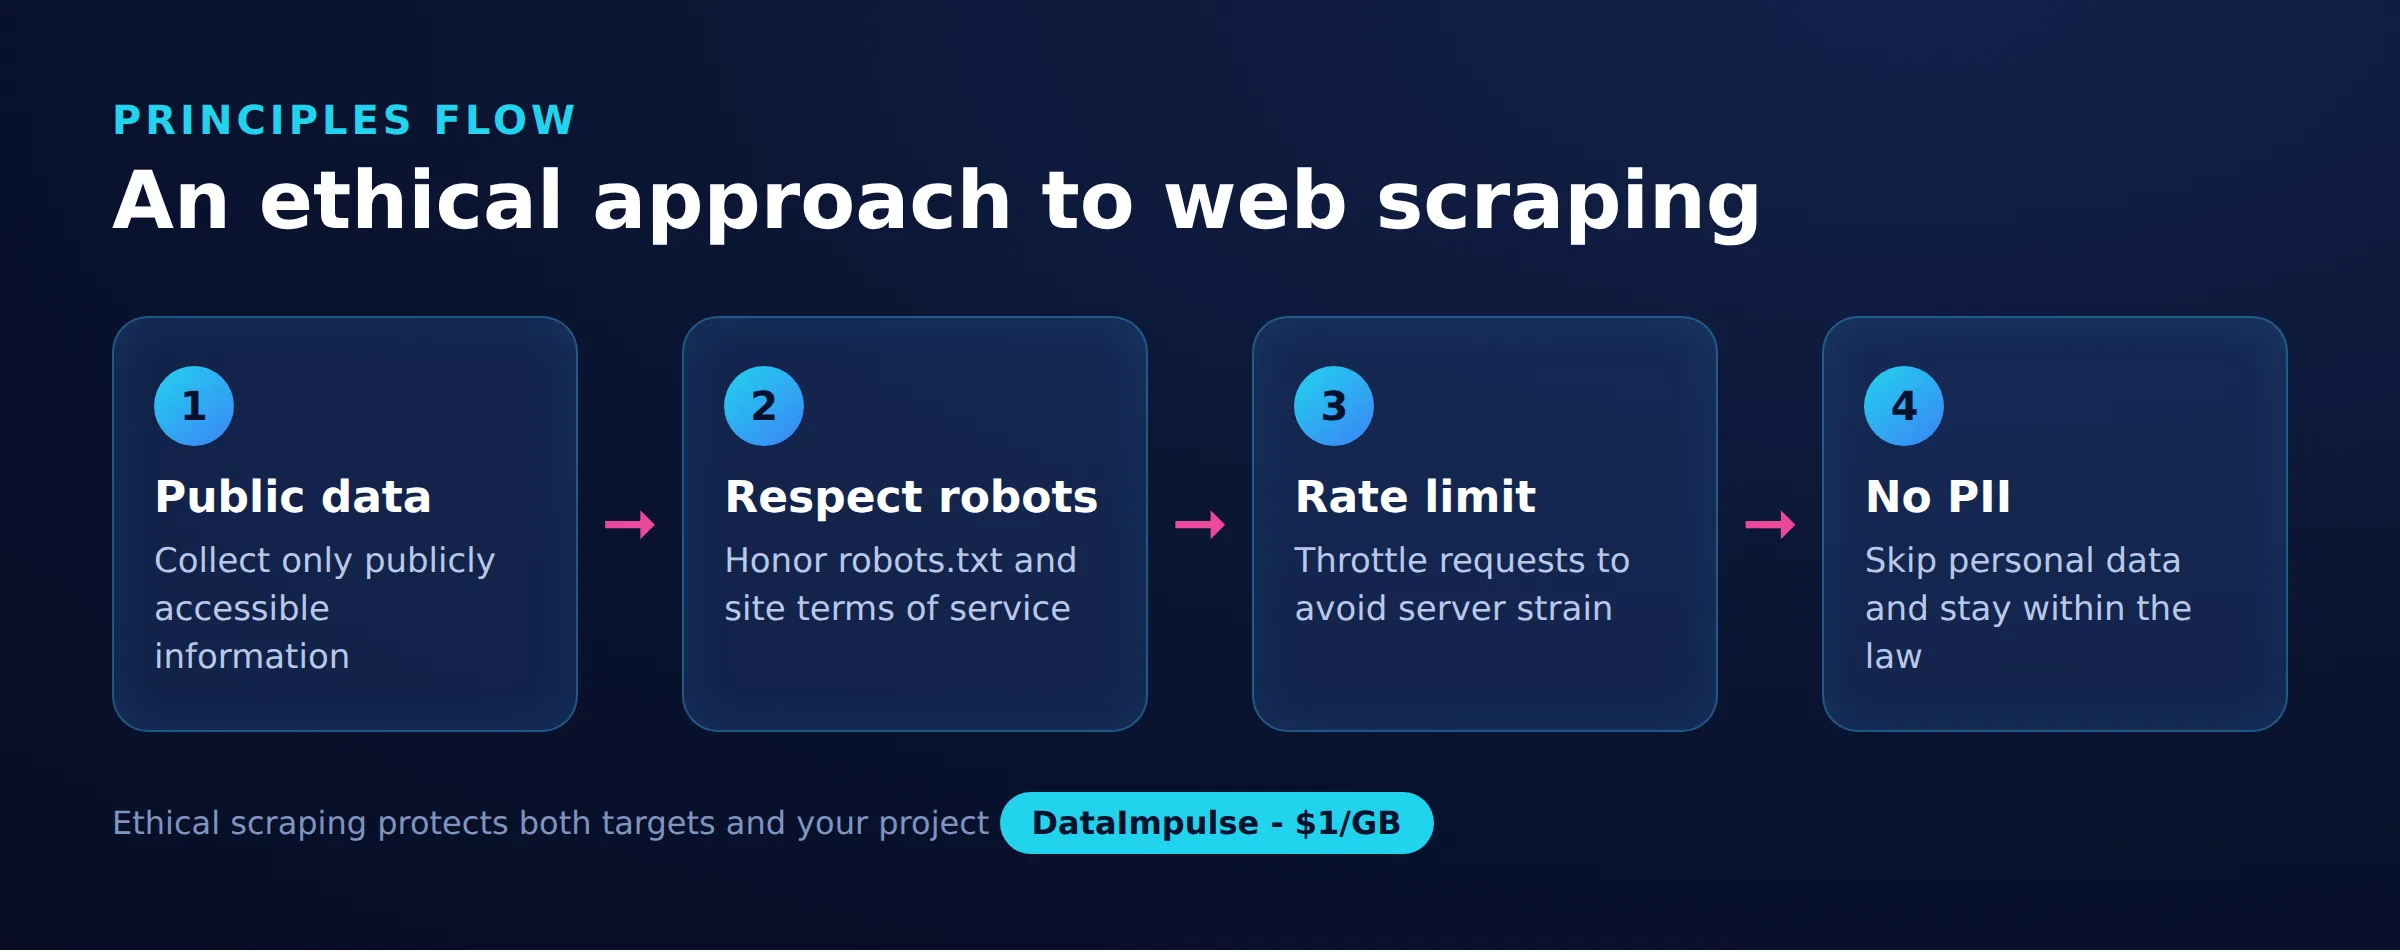
Web scraping, yalnızca açık verileri topladığında, hedef sunucunun kapasitesine saygı gösterdiğinde ve sitenin arkasındaki kişilere veya işletmeye zarar vermekten kaçındığında etiktir. Ayrım, araçtan çok niyet, hedef ve etkiyle ilgilidir.
Herkesin oturum açmadan görüntüleyebildiği, herkese açık sayfalar düşük riskli tarafta yer alır. Kimlik doğrulama, ödeme duvarı veya açık erişim kontrollerinin arkasındaki içerik farklıdır; çünkü bunlara ulaşmak genellikle önce şartları kabul etmeyi gerektirir. Yararlı bir ölçüt, site sahibi veri toplamanızı izleseydi bundan utanıp utanmayacağınızdır. Normal bir ziyaretçinin görebileceği verilerle sınırlı kalmak ve yalnızca gerçekten ihtiyaç duyduğunuz alanları alarak veri minimizasyonu uygulamak, diğer her şeyin üzerine kurulduğu temeldir.
- Açık ve hassas olmayan verileri toplayın.
- Net bir amaç için gerekenden fazlasını almayın.
- Gerçek kullanıcılar için hizmetin kalitesini düşürmekten kaçının.
robots.txt ve hizmet şartlarını nasıl ele almalısınız?
Her ikisini de okuyun ve görmezden gelmek yerine anlamlı işaretler olarak değerlendirin. robots.txt dosyası, otomatik istemcilere bir sitenin kaçınmalarını tercih ettiği yolları bildiren tavsiye niteliğinde bir standarttır; hizmet şartları (ToS) ise uygulanabilirliği yargı bölgesine ve duruma göre değişen bir sözleşmedir.
Hiçbiri basit bir açma-kapama anahtarı değildir. robots.txt tavsiye niteliğindedir: teknik bir kilit değildir ve tek başına kanun sayılmaz; ancak buna uymamak, site sahibinin açıkça ifade edilmiş isteklerini geçersiz kılmaya istekli olduğunuzu gösterir. Hizmet şartları gerçek ağırlık taşıyabilir, fakat ne kadar bağlayıcı oldukları nasıl sunulduklarına ve uyuşmazlığın nerede görüldüğüne bağlıdır. Bu metin hukuki tavsiye değildir; dürüst yanıt, kuralların nüanslı olduğu ve yargı bölgesine bağlı bulunduğudur. Hukuki yönün daha kapsamlı ele alınışı için web scraping yasal mı rehberimize bakın. Şüphe durumunda, kendi durumunuz için yetkin bir avukata danışın.
Asgari bir robots.txt şöyle görünebilir:
User-agent: *
Disallow: /private/
Crawl-delay: 10
Burada site, her otomatik istemciden /private/ yolundan kaçınmasını ve istekler arasında on saniye beklemesini ister. Hem izin verilmeyen yollara hem de tarama gecikmesine uymak, iyi davranışın temelidir.
Bir sunucuyu aşırı yüklemekten nasıl kaçınırsınız?
Trafiğiniz sitenin normal yükünün küçük bir bölümü olarak kalacak şekilde istek hızınızı ve eşzamanlılık düzeyinizi sınırlayın. Agresif scraping, gerçek kullanıcılar için bir siteyi yavaşlatabilir veya uç noktada hizmet reddi örüntüsüne benzeyebilir.
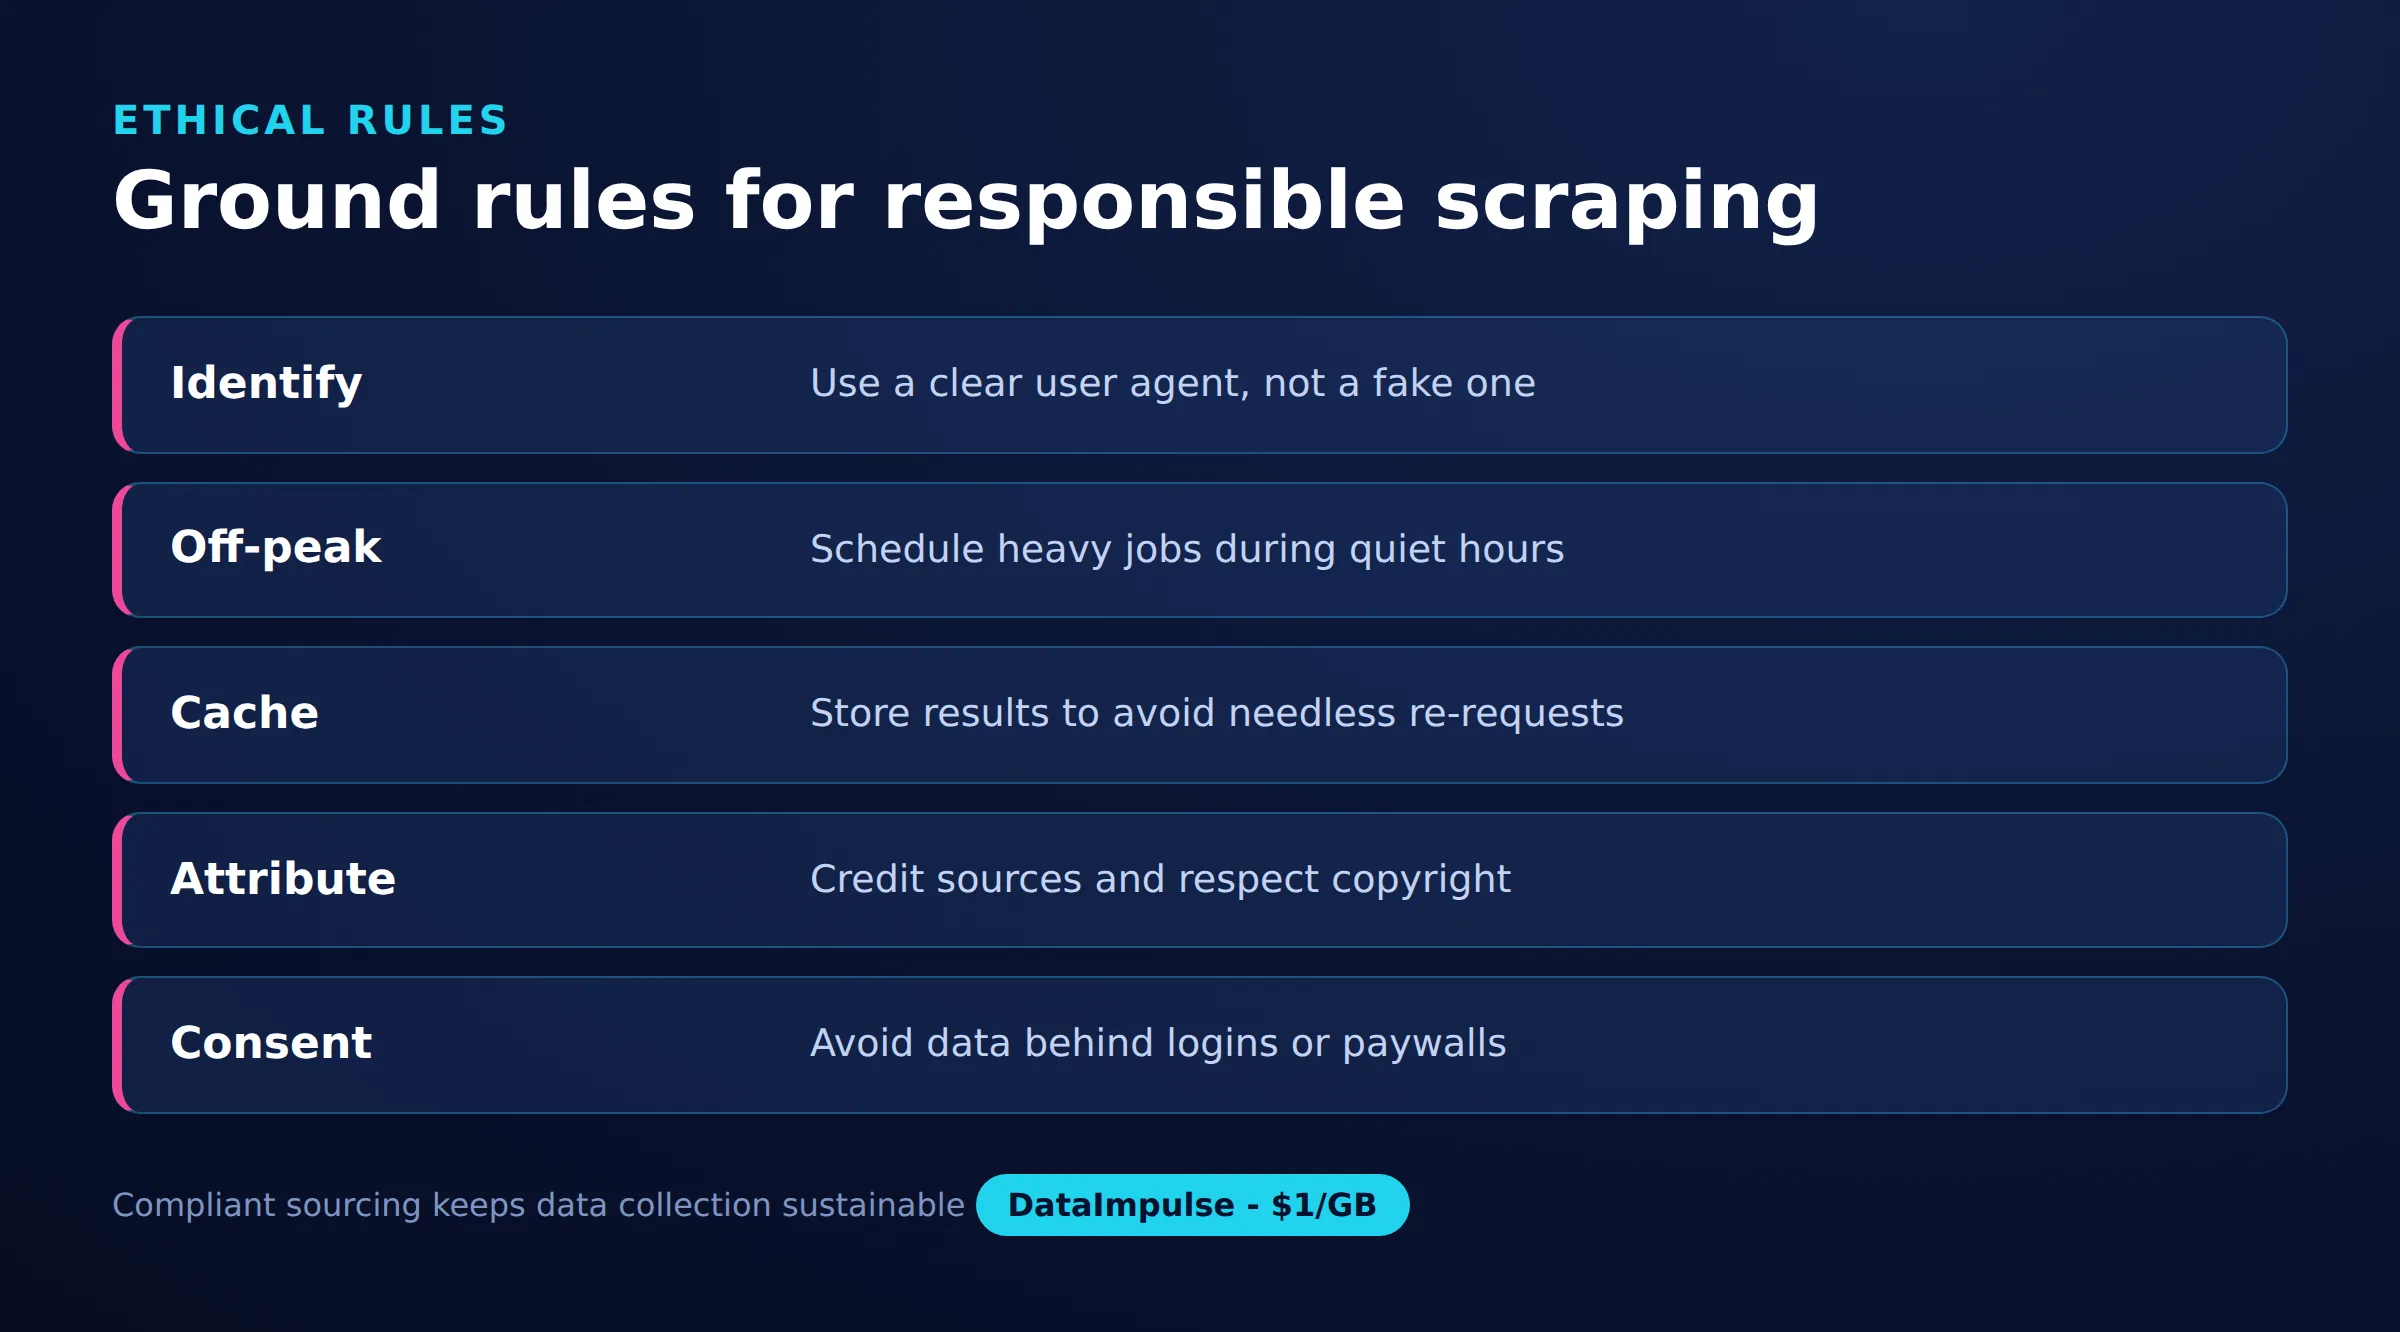
robots.txt içindeki tarama gecikmesine uyun, istekler arasına beklemeler ekleyin ve aynı anda açtığınız bağlantı sayısına üst sınır koyun. Hedef sitenin yoğun olmayan saatlerinde scraping yapmak etkiyi daha da azaltır. Daha önce getirdiğiniz sayfaları önbelleğe almak aynı veri için yinelenen istekleri önler; hata veya hız sınırı yanıtları gördüğünüzde durmak ya da geri çekilmek ise sunucuyu ezip geçmek yerine ona tepki verdiğinizi gösterir. İstekleri bir residential proxy havuzuna dağıtmak yükü yayabilir ve tek bir adresten siteyi sürekli zorlamayı önleyebilir; ancak bu, daha fazla istek göndermek için bir izin değil, dikkatli hız ayarlamak için bir nedendir. Hem engellemeleri hem de yükü azaltan teknikler için engellenmeden scraping rehberimize bakın.
Kişisel verileri ve gizlilik hukukunu nasıl ele almalısınız?
Hukuki bir dayanağınız ve gerçek bir ihtiyacınız olmadıkça kişisel veri toplamaktan kaçının; çünkü gizlilik düzenlemeleri, scraping ile alınan verilere diğer tüm verilerde olduğu gibi uygulanır. AB’deki GDPR ve Kaliforniya’daki CCPA gibi kanunlar, açık olup olmadığına bakılmaksızın kişisel bilgilerin nasıl toplandığını, saklandığını ve kullanıldığını düzenler.
Kişisel olarak tanımlanabilir bilgiler (PII); adlar, e-posta adresleri, telefon numaraları ve bir kişiyi tanımlayan her şeyi kapsar. Bu tür verilerin açık bir sayfada görünmesi, onları otomatik olarak toplanıp başka amaçla kullanılabilir hâle getirmez. Veri minimizasyonu uygulayın: amacınıza hizmet eden en dar alan kümesini toplayın, ihtiyacınız olmayan her şeyi atın ve açık bir hukuki temel olmaksızın kişiler hakkında profil oluşturmayın. Hedefiniz insanlar yerine fiyatlar, bulunabilirlik veya toplu eğilimler olduğunda, baştan PII’ye hiç dokunmayan tasarımları tercih edin.
Bir scraper kendini tanıtmalı mı?
Bu konuda gerçek bir tartışma vardır ve makul uygulayıcılar farklı düşünür. Bir görüşe göre scraper, operatörü tanımlayan ve iletişim yöntemi sunan dürüst bir user-agent dizesi göndermelidir; böylece site sahipleri sizinle iletişim kurabilir veya kurallar koyabilir. Diğer görüş ise bunun, iyi davranıştan bağımsız olarak toplu engellemeye davetiye çıkardığı yönündedir.
Şeffaflığın gerçek bir değeri vardır: projenizi adlandıran ve bir politika sayfasına bağlantı veren açıklayıcı bir user-agent, işbirliğine açık bir site sahibinin tahminde bulunmak yerine sizi yavaşlatmasını veya izin listesine almasını sağlar. Karşı görüş, birçok sitenin yaygın bir tarayıcıya benzemeyen her şeyi engellediği ve bunun iyi davranan scraper’ları bile genel dizelere yönelttiğidir. Tek bir doğru yanıt yoktur; ancak belirli bir kişiyi taklit etmek veya güvenliği aşmak için kimliği kasıtlı olarak sahtelemek, tarafsız ve dürüst bir istemci kullanmaktan daha zor savunulur. Kendi hedefiniz için şeffaflığı pratiklikle karşılaştırarak değerlendirin.
Proxy’lerinizin kaynağı neden önemlidir?
Çünkü veri toplamanızın etiği, trafiği yönlendirdiğiniz altyapıya da uzanır. Sahipleri katılmayı hiç kabul etmemiş cihazlardan oluşan bir proxy ağı, şüphelenmeyen insanlara gizli bir maliyet yükler; bu da scraping’inizin sorumlu olduğu iddiasını zedeler.
Etik biçimde tedarik edilmiş proxy’ler, bağlantılarını paylaşmayı açıkça kabul eden ve bunun karşılığında ücret alan kullanıcılardan gelir; neyin söz konusu olduğu da açıkça belirtilir. DataImpulse bu modeli izler: 195 ülkedeki 90M+ residential, mobile ve datacenter IP’leri, katılmayı kabul eden ve ücretlendirilen kullanıcılardan tedarik edilir; operasyon GDPR ile uyumludur ve veri işleme sözleşmesi sunulur. Bu yaklaşım hakkında daha fazlasını etik proxy’ler sayfamızda okuyabilirsiniz. Kaynağı bilinmeyen en ucuz ağ yerine bu temelde bir sağlayıcı seçmek, tüm hattı yukarıdaki ilkelerle tutarlı tutar. DataImpulse ayrıca farklı IP türlerine ihtiyaç duyan ekipler için mobile proxy’ler ve datacenter proxy’ler sunar.
Etik web scraping kontrol listesi nasıl görünür?
Kısa bir kontrol listesi, projenin baştan dürüst kalmasını sağlar. Bir nokta özel bir notu hak eder: lisanslama ve telif hakkı. Olgular ve ham veriler çoğu zaman korunmaz, ancak makale metni ve fotoğraflar gibi bunların çevresindeki yaratıcı ifade telif hakkı veya veritabanı haklarıyla korunabilir; bu nedenle topladıklarınızı yeniden yayımlamadan veya satmadan önce lisansı kontrol edin.
- Yalnızca açık veriler: oturum açmayı veya ödeme duvarını aşmayı gerektirmeden erişilebilen verileri toplayın.
- İşaretleri okuyun: robots.txt ve hizmet şartlarını inceleyin; izin verilmeyen yollara ve tarama gecikmelerine uyun.
- Hızı sınırlayın: istekleri aralıklı gönderin, eşzamanlılığı sınırlayın, sonuçları önbelleğe alın ve hatalarda geri çekilin.
- PII’yi en aza indirin: hukuki dayanağınız yoksa kişisel verilerden kaçının ve GDPR ile CCPA kapsamında yalnızca ihtiyacınız olanı toplayın.
- Uygun olduğunda şeffaf olun: dürüst bir istemci kullanın; belirli bir kişiyi taklit etmeyin veya güvenliği aşmayın.
- Lisanslamaya saygı gösterin: içeriği yeniden kullanmadan veya yayımlamadan önce telif hakkını ve veritabanı haklarını kontrol edin.
- Altyapıyı etik biçimde tedarik edin: trafiği, katılım onayı alınmış ve ücretlendirilen proxy ağları üzerinden yönlendirin.
- Şüphede tavsiye alın: yüksek riskli veya belirsiz durumlar için bir avukata danışın.
Uygulamada etik scraping ilkeleri
| İlke | Uygulamada |
|---|---|
| Yalnızca açık veriler | Oturum açma kısıtlamalı içeriği atlayın |
| robots.txt’ye saygı | Tarama yönergelerine uyun |
| Hız sınırlama | İstekler arasına gecikmeler ekleyin |
| Kişisel veri yok | PII toplamaktan kaçının |
| Atıf ve lisanslama | Şartlara uyun ve kaynak belirtin |
| Etik proxy tedariki | Onay alınmış IP ağlarını kullanın |
Sık sorulan sorular
Web scraping, etik web scraping ile aynı şey midir?
Hayır. Web scraping, web sitelerinden veri çıkarma tekniğidir; etik web scraping ise açık veri sınırlarına, sunucu yüküne, gizlilik hukukuna ve içerik lisanslamasına saygı gösterilerek yapılan scraping’dir. Araç aynıdır; farklı olan, çevresindeki disiplindir.
robots.txt’yi görmezden gelmek scraping’i yasa dışı yapar mı?
Otomatik olarak yapmaz. robots.txt dosyası kanun değil, tavsiye niteliğinde bir standarttır; dolayısıyla onu görmezden gelmek tek başına suç değildir. Ancak başka iddiaları destekleyebilir ve site sahibinin isteklerini önemsemediğinizi gösterir. Yasallık yargı bölgesine ve somut olgulara bağlıdır; bu nedenle kendi durumunuz için bir avukata danışın.
Kişisel verileri açıkça görünüyorsa scrape edebilir miyim?
Verilerin açıkça görünür olması gizlilik yükümlülüklerini ortadan kaldırmaz. GDPR ve CCPA gibi düzenlemeler, kişisel veriler açık bir sayfada görünse bile uygulanabilir; bu nedenle hukuki bir dayanağa ihtiyacınız vardır ve topladıklarınızı en aza indirmelisiniz.
Etik biçimde tedarik edilmiş proxy’ler nedir?
Etik biçimde tedarik edilmiş proxy’ler, bağlantılarını paylaşmaya açıkça onay veren ve bunun için ücret alan kullanıcılardan, net bir bilgilendirmeyle gelir. DataImpulse IP’lerini bu şekilde tedarik eder, GDPR ile uyumludur ve veri işleme sözleşmesi sunar.
Scraper’ımın bir web sitesini aşırı yüklemesini nasıl önlerim?
İstek hızınızı ve eşzamanlı bağlantı sayısını sınırlayın, varsa tarama gecikmesine uyun, daha önce getirdiğiniz sayfaları önbelleğe alın ve hata veya hız sınırı gördüğünüzde geri çekilin. Amaç, sitenin normal trafiğinin küçük bir bölümü olarak kalmaktır.
DataImpulse ne zaman doğru seçim değildir?
Statik ISP proxy’lerine, tamamen yönetilen bir scraping API’ye veya bankacılık ve devlet sitelerine erişime ihtiyacınız varsa DataImpulse doğru araç değildir. Açık veri toplamak ve içeriğe erişmek için dönen residential, mobile ve datacenter proxy’lere odaklanır.
Etik biçimde tedarik edilmiş proxy’lerle sorumlu scraping yapın
Yukarıdaki ilkelerle uyumlu bir altyapı istiyorsanız DataImpulse, GB başına bir dolardan başlayan kullandıkça ödemeli trafikle etik biçimde tedarik edilmiş residential, mobile ve datacenter proxy’ler sunar. Açık verileri sorumlu biçimde toplamaya başlamak için hesap oluşturun.